

Pozadí
Máme automatizované stroje vlastní konstrukce. Uvnitř je Raspberry Pi a trochu obvodových desek. Jsou připojeny mince, bankovky a platební terminál… Všemu vládne program napsaný na míru. Celá historie provozu se zapisuje do logu na flash disk (MicroSD), který se pak přenáší přes internet (pomocí USB modemu) na server, kde je ukládán do databáze. Informace o prodeji se načítají do 1C, také je dostupné jednoduché webové rozhraní pro monitorování apod.
Log je naprosto nezbytný — pro evidenci (tam jsou tržby, prodeje atd.), monitoring (různé poruchy a další mimořádné situace); to je, dá se říct, veškeré informace, které máme o tomto automatu.
Problém
Flash disky se ukazují jako velmi nespolehlivá zařízení. S železnou pravidelností selhávají. To vede jak k prostojům automatů, tak (pokud z nějakého důvodu log nemohl být online přenesen) k ztrátě dat.
Toto už není první zkušenost s flash disky, předtím jsme měli jiný projekt s více než stovkou zařízení, kde byl log uchováván na USB flash discích, tam byly také problémy s spolehlivostí, někdy se počet selhaných zařízení za měsíc počítal na desítky. Zkoušeli jsme různé flash disky, včetně značkových na SLC paměti, ano, některé modely byly spolehlivější než jiné, ale výměna flash disků nevyřešila problém zásadně.
Pozor! Dlouhý článek! Pokud vás nezajímá „proč“, ale zajímá vás jen „jak“, můžete okamžitě přejít článku.
Řešení
První, co mě napadá: vzdát se MicroSD, nahradit to například SSD a nabootovat z něj. Teoreticky to možné je, ale relativně drahé a ne tak spolehlivé (přidává se adaptér USB-SATA; statistiky poruch levných SSD také nejsou potěšující).
USB HDD také nevypadá jako zvlášť atraktivní řešení.
Proto jsme došli k takovému řešení: zachovat start z MicroSD, ale používat je v režimu pouze pro čtení, a log provozu (a další unikátní informace pro dané zařízení — sériové číslo, kalibrace senzorů atd.) uchovávat někde jinde.
Téma read-only FS pro Raspberry Pi už bylo studováno do hloubky, nebudu se v tomto článku zabývat detaily implementace (ale pokud bude zájem — možná napíšu mini-článek na toto téma). Jediný bod, který bych chtěl zmínit: jak z vlastních zkušeností, tak z recenzí těch, kteří již implementovali výhody spolehlivosti, je to pravda. Ano, úplně se zbavit poruch není možné, ale významně snížit jejich frekvenci – zcela reálné. A také se karty stávají standardizovanými, což výrazně usnadňuje výměnu pro obsluhující personál.
Hardwarová část
S výběrem typu paměti nebylo žádných zvláštních pochyb – NOR Flash.
Argumenty:
- jednoduché připojení (nejčastěji sběrnice SPI, zkušenost s ní již máme, takže žádné ‚hardwarové‘ problémy se nečekají);
- směšná cena;
- standardní pracovní protokol (realizace již existuje v jádře Linuxu, pokud si přejete, lze vzít i externí, které také existují, nebo dokonce napsat své, což je jednoduché);
- spolehlivost a životnost:
z typického datasheetu: data jsou uchovávána 20 let, 100000 cyklů mazání pro každý blok;
z externích zdrojů: extrémně nízký BER, prohlašuje se, že kódy pro opravu chyb nejsou nutné (v některých pracích se zvažuje ECC pro NOR, ale obvykle tam většinou mají na mysli MLC NOR, což se také stává).
Pojďme odhadnout požadavky na objem a životnost.
Chceme, aby byla data garantována uchována po několik dní. Je to potřeba, aby v případě jakýchkoli problémů s komunikací historie prodeje nebyla ztracena. Budeme se orientovat na 5 dní, během této doby (i s ohledem na víkendy a svátky) možno vyřešit problém.
V současnosti se za den nasbírá přibližně 100 kB deníku (3-4 tisíce záznamů), ale tato cifra postupně roste – zvyšuje se podrobnost, přidávají se nové události. Kromě toho se občas objevují výkyvy (nějaký senzor začne spamovat falešnými aktivacemi, například). Budeme počítat s 10 tisíci záznamy po 100 bytech – megabajt za den.
Celkem to činí 5 MB čistých (dobře komprimovatelných) dat. K nim ještě (hrubý odhad) 1 MB servisních dat.
Takže potřebujeme čip o velikosti 8 MB, pokud nevyužíváme kompresi, nebo 4 MB, pokud ji použijeme. To jsou zcela reálné čísla pro tento typ paměti.
Pokud jde o životnost: pokud plánujeme, že paměť bude kompletně přepisována nejvýše jednou za 5 dní, za 10 let služby obdržíme méně než tisíc cyklů přepsání.
Připomínám, že výrobce slibuje sto tisíc.
Něco málo o NOR vs NAND
Dnes je samozřejmě mnohem populárnější NAND paměť, nicméně pro tento projekt bych ji nepoužíval: NAND na rozdíl od NOR vždy vyžaduje použití kódů pro opravu chyb, tabulek vadných bloků atd., a nožiček má obvykle mnohem více.
Jako nevýhody NOR lze uvést:
- malý objem (a tím pádem vysoká cena za megabajt);
- nízkou rychlost přenosu (velmi často kvůli tomu, že se používá sériové rozhraní, obvykle SPI nebo I2C);
- pomalé mazání (v závislosti na velikosti bloku trvá od zlomků sekundy až po několik sekund).
Zatímco to pro nás nevypadá kriticky, pokračujeme.
Pokud vás zajímají detaily, byla vybrána obvodová deska (nicméně, to není zásadní, na trhu je spousta analogů, které jsou kompatibilní z hlediska pinout a sady příkazů; i kdybychom chtěli použít čip jiného výrobce a/nebo jiného objemu, vše bude fungovat bez změny kódu).
Používám vestavěný ovladač v jádře Linuxu, na Raspberry díky podpoře overlay zařízení je to velmi jednoduché — stačí umístit zkompilovaný overlay do /boot/overlays a mírně upravit /boot/config.txt.
Příklad dts souboru
Upřímně řečeno, nejsem si jistý, že je to napsáno bezchybně, ale funguje to.
/*
 * Device tree overlay for at25 at spi0.1
 */

/dts-v1/;
/plugin/;

/ {
    compatible = "brcm,bcm2835", "brcm,bcm2836", "brcm,bcm2708", "brcm,bcm2709";

    /* disable spi-dev for spi0.1 */
    fragment@0 {
        target = <&spi0>;
        __overlay__ {
            status = "okay";
            spidev@1{
                status = "disabled";
            };
        };
    };

    /* the spi config of the at25 */
    fragment@1 {
        target = <&spi0>;
        __overlay__ {
            #address-cells = <1>;
            #size-cells = <0>;
            flash: m25p80@1 {
                    compatible = "atmel,at25df321a";
                    reg = <1>;
                    spi-max-frequency = <50000000>;

                    /* default to false:
                    m25p,fast-read ;
                    */
            };
        };
    };

    __overrides__ {
        spimaxfrequency = <&flash>,"spi-max-frequency:0";
        fastread = <&flash>,"m25p,fast-read?";
    };
};
A ještě jeden řádek v config.txt
dtoverlay=at25:spimaxfrequency=50000000Popis samotného připojení čipu k Raspberry Pi vynechám. Na jedné straně nejsem odborník na elektroniku, na druhé straně — je to pro mě banální: čip má pouze 8 nožiček, z nichž potřebujeme zem, napájení, SPI (CS, SI, SO, SCK); úrovně odpovídají úrovním Raspberry Pi, žádné dodatečné obvody nejsou potřeba — stačí propojit uvedených 6 kontaktů.
Formulace úkolu
Jak je obvyklé, definice úkolu prochází několika iteracemi, myslím, že nastal čas na další. Takže se pojďme zastavit, shromáždit to, co už bylo napsáno, a objasnit zbývající nejasné detaily.
Takže jsme se rozhodli, že žurnál bude uchováván v SPI NOR Flash.
Co je NOR Flash pro ty, kdo to neví?
Je to paměť bez napájení, se kterou lze provádět tři operace:
- Čtení:
Nejtypičtější čtení: předáme adresu a přečteme tolik bajtů, kolik potřebujeme; - Zápis:
Záznam v NOR flash vypadá běžně, ale má jednu zvláštnost: lze měnit pouze 1 na 0, ale ne naopak. Například, pokud máme v paměťové buňce 0x55, po zápisu 0x0f tam již bude uloženo 0x05. (viz tabulka níže); - Vymazání:
Samozřejmě, musíme být schopni provést i opačnou operaci – měnit 0 na 1, přesně pro to existuje operace vymazání. Na rozdíl od prvních dvou operací, tato manipuluje nikoli s bajty, ale s bloky (minimální vymazávací blok v zvolené mikroschéme – 4kB). Vymazání zničí celý blok a je to jediný způsob, jak změnit 0 na 1. Proto, při práci s flash paměťmi, často musíme zarovnat datové struktury na hranu vymazávacího bloku.
Zápis do NOR Flash:
Binární data
Bylo
01010101
Zapsáno
00001111
Stalo se
00000101
Žurnál představuje sekvenci záznamů proměnlivé délky. Typická délka záznamu je kolem 30 bajtů (i když se občas vyskytnou i záznamy o délce několika kilobajtů). V tomto případě s nimi pracujeme jednoduše jako s množinou bajtů, ale pokud vás to zajímá, uvnitř záznamů se používá CBOR.
Kromě žurnálu musíme uchovávat určité „nastavovací“ informace, jak aktualizované, tak ne: určitý ID zařízení, kalibraci senzorů, flag „zařízení je dočasně vypnuto“ atd.
Tyto informace představují soubor záznamů ve formátu key-value, také uložených v CBOR. Těchto informací nemáme příliš mnoho (maximálně několik kilobajtů), aktualizují se zřídka.
V budoucnu je budeme nazývat kontextem.
Pokud si vzpomeneme, odkud tato studie začínala, je velmi důležité zajistit spolehlivost ukládání dat a, pokud možno, nepřetržitý provoz i v případě hardwarových selhání/zranění dat.
Jaké zdroje problémů lze zvážit?
- Vypnutí napájení během operací zápis/vymazání. To je z kategorie „není léku na každou nemoc“.
Informace z na stackexchange: při vypnutí napájení během práce s flash pamětí, ať už jde o vymazání (nastavení na 1) nebo zápis (nastavení na 0), dochází k nejednoznačnému chování: data mohou být zapsána, zapsána částečně (například jsme předali 10 bajtů/80 bitů, ale zapsali jsme pouze 45 bitů), není vyloučeno, že některé bity se ocitnou v „mezivládním“ stavu (čtení může vrátit jak 0, tak 1); - Chyby samotné flash paměti.
BER, i když velmi nízký, nemůže být nulový; - Chyby na sběrnici
Data přenášená pomocí SPI nejsou nijak chráněna, mohou nastat jak jednotlivé chybné bity, tak chyby synchronizace – ztráta nebo vložení bitu (což vede k masivnímu zkreslení dat); - Jiné chyby / selhání
Chyby v kódu, „glitche“ Raspberry, zásah mimozemšťanů…
Stanovil jsem požadavky, jejichž splnění je podle mého názoru nezbytné pro zajištění spolehlivosti:
- záznamy musí být ukládány do flash paměti okamžitě, odložené ukládání se nepřipouští; - pokud dojde k chybě, měla by být co nejdříve detekována a zpracována; - systém by měl být schopen co nejlépe obnovit činnost po chybě.
(příklad ze života "jak by to nemělo být", se kterým se myslím všichni setkali: po havarijním restartu došlo k poškození souborového systému a operační systém se nenačte)
Nápady, přístupy, úvahy
Když jsem začal přemýšlet nad tímto úkolem, hlavou mi probíhalo spousta nápadů, například:
- použít kompresi dat;
- použít chytré datové struktury, například ukládat hlavičky záznamů odděleně od samotných záznamů, abychom při chybě v jakémkoli záznamu mohli bez problémů přečíst ostatní;
- použít bitová pole pro kontrolu dokončení záznamu při odpojení napájení;
- uchovávat kontrolní součty pro všechno a všude;
- použít nějaký druh kódu odolného vůči poruchám.
Část těchto nápadů byla použita, od části bylo rozhodnuto upustit. Pojďme to vzít pěkně popořadě.
Kompresce dat
Samotné události, které zaznamenáváme do deníku, jsou dost jednotné a opakující se ("hodili jsme minci 5 korun", "stiskli jsme tlačítko na vydání drobných", …). Proto by měla být komprese dostatečně efektivní.
Náklady na kompresi jsou zanedbatelné (máme dost silný procesor, i na prvním Pi bylo jedno jádro s frekvencí 700 MHz, na aktuálních modelech několik jader s frekvencí nad gigahertz), rychlost výměny s úložištěm není vysoká (několik megabajtů za sekundu), velikost záznamů není velká. V zásadě, pokud komprese ovlivní výkon, tak pouze pozitivně. (absolutně nekritické, pouze konstatuji). Plus, we don't have a true embedded system, but a regular Linux, so the implementation shouldn't take much effort (just link the library and use a few functions from it).
A piece of log from a running device (1.7MB, 70 thousand records) was taken and initially checked for compressibility using the available gzip, lz4, lzop, bzip2, xz, zstd on the computer.
- gzip, xz, zstd showed similar results (40KB).
It was surprising that the trendy xz performed at the level of gzip or zstd; - lzip with default settings gave slightly worse results;
- lz4 and lzop showed not very good results (150KB);
- bzip2 showed surprisingly good results (18KB).
So, the data compresses very well.
Therefore, (if we don't find any fatal flaws) compression is a go! Simply because more data can fit on the same flash drive.
Let’s consider the drawbacks.
The first problem: we've already agreed that each record should immediately go to flash. Usually, the compressor collects data from the input stream until it decides it's time to write to the output. We need to immediately get a compressed block of data and save it in non-volatile memory.
I see three options:
- Compress each record using dictionary compression instead of the algorithms discussed above.
This is a viable option, but I don't like it. To achieve a more or less decent level of compression, the dictionary needs to be tailored to specific data; any change will lead to a catastrophic drop in the compression ratio. Yes, the problem can be solved by creating a new version of the dictionary, but that’s a headache—we will need to store all versions of the dictionary, and each record will need to indicate which version of the dictionary it was compressed with… - Compress each record using 'classical' algorithms, but independently of others.
The compression algorithms considered are not designed to work with records of this size (dozens of bytes); the compression ratio will clearly be less than 1 (i.e., an increase in data volume instead of compression); - Make a FLUSH after each record.
Many compression libraries support FLUSH. This is a command (or a parameter to the compression procedure) that, upon receiving it, enables the compressor to form a compressed stream so that it can restore všechny the uncompressed data that has already been received. This is an analogysyncve fileových systémech nebocommitv sql.
Co je důležité, následující kompresní operace mohou využít nahromaděný slovník a míra komprese nebude trpět tak silně, jako v předchozím případě.
Myslím, že je jasné, že jsem zvolil třetí možnost, zastavme se na ní podrobněji.
Našla se o FLUSH v zlib.
Udělal jsem na základě článku náročný test a vzal jsem 70 tisíc záznamů protokolu z reálného zařízení při velikosti stránky 60KB (k velikosti stránky se ještě vrátíme) dostal jsem:
Vstupní data
Kompresní gzip -9 (bez FLUSH)
zlib s Z_PARTIAL_FLUSH
zlib s Z_SYNC_FLUSH
Objem, KB
1692
40
352
604
Na první pohled se cena, kterou přináší FLUSH, zdá být přehnaně vysoká, ale ve skutečnosti máme chudý výběr — buď zcela nekcompressovat, nebo kompresi provést (a to velmi efektivně) s FLUSH. Nezapomínejme, že máme 70 tisíc záznamů, nadbytečnost, kterou přináší Z_PARTIAL_FLUSH, představuje pouze 4-5 bytů na záznam. A koeficient komprese se ukázal jako téměř 5:1, což je více než skvělý výsledek.
Může se to zdát překvapivé, ale ve skutečnosti je Z_SYNC_FLUSH účinnějším způsobem provádění FLUSH
Při použití Z_SYNC_FLUSH budou poslední 4 byty každého záznamu vždy 0x00, 0x00, 0xff, 0xff. A pokud je známe, nemusíme je uchovávat, takže konečná velikost je pouze 324KB.
V článku, na který se odvolávám, je vysvětlení:
Nový blok typu 0 s prázdným obsahem je připojen.
Blok typu 0 s prázdným obsahem se skládá z:
- tříbitové hlavičky bloku;
- 0 až 7 bitů rovných nule, pro dosažení bytové zarovnání;
- čtyřbytové sekvence 00 00 FF FF.
Jak není těžké si všimnout, před těmito 4 byty v posledním bloku jde od 3 do 10 nulových bitů. Praxe však ukázala, že nulových bitů je ve skutečnosti minimálně 10.
Ukazuje se, že takto krátké datové bloky jsou obvykle (vždy?) kódovány pomocí bloku typu 1 (pevný blok), který končí 7 nulovými bity, celkem tedy získáme 10-17 zaručeně nulových bitů (a ostatní budou nulové s pravděpodobností přibližně 50%).
Na testovacích datech bylo ve 100% případů před 0x00, 0x00, 0xff, 0xff jeden nulový byt, a ve více než třetině případů — dva nulové byty (možná je to tím, že používám binární CBOR, a při použití textového JSON by se častěji vyskytovaly bloky typu 2 — dynamický blok, následně by se vyskytovaly bloky bez dalších nulových bytů před 0x00, 0x00, 0xff, 0xff).
Celkově lze na existujících testovacích datech dosáhnout méně než 250KB komprimovaných dat.
Můžete ještě trochu ušetřit, když se pustíte do žonglování s bity: nyní ignorujeme existence několika nulových bitů na konci bloku, několik bitů na začátku bloku také zůstává nezměněno…
Ale zde jsem se rozhodl zastavit, jinak bychom takovými tempy mohli dospět k vývoji vlastního archiveru.
Celkově jsem z mých testovacích dat dostal 3-4 bajty na zápis, kompresní poměr byl více než 6:1. Po pravdě říkám: takový výsledek jsem ani nečekal, podle mého názoru cokoliv lepšího než 2:1 je už výsledek, který ospravedlňuje použití komprese.
Všechno je skvělé, ale zlib (deflate) je přece jen archaický, zasloužený a trochu zastaralý kompresní algoritmus. Už to, že jako slovník používá posledních 32 kB z proudu nekomprimovaných dat, dnes vypadá podivně (to znamená, pokud je nějaký blok dat velmi podobný tomu, co bylo ve vstupním proudu před 40 kB, začne se archivovat znovu, a neodkazuje se na minulý výskyt). V moderních archiverisích se velikost slovníku častěji měří megabyty, než kilobyty.
Tak tedy pokračujeme v našem mini-výzkumu archiverů.
Dalším byl otestován bzip2 (připomínám, bez FLUSH ukázal fantastickou míru komprese, téměř 100:1). Bohužel, s FLUSH se ukázal velmi špatný, velikost komprimovaných dat byla větší než nekomprimovaných.
Moje domněnky o příčinách neúspěchu
Libbz2 nabízí pouze jednu možnost flush, která, jak se zdá, vyčistí slovník (analog Z_FULL_FLUSH v zlib), nemůžeme mluvit o nějaké účinné kompresi po tomto.
A posledním testovaným byl zstd. V závislosti na parametrech komprimuje buď na úrovni gzip, ale mnohem rychleji, nebo lépe než gzip.
Bohužel, s FLUSH i on se ukázal jako „ne moc dobrý“: velikost komprimovaných dat byla asi 700 kB.
Já na stránce projektu na githubu, dostal jsem odpověď, že je dobré počítat až 10 bajtů servisních dat na každý blok komprimovaných dat, což se blíží dosaženým výsledkům, deflate stejně nedohnat.
Na tom jsem se rozhodl přestat s pokusy s archivery (připomínám, že xz, lzip, lzo, lz4 se ještě neukázaly na fázi testování bez FLUSH, exotické algoritmy komprese jsem nezvažoval).
Vracíme se k problémům archivace.
Druhý problém (jak říkáme podle pořadí, a ne podle významu) je, že komprimovaná data představují jeden tok, ve kterém neustále probíhá odkazování na předchozí úseky. Takže při poškození nějakého segmentu komprimovaných dat ztrácíme nejen související blok nekomprimovaných dat, ale také všechny následující.
Existují přístupy k řešení tohoto problému:
- Prevence vzniku problému - přidávání nadbytečnosti do komprimovaných dat, která umožní určovat a opravovat chyby; o tom si povíme později;
- Minimalizace následků v případě vzniku problému
Jak jsme již dříve zmínili, je možné každý blok dat komprimovat nezávisle, čímž problém sám zmizí (poškození dat jednoho bloku povede ke ztrátě dat pouze tohoto bloku). Nicméně, to je krajní případ, kdy bude komprese dat neefektivní. Opačná krajnost: použít všech 4 MB našeho čipu jako jednotný archiv, což nám poskytne vynikající kompresi, ale katastrofální důsledky v případě poškození dat.
Ano, je potřebný kompromis z hlediska spolehlivosti. Ale musíme mít na paměti, že vyvíjíme formát ukládání dat pro energeticky nezávislou paměť s extrémně nízkým BER a deklarovanou dobou uchovávání dat 20 let.
Během experimentů jsem zjistil, že více-méně znatelné ztráty úrovně komprese začínají na blocích komprimovaných dat o velikosti méně než 10 kB.
Dříve bylo zmíněno, že používaná paměť má stránkovou organizaci, nevidím důvod, proč bychom neměli používat shodu „jedna stránka - jeden blok komprimovaných dat“.
To znamená, že minimální rozumná velikost stránky je 16 kB (s rezervou na administrativní informace). Nicméně tak malá velikost stránky klade značná omezení na maximální velikost záznamu.
I když zatím neplánuji záznamy větší než jeden kilobajt v komprimované formě, rozhodl jsem se použít stránky o velikosti 32 kB (celkem tedy 128 stránek na čip).
Shrnutí:
- Data ukládáme komprimovaná pomocí zlib (deflate);
- Pro každý záznam nastavujeme Z_SYNC_FLUSH;
- U každého komprimovaného záznamu zkracujeme koncové bajty (například 0x00, 0x00, 0xff, 0xff); v hlavičce uvádíme kolik bajtů jsme zkrátili;
- Data are stored in pages of 32KB; within the page, there is a continuous stream of compressed data; we start compression anew on each page.
And before we finish with compression, I would like to point out that we only get a few bytes of compressed data per record, so it is extremely important not to inflate the metadata, every byte counts here.
Storage of data headers
Since we have variable-length records, we need to determine the placement/boundaries of the records somehow.
I know three approaches:
- All records are stored in a continuous stream, with the record header first, containing the length, followed by the record itself.
In this option, both headers and data can have variable lengths.
Essentially, we end up with a singly linked list that is used frequently; - Headers and records are stored in separate streams.
By using fixed-length headers, we ensure that the corruption of one header does not affect the others.
This approach is used, for example, in many file systems; - Records are stored in a continuous stream, with the record boundary defined by a specific marker (character/sequence of characters that are prohibited within the data blocks). If a marker appears within a record, we replace it with a certain sequence (escape it).
This approach is used, for example, in the PPP protocol.
I will illustrate.
Varianta 1:
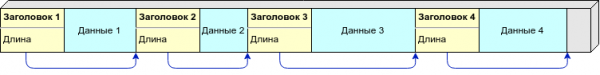
Here everything is very simple: knowing the length of the record, we can calculate the address of the next header. This is how we move through the headers until we encounter an area filled with 0xff (free space) or the end of the page.
Varianta 2:
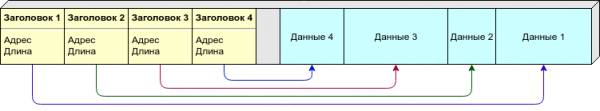
Due to the variable length of records, we cannot anticipate how many records (and hence headers) will be needed on a page. We could spread headers and data across different pages, but I prefer another approach: both headers and data are placed on the same page, with headers (of fixed size) starting from the beginning of the page and data (of variable length) starting from the end. As soon as they 'meet' (there isn't enough free space for a new record) — we consider this page filled.
Varianta 3:

Není potřeba uchovávat délku nebo jinou informaci o umístění dat v hlavičce, stačí značky, které určují hranice záznamů. Nicméně data je třeba zpracovávat při zápisu/čtení.
Jako značku bych použil 0xff (kterým je stránka vyplněna po vymazání), takže volný prostor nebude určitě chápán jako data.
Srovnávací tabulka:
Možnost 1
Možnost 2
Varianta 3
Odolnost vůči chybám
—
+
+
Kompaktnost
+
—
+
Složitost realizace
*
**
**
Varianta 1 má zásadní nevýhodu: při poškození jakékoli hlavičky se zhroutí celý následující řetězec. Ostatní varianty umožňují obnovit část dat i při hromadných poškozeních.
Ale zde se hodí připomenout, že jsme se rozhodli uchovávat data ve stlačené podobě, takže stejně ztrácíme všechna data na stránce po 'poškozeném' záznamu, takže ačkoliv v tabulce je mínus, nezapočítáváme ho.
Kompaktnost:
- v první variantě musíme uchovávat v hlavičce pouze délku, pokud použijeme celé proměnné délky, v drtivé většině případů se můžeme obejít jedním bajtem;
- ve druhé variantě musíme uchovávat počáteční adresu a délku; záznam musí mít konstantní velikost, odhaduji 4 bajty na záznam (dva bajty na posun a dva bajty na délku);
- třetí variantě stačí jediný znak k označení začátku záznamu, plus samotný záznam se kvůli escapování zvýší o 1-2%. Celkově přibližně parita s první variantou.
Původně jsem druhou variantu považoval za hlavní (a dokonce jsem napsal implementaci). Odmítl jsem ji pouze poté, co jsem se definitivně rozhodl používat kompresi.
Možná někdy opravdu budu používat podobnou variantu. Například pokud budu muset zajišťovat ukládání dat pro loď plující mezi Zemí a Marsem — zcela jiné požadavky na spolehlivost, kosmické záření,…
Pokud jde o třetí variantu: dal jsem jí dvě hvězdičky za složitost realizace jen proto, že se mi nelíbí se zabývat escapováním, změnou délky v průběhu atd. Ano, možná je to zaujaté, ale kód budu psát já — proč se nutit dělat to, co se mi nelíbí.
Shrnutí: vybíráme variantu ukládání ve formě řetězců 'hlavička s délkou — data proměnné délky' kvůli efektivitě a jednoduchosti realizace.
Použití bitových polí k monitorování úspěšnosti operací zápisu
Už si nepamatuji, kde jsem viděl tento nápad, ale vypadá to takto:
Pro každý záznam vyčleníme několik bitů na uchování flagů.
Jak jsme již dříve zmínili, po vymazání jsou všechny bity vyplněny 1 a můžeme měnit 1 na 0, ale ne naopak. Takže pro "flag není nastaven" používáme 1, pro "flag je nastaven" — 0.
Takto může vypadat umístění proměnné délky v paměti flash:
- Nastavujeme flag "zápis délky začal";
- Zapisujeme délku;
- Nastavujeme flag "zápis dat začal";
- Zapisujeme data;
- Nastavujeme flag "zápis skončil".
Kromě toho budeme mít flag "došlo k chybě", celkem 4 bitové flagy.
V tomto případě máme dva stabilní stavy "1111" — zápis nezačal a "1000" — zápis proběhl úspěšně; v případě nečekaného přerušení procesu zápisu získáme přechodné stavy, které pak můžeme rozpoznat a zpracovat.
Přístup je zajímavý, ale chrání pouze před náhlým vypnutím napájení a podobnými poruchami, což je samozřejmě důležité, avšak to rozhodně není jediný (a dokonce ani hlavní) důvod možných selhání.
Shrnutí: Pokračujeme dále v hledání dobrého řešení.
Kontrolní součty
Kontrolní součty také umožňují s dostatečnou pravděpodobností ověřit, že čteme přesně to, co mělo být zapsáno. A na rozdíl od výše zmíněných bitových polí fungují vždy.
Pokud se podíváme na seznam potenciálních zdrojů problémů, o kterých jsme hovořili výše, pak kontrolní součet dokáže rozpoznat chybu bez ohledu na její původ (s výjimkou, asi, zlých mimozemšťanů — ti mohou podvrhnout i kontrolní součet).
Takže pokud je naším cílem zkontrolovat, že data jsou v pořádku, kontrolní součty jsou skvělý nápad.
Volba algoritmu pro výpočet kontrolního součtu nevyvolala žádné otázky — CRC. Z pozitivní stránky, matematické vlastnosti umožňují v 100% chytit chyby některých typů, z pohledu náhodných dat obvykle tento algoritmus ukazuje pravděpodobnost kolizí ne výrazně vyšší než teoretický limit.  Ačkoliv to není nejrychlejší algoritmus a není vždy minimální co do počtu kolizí, má jednu velmi důležitou vlastnost: ve všech testech, které jsem prováděl, se nevyskytly vzory, na kterých by selhával. Stabilita je v tomto případě klíčovou vlastností.
Příklad rozsáhlého výzkumu: , (odkaz na narod.ru, omlouvám se).
Úkol vybrat kontrolní součet však není u konce, CRC je celá rodina kontrolních součtů. Musíme se rozhodnout o délce a poté vybrat polynom.
Výběr délky kontrolního součtu není tak jednoduchá otázka, jak se na první pohled zdá.
Ilustruji:
Předpokládejme, že pravděpodobnost chyby v každém bajtu  a ideální kontrolní součet, spočítejme průměrný počet chyb na milion záznamů:
Data, bajt
Kontrolní součet, bajt
Nezjištěné chyby
Falešně zjištěné chyby
Celkem nesprávných aktivací
1
0
1000
0
1000
1
1
4
999
1003
1
2
≈0
1997
1997
1
4
≈0
3990
3990
10
0
9955
0
9955
10
1
39
990
1029
10
2
≈0
1979
1979
10
4
≈0
3954
3954
1000
0
632305
0
632305
1000
1
2470
368
2838
1000
2
10
735
745
1000
4
≈0
1469
1469
Zdálo by se, že je to jednoduché — vybírej podle délky chráněných dat délku kontrolního součtu s minimem nesprávných aktivací — a je to vyřešeno.
Nicméně, s krátkými kontrolními součty nastává problém: ačkoliv dobře detekují jednotlivé bitové chyby, mohou s dostatečně velkou pravděpodobností považovat za správné zcela náhodná data. Na Habr již byl článek, který popisoval .
Proto, aby se prakticky znemožnilo náhodné shodování kontrolního součtu, je nutné používat kontrolní součty o délce 32 bitů a více (pro délky nad 64 bitů se obvykle používají kryptografické hashovací funkce).
I když jsem dříve psal, že je třeba šetřit místo všemi možnými způsoby, přesto použijeme 32-bitový kontrolní součet (16 bitů je málo, pravděpodobnost kolize je více než 0,01%; a 24 bitů, jak se říká, je napůl).
Může tu vzniknout námitka: šetřili jsme každý bajt při výběru komprese, abychom nyní odevzdali 4 bajty najednou? Není lepší nescompress a nepřidávat kontrolní součet? Samozřejmě že ne, absence komprese neznamená, že kontrola integrity nám není potřeba.
Nebudeme vymýšlet kolo, pokud jde o výběr polynomu, ale vezmeme v současnosti populární CRC-32C.
Tento kód detekuje 6 bitových chyb v paketech do 22 bajtů (snad nejčastější případ pro nás), 4 bitové chyby v paketech do 655 bajtů (taktéž častý případ pro nás) a 2 nebo jakékoliv neparitní číslo bitových chyb v paketech jakékoli rozumné délky.
Pokud někoho zajímají detaily
o CRC.
na — snad největšího odborníka na CRC na planetě.
V položka „Přesunout karty“. Kromě toho , který poskytuje o něco lepší parametry pro aktuální délky paketů, ale rozdíl jsem nepovažoval za významný a jsem dostatečně kompetentní, abych si vybral vlastní kód místo standardního a dobře prozkoumaného.
Dále, jelikož máme data komprimována, vyvstává otázka: počítat kontrolní součet z komprimovaných nebo nekomprimovaných dat?
Argumenty „pro“ počítání kontrolního součtu nekomprimovaných dat:
- nakonec musíme ověřit integritu uchovávání dat — a to kontrolujeme přímo (přitom budou také ověřeny možné chyby v implementaci komprese/dekomprese, poškození způsobené vadnou pamětí atd.);
- algoritmus deflate v zlib má dostatečně vyzrálou implementaci a neměl by selhávat při „zkreslených“ vstupních datech, navíc často dokáže sám odhalit chyby ve vstupním toku, čímž snižuje celkovou pravděpodobnost neodhalení chyby (prováděl jsem test s invertováním jednotlivého bitu v krátkém záznamu, zlib chybu zjistil přibližně ve třetině případů).
Argumenty „proti“ počítání kontrolního součtu nekomprimovaných dat:
- CRC „je nastaven“ právě na málo početné bitové chyby, které jsou typické pro flash paměti (bitová chyba v komprimovaném toku může způsobit hromadnou změnu výstupního toku, na kterém teoreticky můžeme „chytit“ kolizi);
- nepřijímám příliš rád myšlenku předávat dekompresoru potenciálně poškozená data, jak na to zareaguje.
V tomto projektu jsem se rozhodl odchýlit od obecně přijímané praxe uchovávání kontrolního součtu nekomprimovaných dat.
Shrnutí: používáme CRC-32C, kontrolní součet počítáme z dat v podobě, v jaké jsou zapisována do flash (po kompresi).
Redundance
Použití redundatního kódování samozřejmě neeliminuje ztrátu dat, avšak může výrazně (často o mnoho řádů) snížit pravděpodobnost nenávratné ztráty dat.
Můžeme využít různé typy redundance k opravě chyb.
Hammingovy kódy mohou opravit jednotlivé bitové chyby, Reed-Solomonovy kódy jsou symbolové, několik kopií dat spolu s kontrolními součty nebo kódování jako RAID-6 mohou pomoci obnovit data i v případě hromadných poškození.
Zpočátku jsem byl nastaven na široké využití kódování odolného vůči chybám, ale poté jsem si uvědomil, že je nejdříve třeba mít představu o tom, proti jakým chybám se chceme chránit, a poté vybírat kódování.
O dřívějším jsme mluvili, že chyby je třeba odhalovat co nejdříve. Kdy se můžeme setkat s chybami?
- Nedokončený zápis (například z důvodu výpadku napájení v okamžiku zápisu, zamrznutí Raspberry, …)
Bohužel v případě podobné chyby zůstává pouze ignorovat neplatné záznamy a považovat data za ztracená; - Chyby zápisu (z nějakého důvodu bylo do flash paměti zapsáno něco jiného, než bylo zamýšleno)
Takové chyby můžeme ihned odhalit, pokud po zápisu provedeme kontrolní čtení; - Deformace dat v paměti během skladování;
- Chyby čtení
Pro opravu stačí v případě nesouladu kontrolního součtu několikrát zopakovat čtení.
To znamená, že pouze chyby třetího typu (náhodné poškození dat během skladování) nemohou být opraveny bez odolného kódování. Domnívám se, že takové chyby jsou přesto extrémně nepravděpodobné.
Shrnutí: Bylo rozhodnuto se vzdát redundatního kódování, ale pokud se ukáže, že toto rozhodnutí bylo chybné, vrátíme se k přehodnocení otázky (s již nahromaděnou statistikou o poruchách, která umožní zvolit optimální typ kódování).
Ostatní
Samozřejmě, formát článku neumožňuje obhájit každou bitovou hodnotu v rozsahu (a už jsem také vyčerpal síly), proto stručně projdu některé momenty, které nebyly dříve zmíněny.
- Rozhodnuto udělat všechny stránky „rovnocenné“.
Tedy nebudou žádné speciální stránky s metadaty, oddělenými proudy atd., místo toho bude jeden proud, který přepisuje všechny stránky postupně.
To zajišťuje rovnoměrné opotřebení stránek, absence jediné poruchové oblasti a jednoduše se to líbí; - Je třeba se postarat o verzování formátu.
Formát bez čísla verze v záhlaví je zlo!
Stačí přidat do zhlaví stránky pole s jakýmisi Magic Number (podpisem), které označuje používanou verzi formátu. (nemyslím, že jich v praxi bude ani deset); - Používat pro záznamy (kterých je velmi mnoho) zhlaví proměnné délky, přičemž se snažit, aby většina případů měla délku 1 bajt;
- Pro kódování délky zhlaví a délky oříznuté části komprimovaného záznamu používat binární kódy proměnné délky.
Hodně pomohl kódů Huffmana. Doslova během několika minut se podařilo najít potřebné kódy proměnné délky.
Popis formátu ukládání dat
Byte order
Pole, která mají velikost větší než 1 bajt, jsou uložena ve formátu big-endian (network byte order), tedy 0x1234 je zapsáno jako 0x12, 0x34.
Rozdělení na stránky
Celá flash paměť je rozdělena na stránky stejné velikosti.
Velikost stránky je podle defaultu 32 KB, ale maximálně 1/4 celkové velikosti paměťového čipu (pro čip o velikosti 4 MB to dává 128 stránek).
Každá stránka uchovává data nezávisle na ostatních (tedy data jedné stránky se neodkazují na data jiné stránky).
Všechny stránky jsou číslovány v přirozeném pořadí (ve vzestupném pořadí adres), počínaje číslem 0 (nulová stránka začíná na adrese 0, první na 32 KB, druhá na 64 KB atd.)
Paměťový čip se používá jako cyklický buffer (ring buffer), tedy nejprve se zápis provádí na stránku číslo 0, pak na stránku číslo 1, … když naplníme poslední stránku, začíná nový cyklus a zápis pokračuje z nulové stránky.
Uvnitř stránky
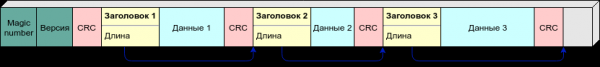
Na začátku stránky se nachází 4-bajtové zhlaví stránky, pak kontrolní součet zhlaví (CRC-32C), dále se ukládají záznamy ve formátu „zhlaví, data, kontrolní součet“.
Zhlaví stránky (na schématu špinavě zelené) se skládá z:
- dvojbajtového pole Magic Number (také známého jako znak verze formátu)
pro aktuální verzi formátu se považuje jako0xed00 ⊕ číslo stránky; - dvoubajtového čítače „Verze stránky“ (číslo cyklu přepisování paměti).
Záznamy na stránce jsou ukládány ve zkomprimované podobě (používá se algoritmus deflate). Všechny záznamy na jedné stránce jsou komprimovány v jednom proudu (používá se sdílený slovník), na každé nové stránce se komprese začíná znovu. To znamená, že pro dekompresi jakéhokoliv záznamu jsou potřeba všechny předchozí záznamy z této stránky (a pouze z této).
Každý záznam bude komprimován s flagem Z_SYNC_FLUSH, přičemž na konci komprimovaného proudu se ocitnou 4 bajty 0x00, 0x00, 0xff, 0xff, předcházené, možná, ještě jedním nebo dvěma nulovými bajty.
Tento sekvenci (o délce 4, 5 nebo 6 bajtů) ignorujeme při zápisu do flash paměti.
Hlavička záznamu se skládá z 1, 2 nebo 3 bajtů, které obsahují:
- jeden bit (T), znamenající typ záznamu: 0 — kontext, 1 — protokol;
- pole proměnné délky (S) od 1 do 7 bitů, určující délku hlavičky a „ocas“, který je třeba přidat k záznamu pro rozbalení;
- délku záznamu (L).
Tabulka hodnot S:
S
Délka hlavičky, bajt
Ignorováno při zápisu, bajt
0
1
5 (00 00 00 ff ff)
10
1
6 (00 00 00 00 ff ff)
110
2
4 (00 00 ff ff)
1110
2
5 (00 00 00 ff ff)
11110
2
6 (00 00 00 00 ff ff)
1111100
3
4 (00 00 ff ff)
1111101
3
5 (00 00 00 ff ff)
1111110
3
6 (00 00 00 00 ff ff)
Snažil jsem se ilustrovat, nevím, jak moc se to povedlo:
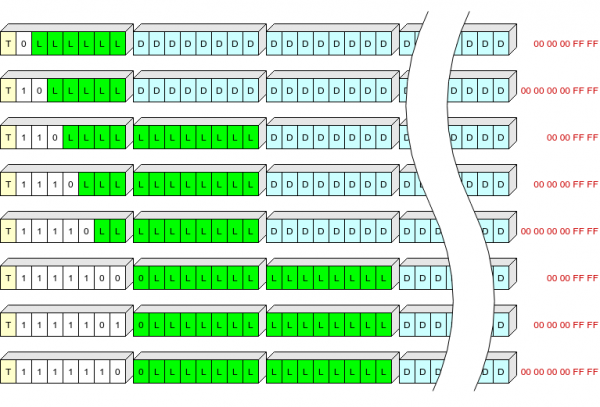
Žlutě je zde vyznačeno pole T, bíle — pole S, zeleně L (délka zkomprimovaných dat v bajtech), modře — zkomprimovaná data, červeně — koncové bajty zkomprimovaných dat, které se neukládají do flash paměti.
Takže hlavičky záznamů nejběžnější délky (až 63+5 bajtů ve zkomprimované podobě) dokážeme zapsat jedním bajtem.
Po každém záznamu se uchovává kontrolní součet CRC-32C, přičemž jako počáteční hodnota (init) se používá invertovaná hodnota předchozího kontrolního součtu.
CRC má vlastnost „pokračování“, funguje (plus-mínus invertování bitů v procesu) takto:  .
To znamená, že vlastně počítáme CRC všech předchozích bajtů hlaviček a dat na této stránce.
Bezprostředně za kontrolním součtem se nachází hlavička dalšího záznamu.
Hlavička je konstruována tak, aby první bajt byl vždy odlišný od 0x00 a 0xff (pokud místo prvního bajtu hlavičky narazíme na 0xff, znamená to, že tohle je dosud nevyužívaná oblast; 0x00 signalizuje chybu).
Přibližné algoritmy
Čtení z flash paměti
Každé čtení probíhá s kontrolou kontrolního součtu.
Pokud se kontrolní součet neshoduje, čtení se opakuje několikrát s nadějí, že se podaří přečíst správná data.
(to dává smysl, Linux neukládá do mezipaměti čtení z NOR Flash, ověřeno)
Zápis do flash paměti
Zapisujeme data.
Čteme je.
Pokud se přečtená data neshodují se zapsanými, vyplníme oblast nulami a signalizujeme chybu.
Příprava nové čipové sady k práci
Pro inicializaci se na první (spíše nulové) stránce zapisuje záhlaví s verzí 1.
Poté se na tuto stránku zapisuje počáteční kontext (obsahuje UUID automatu a výchozí nastavení).
Vše, flash paměť je připravena k práci.
Nahrání automatu
Při nahrávání se čte prvních 8 bajtů každé stránky (záhlaví + CRC), stránky s neznámým Magic Number nebo chybným CRC se ignorují.
Z "správných" stránek se vybírají stránky s maximální verzí, z nich se bere stránka s největším číslem.
Čte se první záznam, kontroluje se správnost CRC a přítomnost příznaku „kontekst“. Pokud je vše v pořádku, tato stránka je považována za aktuální. Pokud ne, vracíme se na předchozí, dokud nenajdeme „živou“ stránku.
Na nalezené stránce přečteme všechny záznamy, ty s příznakem „kontekst“ aplikujeme.
Uložíme slovník zlib (bude potřebný pro záznam na tuto stránku).
Vše, nahrání dokončeno, kontext obnoven, nyní je možné pracovat.
Přidání záznamu do žurnálu
Komprimujeme záznam s správným slovníkem, uvádíme Z_SYNC_FLUSH. Kontrolujeme, zda se zkomprimovaný záznam vejde na aktuální stránku.
Pokud se nevejde (nebo na stránce byly chyby CRC) – začínáme novou stránku (viz níže).
Zapisujeme záznam a CRC. Pokud došlo k chybě, začínáme novou stránku.
Nová stránka
Vybereme volnou stránku s minimálním číslem (volnou považujeme stránku s chybným kontrolním součtem v záhlaví nebo s verzí nižší než aktuální). Pokud takové stránky nejsou, vybíráme stránku s minimálním číslem z těch, které mají verzi rovnou aktuální.
Pro vybranou stránku provedeme erase. Porovnáme obsah s 0xff. Pokud je něco špatně, vezmeme další volnou stránku atd.
Na smazanou stránku zapisujeme záhlaví, první záznam aktuální stav kontextu, následující nezapsaný záznam žurnálu (pokud nějaký existuje).
Použitelnost formátu
Podle mého názoru se jedná o slušný formát pro ukládání jakýchkoli více či méně komprimovatelných toků informací (běžný text, JSON, MessagePack, CBOR, možná protobuf) do NOR Flash.
Samozřejmě, formát je „uzpůsoben“ pro SLC NOR Flash.
Není vhodné jej používat s médii s vysokou BER, například NAND nebo MLC NOR. (existuje vůbec taková paměť v prodeji? Setkal jsem se s ní pouze v pracích na kódy oprav)..
Tím spíše není vhodné jej používat s zařízeními, která mají svůj FTL: USB flash, SD, MicroSD atd. (pro takovou paměť jsem vytvořil formát s velikostí stránky 512 bytů, podpisem na začátku každé stránky a unikátními čísly záznamů — někdy se podařilo obnovit všechna data prostým sekvenčním čtením z „pokazil“ flashky)..
V závislosti na úkolech lze formát bez změn používat na fleškách od 128Kbit (16Kb) do 1Gbit (128Mb). Při přání lze použít i na čipech větší kapacity, jen asi bude nutné upravit velikost stránky. (Ale zde už vyvstává otázka ekonomické efektivity, cena za velkou kapacitu NOR Flash není příliš povzbudivá)..
Pokud se někomu formát zdál zajímavý a chtěl by jej použít v otevřeném projektu — pište, pokusím se najít čas, upravit kód a zveřejnit jej na githubu.
Závěr
Jak vidíme, nakonec se formát ukázal jako jednoduchý. A dokonce i nudný..
V článku je obtížné vyjádřit evoluci svého názoru, ale věřte mi: původně jsem chtěl vytvořit něco vychytaného, nezničitelného, schopného přežít i po jaderném výbuchu v těsné blízkosti. Nicméně, rozum (doufám) nakonec zvítězil a postupně se priority posunuly k jednoduchosti a kompaktnosti.
Může se stát, že jsem se zmýlil? Ano, samozřejmě. Může se ukázat, že jsme zakoupili špatnou dávku čipů. Nebo z jiného důvodu zařízení nenaplní očekávání ohledně spolehlivosti.
Mám plány pro takový případ? Myslím, že po přečtení článku nepochybujete, že plány mám. A dokonce víc než jeden.
Pokud to vezmeme trochu vážněji, formát byl navržen současně jako pracovní varianta a jako „zkouška“.
V současné době vše na stole funguje normálně, doslova v posledních dnech bude řešení nasazeno. (přibližně) na stovkách zařízení, podíváme se, co se stane v "boji" (doufám, že formát umožňuje spolehlivě detekovat chyby; takže se podaří shromáždit plnohodnotnou statistiku). Za několik měsíců budeme moci učinit závěry (a pokud se nedaří — tak i dříve).
Pokud se při používání objeví vážné problémy a bude třeba provést úpravy, určitě o tom napíšu.
Literatura
Nechtěl jsem sestavovat dlouhý nudný seznam použitých prací, koneckonců Google mají všichni.
Tady jsem se rozhodl ponechat seznam nálezů, které se mi zdály obzvlášť zajímavé, ale postupně se přesunuly přímo do textu článku a v seznamu zůstal jen jeden bod:
- Nástroj od autora zlib. Umí v přehledné podobě zobrazit obsah archivů deflate/zlib/gzip. Pokud se musíte zabývat vnitřní strukturou formátu deflate (nebo gzip) — důrazně doporučuji.
Zdroj: habr.com
