

Počkejte! Omlouvám se, ale tohle není další článek o typech záloh SQL Serveru. Ani se nebudu zabývat rozdíly mezi modely obnovy a jak se vyrovnat s nadměrným „logem“.
Je možné (jen možné), že po přečtení tohoto příspěvku budete schopni zajistit, aby záloha, která se standardními prostředky každý den probíhá, byla zítra v noci provedena o 1,5krát rychleji. A to pouze díky tomu, že použijete o něco více parametrů BACKUP DATABASE.
Pokud vám obsah příspěvku připadal zřejmý — omlouvám se. Pročetl jsem všechno, co jsem na Googlu našel na frázi „habr sql server backup“, a v žádném článku jsem nenarazil na zmínku, že by na čas zálohy šlo nějakým způsobem ovlivnit pomocí parametrů.
Okamžitě vás upozorním na komentář Alexandra Gladčenka ():
Nikdy neměňte parametry BUFFERCOUNT, BLOCKSIZE, MAXTRANSFERSIZE na produkčním prostředí. Ty jsou určeny pouze pro psaní podobných článků. V praxi narazíte na problémy s pamětí u plného nasazení.
Bylo by samozřejmě skvělé být tím nejchytřejším a zveřejnit exkluzivní obsah, ale bohužel to tak není. Existují jak anglické, tak ruské články/příspěvky (vždy se pletu, jak je správně nazývat) věnované tomuto tématu. Tady je část z těch, které jsem našel: , , .
Takže na začátek přikládám mírně zkrácenou syntaxi BACKUP z (mimochodem, tam nahoře jsem psal o BACKUP DATABASE, ale všechno to platí i pro zálohu transakčního logu a diferentialní zálohu, i když možná s méně jasným efektem):
BACKUP DATABASE { database_name | @database_name_var }
  TO  [ ,...n ]

  [ WITH {
           |  [ ,...n ] } ]
[;]

 [ ,...n ]::=

--Media Set Options

 | BLOCKSIZE = { blocksize | @blocksize_variable }

--Data Transfer Options
   BUFFERCOUNT = { buffercount | @buffercount_variable }
 | MAXTRANSFERSIZE = { maxtransfersize | @maxtransfersize_variable }
— znamená, že tam něco bylo, ale to jsem odstranil, protože se to k tématu nyní nehodí.
Jak obvykle získáváte zálohu? Jak vás „učí“ zálohovat v miliardách článků? Pokud bych měl jednorázově zálohovat nějakou ne příliš velkou databázi, automaticky bych napsal něco jako:
BACKUP DATABASE smth
TO DISK = 'D:Backupsmth.bak'
WITH STATS = 10, CHECKSUM, COMPRESSION, COPY_ONLY;
--dobře, CHECKSUM jsem napsal jen abych vypadal chytře
A v podstatě, tady je asi uvedeno 75-90 % všech parametrů, které se obvykle zmiňují v článcích o zálohách. No a tam je ještě INIT, SKIP. A byli jste někdy v MSDN? Viděli jste, že tam je možností na jedno a půl obrazovky? Já jsem to také viděl...
Asi jste už pochopili, že se nyní budeme bavit o třech parametrech, které zůstaly v prvním bloku kódu — BLOCKSIZE, BUFFERCOUNT a MAXTRANSFERSIZE. Zde jsou jejich popisy z MSDN:
BLOCKSIZE = { blocksize | @ blocksize_variable } - určuje velikost fyzického bloku v bytech. Podporované velikosti jsou 512, 1024, 2048, 4096, 8192, 16 384, 32 768 a 65 536 bytů (64 KB). Výchozí hodnota je 65 536 pro pásek a 512 pro ostatní zařízení. Obvykle není třeba tento parametr nastavovat, protože instrukce BACKUP automaticky vybere velikost bloku odpovídající zařízení. Výslovné nastavení velikosti bloku přepíše automatický výběr velikosti bloku.
BUFFERCOUNT = { buffercount | @ buffercount_variable } - určuje celkový počet vstupně-výstupních bufferů, které budou použity pro operaci zálohování. Můžete uvést jakékoli kladné celé číslo, ale vysoký počet bufferů může vyvolat chybu nedostatku paměti kvůli nadměrnému virtuálnímu adresnímu prostoru během procesu Sqlservr.exe.
Celkový objem prostoru, který buffer používá, se určuje podle následujícího vzorce:
BUFFERCOUNT * MAXTRANSFERSIZE.
MAXTRANSFERSIZE = { maxtransfersize | @ maxtransfersize_variable } určuje maximální objem datového balíčku v bytech pro výměnu dat mezi SQL Serverem a médiem zálohy. Podporované hodnoty jsou násobky 65 536 bytů (64 KB), až do 4 194 304 bytů (4 MB).
Přísahám — četl jsem to dříve, ale nikdy mě nenapadlo, jaký vliv mohou mít na výkon. Navíc, evidentně musím provést určitý „coming out“ a přiznat, že ani nyní úplně nerozumím tomu, co přesně dělají. Asi bych se měl víc dočíst o buffered I/O a práci s pevným diskem. Jednou to udělám, ale teď mohu jen napsat skript, který zkontroluje, jak tyto hodnoty ovlivňují rychlost, s jakou se záloha vytváří.
Vytvořil jsem malou databázi o velikosti přibližně 10 GB, uložil ji na SSD a adresář pro zálohy na HDD.
Vytvářím dočasnou tabulku pro ukládání výsledků (u mě není dočasná, abyste se mohli podívat na výsledky podrobněji, ale rozhodněte se sami):
DROP TABLE IF EXISTS ##bt_results;

CREATE TABLE ##bt_results (
    id              int IDENTITY (1, 1) PRIMARY KEY,
    start_date      datetime NOT NULL,
    finish_date     datetime NOT NULL,
    backup_size     bigint NOT NULL,
    compressed_size bigint,
    block_size      int,
    buffer_count    int,
    transfer_size   int
);
Princip fungování skriptu je jednoduchý — vnořené smyčky, z nichž každá mění hodnotu jednoho parametru, předávám tyto parametry do příkazu BACKUP, uchovávám poslední záznam s historií z msdb.dbo.backupset, mažu zálohovací soubor a následuje další iterace. Protože data o provádění zálohy jsou získávána z backupset, přesnost je poněkud ztracena (není tam zlomková sekunda), ale to přečkáme.
Nejprve je potřeba povolit používání xp_cmdshell, abychom mohli mazat zálohy (poté nezapomeňte vypnout, pokud ho nepotřebujete):
EXEC sp_configure 'show advanced options', 1;
EXEC sp_configure 'xp_cmdshell', 1;
RECONFIGURE;
EXEC sp_configure 'show advanced options', 0;
GO
No a vlastně:
DECLARE @tmplt AS nvarchar(max) = N'
BACKUP DATABASE [bt]
TO DISK = ''D:SQLServerbackupbt.bak''
WITH
    COMPRESSION,
    BLOCKSIZE = {bs},
    BUFFERCOUNT = {bc},
    MAXTRANSFERSIZE = {ts}';

DECLARE @sql AS nvarchar(max);

/* HODNOTY BLOCKSIZE */
DECLARE @bs     int = 4096,
        @max_bs int = 65536;

/* HODNOTY BUFFERCOUNT */
DECLARE @bc     int = 7,
        @min_bc int = 7,
        @max_bc int = 800;

/* HODNOTY MAXTRANSFERSIZE */
DECLARE @ts     int = 524288,   --512KB, výchozí = 1024KB
        @min_ts int = 524288,
        @max_ts int = 4194304;  --4MB

SELECT TOP 1
    @bs = COALESCE (block_size, 4096),
    @bc = COALESCE (buffer_count, 7),
    @ts = COALESCE (transfer_size, 524288)
FROM ##bt_results
ORDER BY id DESC;

WHILE (@bs <= @max_bs)
BEGIN
    WHILE (@bc <= @max_bc)
    BEGIN
        WHILE (@ts <= @max_ts)
        BEGIN
            SET @sql = REPLACE (REPLACE (REPLACE(@tmplt, N'{bs}', CAST(@bs AS nvarchar(50))), N'{bc}', CAST (@bc AS nvarchar(50))), N'{ts}', CAST (@ts AS nvarchar(50)));

            EXEC (@sql);

            INSERT INTO ##bt_results (start_date, finish_date, backup_size, compressed_size, block_size, buffer_count, transfer_size)
            SELECT TOP 1 backup_start_date, backup_finish_date, backup_size, compressed_backup_size,  @bs, @bc, @ts
            FROM msdb.dbo.backupset
            ORDER BY backup_set_id DESC;

            EXEC xp_cmdshell 'del "D:SQLServerbackupbt.bak"', no_output;

            SET @ts += @ts;
        END

        SET @bc += @bc;
        SET @ts = @min_ts;

        WAITFOR DELAY '00:00:05';
    END

    SET @bs += @bs;
    SET @bc = @min_bc;
    SET @ts = @min_ts;
END
Pokud potřebujete vysvětlení ohledně toho, co se tady děje — napište do komentářů nebo soukromé zprávy. Zatím vám povím jen o parametrech, které předávám do BACKUP DATABASE.
Pro BLOCKSIZE máme "uzavřený" seznam hodnot, přičemž na mém systému se nezdařila záloha s BLOCKSIZE < 4KB. MAXTRANSFERSIZE je jakékoliv číslo dělitelné 64KB — od 64KB do 4MB. Ve výchozím nastavení je na mém systému 1024KB, vzal jsem 512 — 1024 — 2048 — 4096.
S BUFFERCOUNT to bylo složitější — může být jakékoliv kladné číslo, a přitom je v odkazu uvedeno, Také je tam popsáno, jak získat informace o tom, s jakým BUFFERCOUNT se záloha skutečně provádí — mám toto 7. Snižovat ho nemělo smysl, a horní hranice byla zjištěna empiricky — při BUFFERCOUNT = 896 a MAXTRANSFERSIZE = 4194304 záloha selhala s chybou (o které je ve výše uvedeném odkazu):
Msg 3013, Level 16, State 1, Line 7 BACKUP DATABASE se abnormálně ukončuje.
Msg 701, Level 17, State 123, Line 7 V systémovém paměťovém zdroji ‘default’ není dostatek systémové paměti pro spuštění tohoto dotazu.
Pro srovnání nejdříve ukážu výsledky provedení zálohy bez jakýchkoliv parametrů:
BACKUP DATABASE [bt]
TO DISK = 'D:SQLServerbackupbt.bak'
WITH COMPRESSION;
Tak, záloha a záloha:
Zpracováno 1070072 stránek pro databázi ‘bt’, soubor ‘bt’ na souboru 1.
Zpracováno 2 stránky pro databázi ‘bt’, soubor ‘bt_log’ na souboru 1.
BACKUP DATABASE úspěšně zpracoval 1070074 stránek za 53,171 sekundy (157,227 MB/s).
Samotný skript, který testoval parametry, pracoval několik hodin, všechna měření v . A tady je výběr výsledků, které měly tři nejlepší časy provedení (snažil jsem se udělat hezký graf, ale v příspěvku se budu muset obejít tabulkou, a v komentářích přidal ).
SELECT TOP 7 WITH TIES
    compressed_size,
    block_size,
    buffer_count,
    transfer_size,
    DATEDIFF(SECOND, start_date, finish_date) AS backup_time_sec
FROM ##bt_results
ORDER BY backup_time_sec ASC;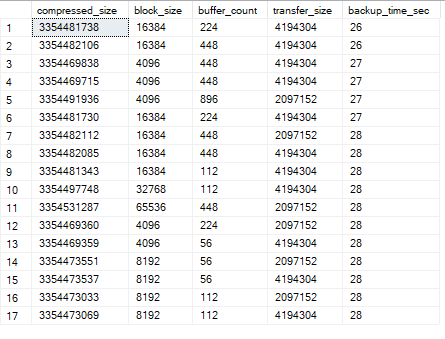
Pozor, hned důležitá poznámka od z :
bez pochyby lze říci, že vztah mezi parametry a rychlostí zálohy v těchto mezích hodnot je náhodný, žádná pravidelnost neexistuje. Ale odklon od vestavěných parametrů, je zřejmé, že měl pozitivní vliv na výsledek.
Tj. pouze díky řízení standardních parametrů BACKUP došlo k časovému zisku při provedení zálohy na 2 krát: 26 sekund, proti 53 na začátku. A to není špatné, že? Ale musíme se podívat, co se děje s obnovením. A co když bude nyní obnova trvat 4 krát déle?
Nejdříve změřme, jak dlouho trvá obnova zálohy s výchozími nastaveními:
RESTORE DATABASE [bt]
FROM DISK = 'D:SQLServerbackupbt.bak'
WITH REPLACE, RECOVERY;
No to víte vy sami, cesty tam, replace ano-ne, recovery ano-ne. A na mém systému to funguje takto:
Zpracováno 1070072 stránek pro databázi ‘bt’, soubor ‘bt’ na souboru 1.
Zpracováno 2 stránky pro databázi ‘bt’, soubor ‘bt_log’ na souboru 1.
RESTORE DATABASE úspěšně zpracoval 1070074 stran během 40,752 sekund (205,141 MB/s).
A teď se pokusím obnovit zálohy s upraveným BLOCKSIZE, BUFFERCOUNT a MAXTRANSFERSIZE.
BLOCKSIZE = 16384, BUFFERCOUNT = 224, MAXTRANSFERSIZE = 4194304RESTORE DATABASE úspěšně zpracoval 1070074 stran během 32,283 sekund (258,958 MB/s).
BLOCKSIZE = 4096, BUFFERCOUNT = 448, MAXTRANSFERSIZE = 4194304RESTORE DATABASE úspěšně zpracoval 1070074 stran během 32,682 sekund (255,796 MB/s).
BLOCKSIZE = 16384, BUFFERCOUNT = 448, MAXTRANSFERSIZE = 2097152RESTORE DATABASE úspěšně zpracoval 1070074 stran během 32,091 sekund (260,507 MB/s).
BLOCKSIZE = 4096, BUFFERCOUNT = 56, MAXTRANSFERSIZE = 4194304RESTORE DATABASE úspěšně zpracoval 1070074 stran během 32,401 sekund (258,015 MB/s).
Příkaz RESTORE DATABASE se při obnově nemění, tyto parametry se neurčují, SQL Server je určuje podle zálohy. A je vidět, že i při obnově může být zisk — prakticky o 20 % rychleji (po pravdě řečeno, věnoval jsem obnově málo času, projel jsem několik nej "rychlejších" záloh a ujistil se, že zhoršení není).
Pro jistotu upřesním — zde jsou popsány nikoli optimální parametry pro všechny. Optimální parametry si můžete získat pouze testováním. Já získal tyto výsledky, vy získáte jiné. Ale vidíte, že své zálohy lze "vyladit" a skutečně se mohou vytvářet a obnovovat rychleji.
Ještě naléhavě doporučuji přečíst si dokumentaci celou, protože právě pro váš systém mohou být nuance.
Pokud už píšu o zálohách, chci hned napsat ještě o jedné "optimalizaci", která se objevuje častěji než "tuning" parametrů (tu, jak chápu, používá minimálně část utilit pro zálohování, možná spolu s dříve uvedenými parametry), ale na Habru zatím nebyla popsána.
Pokud se podíváme na druhý řádek v dokumentaci, hned pod BACKUP DATABASE, vidíme tam:
TO [, ...n]Co si myslíte, co se stane, když uvedeme více backup_device? Syntaxe to přece umožňuje. A stane se velmi zajímavá věc — záloha se prostě "rozprostře" mezi několik zařízení. Tzn. každé "zařízení" bude zbytečné, ztratíme jedno, ztratíme celou zálohu. Ale jak se takové rozprostření projeví na rychlosti zálohování?
Zkusíme udělat zálohu na dvě "zařízení", která leží vedle sebe v jedné složce:
BACKUP DATABASE [bt]
TO
    DISK = 'D:SQLServerbackupbt1.bak',
    DISK = 'D:SQLServerbackupbt2.bak'
WITH COMPRESSION;
Pane Bože, co se to děje?
Zpracováno 1070072 stránek pro databázi ‘bt’, soubor ‘bt’ na souboru 1.
Zpracováno 2 stránky pro databázi ‚bt‘, soubor ‚btlog‘ v souboru 1.
ZÁLOHA DATABÁZE úspěšně zpracovala 1070074 stránek za 40.092 sekund (208.519 MB/s).
Záloha se udělala o 25 % rychleji, aniž by se něco změnilo? A když přidáme ještě pár zařízení?
ZÁLOHA DATABÁZE [bt]
DO
    DISK = 'D:SQLServerbackupbt1.bak',
    DISK = 'D:SQLServerbackupbt2.bak',
    DISK = 'D:SQLServerbackupbt3.bak',
    DISK = 'D:SQLServerbackupbt4.bak'
S KOMPRESE;
ZÁLOHA DATABÁZE úspěšně zpracovala 1070074 stránek za 34.234 sekund (244.200 MB/s).
Celkově tedy úspora přibližně 35 % času na vytvoření zálohy jen díky tomu, že záloha se zapisuje rovnou do 4 souborů na jednom disku. Zkoušel jsem větší množství — na mém notebooku úspora chyběla, optimální je 4 zařízení. Co se týče vás — nevím, musíte to vyzkoušet. A mimochodem, pokud máte tato zařízení — opravdu různé disky, gratuluji, úspora by měla být ještě výraznější.
Teď si povíme, jak to štěstí obnovit. K tomu bude třeba změnit příkaz pro obnovení a vyjmenovat všechna zařízení:
OBNOVIT DATABÁZI [bt]
Z
    DISK = 'D:SQLServerbackupbt1.bak',
    DISK = 'D:SQLServerbackupbt2.bak',
    DISK = 'D:SQLServerbackupbt3.bak',
    DISK = 'D:SQLServerbackupbt4.bak'
S NÁHRADOU, OBNOVENÍ;
OBNOVA DATABÁZE úspěšně zpracovala 1070074 stránek za 38.027 sekund (219.842 MB/s).
Trochu rychlejší, ale někde poblíž, ne podstatně. Obecně se záloha provádí rychleji, ale obnovuje se stejně — úspěch? Podle mého názoru — docela úspěch. To je důležité, proto se opakuji — pokud vy ztratíte alespoň jeden z těchto souborů — ztratíte celou zálohu..
Pokud se podíváte do protokolu s informacemi o záloze, které jsou zobrazovány pomocí Trace Flag 3213 a 3605, můžete si všimnout, že při záloze na několik zařízení se zvyšuje alespoň počet BUFFERCOUNT. Možná lze zkusit najít optimálnější parametry i pro BUFFERCOUNT, BLOCKSIZE, MAXTRANSFERSIZE, ale mě se to hned nepodařilo a chtít dělat takové testování znova, ale pro různé počty souborů, jsem se nechtěl. A také bych byl škoda disků. Pokud chcete uspořádat takové testování sami, změna skriptu není složitá.
Na závěr si promluvíme o ceně. Pokud se záloha provádí paralelně s prací uživatelů — je nutné velmi odpovědně přistoupit k testování, protože pokud se záloha provádí rychleji — disky jsou více zatěžovány, zátěž na procesoru roste (musí se všechno také ještě komprimovat za chodu), což snižuje celkovou odezvu systému.
Šeptáním, ale také chci říct, že jsem si vědom, že jsem žádné novinky nepřinesl. To, co jsem napsal výše, je prostě ukázka toho, jak lze nastavit optimální parametry pro provádění záloh.
Pamatujte, že všechno, co děláte, děláte na vlastní nebezpečí. Kontrolujte své zálohy a nezapomínejte na DBCC CHECKDB.
Zdroj: habr.com
