

Ahoj všichni! Jmenuji se Nikolaj Golov. Dříve jsem pracoval na Avito a šest let vedl Data Platform, tedy jsem se zabýval všemi databázemi: analytickými (Vertica, ClickHouse), streamovými a OLTP (Redis, Tarantool, VoltDB, MongoDB, PostgreSQL). Během této doby jsem se seznámil s velkým množstvím databází – nejrůznějšími a zvláštními, a s netradičními případy jejich použití.
Nyní pracuji v ManyChat. V podstatě je to startup – nový, ambiciózní a rychle rostoucí. A když jsem do firmy teprve nastoupil, objevil se klasický dotaz: „Jaká databáze by teď měla mladá startupová firma brát na trhu DBMS a databází?“
V tomto článku, založeném na mém povídání na , odpovím na tuto otázku. Videoversion přednášky je dostupná na .
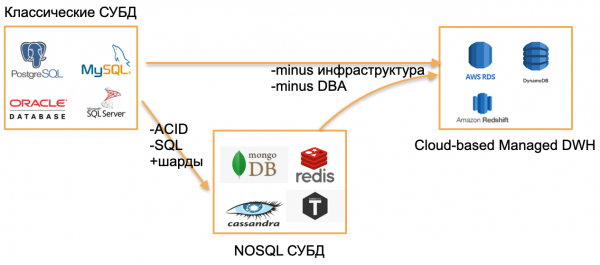
Obvyklé databáze roku 2020
Je rok 2020, podíval jsem se kolem a viděl tři typy DB.
První typ — klasické OLTP databáze: PostgreSQL, SQL Server, Oracle, MySQL. Byly napsané jako dávno, ale stále jsou relevantní, protože jsou dobře známé komunitě vývojářů.
Druhý typ — databáze z „nuly“. Snažily se vyhnout klasickým vzorům tím, že se vzdaly SQL, tradičních struktur a ACID, na základě integrovaného shardování a dalších atraktivních funkcí. Například to jsou Cassandra, MongoDB, Redis nebo Tarantool. Všechna tato řešení chtěla nabídnout trhu něco zásadně nového a našla si svou niku, protože v určitých úlohách se ukázala jako velmi pohodlná. Tyto databáze označím jako souhrnný termín NOSQL.
Nula skončila, na NOSQL databáze jsme si zvykli, a svět, z mého pohledu, udělal další krok — k managed databázím. Tyto databáze mají stejné jádro jako klasické OLTP databáze nebo nové NoSQL. Ale nepotřebují DBA ani DevOps a fungují na spravovaném hardwaru v cloudu. Pro vývojáře je to „jen databáze“, která někde funguje, a jak je nainstalována na serveru, kdo server nastavuje a kdo ho aktualizuje, nikoho nezajímá.
Příklady takových databází:
- AWS RDS — managed obal nad PostgreSQL/MySQL.
- DynamoDB — AWS ekvivalent dokumentové databáze, podobný Redis a MongoDB.
- Amazon Redshift — managed analytická databáze.
Základem jsou staré databáze, ale provozované v managed prostředí, bez nutnosti pracovat s hardwarem.
Poznámka. Příklady jsou vzaty pro prostředí AWS, ale jejich analogy také existují v Microsoft Azure, Google Cloud nebo Yandex.Cloud.
Co je na tom nového? V roce 2020 nic z toho.
Koncept Serverless
Skutečně novinkou na trhu v roce 2020 jsou bezserverová řešení.
Pokud bych to měl vysvětlit, použiji příklad běžné služby nebo backendové aplikace.
Pro nasazení běžné backendové aplikace koupíme nebo pronajmeme server, zkopírujeme na něj kód, zveřejníme venkovní endpoint a pravidelně platíme za pronájem, elektrickou energii a služby datového centra. To je standardní schéma.
Existuje jiný způsob? S bezserverovými službami ano.
O co v tomto přístupu jde: žádný server, dokonce ani pronájem virtuální instance v cloudu. Pro nasazení služby zkopírujeme kód (funkce) do repozitáře a zveřejníme venkovní endpoint. Poté platíme pouze za každé volání této funkce, úplně ignorujeme hardware, na kterém se vykonává.
Zkusím tento přístup ilustrovat na obrázcích.
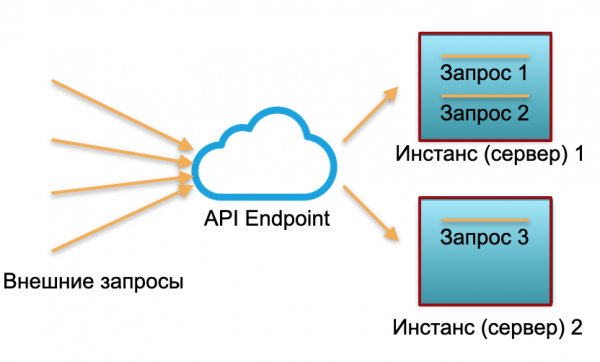
Klasické nasazení. Máme službu s určitou zátěží. Spouštíme dva instance: fyzické servery nebo instance v AWS. Na tyto instance směřují externí požadavky, které jsou tam zpracovávány.
Jak je vidět na obrázku, servery nejsou plně využity. Jeden je využit na 100%, zpracovává dva požadavky, a druhý pouze na 50% — částečně nevyužity. Pokud přijdou místo tří požadavků tři desítky, celý systém to nezvládne a začne se zpomalovat.
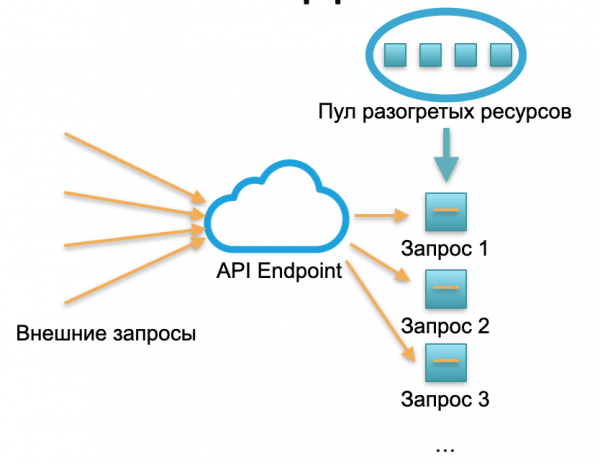
Bezserverové nasazení. V bezserverovém prostředí nemá podobná služba žádné instance ani servery. Existuje určitý pool vyhřátých zdrojů — malé připravené kontejnery Docker s nasazeným kódem funkce. Systém přijímá externí požadavky a na každý z nich bezserverový framework spouští malý kontejner s kódem: zpracovává tento konkrétní požadavek a pak kontejner zruší.
Jeden požadavek — jeden spuštěný kontejner, 1000 požadavků — 1000 kontejnerů. A nasazení na fyzických serverech je už prací cloudového poskytovatele. Tato činnost je zcela skryta bezserverovým frameworkem. V této koncepci platíme za každé volání. Například, přišel jeden požadavek za den — zaplatili jsme za jedno volání, přišel milion za minutu — zaplatili jsme za milion. Nebo za sekundu, to se také stává.
Koncept publikace bezserverové funkce vyhovuje pro stateless službu. Pokud však potřebujete statefull službu, přidáme k ní databázi. V tomto případě, když dojde na práci se stavem, každá statefull funkce jednoduše zapisuje a čte z databáze. Navíc z databáze jakéhokoli z tří typů popsaných na začátku článku.
Jaké je společné omezení všech těchto databází? Jsou to náklady na neustále používaný cloudový nebo fyzický server (nebo několik serverů). Nezáleží na tom, zda používáme klasickou databázi nebo managed, zda máme DevOps a administrátora, stejně tak platíme 24/7 za hardware, elektrickou energii a pronájem datového centra. Pokud máme klasickou databázi, platíme za master a slave. Pokud je to vysoce zatížená shardovaná databáze, platíme za 10, 20 nebo 30 serverů a to neustále.
Přítomnost trvale rezervovaných serverů v nákladech byla dříve vnímána jako nevyhnutelné zlo. Klasické databáze mají i další komplikace, jako jsou limity na počet připojení, omezení škálování, geograficky distribuovaný konsensus — tyto problémy lze vyřešit u určitých databází, ale ne všechny najednou a ne dokonale.
Bezserverová databáze — teorie
Otázka roku 2020: lze databázi rovněž vytvořit bezserverovou? Všichni slyšeli o bezserverovém backendu… co takhle zkusit udělat databázi bezserverovou?
Zní to podivně, protože databáze je přece statefull služba, která se pro bezserverovou infrastrukturu příliš nehodí. Navzdory tomu je stav databáze velmi rozsáhlý: gigabyty, terabyty, a v analytických databázích dokonce petabyty. Jen tak se to v lehkých Docker kontejnerých nezprovozuje.
Na druhé straně, téměř všechny moderní databáze jsou ohromné množství logiky a komponentů: transakce, zajištění integrity, procedury, relační závislosti a spousta logiky. Poměrně velká část logiky databáze potřebuje relativně malý stav. Gigabyty a terabyty se přímo používají jen malou částí logiky databáze, která souvisí s okamžitým prováděním dotazů.
Tím pádem je myšlenka: pokud část logiky dovoluje stateless provedení, proč bychom databázi nerozdělili na Stateful a Stateless části.
Serverless pro OLAP řešení
Podívejme se, jak může vypadat rozdělení databáze na Stateful a Stateless části na praktických příkladech.
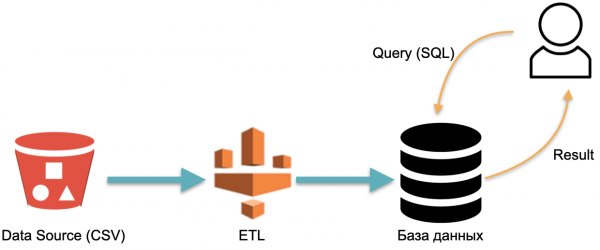
Například máme analytickou databázi: externí data (červený válec vlevo), ETL proces, který načítá data do databáze, a analytik, který posílá SQL dotazy k databázi. To je klasická schéma fungování datového skladu.
V této schémě se ETL provádí, řekněme, jednou. Dále je nutné neustále platit za servery, na kterých běží databáze se zde vloženými daty, aby bylo co dotazovat.
Podívejme se na alternativní přístup implementovaný v databázi AWS Athena Serverless. Zde neexistuje neustále přidělený hardware, na kterém jsou uložena načtená data. Místo toho:
- Uživatel posílá SQL dotaz k Athéně. Optimalizátor Athény analyzuje SQL dotaz a vyhledává ve skladu metadat (Metadata) konkrétní data potřebná k provedení dotazu.
- Optimalizátor na základě shromážděných dat extrahuje potřebná data z externích zdrojů do dočasného úložiště (dočasná databáze).
- V dočasném úložišti se provádí SQL dotaz od uživatele, výsledek se vrací uživateli.
- Dočasné úložiště se čistí, zdroje se uvolňují.
V této architektuře platíme pouze za proces provádění dotazu. Není žádný dotaz — nejsou žádné náklady.
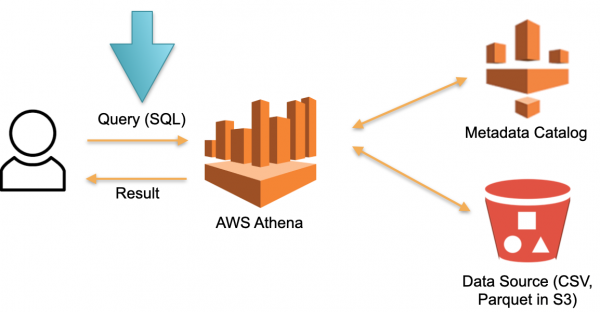
To je funkční přístup a realizuje se nejen v Athena Serverless, ale i v Redshift Spectrum (v AWS).
Na příkladu Athény je vidět, že databáze bez serveru pracuje na skutečných dotazech s desítkami a stovkami terabajtů dat. Pro stovky terabajtů budou potřeba stovky serverů, ale nemusíme za ně platit — platíme za dotazy. Rychlost každého dotazu je (velmi) nízká ve srovnání se specializovanými analytickými databázemi jako Vertica, ale za dobu nečinnosti neplatíme.
Taková databáze je použitelné pro vzácné analytické ad-hoc dotazy. Například když se spontánně rozhodneme prověřit hypotézu na nějakém obrovském objemu dat. Pro tyto případy je Athena ideální. Pro pravidelné dotazy se takový systém ukazuje jako nákladný. V tomto případě si data cacheujte v nějakém specializovaném řešení.
Serverless pro OLTP řešení
V předchozím příkladu byly zkoumány OLAP úkoly (analytické). Nyní se podíváme na úkoly OLTP.
Představme si škálovatelný PostgreSQL nebo MySQL. Vytvoříme běžnou spravovanou instanci PostgreSQL nebo MySQL na minimálních zdrojích. Když na instanci vzroste zátěž, připojíme další repliky, na které rozdělíme část čtecí zátěže. Pokud nejsou žádné požadavky a zátěž, repliky odpojíme. První instance je master a ostatní jsou repliky.
Tato myšlenka je realizována v databázi zvané Aurora Serverless AWS. Princip je jednoduchý: požadavky od externích aplikací přijímá proxy fleet. Když zaznamená růst zátěže, přidělí výpočetní zdroje z předem zahřátých minimálních instancí - připojení probíhá maximálně rychle. Odpojení instancí probíhá stejně.
V rámci Aurory existuje pojem Aurora Capacity Unit, ACU. Toto (podmíněně) je instance (server). Každý konkrétní ACU může být master nebo slave. Každá kapacitní jednotka má svou vlastní operační paměť, procesor a minimální disk. Odpovídajícím způsobem je jeden master a ostatní read-only repliky.
Počet těchto pracovních Aurora Capacity Units je nastavitelné parametry. Minimální počet může být jeden nebo nula (v takovém případě databáze nepracuje, pokud nejsou žádné požadavky).
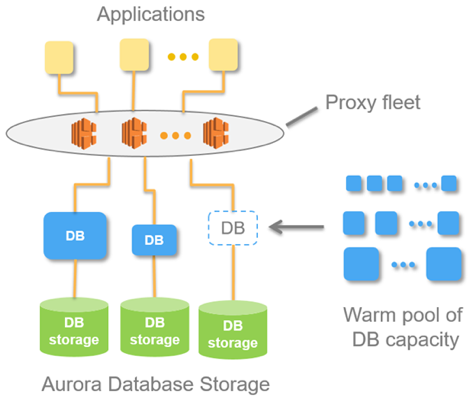
Když databáze přijme požadavky, proxy fleet zvyšuje Aurora Capacity Units, čímž zvyšuje výkonnostní zdroje systému. Možnost zvyšovat a snižovat zdroje umožňuje systému "žonglovat" s prostředky: automaticky vypínat jednotlivé ACU (nahrazovat je novými) a aplikovat na vypnuté zdroje všechny aktuální aktualizace.
Databáze Aurora Serverless může škálovat čtecí zátěž. Ale v dokumentaci o tom není přímo uvedeno. Může vzniknout dojem, že mohou mít multi-master. Žádné kouzlo tu však není.
Tato databáze je ideální pro minimalizaci nákladů na systémy s nepředvídatelným přístupem. Například při vytváření MVP nebo marketingových landing pages obvykle neočekáváme stabilní zátěž. Při absenci přístupu tedy neplatíme za instance. Když náhle dojde k nárůstu zátěže, například po konferenci nebo reklamní kampani, davy lidí přistupují na web a zatížení rychle vzrůstá, Aurora Serverless automaticky akceptuje tuto zátěž a rychle zapojuje chybějící prostředky (ACU). Po konferenci se zájem o prototyp vytratí, servery (ACU) zhasnou a náklady klesají na nulu — pohodlné.
Toto řešení není vhodné pro stabilní vysokou zátěž, protože neumí škálovat zápisovou zátěž. Všechna tato připojení a odpojení prostředků se odehrávají v okamžiku, kterému se říká „scale point“ — chvíle, kdy databázi nedrží transakce, ani dočasné tabulky. Například během týdne se „scale point“ nemusí vůbec objevit, a databáze běží na stejných prostředcích a nemůže se ani rozšířit, ani zmenšit.
Žádná kouzla — to je obyčejný PostgreSQL. Ale proces přidávání strojů a odpojování je částečně automatizován.
Serverless by design
Aurora Serverless je stará databáze přepracovaná pro cloud, aby využila specifických výhod Serverless. A nyní vám povím o databázi, která byla od začátku napsána pro cloud a přístup serverless — Serverless-by-design. Byla vyvíjena bez předpokladu, že funguje na fyzických serverech.
Tato databáze se nazývá Snowflake. Má tři klíčové bloky.
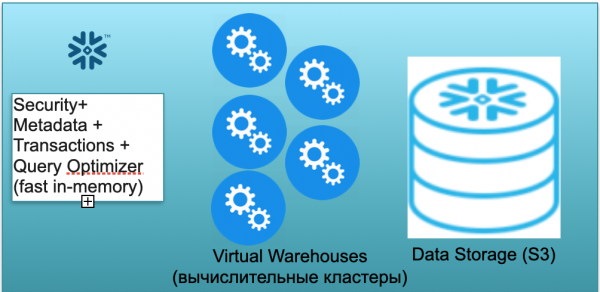
První — to je blok metadat. Je to rychlá in-memory služba, která řeší otázky bezpečnosti, metadat, transakcí a optimalizace dotazů (na ilustraci vlevo).
Druhý blok — to je mnohost virtuálních výpočetních clusterů pro výpočty (na ilustraci — soubor modrých kruhů).
Třetí blok — systém ukládání dat založený na S3. S3 je bezrozměrné objektové úložiště v AWS, něco jako bezrozměrný Dropbox pro firmy.
Podívejme se, jak Snowflake funguje při předpokladu studeného startu. To znamená, že databáze existuje, data jsou do ní nahraná, ale není žádný běžící dotaz. Pokud tedy k databázi nejsou žádné dotazy, máme spuštěný rychlý in-memory Metadata službu (první blok). A máme úložiště S3, kde jsou uložena data tabulek, rozdělena na takzvané mikropartice. Pro zjednodušení: pokud v tabulce leží transakce, mikropartice představují dny transakcí. Každý den je samostatná mikropartice, samostatný soubor. A když databáze funguje v tomto režimu, platíte pouze za místo, které data zabírají. Ceník za místo je velmi nízký (zejména s ohledem na značné kompresi). Metadata služba také pracuje neustále, ale pro optimalizaci dotazů není potřeba mnoho zdrojů, a tento servis lze považovat za podmíněně bezplatný.
Nyní si představme, že k naší databázi přichází uživatel a posílá SQL dotaz. SQL dotaz okamžitě směřuje k zpracování do Metadata služby. Tento servis analyzuje dotaz, dostupná data, práva uživatele a pokud je vše v pořádku, vytvoří plán zpracování dotazu.
Dále služba iniciuje spuštění výpočetního clusteru. Výpočetní cluster je soubor serverů, které provádějí výpočty. To znamená, že to může být cluster, který obsahuje 1 server, 2 servery, 4, 8, 16, 32 — kolik chcete. Odešlete dotaz a pro něj se okamžitě začne spouštět tento cluster. Opravu to trvá sekundy.
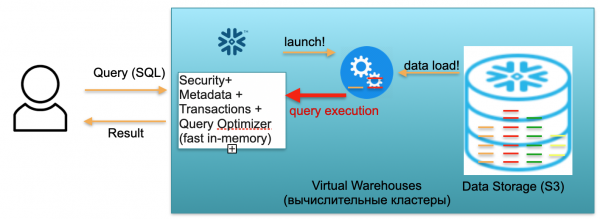
Po spuštění clusteru se do clusteru z S3 začnou kopírovat mikro-partice potřebné pro zpracování vaší žádosti. Představme si, že pro vykonání SQL dotazu jsou potřeba dvě partie z jedné tabulky a jedna z druhé. V takovém případě budou do clusteru zkopírovány pouze tři potřebné partie, nikoli všechny tabulky jako celek. Právě proto, že všechno je umístěno v jednom datovém centru a spojeno velmi rychlými kanály, probíhá celý proces přenosu velmi rychle: za sekundy, velmi zřídka za minuty, pokud se nejedná o nějaké složité dotazy. Mikro-partice jsou tedy kopírovány do výpočetního clusteru a po dokončení se na tomto výpočetním clusteru provede SQL dotaz. Výsledkem tohoto dotazu může být jeden řádek, několik řádků nebo tabulka — ty se posílají ven uživateli, aby je mohl exportovat, zobrazit ve svém BI nástroji nebo jinak využít.
Každý SQL dotaz může nejen počítat agregáty z dříve načtených dat, ale také načítat/formovat nová data v databázi. To znamená, že může jít o dotaz, který například provádí vložení nových záznamů do jiné tabulky, což vede k vytvoření nové partie na výpočetním clusteru, která je pak automaticky uložena do jednotného S3 úložiště.
Popsaný scénář, od příchodu uživatele po spuštění clusteru, načítání dat, provádění dotazů, získávání výsledků, se účtuje podle sazby za minuty používání spuštěného virtuálního výpočetního clusteru, virtuálního warehouse. Sazba se liší v závislosti na zóně AWS a velikosti clusteru, ale průměrně to jsou několik dolarů za hodinu. Cluster ze čtyř strojů je dvakrát dražší než z dvou strojů, z osmi strojů ještě dvakrát dražší. Jsou k dispozici varianty ze 16, 32 strojů, v závislosti na složitosti dotazů. Ale platíte pouze za ty minuty, kdy cluster skutečně pracuje, protože když nejsou žádné dotazy, jako byste zvedli ruce, a po 5-10 minutách čekání (nastavitelný parametr) se sám vypne, uvolní zdroje a stane se bezplatným.
Scénář, kdy odešlete dotaz, cluster se aktivuje, řekněme, za minutu, další minutu počítá, pak pět minut na vypnutí, a nakonec platíte za sedm minut provozu tohoto clusteru, a ne za měsíce a roky.
První scénář popisoval použití Snowflake v jednom uživatelském režimu. Nyní si představme, že uživatelů je mnoho, což se již blíží reálnému scénáři.
Předpokládejme, že máme mnoho analytiků a Tableau reportů, které neustále bombarďují naši databázi velkým množstvím jednoduchých analytických SQL dotazů.
Kromě toho předpokládejme, že máme vynalézavé datové vědce, kteří se pokoušejí dělat s daty úžasné věci, operovat s desítkami terabajtů, analyzovat miliardy a biliony řádků dat.
Pro výše popsané dva typy zátěže Snowflake umožňuje spouštět několik nezávislých výpočetních clusterů různé výkonnosti. Tyto výpočetní clustery pracují nezávisle, ale s sdílenými konzistentními daty.
Pro velké množství lehkých dotazů lze zprovoznit 2-3 malé clustery, velikosti, řekněme, 2 stroje každý. Toto chování lze realizovat také pomocí automatických nastavení. To znamená, že říkáte: „Snowflake, spusť malý cluster. Pokud zatížení vzroste nad určité parametry, spusť obdobný druhý, třetí. Když zatížení začne klesat, vypni nadbytečné.“ Aby nezávisle na počtu analytiků, kteří přicházejí a začínají sledovat reporty, bylo k dispozici dostatek zdrojů.
Pokud ale analytici spí a nikdo nesleduje reporty, clustery mohou zcela vypnout a vy přestáváte platit za ně.
Pro těžké dotazy (od datových vědců) můžete spustit jeden velmi velký cluster na zhruba 32 strojích. Tento cluster bude také placen pouze za minuty a hodiny, kdy tam běží váš obrovský dotaz.
Popisovaná možnost umožňuje rozdělovat podle clusterů nejen 2, ale i více typů zátěže (ETL, monitorování, materializace reportů,… ).
Shrnutí Snowflake. Databáze kombinuje krásnou ideu a funkční implementaci. V ManyChat používáme Snowflake pro analýzu všech dostupných dat. Nemáme tři clustery, jak v příkladu, ale od 5 do 9 různých velikostí. Máme takzvané 16-strojové, 2-strojové a dokonce i super-malé 1-strojové pro některé úkoly. Ty úspěšně rozdělují zátěž a umožňují nám výrazně šetřit.
Databáze úspěšně škáluje čtecí a zapisovací zátěž. To je obrovský rozdíl a zásadní pokrok ve srovnání se „Aurorou“, která zvládala pouze čtecí zátěž. Snowflake umožňuje škálovat zapisovací zátěž pomocí těchto výpočetních clusterů. Jak jsem již zmínil, v ManyChat používáme několik clusterů, malé a super-malé clustery se většinou používají pro ETL, pro nahrávání dat. Analytici pracují na středních clusterech, které jsou zcela nezatíženy ETL zátěží, a proto fungují velmi rychle.
Odpovídajícím způsobem je databáze dobře vhodná pro OLAP úkoly. Bohužel však pro OLTP zátěže ještě není aplikovatelná. Zaprvé, tato databáze je sloupcová, se všemi důsledky. Zadruhé, samotný přístup, kdy při každém dotazu potřísníte výpočetní cluster daty, je bohužel pro OLTP zátěže stále nedostatečně rychlý. Sekundy čekání pro OLAP úkoly jsou v pořádku, ale pro OLTP úkoly jsou nepřijatelné, raději by to bylo 100 ms, a ještě lépe – 10 ms.
Výsledek
Serverless databáze je možná díky rozdělení databáze na Stateless a Stateful části. Určitě jste si všimli, že ve všech uvedených příkladech, Stateful část – je, řekněme, uložení mikropartic na S3, a Stateless – je optimalizátor, práce s metadaty, zpracování bezpečnostních otázek, které mohou být spuštěny jako nezávislé lehké Stateless služby.
Provádění SQL dotazů lze také vnímat jako služby s lehkým stavem, které se mohou objevit v bezserverovém režimu, jako výpočetní clustry Snowflake, stáhnout pouze potřebná data, provést dotaz a "zhasnout".
Serverless databáze na úrovni produkce jsou již k dispozici a fungují. Tyto serverless databáze jsou už připraveny zvládat OLAP úkoly. Bohužel, pro OLTP úkoly se používají... s některými nuancemi, protože existují omezení. Na jedné straně je to nevýhoda. Na druhé straně je to příležitost. Možná někdo z čtenářů najde způsob, jak udělat OLTP databázi úplně serverless, bez omezení Aurora.
Doufám, že vás to zaujalo. Budoucnost je serverless 🙂
Zdroj: habr.com
