

Některé společnosti, včetně našeho klienta, rozvíjejí produkt prostřednictvím partnerské sítě. Například velké internetové obchody jsou integrovány s doručovací službou – objednáte si zboží a brzy obdržíte sledovací číslo balíku. Dalším příkladem je, že spolu s letenkou si zakoupíte pojištění nebo lístek na aerotransport.
K tomu se používá jedno API, které je třeba poskytnout partnerům prostřednictvím API Gateway. Tento úkol jsme vyřešili. V tomto článku vysvětlíme podrobnosti.
Dané: ekosystém a API portál s rozhraním, kde jsou registrováni uživatelé, získávají informace atd. Musíme vytvořit pohodlnou a spolehlivou API Gateway. V procesu jsme potřebovali zajistit
- registraci,
- kontrolu připojení k API,
- monitorování toho, jak uživatelé používají koncový systém,
- sledování obchodních ukazatelů.
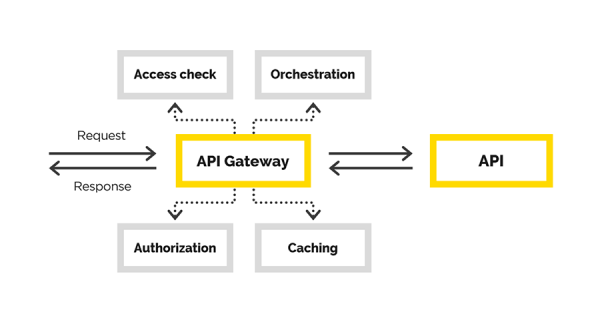
V článku se podělíme o naše zkušenosti při vytváření API Gateway, během níž jsme řešili následující úkoly:
- autentizaci uživatele,
- autorizaci uživatele,
- modifikaci původního požadavku,
- proxy požadavku,
- postprocessing odpovědi.
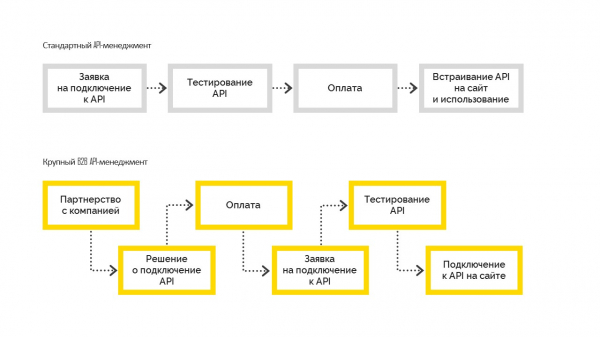
Existují dva typy správy API:
1. Standardní, který funguje následujícím způsobem. Před připojením si uživatel testuje možnosti, poté platí a integruje je na svůj web. Nejčastěji je používají v malém a středním podnikání.
2. Velký B2B API Management, kdy společnost nejprve přijme obchodní rozhodnutí o připojení, stane se partnerem společnosti s kontraktními závazky, a poté se připojí k API. A teprve po vyřízení všech formalit společnost získá testovací přístup, absolvuje testování a přejde do produkce. To však není možné bez vedení rozhodnutí o připojení.
Naše řešení
V této části se podělíme o vytvoření API Gateway.
Koneční uživatelé vytvářeného API Gateway jsou partneři našeho klienta. Pro každého z nich již máme potřebné smlouvy. Budeme muset pouze rozšířit funkcionalitu a zaznamenat poskytnutý přístup k bráně. Odpovídající je řízený proces připojení a správy.
Samozřejmě, mohli bychom zvolit nějaké hotové řešení pro úlohu správy API a tvorbu API Gateway mimo jiné. Například takovým by mohl být. To nevyhovovalo, protože v našem případě jsme již měli API portál a obrovský ekosystém vybudovaný kolem něj. Všichni uživatelé byli již registrováni, rozuměli, kde a jak mohou získat potřebné informace. V API portálu již existovaly potřebné rozhraní, potřebovali jsme pouze API Gateway. Na jeho vývoji jsme se pustili.
To, co nazýváme API Gateway - je jakýsi proxy. Zde jsme měli opět na výběr - buď napsat svůj vlastní proxy, nebo si vybrat něco připraveného. V tomto případě jsme se vydali druhou cestou a zvolili jsme kombinaci nginx+Lua. Proč? Potřebovali jsme spolehlivý, otestovaný software, který podporuje škálovatelnost. Nechtěli jsme po realizaci znovu kontrolovat a ověřovat správnost obchodní logiky i funkčnost proxy.
Každý webový server má konvej pro zpracování požadavku. V případě nginx vypadá následovně:
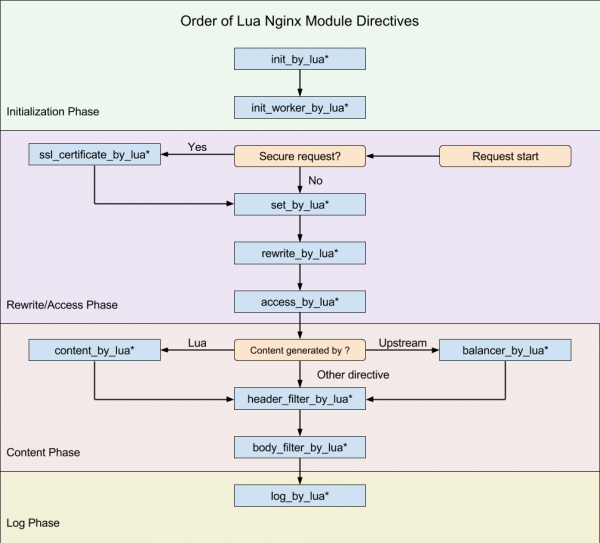
(schéma z )
Naším cílem bylo integrovat se do tohoto konveje v okamžiku, kdy můžeme modifikovat původní požadavek.
Chceme vytvořit transparentní proxy, aby požadavek zůstal funkčně stejný, jaký přišel. Kontrolujeme pouze přístup k konečnému API a pomáháme požadavku k jeho dosažení. Pokud byl požadavek nesprávný, chybu by měl ukázat konečný API, nikoli my. Jediným důvodem, proč můžeme požadavek odmítnout, je absence přístupu klienta.
Pro nginx již existuje na . Lua je skriptovací jazyk, je velmi lehký a snadno se učí. Takže potřebnou logiku jsme реализovali pomocí Lua.
Konfigurace nginxu (analogická k routě aplikace), kde se vykonává veškerá práce, je docela srozumitelná. Zajímavá je zde poslední direktiva - post_action.
location /middleware {
      more_clear_input_headers Accept-Encoding;
      lua_need_request_body on;
      rewrite_by_lua_file 'middleware/rewrite.lua';
      access_by_lua_file 'middleware/access.lua';
      proxy_pass https://someurl.com;
      body_filter_by_lua_file 'middleware/body_filter.lua';
      post_action /process_session;
}
Podívejme se, co se děje v této konfiguraci:
more_clear_input_headers — čistí hodnotu uvedených hlaviček po direktivě.
lua_need_request_body — reguluje, zda by se mělo přečíst původní tělo požadavku před prováděním direktiv rewrite/access/access_by_lua. Ve výchozím nastavení nginx nečte tělo požadavku klienta, a pokud potřebujete získat k němu přístup, tato direktiva by měla mít hodnotu on.
rewrite_by_lua_file — cesta ke skriptu, kde je popsána logika pro modifikaci dotazu
access_by_lua_file — cesta ke skriptu, kde je popsána logika, která kontroluje existenci přístupu k zdroji.
proxy_pass — url, na který bude dotaz proxy.
body_filter_by_lua_file — cesta ke skriptu, kde je popsána logika pro filtrování dotazu před vrácením klientovi.
A nakonec, post_action — oficiálně nedokumentovaná direktiva, pomocí které lze provádět další akce po odeslání odpovědi klientovi.
Dále si podrobně vysvětlíme, jak jsme řešili naše úkoly.
Autentizace/audit a modifikace dotazu
Autentizace
Autentizaci a audit jsme postavili na základě přístupů pomocí certifikátu. Existuje kořenový certifikát. Každému novému klientovi zadavatele se generuje jeho vlastní certifikát, se kterým může získat přístup k API. Tento certifikát se nastavuje v sekci server v konfiguraci nginx.
ssl on;
ssl_certificate /usr/local/openresty/nginx/ssl/cert.pem;
ssl_certificate_key /usr/local/openresty/nginx/ssl/cert.pem;
ssl_client_certificate /usr/local/openresty/nginx/ssl/ca.crt;
ssl_verify_client on;
Modifikace
Může se objevit spravedlivá otázka: co dělat se certifikovaným klientem, pokud bychom ho náhle chtěli odpojit od systému? Nebudeme přece vydávat nové certifikáty pro všechny ostatní klienty.
Tak jsme hladce přešli k dalšímu úkolu — modifikaci původního dotazu. Původní dotaz klienta totiž obvykle není platný pro konečný systém. Jedním z úkolů je doplnit do dotazu chybějící části, aby se stal platným. Klíčové je, že chybějící data jsou různá pro každého klienta. Víme, že klient k nám přichází s certifikátem, ze kterého můžeme získat otisk a vytáhnout z databáze potřebná data klienta.
Pokud by v nějakém okamžiku bylo nutné odpojit klienta od naší služby, jeho data by zmizela z databáze a on by nemohl nic dělat.
Práce s daty klienta
Museli jsme zajistit vysokou dostupnost řešení, zejména toho, jak získáváme data klienta. Složitost spočívá v tom, že primárním zdrojem těchto dat je externí služba, která nezaručuje nepřerušovanou a dostatečně vysokou rychlost práce.
Proto jsme potřebovali zajistit vysokou dostupnost dat klientů. Jako nástroj jsme vybrali , který nám poskytuje:
- rychlý přístup k datům,
- možnost vytvořit cluster z několika uzlů s replikovanými daty na různých uzlech.
Zvolili jsme nejjednodušší strategii pro doručování dat do cache:
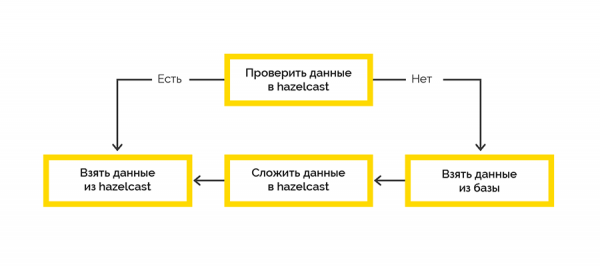
Práce s koncovým systémem se odehrává v rámci relací a existuje limit na maximální počet. Pokud klient relaci neuzavře, musíme to udělat my.
Data o otevřené relaci přicházejí od koncového systému a původně jsou zpracovávána na straně Lua. Rozhodli jsme se použít Hazelcast pro uchování těchto dat pomocí jobu napsaného v .NET. Poté v určitých intervalech kontrolujeme životnost otevřených relací a uzavíráme ty, které jsou propadlé.
Přístup k Hazelcast jak z Lua, tak z .NET
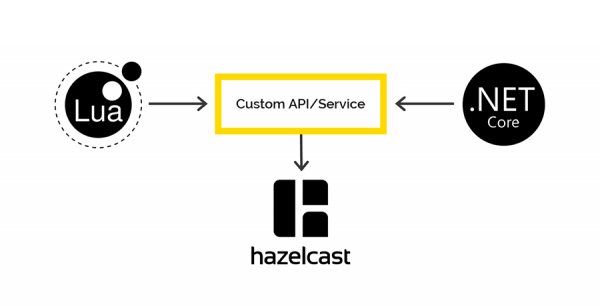
Klienti pro Lua pro práci s Hazelcast neexistují, ale Hazelcast má REST API, které jsme se rozhodli využít. Pro .NET existuje , přes které jsme plánovali získat přístup k datům Hazelcast na straně .NET. Ale to se nepodařilo.
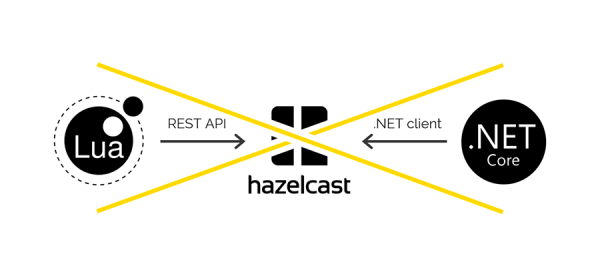
Při ukládání dat přes REST a vyhledávání přes .NET klienta se používají různé serializátory a deserializátory. Proto není možné ukládat data přes REST a získat je přes .NET klienta a naopak.
Pokud budou zájemci, podrobněji tuto problematiku popíšeme v samostatném článku. Spoiler — na schématu.
Protokolování a monitoring
Naším firemním standardem pro protokolování přes .NET je Serilog, všechny logy nakonec končí v Elasticsearch, jejich analýzu provádíme přes Kibana. Něco podobného jsme chtěli udělat i v tomto případě. Jediný klient pro Elastic na Lua, který byl nalezen, se zhroutil hned při prvním require. A použili jsme Fluentd.
— open source řešení pro zajištění jednotné vrstvy protokolování aplikace. Umožňuje shromažďovat logy z různých vrstev aplikace a poté je transformovat do jednotného zdroje.
API Gateway funguje v K8S, proto jsme se rozhodli přidat kontejner s fluentd do stejného podu, abychom mohli zapisovat logy do existujícího otevřeného tcp portu fluentd.
Také jsme zkoumali, jak se fluentd bude chovat, pokud nebude mít spojení s Elasticsearch. Během dvou dnů do brány nepřetržitě přicházely požadavky, do fluentd se posílaly logy, ale fluentd měl zakázanou IP adresu Elastic. Po obnovení spojení fluentd bez problémů převedl všechny logy do Elastic.
Závěr
Zvolený přístup k implementaci nám umožnil doručit skutečně funkční produkt do produkčního prostředí za pouhé 2,5 měsíce.
Pokud se někdy dostanete k podobným věcem, doporučujeme nejprve jasně pochopit, jaký úkol řešíte a jaké zdroje už máte k dispozici. Buďte opatrní vůči složitostem integrace s existujícími systémy pro správu API.
Ujasněte si, co vlastně hodláte vyvíjet — jen obchodní logiku zpracování požadavků, nebo, jak to bylo v našem případě, celý proxy. Nezapomeňte, že vše, co si vyrobíte sami, musí být následně důkladně otestováno.
Zdroj: habr.com
