

Pozn. přek.: adaptace Kubernetes v GitLab je považována za jeden ze dvou hlavních faktorů přispívajících k růstu společnosti. Nicméně, až do nedávné doby byla infrastruktura online služby GitLab.com postavena na virtuálních strojích, a teprve před rokem začala její migrace do K8s, která dosud nebyla dokončena. Rádi bychom představili překlad nedávného článku SRE inženýra GitLab o tom, jak to probíhá a jaké závěry dělají inženýři účastnící se projektu.
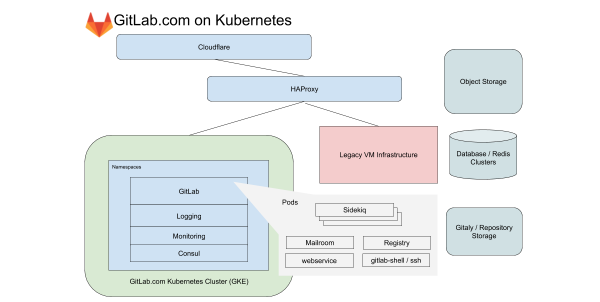
Naše infrastrukturní oddělení se již více než rok věnuje migraci všech služeb běžících na GitLab.com do Kubernetes. Během této doby jsme se setkali s problémy, které se netýkaly pouze přesunu služeb do Kubernetes, ale také s řízením hybridního nasazení během přechodu. O cenných lekcích, které jsme získali, bude tato článek.
Od počátku GitLab.com fungovaly jeho servery v cloudu na virtuálních strojích. Těmito virtuálními stroji spravuje Chef a jejich instalace probíhá prostřednictvím našeho . pro případ, že je potřeba aktualizovat aplikaci, spočívá v jednoduché aktualizaci sady serverů koordinovaným postupným způsobem pomocí CI pipeline. Tato metoda — i když pomalá a poněkud — zaručuje, že GitLab.com používá stejné metody instalace a konfigurace jako uživatelé samostatných (self-managed) instalací GitLab, využívajících k tomu naše Linux balíčky.
Tento přístup využíváme, protože je mimořádně důležité prožít všechny starosti a radosti, které zažívají běžní členové komunity při instalaci a nastavování svých kopií GitLab. Tento přístup dobře fungoval nějakou dobu, avšak když počet projektů na GitLab překročil 10 milionů, uvědomili jsme si, že již nevyhovuje našim potřebám v oblasti škálovatelnosti a nasazení.
První kroky k Kubernetes a cloud-native GitLab
V roce 2017 byl vytvořen projekt pro přípravu GitLab k nasazení v cloudu a také pro umožnění uživatelům instalovat GitLab do Kubernetes klastrů. Už jsme věděli, že přesun GitLab do Kubernetes zvýší možnosti škálování SaaS platformy, usnadní nasazení a zlepší efektivitu využití výpočetních zdrojů. Zároveň však mnoho funkcí naší aplikace záviselo na připojených NFS oddílech, což zpomalilo přechod z virtuálních strojů.
Snažení o cloud native a Kubernetes umožnilo našim inženýrům plánovat postupný přechod, během něhož jsme se vzdali některých závislostí aplikace na síťových úložištích, a zároveň pokračovali ve vývoji nových funkcí. Od té doby, co jsme začali plánovat migraci v létě 2019, bylo odstraněno mnoho těchto omezení a proces přenosu GitLab.com na Kubernetes nyní probíhá na plné obrátky!
Vlastnosti fungování GitLab.com v Kubernetes
Pro GitLab.com používáme jediný regionální klastr GKE, který zpracovává veškerý provoz aplikace. Abychom minimalizovali složitost (již tak složité) migrace, zaměřujeme se na služby, které nejsou závislé na místním úložišti nebo NFS. GitLab.com převážně používá monolitní kódovou základnu na Rails a směrujeme provoz podle charakteristik pracovního zatížení na různé endpointy, izolované do svých vlastních uzlových poolů.
V případě front-endu jsou tyto typy rozděleny na požadavky na web, API, Git SSH/HTTPS a Registry. V případě back-endu rozdělujeme joby v frontách podle různých charakteristik v závislosti na , které nám umožňují nastavovat cílové ukazatele úrovně služeb (Service-Level Objectives, SLOs) pro různé zátěže.
Všechny tyto služby GitLab.com jsou nakonfigurovány pomocí nemodifikovaného Helm chartu GitLab. Konfigurace probíhá v subchartech, které mohou být selektivně zahrnuty, jak postupně převádíme služby do clustru. I přes rozhodnutí nezahrnout do migrace některé naše stateful služby, jako jsou Redis, Postgres, GitLab Pages a Gitaly, umožňuje použití Kubernetes radikálně snížit počet VM, které nyní spravuje Chef.
Transparentnost a správa konfigurace Kubernetes
Všechna nastavení spravuje samotný GitLab. K tomu se používají tři konfigurační projekty založené na Terraformu a Helmu. Snažíme se, kde to je možné, využívat samotný GitLab k spuštění GitLabu, ale pro provozní úkoly máme funkční oddělenou instalaci GitLabu. Ta je potřebná, abychom nebyli závislí na dostupnosti GitLab.com během provádění nasazení a aktualizací GitLab.com.
I když naše pipeline pro klastr Kubernetes fungují na oddělené instalaci GitLabu, existují zrcadla repozitářů kódu, které jsou veřejně dostupné na následujících adresách:
- — konfigurační obal GitLab.com pro Helm chart GitLab;
- — obsahuje konfigurace pro služby, které nejsou přímo spojené s aplikací GitLab. Mezi ně patří konfigurace pro protokolování a monitorování klastru, stejně jako pro integrované nástroje jako PlantUML;
- — konfigurace Terraformu pro Kubernetes a starou (legacy) VM infrastrukturu. Zde se nastavují všechny zdroje potřebné pro spuštění klastru, včetně samotného klastru, poolů uzlů, účtů služeb a rezervace IP adres.

Při provádění změn se zobrazuje veřejně přístupné s odkazem na podrobný diff, který SRE analyzuje před provedením změn v klastru.
Pro SRE odkaz vede na podrobný diff v instalaci GitLabu, která se používá pro provoz a jejíž přístup je omezen. To umožňuje zaměstnancům a komunitě, kteří nemají přístup k provoznímu projektu (ten je otevřen pouze pro SRE), prohlížet navrhované změny v konfiguraci. Kombinováním veřejné instance GitLabu pro kód s uzavřenou instancí pro CI pipeline si zachováváme jednotný pracovní postup, přičemž zajišťujeme nezávislost na GitLab.com během aktualizací konfigurace.
Co jsme zjistili během migrace
Během přesunu jsme nasbírali zkušenosti, které aplikujeme na nové migrace a nasazení v Kubernetes.
1. Růst nákladů kvůli provoznímu přenosu mezi zónami dostupnosti
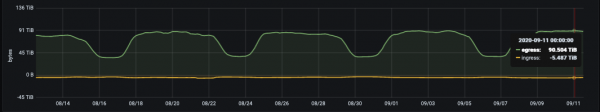
Každodenní egress statistika (byty za den) pro sadu Git repozitářů na GitLab.com
Google dělí svou síť na regiony. Ty se dále rozdělují na zóny dostupnosti (AZ). Git hosting je spojen s velkými objemy dat, proto je pro nás důležité kontrolovat síťový egress. V případě vnitřního provozu je egress zdarma pouze tehdy, pokud zůstává v rámci jedné zóny dostupnosti. K datu sepsání tohoto článku odesíláme přibližně 100 TB dat během běžného pracovního dne (a to pouze pro Git repozitáře). Služby, které byly v naší staré topologii založené na VM, umístěné na stejných virtuálních strojích, nyní fungují v různých podech Kubernetes. To znamená, že část provozu, která byla dříve lokální pro VM, může potenciálně přecházet za hranice zón dostupnosti.
Regionální clustry GKE umožňují pokrýt několik zón dostupnosti pro redundanci. Zvažujeme možnost pro služby, které generují velké objemy provozu. To povede ke snížení nákladů na egress při zachování redundance na úrovni clusteru.
2. Limity, požadavky na zdroje a škálování
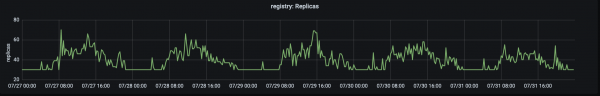
Počet replik zpracovávajících produkční provoz na registry.gitlab.com. Provoz dosahuje svého vrcholu kolem ~15:00 UTC.
Naše historie migrace začala v srpnu 2019, kdy jsme přenesli první službu — GitLab Container Registry — do Kubernetes. Tato kriticky důležitá služba s vysokým provozem byla ideální pro první migraci, protože je to stateless aplikace s malým počtem externích závislostí. Prvním problémem, se kterým jsme se setkali, bylo velké množství vytlačených podů kvůli nedostatku paměti na uzlech. To nás donutilo upravit požadavky a limity.
Bylo zjištěno, že v případě aplikace, jejíž spotřeba paměti roste v průběhu času, nízké hodnoty pro požadavky (rezervující paměť pro každý pod) spolu se „štědrým“ pevným limitem na použití vedly k saturaci (saturation) uzlů a vysoké úrovni vytlačení. Abychom se s tímto problémem vypořádali, bylo . To uvolnilo tlak na uzlech a zajistilo životní cyklus podů, který nevyvíjel příliš vysoký tlak na uzel. Nyní začínáme migrace s štědrými (a téměř stejně vysokými) hodnotami požadavků a limitů, které upravujeme podle potřeby.
3. Metрики a logy
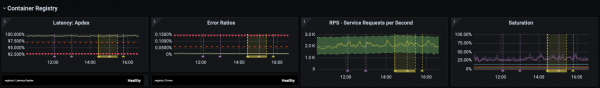
Infrastrukturní oddělení se zaměřuje na latence, procento chyb a saturaci s nastavenými (SLO), vázanými na .
Během uplynulého roku se jedním z klíčových událostí v infrastrukturním oddělení stala zlepšení v monitorování a práci se SLO. SLO nám umožnily stanovovat cíle pro jednotlivé služby, které jsme pečlivě sledovali během migrace. Ale i s takto vylepšenou viditelností ne vždy lze okamžitě vidět problémy, pomocí metrik a alertů. Například, zaměřením na latence a procento chyb nekryjeme úplně všechny scénáře používání služby, která prochází migrací.
Tento problém byl odhalen téměř okamžitě po přesunu části pracovních zátěží do clusteru. Zvlášť výrazně se projevoval, když bylo třeba zkontrolovat funkce, jejichž počet požadavků není velký, ale mají velmi specifické konfigurační závislosti. Jedním z klíčových poučení po migraci byla nutnost brát při monitorování v úvahu nejen metriky, ale také logy a „dlouhý ocas” (jde o na grafu — pozn. překl.) chyb. Nyní pro každou migraci zahrnujeme podrobný seznam požadavků na logy (log queries) a plánujeme jasné postupy pro vrácení, které lze v případě problémů přenášet z jedné směny na druhou.
Paralelní obsluha stejných požadavků na staré VM infrastruktuře a nové, založené na Kubernetes, představovala unikátní úkol. Na rozdíl od migrace typu lift-and-shift (rychlý přesun aplikací „tak jak jsou“ do nové infrastruktury; více informací lze přečíst například, — pozn. překl.), paralelní práce na „starých“ VM a Kubernetes vyžaduje, aby nástroje pro monitorování byly kompatibilní s oběma prostředími a uměly spojovat metriky do jedné formy. Důležité je, že používáme stejné dashboardy a dotazy na logy, abychom dosáhli konzistentní observability během přechodného období.
4. Přepnutí provozu na nový cluster
Pro GitLab.com je část serverů vyhrazena pro . Kanárkový park obsluhuje naše vnitřní projekty a také může . Ale především je určen pro testování změn v infrastruktuře a aplikaci. První přesunutá služba začala přijímat omezený objem interního provozu a tento přístup nadále používáme, abychom se ujistili, že SLO je dodržováno, než nasměrujeme veškerý provoz do clusteru.
V případě migrace to znamená, že nejprve jsou do Kubernetes směrovány požadavky na interní projekty a poté postupně přepínáme na cluster zbytek provozu změnou váhy pro backend přes HAProxy. Během přechodu z VM na Kubernetes se ukázalo, že je velmi výhodné mít k dispozici jednoduchý způsob přesměrování provozu mezi starou a novou infrastrukturou a tím pádem udržovat starou infrastrukturu připravenou na zpětný návrat v prvních několika dnech po migraci.
5. Záložní kapacita podů a její využití
Téměř okamžitě byla zjištěna následující chyba: pody pro službu Registry byly spuštěny rychle, avšak spuštění podů pro Sidekiq trvalo až . Dlouhá doba spuštění podů pro Sidekiq se stala problémem, když jsme začali migraci pracovních zátěží pro pracovníky do Kubernetes, kteří potřebují rychle zpracovávat úkoly a rychle škálovat.
V tomto případě bylo ponaučení, že i když Horizontal Pod Autoscaler (HPA) v Kubernetes dobře zvládá růst provozu, je důležité brát v úvahu charakteristiky pracovních zátěží a vyčleňovat záložní kapacitu podů (zejména v podmínkách nerovnoměrného rozdělení poptávky). V našem případě došlo k náhlému nárůstu úkolů, což vedlo k rychlému škálování, které mělo za následek saturaci CPU zdrojů dříve, než jsme stihli rozšířit zbytek uzlů.
Vždy je lákavé vyždímat maximum z clusteru, nicméně my, kteří jsme se zpočátku potýkali s problémy s výkonem, teď začínáme se štědrým pod budgetem a následně ho snižujeme, pozorně sledujeme SLO. Spuštění podů pro službu Sidekiq se výrazně zrychlilo a nyní průměrně trvá kolem 40 sekund. těžili jak GitLab.com, tak naši uživatelé self-managed instalací, kteří pracují s oficiálním Helm chartem GitLab.
Závěr
Po přenosu každé služby jsme se těšili výhodám používání Kubernetes v produkci: rychlejšímu a bezpečnějšímu nasazení aplikace, škálování a efektivnějšímu rozdělování prostředků. Výhody migrace navíc přesahují služby GitLab.com. Z každého vylepšení oficiálního Helm chartu těží i jeho uživatelé.
Doufám, že se vám líbila naše příběh o našich dobrodružstvích s migrací do Kubernetes. Pokračujeme v přenosu nových služeb do clusteru. Další informace lze nalézt v následujících publikacích:
- «»;
- «»;
- .
P.S. od překladatele
Přečtěte si také náš blog:
- «»;
- «»;
- «»;
- «».
Zdroj: habr.com
