

Je všeobecně známo, že kompetence technického ředitele (CTO) se prověřují až při druhém nástupu do role. Jedna věc je pracovat pro společnost několik let, vyvíjet se s ní a přitom stále ve stejném kulturním kontextu postupně získávat větší zodpovědnost. Úplně jiná věc je nastoupit rovnou na pozici CTO ve společnosti s historií problémů a hromadou úhledně zametených pod koberec.
V tomto smyslu zkušenost Leona Fayera, o kterou se podělil na Není to úplně unikátní, ale v kombinaci s jeho zkušenostmi a počtem různých rolí, které za 20 let zastával, je to velmi užitečné. Níže je chronologie událostí za 90 dní a mnoho anekdot, které se sice mohou zasmát, když se stanou někomu jinému, ale ne tak zábavné se s nimi setkat osobně.
Leon mluví velmi živě rusky, takže pokud máte 35-40 minut, doporučuji shlédnout video. Textová verze je níže, abyste ušetřili čas.
První verze zprávy obsahovala dobře strukturovaný popis práce s lidmi a procesy a obsahovala užitečná doporučení. Nezachytila však všechna překvapení, se kterými jsem se cestou setkal. Proto jsem změnil formát a chronologicky prezentoval problémy, které se v nové firmě objevily, jako by to bylo jako z krabice, a metody jejich řešení.
Měsíc předtím
Jako mnoho dobrých příběhů, i tento začal alkoholem. Seděli jsme s přáteli v baru a jak je v IT kruzích typické, všichni si stěžovali na své problémy. Jeden z nich právě změnil práci a vyprávěl mi o svých problémech s technologiemi, lidmi a týmem. Čím víc jsem poslouchal, tím víc jsem si uvědomoval, že by mě měl prostě najmout, protože přesně takové problémy řeším posledních 15 let. Řekl jsem mu to a druhý den jsme se setkali v pracovním prostředí. Firma se jmenovala Teaching Strategies.
Společnost Teaching Strategies je lídrem na trhu vzdělávacího softwaru pro velmi malé děti – od narození do tří let. Tradiční papírová společnost má 40 let, zatímco digitální SaaS verze platformy je stará 10 let. Proces adaptace digitální technologie na standardy společnosti začal relativně nedávno. „Nová“ verze byla spuštěna v roce 2017 a byla téměř identická se starou, jen méně funkční.
Nejzajímavější je, že návštěvnost této společnosti je velmi předvídatelná – den co den, rok co rok, můžete přesně předpovědět, kolik lidí přijde a kdy. Například mezi 13. a 15. hodinou jdou všechny děti ve školce spát a učitelé začnou zadávat informace. A to se děje každý den kromě víkendů, protože o víkendech téměř nikdo nepracuje.
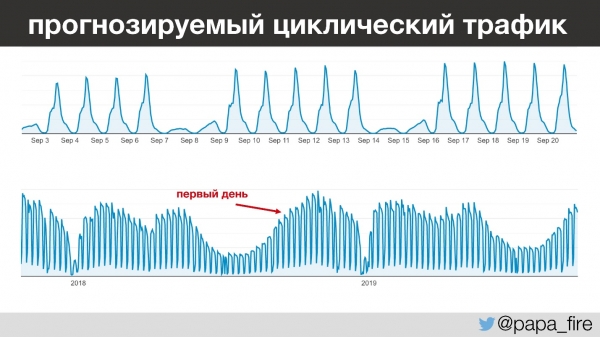
S trochou dopředu poznamenám, že jsem svou práci začal v období nejvyšší roční návštěvnosti, což je z různých důvodů zajímavé.
Platforma, která se zdála být stará jen dva roky, měla unikátní sadu nástrojů: ColdFusion a SQL Server z roku 2008. ColdFusion, pokud to nevíte (a pravděpodobně to nevíte), je podnikový jazyk PHP, který vznikl v polovině 90. let, a od té doby jsem o něm ani neslyšel. Obsahoval také Ruby, MySQL, PostgreSQL, Javu, Go a Python. Ale základní monolit běžel na ColdFusion a SQL Serveru.
Problémy
Čím více jsem se zaměstnanci firmy bavil o jejich práci a výzvách, kterým čelí, tím více jsem si uvědomoval, že problémy nebyly jen technické. Technologie byla stará – fungovalo se i s horšími technologiemi, ale byly tu problémy s týmem a procesy a firma si to začínala uvědomovat.
Tradičně jejich technici seděli v koutě a dělali si po svém. Ale stále více podnikání se začalo přesouvat digitálně. Takže v posledním roce předtím, než jsem tam začal pracovat, společnost přijala nové členy: představenstvo, technického ředitele, finančního ředitele a ředitele pro zajištění kvality. Jinými slovy, společnost začala investovat do technologií.
Stopy obtížného dědictví nebyly jen v systémech. Společnost měla staré procesy, staré lidi a starou kulturu. To vše bylo potřeba změnit. Říkal jsem si, že to nebude nuda, a tak jsem se rozhodl to zkusit.
Dva dny předtím
Dva dny před nástupem do nové práce jsem dorazil do kanceláře, vyplnil poslední papíry, setkal se s týmem a zjistil, že se potýkají s problémem. Problém byl v tom, že průměrná doba načítání stránky vzrostla na 4 sekundy, což je dvojnásobek.
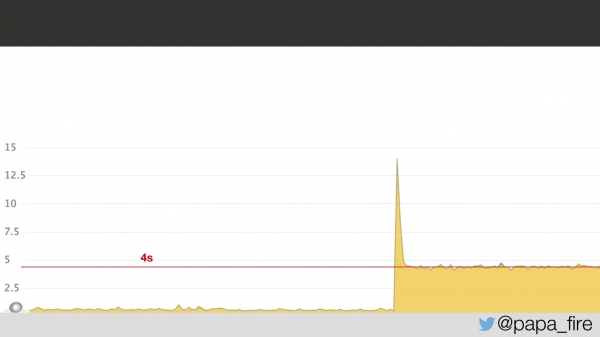
Soudě podle grafu se evidentně něco pokazilo a nebylo jasné co. Ukázalo se, že šlo o problém s latencí sítě v datovém centru: 5 ms latence v datovém centru se pro uživatele promítlo do 2 sekund. Nevěděl jsem, proč se to stalo, ale alespoň bylo jasné, že problém byl v datovém centru.
Den první
Uplynuly dva dny a hned první den v práci jsem zjistil, že problém nezmizel.
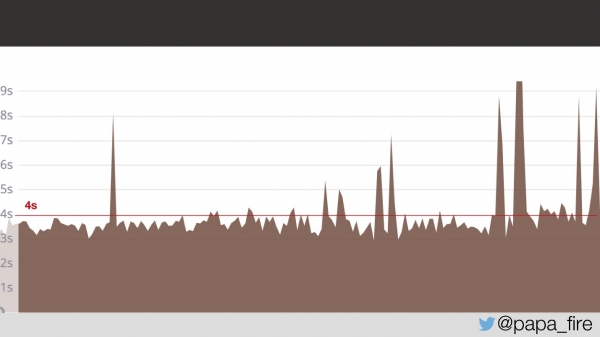
Dva dny se stránky uživatelů načítaly průměrně za 4 sekundy. Zeptal jsem se, jestli problém objevili.
- Ano, otevřeli jsme lístek.
- A?
- No, ještě nám neodpověděli.
Tady jsem si uvědomil, že všechno, co mi bylo předtím řečeno, byla jen špička ledovce, se kterou bylo třeba bojovat.
Existuje dobrý citát, který se v tomto případě velmi hodí:
"Někdy je pro změnu technologie nutné změnit organizaci."
Ale protože jsem začal pracovat v nejrušnějším období roku, musel jsem zvážit jak okamžitá, tak dlouhodobá řešení. A musel jsem začít s tím, co bylo právě teď kritické.
Den třetí
Doba načítání je tedy 4 sekundy a největší špičky jsou od 13 do 15 sekund.
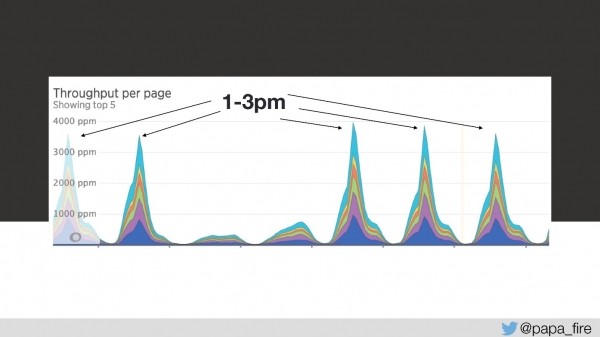
Třetí den během tohoto období vypadala rychlost stahování takto:
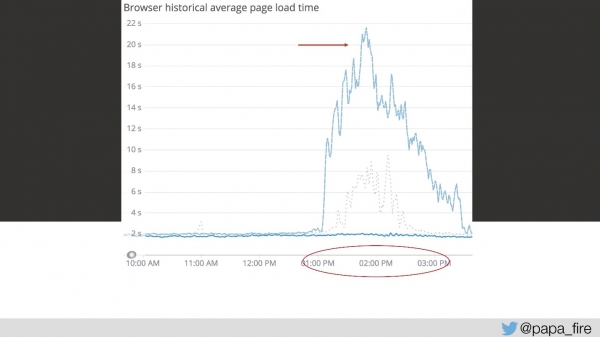
Z mého pohledu nefungovalo vůbec nic. Z pohledu všech ostatních to fungovalo trochu pomaleji než obvykle. Ale to se nestává jen tak – je to vážný problém.
Snažil jsem se tým přesvědčit, ale řekli mi, že prostě potřebují více serverů. To je jistě řešení, ale zdaleka není jediné ani nejúčinnější. Zeptal jsem se, proč není dostatek serverů a jaký je objem provozu. Extrapoloval jsem data a zjistil jsem, že máme asi 150 požadavků za sekundu, což je obecně v rozumných mezích.
Nesmíme ale zapomenout, že než dostaneme správnou odpověď, musíme si nejprve položit správnou otázku. Moje další otázka zněla: kolik máme frontendových serverů? Odpověď mě trochu „ohromila“ – měli jsme 17 frontendových serverů!
— Stydím se zeptat, ale 150 děleno 17 se rovná asi 8? Říkáte, že každý server zpracuje 8 požadavků za sekundu, a pokud budeme mít zítra 160 požadavků za sekundu, budeme potřebovat další dva servery?
Samozřejmě jsme nepotřebovali další servery. Řešení bylo v samotném kódu, přímo na povrchu:
var currentClass = classes.getCurrentClass();
return currentClass;
Byla tam funkce getCurrentClass(), protože vše na webu funguje v kontextu třídy – správně. A pro tuto jednu funkci na každé stránce, více než 200 žádostí.
Řešení bylo tedy velmi jednoduché, nebylo třeba nic přepisovat: prostě už nikdy nepožadovat stejné informace.
if ( !isDefined("REQUEST.currentClass") ) {
    var classes = new api.private.classes.base();
   REQUEST.currentClass = classes.getCurrentClass();
}
return REQUEST.currentClass;
Měl jsem z toho obrovskou radost, protože jsem si myslel, že jsem hlavní problém objevil až třetí den. Jak jsem byl naivní, byl to jen jeden z mnoha problémů.
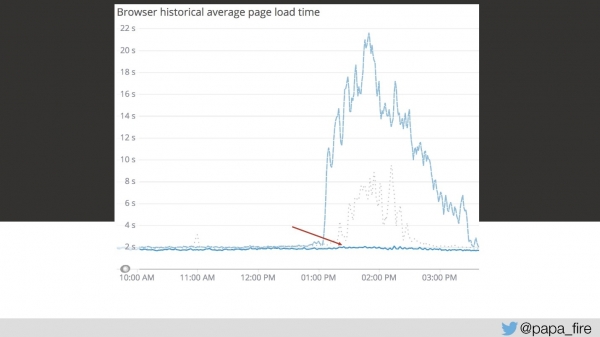
Ale vyřešení tohoto prvního problému snížilo graf mnohem níže.
Zároveň jsme pracovali na dalších optimalizacích. Bylo spousta věcí, které se daly hned opravit. Například třetí den jsem zjistil, že systém má mezipaměť (nejdřív jsem si myslel, že všechny požadavky přicházejí přímo z databáze). Když se řekne mezipaměť, představím si standardní Redis nebo Memcached. Ale to jsem byl jen můj názor, protože ukládání do mezipaměti v tomto systému používalo MongoDB a SQL Server – ten samý, ze kterého jsme právě četli data.
Den desátý
První týden jsem strávil řešením problémů, které bylo potřeba řešit okamžitě. Kolem druhého týdne jsem poprvé přišel na schůzku vestoje, abych si popovídal s týmem, zjistil, co se děje a jak celý proces probíhá.
Opět se objevilo něco zajímavého. Tým se skládal z: 18 vývojářů; 8 testerů; 3 manažerů; 2 architektů. A všichni se účastnili společných rituálů, což znamenalo, že každé ráno na stand-up přišlo více než 30 lidí a referovalo o tom, co dělají. Schůzka samozřejmě netrvala 5 ani 15 minut. Nikdo nikoho neposlouchal, protože každý pracoval na jiných systémech. V tomto formátu byly 2–3 tikety za hodinu během grooming session už dobrým výsledkem.
Nejdříve jsme tým rozdělili do několika produktových linií. Pro různé sekce a systémy jsme vytvořili samostatné týmy, které zahrnovaly vývojáře, testery, produktové manažery a obchodní analytiky.
Výsledek byl:
- Omezení stand-upů a demonstrací.
- Znalost předmětu produktu.
- Pocit vlastnictví. Když lidé dříve neustále střídali systémy, věděli, že jejich chyby pravděpodobně vyřeší někdo jiný, ne oni sami.
- Spolupráce mezi týmy. Není třeba dodávat, že QA a programátoři spolu dříve moc nekomunikovali; produktový manažer si dělal své vlastní věci atd. Nyní mají společný bod odpovědnosti.
Zaměřili jsme se především na efektivitu, produktivitu a kvalitu – to byly problémy, které jsme se snažili vyřešit transformací týmu.
Jedenáctý den
V procesu změny struktury týmu jsem zjistil, jak vypočítat PříběhBody1 SP se rovnalo jednomu dni a každý tiket obsahoval SP jak pro vývoj, tak pro QA, tedy alespoň 2 SP.
Jak jsem to zjistil/a?
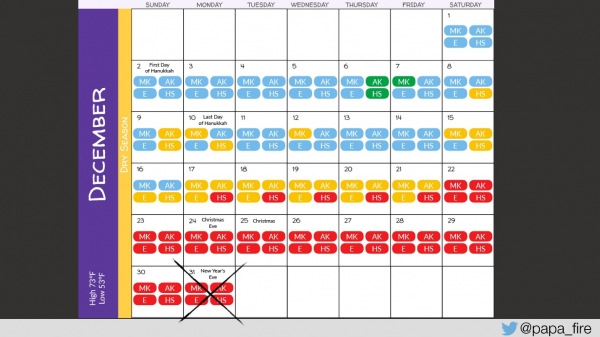
Našli jsme chybu: v jednom z reportů, kde zadáváte počáteční a koncové datum období, pro které potřebujete report, se poslední den nebere v úvahu. To znamená, že někde v dotazu nebylo <=, ale jednoduše <. Bylo mi řečeno, že se jedná o tři Story Points, což znamená 3 dny.
Poté my:
- Přepracovali jsme systém Story Points. Nyní se drobné opravy chyb, které lze systémem rychle zpracovat, dostanou k uživatelům rychleji.
- Začali jsme konsolidovat související vývojové a testovací tikety. Dříve byl každý tiket, každá chyba, uzavřeným ekosystémem, nepropojeným s ničím jiným. Změna tří tlačítek na jedné stránce mohla vést ke třem různým tiketům se třemi různými procesy QA namísto jednoho automatizovaného testu na stránku.
- Začali jsme s vývojáři pracovat na přístupu k odhadování nákladů na pracovní sílu. Tři dny na výměnu jednoho tlačítka nejsou žádná legrace.
Den dvacátý
Někde kolem poloviny prvního měsíce se situace trochu stabilizovala, pochopil jsem, o co v podstatě jde, a začal jsem se dívat do budoucnosti a přemýšlet o dlouhodobých řešeních.
Dlouhodobé cíle:
- Spravovaná platforma. Stovky dotazů na každé stránce nejsou vážné.
- Předvídatelné trendy. Občas se vyskytovaly špičky v provozu, které na první pohled nekorelovaly s jinými metrikami – museli jsme pochopit, proč k tomu dochází, a naučit se to předvídat.
- Rozšíření platformy. Obchod neustále roste, přichází stále více uživatelů a návštěvnost se zvyšuje.
V minulosti se často říkalo: „Přepišme všechno v [jazyku/rámci], všechno bude fungovat lépe!“
Ve většině případů to nefunguje; je dobré, když přepracování vůbec funguje. Proto jsme potřebovali vytvořit plán – konkrétní strategii, která krok za krokem ilustruje, jak dosáhneme našich obchodních cílů (co budeme dělat a proč), který:
- odráží poslání a cíle projektu;
- upřednostňuje klíčové cíle;
- obsahuje harmonogram pro jejich dosažení.
Předtím nikdo s týmem nediskutoval o účelu jakýchkoli změn. To vyžaduje správné metriky úspěchu. Poprvé v historii společnosti jsme stanovili klíčové ukazatele výkonnosti (KPI) pro technický tým a propojili jsme tyto metriky s organizačními.
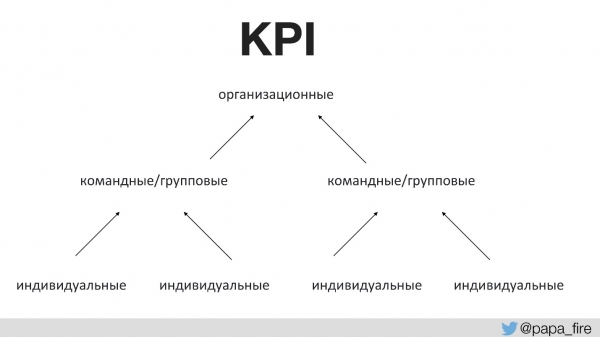
Jinými slovy, klíčové ukazatele výkonnosti organizace jsou podporovány týmy a klíčové ukazatele výkonnosti týmů jsou podporovány individuálními klíčovými ukazateli výkonnosti. V opačném případě, pokud klíčové ukazatele výkonnosti procesu nebudou v souladu s klíčovými ukazateli výkonnosti organizace, budou všichni nést odpovědnost.
Například jedním z klíčových ukazatelů výkonnosti organizace je zvyšování podílu na trhu prostřednictvím nových produktů.
Jak můžeme podpořit cíl mít více nových produktů?
- Zaprvé chceme trávit více času vývojem nových produktů místo opravováním vad. To je logické a snadno měřitelné rozhodnutí.
- Za druhé chceme podpořit růst objemu transakcí, protože čím větší je podíl na trhu, tím více uživatelů a v důsledku toho i více návštěvnosti.
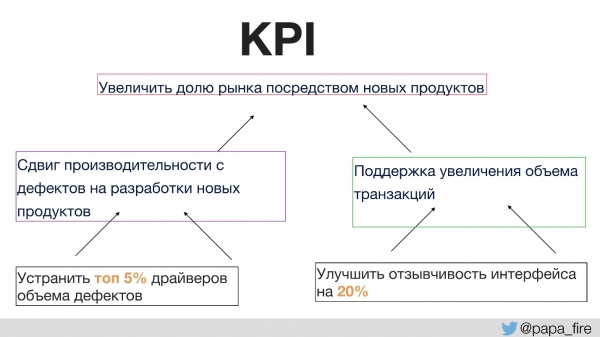
Jednotlivé klíčové ukazatele výkonnosti (KPI), které lze implementovat v rámci skupiny, pak budou například umístěny tam, kde vznikají hlavní vady. Zaměřením se konkrétně na tuto část můžete výrazně snížit počet vad, prodloužit čas strávený vývojem nových produktů a opět podpořit KPI organizace.
Proto každé rozhodnutí, včetně přepisování kódu, musí podporovat specifické cíle, které si pro nás společnost stanovila (organizační růst, nové funkce, nábor).
Během tohoto procesu se objevila zajímavá věc, která byla novinkou nejen pro technický tým, ale pro celou společnost: všechny tikety se musí zaměřovat alespoň na jeden klíčový ukazatel výkonnosti (KPI). Pokud tedy produktový manažer řekne, že chce vytvořit novou funkci, první otázka by měla znít: „Jaký KPI tato funkce podporuje?“ Pokud žádný, pak se omlouvám – zdá se to jako zbytečná funkce.
Den třicátý
Na konci měsíce jsem objevil další nuanci: nikdo z mého operačního týmu nikdy neviděl smlouvy, které podepisujeme s klienty. Možná se ptáte, proč by někdo chtěl vidět kontakty?
- Zaprvé proto, že SLA jsou specifikovány ve smlouvách.
- Za druhé, všechny SLA jsou jiné. Každý klient přišel s vlastními požadavky a obchodní tým je podepsal, aniž by se na ně podíval.
Ještě jeden zajímavý detail: smlouva s jedním z našich největších klientů stanoví, že všechny verze softwaru podporované platformou musí být n-1, tedy ne nejnovější verze, ale předposlední.
Je jasné, jak daleko jsme byli od n-1, pokud byla platforma založena na ColdFusion a SQL Serveru 2008, který v červenci přestal být vůbec podporován.
Den čtyřicátý pátý
Někdy kolem poloviny druhého měsíce jsem měl dost času sednout si a udělat hodnotaproudmapování Celý proces. Jedná se o nezbytné kroky, které je třeba podniknout, od vytvoření produktu až po dodání spotřebiteli, a musí být popsány co nejpodrobněji.
Rozdělíte proces na menší části a podíváte se na to, co trvá příliš dlouho, co lze optimalizovat, vylepšit atd. Například, jak dlouho trvá, než požadavek na produkt projde úpravou, kdy se dostane na tiket, který může vývojář zpracovat, QA atd. Podrobně se podíváte na každý krok a přemýšlíte o tom, co lze optimalizovat.
Když jsem to dělal, upoutaly mě do očí dvě věci:
- vysoké procento vrácených tiketů z QA zpět vývojářům;
- Kontrola žádostí o načtení trvala příliš dlouho.
Problém byl v tom, že se jednalo o závěry typu: zdá se, že to trvá dlouho, ale nejsme si jisti, kolik přesně.
"Nemůžete zlepšit to, co nemůžete měřit."
Jak můžete zdůvodnit, jak závažný je problém? Je to plýtvání dny nebo hodinami?
Abychom to změřili, přidali jsme do procesu Jira několik kroků: „připraveno pro vývoj“ a „připraveno pro QA“, abychom změřili, jak dlouho každý tiket čeká a kolikrát se vrátí do konkrétního kroku.
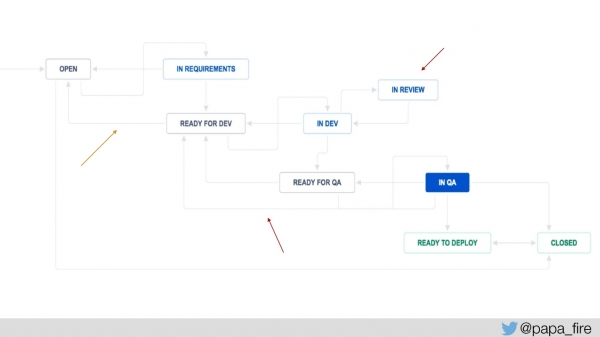
Také jsme přidali možnost „probíhá kontrola“, abychom mohli sledovat průměrnou dobu, po kterou jsou tikety kontrolovány, a odtud pak můžeme začít měřit. Systémové metriky jsme již měli, ale nyní jsme přidali nové a začali jsme měřit:
- Эффективность процесса: výkon a plánované/dodané.
- Kvalita procesu: počet vad, vady z QA.
Opravdu pomáhá pochopit, co se daří a co ne.
Den padesátý
To je samozřejmě hezké a zajímavé, ale ke konci druhého měsíce se stalo něco, co se dalo v podstatě předvídat, i když jsem nečekal takový rozsah. Lidé začali odcházet, protože se změnilo vedení. Do managementu přišli noví lidé a začali všechno měnit a ti staří odcházeli. A obvykle ve firmě, která existuje už pár let, jsou všichni přátelé a všichni se znají.
To se dalo očekávat, ale rozsah propouštění byl nečekaný. Například během jednoho týdne dva vedoucí týmů současně podali rezignaci. Takže jsem musel nejen zapomenout na jiné záležitosti, ale také se soustředit na... vytvoření týmuJe to dlouhý a obtížný problém k řešení, ale muselo se jím zabývat, protože jsme si chtěli udržet lidi, kteří zůstali (nebo alespoň většinu z nich). Museli jsme nějak reagovat na lidi, kteří odešli, abychom udrželi morálku v týmu.
Teoreticky je to dobrá věc: nový člověk přichází s úplnou volností, může posoudit dovednosti týmu a nahradit stávající zaměstnance. Ve skutečnosti je z různých důvodů nemožné jednoduše přivést nové lidi. Vždy je potřeba rovnováhy.
- Staří i noví. Potřebujeme si udržet staré lidi, kteří mohou změnit a podpořit naši misi. Zároveň ale potřebujeme přivést novou krev, o čemž si povíme o něco později.
- Zkušenosti. Hodně jsem mluvil s dobrými juniory, kteří se k nám dychtivě přidali. Ale nemohl jsem je najmout, protože nebylo dost seniorů, kteří by je podporovali a mentorovali. Museli jsme nejdřív najít ty nejlepší a teprve pak mladé.
- Mrkev a bič.
Nemám dobrou odpověď na otázku, jaká je správná rovnováha, jak ji udržet, kolik lidí si udržet a jak velký tlak vyvíjet. Je to čistě individuální proces.
Den padesátý jedna
Začal jsem se dívat na tým, abych zjistil, koho mám, a znovu jsem si vzpomněl:
"Většina problémů jsou problémy lidí."
Zjistil jsem, že tým jako celek, jak vývojáři, tak i operační tým, měl tři velké problémy:
- Spokojenost se současným stavem věcí.
- Nedostatek zodpovědnosti — protože nikdo nikdy nepromítl výsledky práce umělců do jejich dopadu na podnikání.
- Strach ze změny.
Změna vás vždycky vytrhne z vaší komfortní zóny a čím mladší lidé jsou, tím méně se jim změna líbí, protože nechápou proč nebo jak. Nejčastější odpovědí, kterou jsem slyšel, byla: „Nikdy jsme to takhle nedělali.“ To dosáhlo bodu naprosté absurdity – i sebemenší změna by se neobešla bez stížností někoho. A bez ohledu na to, jak moc změna ovlivnila jejich práci, lidé říkali: „Ne, proč se s tím obtěžovat? To nebude fungovat.“
Ale bez změny čehokoli se člověk nemůže zlepšit.
Měl jsem naprosto absurdní rozhovor s jedním zaměstnancem, sděloval jsem mu své nápady na optimalizaci, na což on řekl:
- Ach, neviděli jste, co jsme měli loni!
- Tak co?
— Teď je to mnohem lepší než dřív.
- Takže, lepší už to být nemůže?
- Na co?
Dobrá otázka – proč? Jako by, když jsou věci teď lepší než dříve, pak je všechno dost dobré. To vede k nedostatku odpovědnosti, což je naprosto normální. Jak jsem řekl, technologický tým byl trochu stranou. Společnost si myslela, že by tam měli být, ale nikdo nikdy nestanovil standardyTechnická podpora nikdy neviděla SLA, takže pro skupinu to bylo naprosto „přijatelné“ (a to mě zaujalo nejvíc):
- Načítání 12 sekund;
- 5–10 minut výpadku na vydání;
- Řešení kritických problémů trvá dny a týdny;
- žádný personál na pohotovosti 24 hodin denně, 7 dní v týdnu.
Nikdo se nikdy nepokusil zeptat, proč bychom to nemohli dělat lépe, a nikdo si nikdy neuvědomil, že by to takhle být nemělo.
Jako bonus tu byl ještě jeden problém: nedostatek zkušenostíSenioři odešli a zbývající mladý tým vyrůstal za minulého režimu a byl jím otráven.
Kromě toho všeho se lidé také báli selhání a toho, že budou vypadat neschopně. To se odrazilo ve skutečnosti, že zaprvé, za žádných okolností nepožádal o pomocKolikrát jsme se už bavili ve skupinách i individuálně a já jsem řekl: „Zeptejte se na něco, když nevíte, jak na něco?“ Jsem si jistý a vím, že dokážu vyřešit jakýkoli problém, ale bude to nějakou dobu trvat. Takže když se můžu zeptat někoho, kdo ví, jak to vyřešit, za 10 minut, udělám to. Čím méně zkušeností máte, tím více se bojíte zeptat, protože si myslíte, že budete považováni za neschopného.
Tento strach z kladení otázek se projevuje zajímavými způsoby. Například se zeptáte: „Jak jde tenhle úkol?“ a oni odpoví: „Je to už jen pár hodin, už jsem skoro hotový.“ Druhý den se zeptáte znovu a oni vám řeknou, že je všechno v pořádku, ale je tu jen jeden problém a ten bude do konce dne určitě hotový. Uběhne další den a dokud je nezaženete do kouta a nedonutíte je, aby si s někým promluvili, věci takto pokračují. Chtějí problém vyřešit sami a věří, že pokud ho sami nevyřeší, bude to obrovské selhání.
To je důvod, proč developeři nafoukli odhadyByl to docela vtip: když jsme probírali konkrétní úkol, dali mi číslo, které mě opravdu překvapilo. Řekli mi, že ve svých odhadech vývojáři zahrnují dobu, kterou bude trvat, než bude tiket vrácen z QA, protože najdou chyby, dobu, kterou to bude trvat PR, a dobu, kterou budou mít lidé, kteří ho mají zkontrolovat, zaneprázdněni – jinými slovy všechno možné.
Za druhé, lidé, kteří se bojí, že budou vypadat neschopně, přeanalyzovatKdyž jim řeknete, co přesně je třeba udělat, začnou říkat: „Ne, co kdybychom o tom přemýšleli tady?“ V tomto smyslu není naše společnost jedinečná; je to běžný problém mezi mladými lidmi.
V reakci na to jsem zavedl následující postupy:
- Pravidlo 30 minut. Pokud problém nedokážete vyřešit do půl hodiny, požádejte o pomoc někoho jiného. Funguje to s různou úspěšností, protože lidé se stejně neptají, ale alespoň proces začal.
- Eliminujte vše kromě podstaty, při odhadování času potřebného k dokončení úkolu, tedy berte v úvahu pouze to, jak dlouho bude trvat napsání kódu.
- Průběžné učení Pro ty, co přehánějí analýzu. Je to prostě neustálá práce s lidmi.
Den šedesátý
Zatímco jsem tohle všechno dělal, nastal čas vyřešit rozpočet. Samozřejmě jsem zjistil spoustu zajímavých věcí o tom, jak jsme utráceli peníze. Například jsme měli celý rack v samostatném datovém centru, ve kterém byl umístěn jeden FTP server používaný jedním klientem. Ukázalo se, že „...přestěhovali jsme se, ale zůstal tam, nenahradili jsme ho.“ To bylo před dvěma lety.
Obzvláště zajímavý byl účet za cloud. Jsem si jistý, že hlavním důvodem vysokého účtu za cloud je to, že vývojáři mají poprvé v životě neomezený přístup k serverům. Nemusí se ptát: „Prosím, dejte mi testovací server“ – můžou si ho obstarat sami. Navíc vývojáři vždycky chtějí postavit tak skvělý systém, že by jim Facebook a Netflix záviděly.
Vývojářům však chybí zkušenosti s nákupem serverů a dovednosti k určení správné velikosti serveru, protože to dříve nepotřebovali dělat. A často plně nechápou rozdíl mezi škálovatelností a výkonem.
Výsledky inventury:
- Pochází ze stejného datového centra.
- Ukončili jsme smlouvy se třemi logovacími službami. Protože jsme jich měli pět – každý vývojář, který si s něčím začal hrát, si najal nového.
- Sedm systémů AWS bylo vypnuto. Ani v tomto případě nebyly ukončeny nefunkční projekty, ale pokračovaly v provozu.
- Snížení nákladů na software šestinásobně.
Den sedmdesátý pátý
Čas plynul a za dva a půl měsíce jsem měl naplánovanou schůzku s představenstvem. Naše představenstvo není o nic lepší ani horší než kterékoli jiné; stejně jako všechny představenstva chce vědět všechno. Lidé investují peníze a chtějí pochopit, jak naše práce odpovídá našim klíčovým ukazatelům výkonnosti (KPI).
Představenstvo dostává každý měsíc spoustu informací: počet uživatelů, jejich růst, jaké služby využívají a jak, výkon a produktivitu a nakonec průměrnou rychlost načítání stránky.
Jediný problém je, že si myslím, že průměr je naprosté zlo. Ale je velmi těžké to vysvětlit představenstvu. Jsou zvyklí pracovat s agregovanými čísly, ne například s rozptylem doby načítání za sekundu.
V tomto ohledu se objevilo několik zajímavých bodů. Například jsem řekl, že provoz by měl být rozdělen mezi samostatné webové servery v závislosti na typu obsahu.
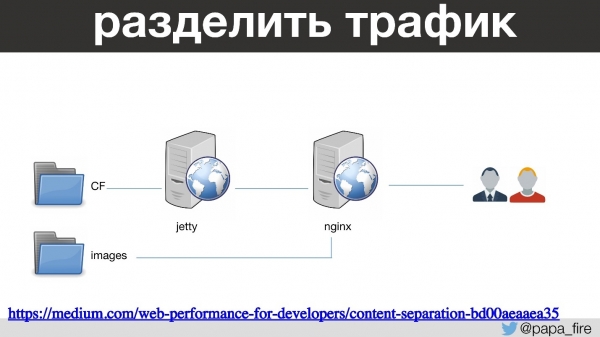
Takže ColdFusion prochází Jetty a nginx a spouští stránky. A obrázky, JS a CSS procházejí samostatným nginxem s vlastní konfigurací. To je poměrně standardní postup, o kterém mluvím. Ještě před pár lety. Díky tomu se obrázky načítají mnohem rychleji a... průměrná rychlost načítání se zvýšila o 200 ms.
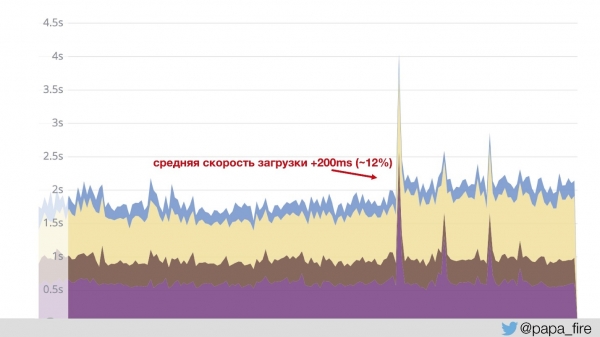
Stalo se to proto, že graf je založen na datech z Jetty. To znamená, že rychlý obsah není ve výpočtu zahrnut – průměrná hodnota vzrostla. Chápali jsme to a zasmáli jsme se tomu, ale jak jsme mohli představenstvu vysvětlit, proč jsme udělali něco, co způsobilo 12% pokles?
Den osmdesátý pátý
Na konci třetího měsíce jsem si uvědomil, že s jednou věcí jsem vůbec nepočítal: s časem. Všechno, o čem jsem mluvil, vyžaduje čas.
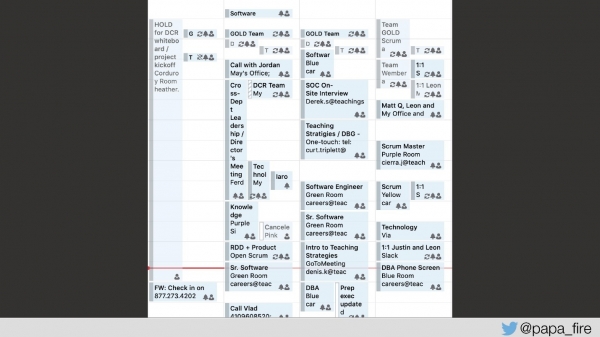
Toto je můj skutečný týdenní kalendář – jednoduchý pracovní týden, ne zrovna nabitý. Na všechno není dost času. Takže si opět musím najmout lidi, kteří mi s problémy pomohou.
Závěr
To není všechno. V tomto příběhu jsem se ani nedostal k tomu, jak jsme s produktem pracovali a snažili se shodnout, jak jsme integrovali technickou podporu nebo jak jsme řešili další technické problémy. Například jsem zcela náhodou zjistil, že nepoužíváme SEQUENCEMáme funkci, kterou jsme si sami napsali. nextIDa nepoužívá se v transakci.
Bylo by možné dlouze a podrobně diskutovat o milionu dalších podobných věcech. Ale nejdůležitější věcí, kterou stojí za zmínku, je kultura.
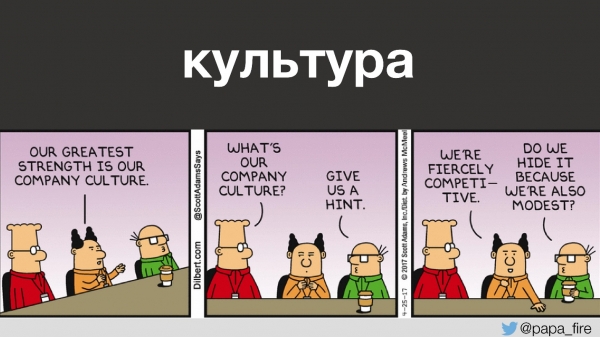
Je to kultura, respektive její nedostatek, která vede ke všem ostatním problémům. Snažíme se vybudovat kulturu, kde lidé:
- nebojí se selhání;
- poučit se z chyb;
- spolupracovat s ostatními týmy;
- projevit iniciativu;
- převzít odpovědnost;
- vítat výsledek jako cíl;
- oslavit úspěch.
S tím přijde i všechno ostatní.
Leon Fire , a .
Existují dvě strategie, jak se vypořádat s odkazem: za každou cenu se mu vyhnout, nebo statečně překonat těžkosti, které s ním souvisejí. My Vydáváme se druhou cestou, měníme procesy a přístupy. Přidejte se k nám. , и a společně implementujeme kulturu DevOps.
Zdroj: www.habr.com
