

Mezi SRE a DevOps inženýry nikoho nepřekvapí, že se občas objeví klient (nebo monitorovací systém) a oznámí, že "všechno zmizelo": web nefunguje, platby neprobíhají, život je prázdný… Jak by se mohlo zdát, že v takové situaci je obtížné pomoci bez jednoduchého a srozumitelného nástroje. Často je problém skrytý v kódu samotné aplikace — je třeba ho pouze lokalizovat.
Jak v bolesti, tak v radosti...
Stalo se, že jsme si New Relic velmi oblíbili. Bylo a zůstává to skvélé nástroj pro monitorování výkonu aplikace, a také umožňuje instrumentaci mikroslužebné architektury (pomocí svého agenta) a mnohem více. A všechno by mohlo být skvělé, kdyby ne změny v cenové politice služby: jeho cena vzrostla více než 3krát. Navíc, od loňského roku je pro získání trial účtu třeba komunikace s osobním manažerem, což ztěžuje prezentaci produktu potenciálnímu zákazníkovi.
Běžná situace: New Relic není potřeba "na stálé bázi", vzpomíná se na něj pouze ve chvíli, kdy začnou problémy. Ale platit je stejně třeba pravidelně (140 USD za server měsíčně), a v automaticky škálující se cloudové infrastruktuře se částky rychle nasčítají. Ačkoliv je možnost "Pay-As-You-Go", pro aktivaci New Relic je třeba restartovat aplikaci, což může vést ke ztrátě té problémové situace, pro kterou bylo vše zahájeno. Nedávno New Relic zavedl nový tarifní plán — , — který na první pohled vypadá jako rozumná alternativa k Professional… ale při podrobném zkoumání se ukázalo, že některé důležité funkce chybí (zejména v něm není Key Transactions, Cross Application Tracing, Distributed Tracing).
V důsledku toho jsme začali přemýšlet o hledání levnější alternativy, a náš výběr padl na dva služby: Datadog a Atatus. Proč právě na ně?
O konkurentech
Hned na úvod bych chtěl říci, že na trhu existují i další řešení. Dokonce jsme zvažovali varianty s otevřeným zdrojovým kódem, ale ne každý klient má volné kapacity pro nasazení řešení kategorie self-hosted… — navíc vyžadují další údržbu. Naše vybraná dvojice se ukázala jako nejbližší k našim potřebám:
- Vestavěná a rozsáhlá podpora aplikací PHP (náš zákaznický stack je velmi rozmanitý, ale to je jasný lídr v rámci hledání alternativy k New Relic);
- přijatelná cena (méně než 100 USD za měsíc za hosting);
- automatizované nástroje;
- integrace s Kubernetes;
- podobnost s rozhraním New Relic — výrazný plus (protože naši inženýři si na něj zvykli).
Proto jsme během prvního výběru vyloučili několik dalších populárních řešení, konkrétně:
- Tideways, AppDynamics a Dynatrace — kvůli ceně;
- Stackify — zablokováno v Ruské federaci a ukazuje příliš málo dat.
Následující článek je strukturován tak, že nejprve budou stručně představena zvažovaná řešení, po čemž budu hovořit o naší typické spolupráci s New Relic a zkušenostech / dojmech z provádění podobných operací v jiných službách.
Představení vybraných konkurentů
O , asi už slyšel každý? Tato služba začala svůj rozvoj před více než 10 lety, v roce 2008. Aktivně ji používáme od roku 2012 a nikdy jsme neměli problémy s integrací skutečně velkého počtu aplikací v jazycích PHP, Ruby a Python, a rovněž máme zkušenosti s integrací v jazycích C# a Go. Autoři služby mají řešení pro monitorování aplikací, infrastruktury, trasování mikroslužeb, vytvořili pohodlné aplikace pro uživatelská zařízení a mnohem více.
Agent New Relic však pracuje na proprietárních protokolech, nemá podporu OpenTracing. Pro rozšířenou instrumentaci je třeba provádět úpravy specificky pro New Relic. Nakonec podpora Kubernetes má zatím experimentální status.
Rozvíjející se od roku 2010 se jeví výrazně zajímavěji než New Relic právě z hlediska použití v prostředích Kubernetes. Konkrétně podporuje integraci s NGINX Ingress, sběr logů, protokoly statsd a OpenTracing, což umožňuje sledovat uživatelský požadavek od jeho připojení až po dokončení, a také najít logy k tomuto požadavku (jak na straně webového serveru, tak na straně consumerů).
Při používání Datadog jsme se setkali s tím, že někdy nesprávně vytvářel mapu mikroslužeb a měl některé technické nedostatky. Například nesprávně určil typ služby (vyhodnotil Django jako caching službu) a vyvolával 500 chyby v PHP aplikaci využívající populární knihovnu Predis.
— nejmladší nástroj; služba byla spuštěna v roce 2014. Její marketingový rozpočet je očividně nižší než u uvedených konkurentů a zmínky se objevují výrazně méně často. Přesto je nástroj sám o sobě velmi podobný New Relic, a to jak v možnostech (APM, monitorování prohlížeče atd.), tak i co se vzhledu týče.
Významným nedostatkem je podpora pouze Node.js a PHP. Na druhou stranu je realizována výrazně lépe než u Datadog. Na rozdíl od něj Atatus nevyžaduje od aplikací žádné úpravy a přidávání dalších značek do kódu.
Jak pracujeme s New Relic
Teď se podíváme na to, jak obvykle používáme New Relic. Předpokládejme, že máme problém, který vyžaduje řešení:
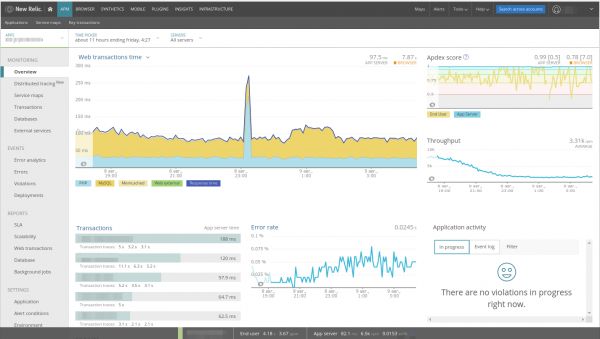
Na grafu je snadné si všimnout výkyvu — analyzujme ho. V New Relic pro webovou aplikaci jsou ihned vybrány webové transakce, na grafu výkonu jsou uvedeny všechny komponenty, přítomny jsou panely error-rate, request-rate… Nejpodstatnější je, že přímo z těchto panelů lze přecházet mezi různými částmi aplikace (například kliknutím na MySQL přejdete do sekce databází).
Jelikož v daném příkladu vidíme výkyv aktivity PHP, klikneme na tento graf a automaticky přejdeme do Transactions:
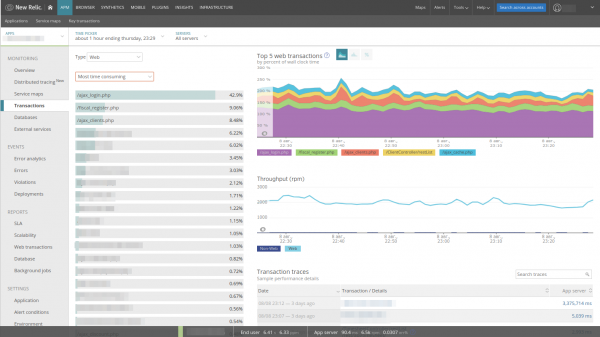
Seznam transakcí, které v podstatě představují kontrolery z modelu MVC, je již seřazen podle Most time consuming, což je velmi praktické: hned vidíme, čím se aplikace zabývá. Zde jsou k dispozici příklady dlouhých požadavků, které New Relic automaticky shromažďuje. Přepínáním třídění snadno najdeme:
- nejvíce zatížený kontroler aplikace;
- nejčastěji požadovaný kontroler;
- nejpomalejší kontroler.
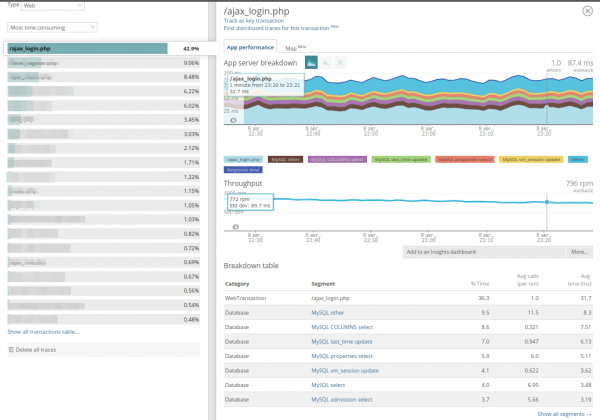
Kromě toho lze rozbalit každou transakci a vidět, čemu se aplikace věnovala během provádění kódu:
Konečně, v aplikaci se uchovávají příklady tras dlouhých požadavků (které trvají více než 2 sekundy). Tady je panel pro dlouhou transakci:
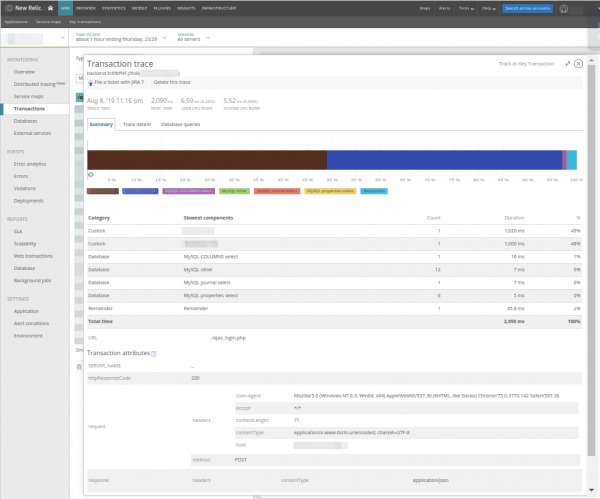
Je vidět, že dvě metody zabírají spoustu času, a přitom se ukazuje i čas, kdy byl požadavek vykonán, jeho URI a doména. Velmi často to pomáhá najít požadavek v logách. Přejdeme-li do Trace details, můžeme se podívat, odkud jsou tyto metody volány:
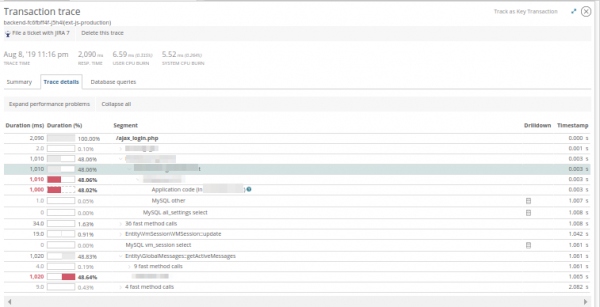
A v Database queries — odhadnout dotazy na databáze, které byly vykonávány v době, kdy aplikace fungovala:
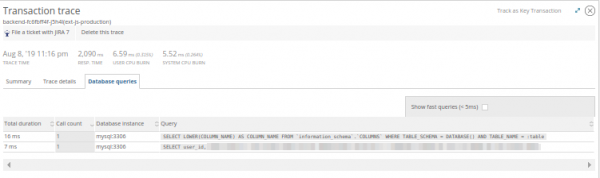
Se získanými znalostmi můžeme posoudit příčinu zpomalení aplikace a vypracovat strategii řešení problému společně s vývojářem. Ve skutečnosti New Relic ne vždy poskytuje jasný obraz, ale pomáhá zvolit směr vyšetřování:
- dlouhý
PDO::Constructnás dovedlo k podivnému fungování pgpoll; - nestabilita v čase
Memcache::Getnaznačila nesprávnou konfiguraci virtuálního stroje; - podezřele zvýšený čas na zpracování šablony vedl k vnořené smyčce s kontrolou existence 500 avatarů v objektovém úložišti;
- a tak dále…
Stává se také, že místo vykonávání kódu na hlavním displeji roste něco spojeného s externím úložištěm dat — a nezáleží na tom, zda jde o Redis nebo PostgreSQL — všechny se skrývají na kartě Databases.
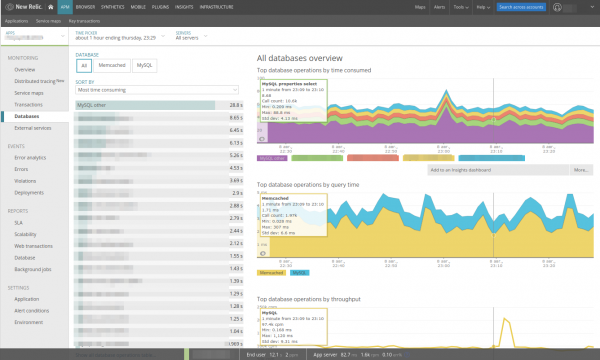
Můžete vybrat konkrétní databázi pro vyšetřování a provést třídění dotazů — analogicky, jak se to dělá v Transactions. A při přechodu na kartu dotazů uvidíte, kolikrát se tento dotaz vyskytuje v každém z kontrolerů aplikace, a také posoudit, jak často je volán. To je velmi praktické:
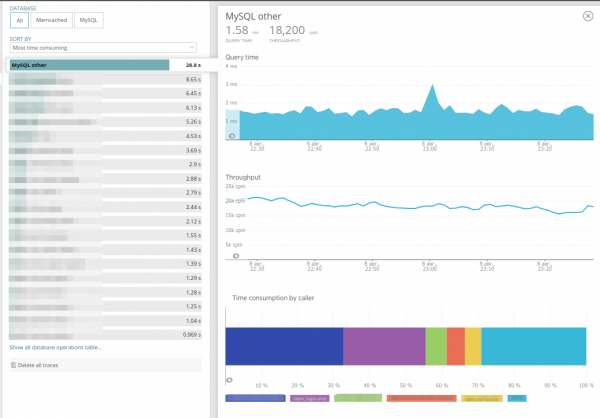
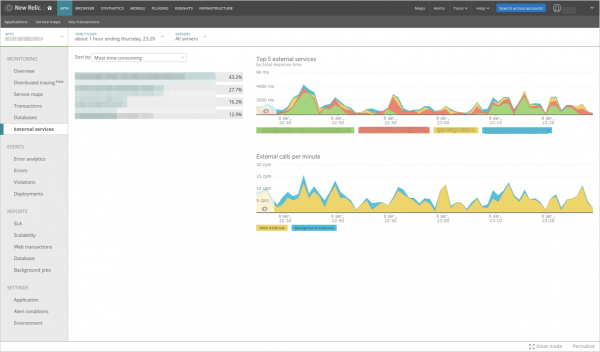
Podobné údaje obsahuje karta External Services, která skrývá dotazy na externí HTTP služby, jako je přístup k objektovému úložišti, odesílání událostí do Sentry nebo podobně. Podle svého obsahu je karta zcela analogická Databases:
Konkurenti: možnosti a dojmy
Teď to nejzajímavější — srovnejme schopnosti New Relic s tím, co nabízejí konkurenti. Bohužel jsme nemohli otestovat všechny tři nástroje na jedné verzi jedné funkční produkční aplikace. Přesto jsme se snažili porovnat co nejpodobnější situace/configurace.
1. Datadog
Datadog nás vítá panelem se zdí služeb:
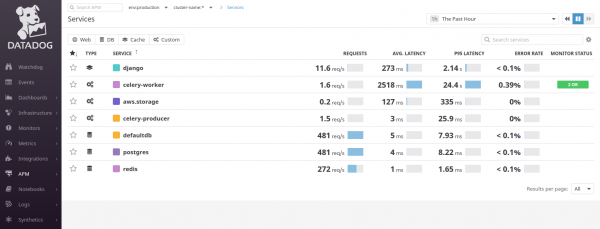
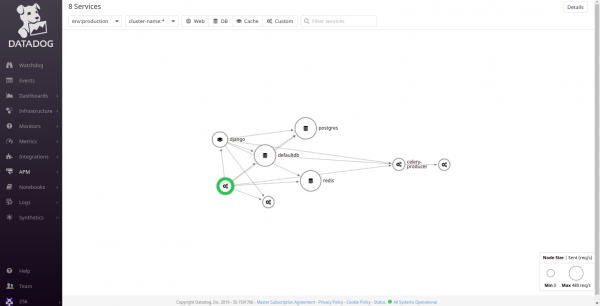
Snaží se rozdělit aplikace na komponenty/mikroslužby, takže u uvedeného příkladu Django aplikace uvidíme 2 připojení k PostgreSQL (defaultdb a Postgres), stejně jako Celery a Redis. Práce s Datadogem od vás vyžaduje minimální znalosti principů MVC: je nutné chápat, kam vlastně přicházejí požadavky uživatelů. Obvykle pomáhá mapa služeb:
Mimochodem, něco podobného má i New Relic:
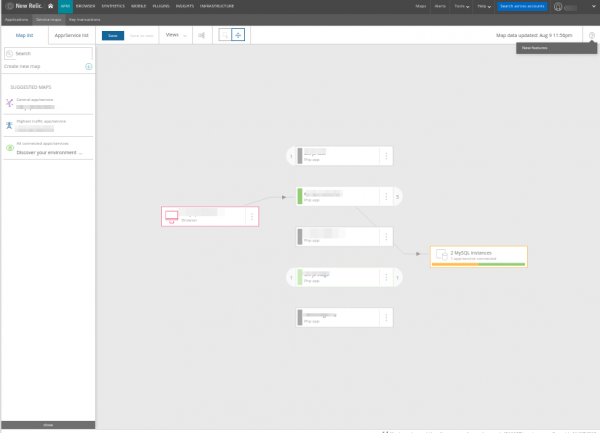
… a jejich mapa je podle mého názoru jednodušší a přehlednější: zobrazuje konkrétní služby nebo mikroslužby, místo aby se soustředila na komponenty jedné aplikace (což by ji činilo zbytečně podrobnou, jako v případě Datadog).
Vrátíme se k Datadogu: z mapy služeb je vidět, že uživatelské požadavky přicházejí do Django. Přejdeme k službě Django a konečně uvidíme to, co jsme očekávali:
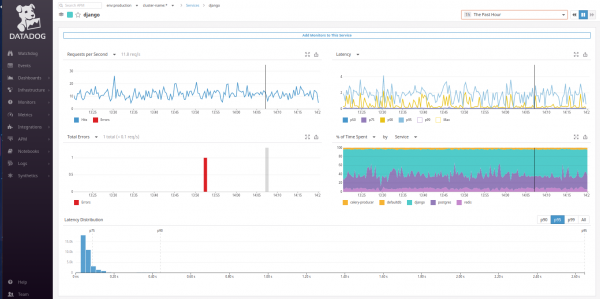
Bohužel, standardně zde chybí graf Čas webové transakce, analogický tomu, co vidíme na hlavní panelu New Relic. Nicméně ho lze nastavit na místě grafu % času stráveného. Stačí ho přepnout na Průměrný čas na požadavek podle typu… a už se na nás dívá známý graf!
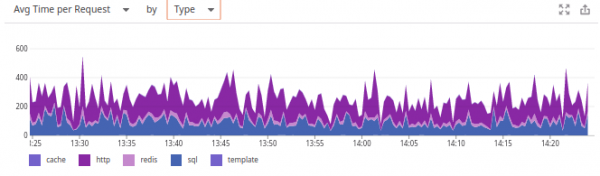
Proč v Datadogu dali přednost jinému grafu — to je pro nás záhadou. Zklamalo nás také to, že systém si nepamatuje výběr uživatele (na rozdíl od obou konkurentů), a tak zůstává jedinou možností vytváření uživatelských panelů.
Na druhou stranu potěšila možnost v Datadogu přejít z těchto grafů na metriky souvisejících serverů, prohlédnout si logy a vyhodnotit zatížení zpracovatelů webového serveru (Gunicorn). Všechno skoro jako v New Relic… a dokonce trochu více (logy)!
Pod grafy se nacházejí transakce, které jsou zcela analogické New Relic:
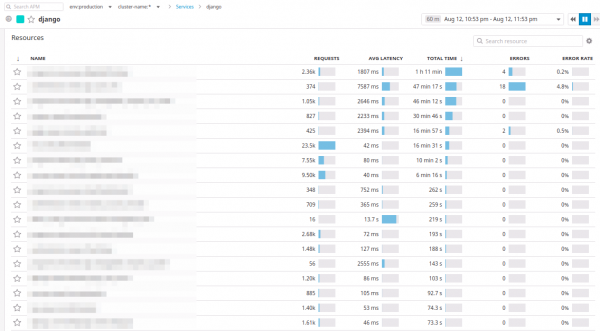
V Datadogu se transakce nazývají zdroji. Lze třídit kontrolery podle počtu požadavků, průměrného času odezvy nebo maximálního času spotřebovaného za vybrané časové období.
Zdroje je možné rozbalit a vidět vše, co jsme již sledovali v New Relic:
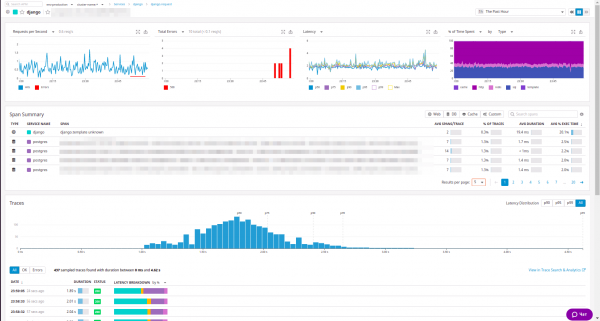
Dostupná je zde jak statistika o zdroji, tak souhrnný seznam vnitřních volání, a příklady požadavků, které lze třídit podle kódu odpovědi… Mimochodem, toto třídění se velmi líbilo našim inženýrům.
Jakýkoli příklad zdroje v Datadogu lze rozbalit a prostudovat:
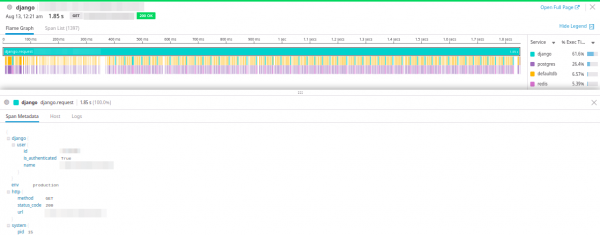
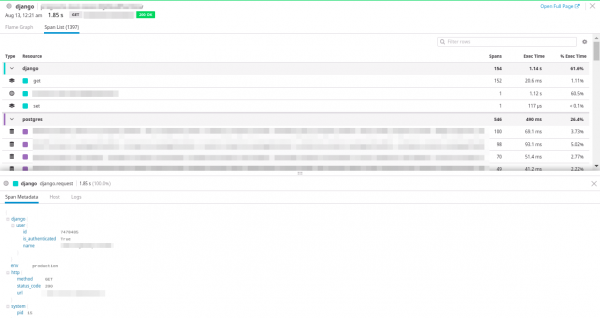
Jsou zde uvedeny parametry požadavku, souhrnný graf o čase stráveném na každé z komponent a vodopádový graf, kde je vidět sekvenci volání. K dispozici je také přepnutí na stromový pohled vodopádového grafu:
A to nejzajímavější — přehled vytížení hostitele, na kterém byl požadavek proveden, a přehled logů požadavku.
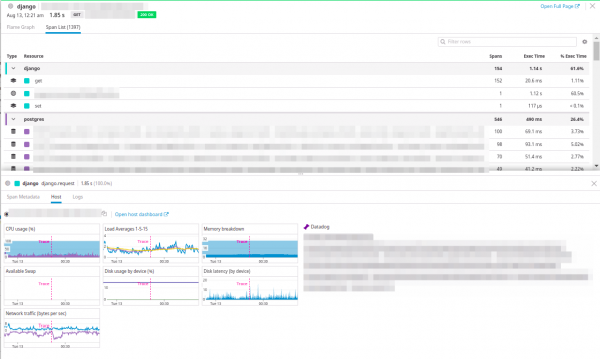
Skvělá integrace!
Může se objevit otázka, kde jsou karty Databases a External Services, jako v New Relic. Zde nejsou: protože Datadog rozebírá aplikaci na komponenty, PostgreSQL bude považováno za samostatnou službu, a místo External Services byste měli hledat aws.storage (podobně to platí i pro každou jinou externí službu, na kterou může aplikace vyžadovat.)
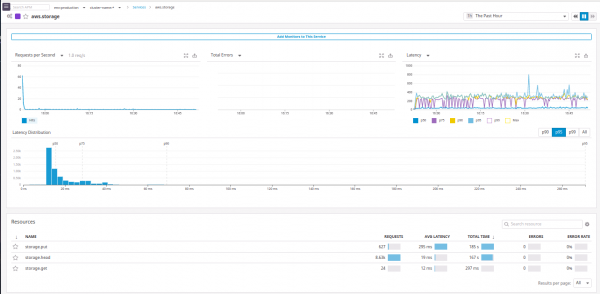
A zde je příklad s Postgres:
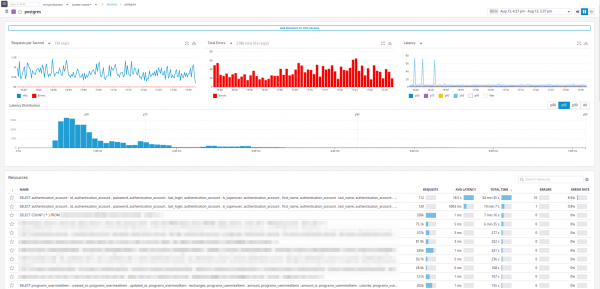
V podstatě máme všechno, co jsme chtěli:
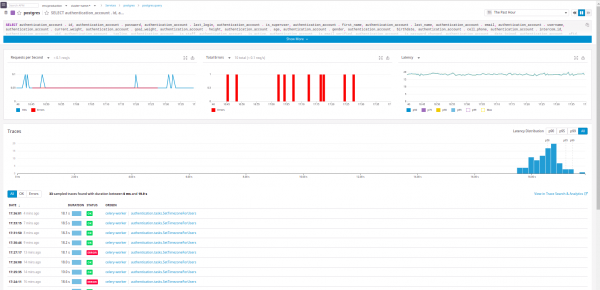
Je vidět, z jakého "servisu" přišel požadavek.
Nebude na škodu připomenout, že Datadog se skvěle integruje s NGINX Ingress a umožňuje provádět end-to-end trasování od okamžiku, kdy požadavek dorazí do clusteru, a také přijímat metriky statsd, sbírat logy a metriky hostitelů.
Obrovskou výhodou Datadog je, že jeho cena se skládá z monitorování infrastruktury, APM, Log Management a Synthetics test, tj. je možné flexibilně vybrat plán.
2. Atatus
Tým Atatus tvrdí, že jejich služba je "taková, jako New Relic, ale lepší". Podíváme se, zda je to skutečně pravda.
Hlavní panel vypadá skutečně podobně, ale nebylo možné určit, zda aplikace používá Redis a memcached.
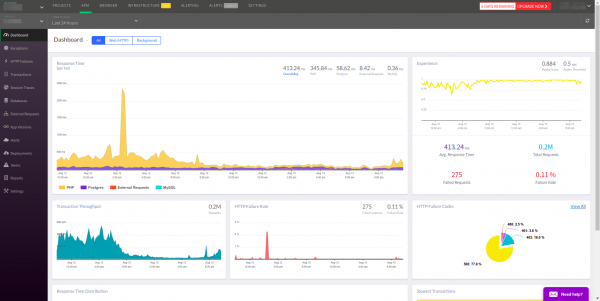
APM standardně vybírá všechny transakce, i když obvykle jsou potřeba pouze Web. Stejně jako u Datadog není možné přepnout na požadovanou službu z hlavního panelu. Navíc jsou transakce uvedeny v seznamu po chybách, což pro APM nevypadá příliš logicky.
V transakcích má Atatus všechno maximálně podobné jako New Relic. Nevýhodou je, že není hned vidět dynamika pro každý z kontrolérů. Tu je třeba hledat v tabulce kontrolérů, řadit podle Most Time Consumed:
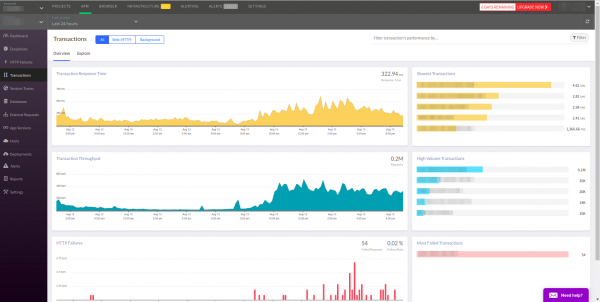
Seznam kontrolérů, na který jsme zvyklí, je k dispozici na záložce Explore:
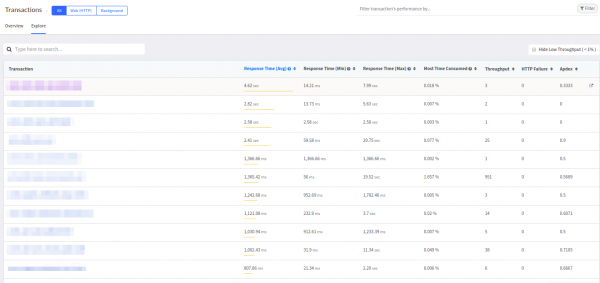
Tato tabulka svým způsobem připomíná Datadog a je oblíbenější než ta v New Relic.
Každou transakci lze rozbalit a podívat se, čím se aplikace zabývala:
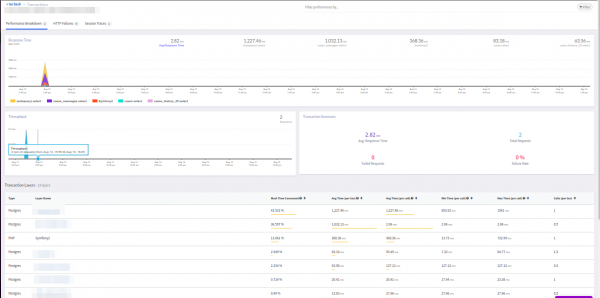
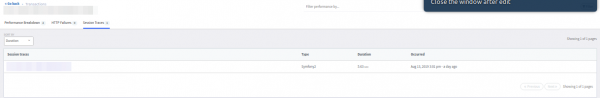
Panel spíše připomíná Datadog: jsou zde počty požadavků, celkový přehled volání. Horní panel nabízí záložku s chybami HTTP Failures a příklady pomalých požadavků Session Traces:
Pokud přejdete na transakci, můžete vidět příklad tracování, získat seznam požadavků na databázi a prohlédnout si hlavičky požadavku. Všechno je to podobné jako u New Relic:
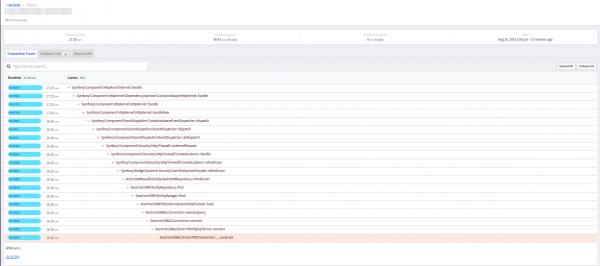
Celkově, Atatus potěšil podrobnými tracemi — bez typických slepování volání do reminder bloku, jak je tomu u New Relic:
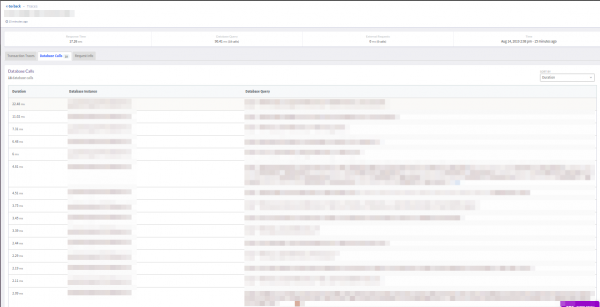
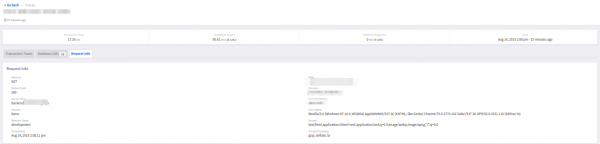
Chybí zde však filtr, který by (jako u New Relic) vyřazoval nadmíru rychlé požadavky (<5ms). Na druhou stranu se mi líbilo zobrazení konečné odpovědi transakce (úspěšná nebo chyba).
Panel Databases pomůže prozkoumat požadavky na externí databáze, které aplikace dělá. Připomínám, že Atatus nalezl pouze PostgreSQL a MySQL, ačkoli v projektu jsou zapojeny také Redis a memcached.
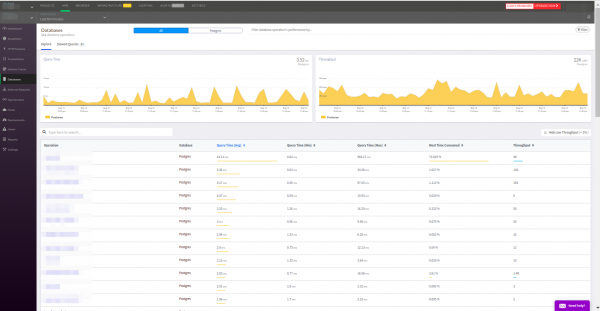
Dotazy jsou tříděny podle běžných kritérií: četnost výskytu, průměrná doba odezvy a tak dále. Zvlášť bych chtěl vyzdvihnout záložku s nejpomalejšími dotazy — to je velmi praktické. Navíc data v této záložce pro PostgreSQL odpovídají datům z rozšíření — skvělý výsledek!
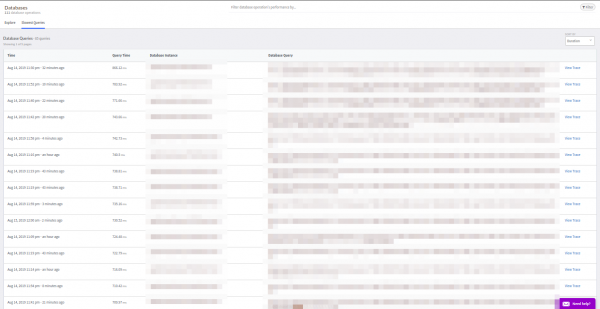
Záložka Externí požadavky je plně identická s Databázemi.
Závěry
Obě představované nástroje se dobře osvědčily jako APM. Každý z nich může nabídnout nezbytné minimum. Shrnutí našich dojmů vypadá takto:
Datadog
Plusy:
- pohodlná cenová struktura (APM stojí 31 USD za hostování);
- skvěle fungoval s Pythonem;
- možnost integrace s OpenTracing
- integrace s Kubernetes;
- integrace s NGINX Ingress.
Nevýhody:
- jediný APM, který způsobil nedostupnost aplikace kvůli chybě modulu (predis);
- slabá automatická instrumentace PHP;
- částečně podivné určení služeb a jejich účelu.
Atatus
Plusy:
- hluboká instrumentace PHP;
- uživatelské rozhraní podobné New Relic.
Nevýhody:
- nefunguje na starých operačních systémech (Ubuntu 12.05, CentOS 5);
- slabá automatická instrumentace;
- podpora pouze dvou programovacích jazyků (Node.js a PHP);
- pomalá práce rozhraní.
S ohledem na cenu Atatus ve výši 69 USD měsíčně za server bychom raději použili Datadog, který se skvěle integruje do našich potřeb (webové aplikace v K8s) a nabízí řadu užitečných funkcí.
P.S.
Přečtěte si také náš blog:
- «»;
- «»;
- «».
Zdroj: habr.com
