

Ahoj, Habr!
Připomínáme, že po knize o jsme vydali neméně zajímavou práci o knihovně .
Zatímco komunita teprve objevuje hranice možností tohoto mocného nástroje. Nedávno vyšel článek, se kterým vás chceme seznámit. Na vlastních zkušenostech autor popisuje, jak přetvořit Kafka Streams na distribuované úložiště dat. Příjemné čtení!
Knihovna Apache se po celém světě používá v podnicích pro distribuované streamování dat nad Apache Kafka. Jeden z podceňovaných aspektů tohoto rámce spočívá v tom, že umožňuje uchovávat místní stav, který vzniká na základě streamovaného zpracování.
V tomto článku budu vyprávět, jak se nám v naší společnosti podařilo výhodně využít tuto možnost při vývoji produktu pro zabezpečení cloudových aplikací. Pomocí Kafka Streams jsme vytvořili mikroslužby se sdíleným stavem, z nichž každá slouží jako odolný a vysoce dostupný zdroj spolehlivých informací o stavu objektů v systému. Pro nás je to krok vpřed jak co do spolehlivosti, tak co do pohodlí údržby.
Pokud vás zajímá alternativní přístup, který umožňuje používat jednotnou centrální databázi pro podporu formálního stavu vašich objektů – přečtěte si, bude to zajímavé…
Proč jsme usoudili, že je čas změnit naše přístupy k práci se sdíleným stavem
Potřebovali jsme udržovat stav různých objektů, založený na zprávách agentů (například: byl web napaden?). Před přechodem na Kafka Streams jsme často spoléhali na jediné centrální databázi (+ servisní API) pro řízení stavu. Tento přístup má své nedostatky: v udržování konzistence a synchronizace se stává skutečnou výzvou. Databáze se může stát úzkým místem, nebo se ocitnout v a trpět nepředvídatelností.
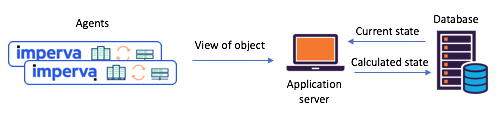
Ilustrace 1: typický scénář s rozdělením stavu, který byl běžný před přechodem na
Kafka a Kafka Streams: agenti předkládají své pohledy přes API, aktualizovaný stav se vypočítává přes centrální databázi.
Seznamte se s Kafka Streams – nyní je jednoduché vytvářet mikroslužby se sdíleným stavem.
Přibližně před rokem jsme se rozhodli pořádně přepracovat naše scénáře pro práci se sdíleným stavem, abychom se vypořádali s těmito problémy. Okamžitě jsme se rozhodli vyzkoušet Kafka Streams – je známo, jak je škálovatelná, vysoce dostupná a odolná proti chybám, jaká bohatá funkčnost streamování nabízí (transformace, včetně těch s uchováním stavu). Přesně to, co jsme potřebovali, nemluvě o tom, jak zralý a spolehlivý systém výměny zpráv v Kafka vznikl.
Každý z našich vytvořených mikroslužeb se sdíleným stavem byl postaven na základě instance Kafka Streams s poměrně jednoduchou topologií. Sestával se z 1) zdroje 2) procesoru s trvalým uložením klíčů a hodnot 3) potrubí:
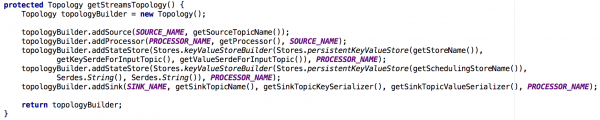
Obrázek 2: výchozí topologie našich streamingových instancí pro mikroslužby se sdíleným stavem. Všimněte si, že zde je také úložiště, které obsahuje metadata o plánování.
Při této nové přístupu agenti vytvářejí zprávy, které se posílají do výchozího topiku, a spotřebitelé – například služba poštovních upozornění – přijímají vypočítaný sdílený stav přes potrubí (výstupní topik).
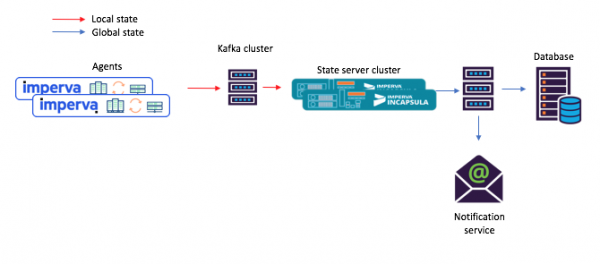
Obrázek 3: nový příklad správního toku pro scénář se sdílenými mikroslužbami: 1) agent generuje zprávu, která se dostane do výchozího topiku Kafka; 2) mikroslužba se sdíleným stavem (používající Kafka Streams) ji zpracovává a zapisuje vypočítaný stav do koncového topiku Kafka; po čemž 3) spotřebitelé přijímají nový stav.
Hele, to vestavěné úložiště klíčů a hodnot je opravdu velmi užitečné!
Jak bylo zmíněno výše, naše topologie se sdíleným stavem obsahuje úložiště klíčů a hodnot. Našli jsme několik možností jeho použití a dvě z nich jsou popsány níže.
Možnost č. 1: použití úložiště klíčů a hodnot při výpočtech.
Naše první úložiště klíčů a hodnot obsahovalo pomocná data, která jsme potřebovali pro výpočty. Například v některých případech bylo sdílené stavové určeno na základě principu „většinového hlasování“. V úložišti jsme mohli uchovávat všechny poslední zprávy agentů o stavu určitého objektu. Poté, co jsme obdrželi novou zprávu od jednoho z agentů, jsme mohli její zprávu uložit, vyhledat zprávy všech ostatních agentů o stavu téhož objektu a zopakovat výpočet.
Níže na ilustraci 4 je znázorněno, jak jsme otevřeli přístup k úložišti klíčů a hodnot zpracovávajícímu metodě procesoru, aby bylo možné zpracovat novou zprávu.
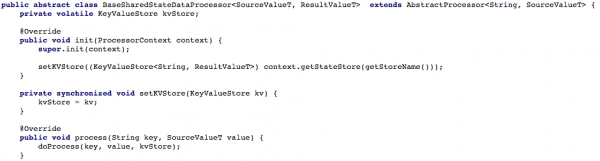
Ilustrace 4: otevření přístupu k úložišti klíčů a hodnot pro zpracovávající metodu procesoru (poté je v každém scénáři pracujícím se sdíleným stavem nutné implementovat metodu doProcess)
Varianta #2: vytvoření CRUD API nad Kafka Streams
Poté, co jsme nastavili náš základní tok úloh, jsme se pokusili napsat RESTful CRUD API pro naše mikroservisy se sdíleným stavem. Chtěli jsme, aby bylo možné získávat stav některých nebo všech objektů, a také nastavovat nebo odstraňovat stav objektu (což je užitečné při podpoře serverové části).
Pro podporu všech API Get State, kdykoli bylo potřeba znovu vypočítat stav při zpracování, jsme ho na dlouho ukládali do vestavěného úložiště klíčů a hodnot. V takovém případě je dostatečně jednoduché implementovat takové API pomocí jediného instance Kafka Streams, jak je ukázáno v následujícím výpisu:
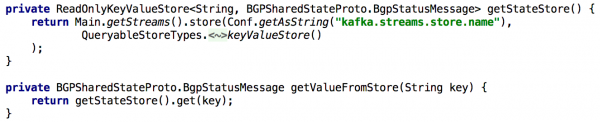
Ilustrace 5: použití vestavěného úložiště klíčů a hodnot pro získání předpočítaného stavu objektu
Aktualizace stavu objektu prostřednictvím API také není složitá. V zásadě je třeba pouze vytvořit producenta Kafka a pomocí něj provést zápis, který obsahuje nový stav. Tím se zaručuje, že všechny zprávy generované prostřednictvím API budou zpracovávány přesně tak, jak ty, které přicházejí od jiných producentů (např. agentů).
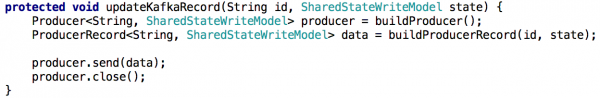
Ilustrace 6: stav objektu lze nastavit pomocí producenta Kafka
Malé komplikace: Kafka má mnoho partií
Dále jsme chtěli rozložit zátěž spojenou s zpracováním a zlepšit dostupnost tím, že na každý scénář poskytneme cluster mikroslužeb se sdíleným stavem. Konfigurace se nám zdála snadná: jakmile jsme nastavili všechny instance tak, aby pracovaly s tím samým ID aplikace (a se stejnými servery pro počáteční nahrání), prakticky všechno ostatní se dělalo automaticky. Také jsme stanovili, že každý zdrojový topic se bude skládat z několika partií, aby každé instanci bylo možné přiřadit podmnožinu těchto partií.
Také bych chtěl zmínit, že zde je běžné dělat zálohu úložiště stavů, abychom v případě obnovení po selhání mohli přesunout tuto kopii na jinou instanci. Na každé úložiště stavů v Kafka Streams se vytváří replikační topic s logem změn (v němž se sledují lokální aktualizace). Tímto způsobem Kafka neustále zabezpečuje úložiště stavů. Proto v případě selhání určité instance může být úložiště stavů Kafka Streams rychle obnoveno na jiné instanci, kam přejdou odpovídající partie. Naše testy ukázaly, že to lze provést během několika sekund, i když jsou v úložišti miliony záznamů.
Při přechodu od jedné mikroslužby se sdíleným stavem k clustru mikroslužeb se implementace Get State API stává méně triviální. V nové situaci se v úložišti stavů každé mikroslužby nachází pouze část celkového obrazu (ty objekty, jejichž klíče byly přiřazeny konkrétní partii). Museli jsme určit, na které instanci se nachází stav požadovaného objektu, což jsme dělali na základě metadat proudů, jak je ukázáno níže:
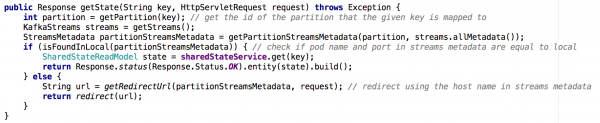
Ilustrace 7: pomocí metadat proudů určujeme, z jaké instance požadovat stav požadovaného objektu; podobný přístup byl použit s API GET ALL.
Hlavní závěry
Úložiště stavů v Kafka Streams de facto mohou sloužit jako distribuovaná databáze,
- neustále replikovaná v Kafka.
- Nad touto systémem se snadno staví CRUD API.
- Zpracování více partií se stává o něco složitějším.
- Je možné přidat jedno nebo více úložišť stavů do streamové topologie pro ukládání pomocných dat. Tato možnost může být využita pro:
- Dlouhodobé ukládání dat potřebných pro výpočty během streamového zpracování
- Dlouhodobé ukládání dat, která mohou být užitečná při další inicializaci streamové instance
- mnoho dalšího…
Díky těmto a dalším výhodám je Kafka Streams skvěle vhodná pro podporu globálního stavu v takovém distribuovaném systému, jako je náš. Kafka Streams se ukázala jako velmi spolehlivá v produkčním prostředí (od doby jejího nasazení jsme prakticky neztratili žádné zprávy), a jsme si jisti, že její možnosti tím rozhodně nekončí!
Zdroj: habr.com
