

LINQ byl zavedeno do .NET jako nový mocný jazyk pro manipulaci s daty. LINQ to SQL jako jeho součást umožňuje poměrně pohodlnou komunikaci se SGBD například prostřednictvím Entity Framework. Často se však stává, že vývojáři zapomínají sledovat, jaký konkrétní SQL dotaz bude generovat queryable provider, v tomto případě — Entity Framework.
Podíváme se na dva hlavní aspekty na příkladu.
Za tímto účelem vytvoříme v SQL Serveru databázi Test a v ní vytvoříme dvě tabulky pomocí následujícího dotazu:
Vytváření tabulek
USE [TEST]
GO

SET ANSI_NULLS ON
GO

SET QUOTED_IDENTIFIER ON
GO

CREATE TABLE [dbo].[Ref](
	[ID] [int] NOT NULL,
	[ID2] [int] NOT NULL,
	[Name] [nvarchar](255) NOT NULL,
	[InsertUTCDate] [datetime] NOT NULL,
 CONSTRAINT [PK_Ref] PRIMARY KEY CLUSTERED
(
	[ID] ASC
)WITH (PAD_INDEX = OFF, STATISTICS_NORECOMPUTE = OFF, IGNORE_DUP_KEY = OFF, ALLOW_ROW_LOCKS = ON, ALLOW_PAGE_LOCKS = ON) ON [PRIMARY]
) ON [PRIMARY]
GO

ALTER TABLE [dbo].[Ref] ADD  CONSTRAINT [DF_Ref_InsertUTCDate]  DEFAULT (getutcdate()) FOR [InsertUTCDate]
GO

USE [TEST]
GO

SET ANSI_NULLS ON
GO

SET QUOTED_IDENTIFIER ON
GO

CREATE TABLE [dbo].[Customer](
	[ID] [int] NOT NULL,
	[Name] [nvarchar](255) NOT NULL,
	[Ref_ID] [int] NOT NULL,
	[InsertUTCDate] [datetime] NOT NULL,
	[Ref_ID2] [int] NOT NULL,
 CONSTRAINT [PK_Customer] PRIMARY KEY CLUSTERED
(
	[ID] ASC
)WITH (PAD_INDEX = OFF, STATISTICS_NORECOMPUTE = OFF, IGNORE_DUP_KEY = OFF, ALLOW_ROW_LOCKS = ON, ALLOW_PAGE_LOCKS = ON) ON [PRIMARY]
) ON [PRIMARY]
GO

ALTER TABLE [dbo].[Customer] ADD  CONSTRAINT [DF_Customer_Ref_ID]  DEFAULT ((0)) FOR [Ref_ID]
GO

ALTER TABLE [dbo].[Customer] ADD  CONSTRAINT [DF_Customer_InsertUTCDate]  DEFAULT (getutcdate()) FOR [InsertUTCDate]
GO
Nyní naplníme tabulku Ref pomocí spuštění následujícího skriptu:
Naplnění tabulky Ref
USE [TEST]
GO

DECLARE @ind INT=1;

WHILE(@ind<1200000)
BEGIN
	INSERT INTO [dbo].[Ref]
           ([ID]
           ,[ID2]
           ,[Name])
    SELECT
           @ind
           ,@ind
           ,CAST(@ind AS NVARCHAR(255));

	SET @ind=@ind+1;
END
GO
Analogicky naplníme tabulku Customer pomocí následujícího skriptu:
Naplnění tabulky Customer
POUŽIJTE [TEST]
GO

DECLARE @ind INT=1;
DECLARE @ind_ref INT=1;

WHILE(@ind<=12000000)
BEGIN
	IF(@ind%3=0) SET @ind_ref=1;
	ELSE IF (@ind%5=0) SET @ind_ref=2;
	ELSE IF (@ind%7=0) SET @ind_ref=3;
	ELSE IF (@ind=0) SET @ind_ref=4;
	ELSE IF (@ind=0) SET @ind_ref=5;
	ELSE IF (@ind=0) SET @ind_ref=6;
	ELSE IF (@ind=0) SET @ind_ref=7;
	ELSE IF (@ind=0) SET @ind_ref=8;
	ELSE IF (@ind=0) SET @ind_ref=9;
	ELSE IF (@ind=0) SET @ind_ref=10;
	ELSE IF (@ind=0) SET @ind_ref=11;
	ELSE SET @ind_ref=@ind90000;

	INSERT INTO [dbo].[Customer]
	 ([ID]
	 ,[Name]
	 ,[Ref_ID]
	 ,[Ref_ID2])
	 SELECT
	 @ind,
	 CAST(@ind AS NVARCHAR(255)),
	 @ind_ref,
	 @ind_ref;


	SET @ind=@ind+1;
END
GO
Tak jsme získali dvě tabulky, z nichž jedna obsahuje více než 1 milion řádků dat a druhá více než 10 milionů řádků dat.
Nyní je v aplikaci Visual Studio potřeba vytvořit testovací projekt Visual C# Console App (.NET Framework):
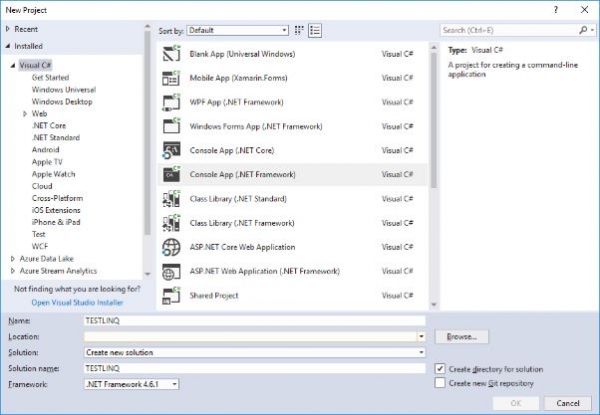
Dále je třeba pro interakci s databází přidat knihovnu Entity Framework.
Abychom ji přidali, klikneme na projekt pravým tlačítkem myši a v kontextovém menu vybereme Manage NuGet Packages:
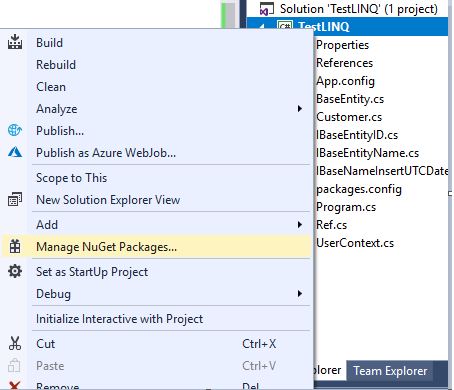
Poté v otevřeném okně správy NuGet balíčků do vyhledávacího pole zadáme slovo „Entity Framework“ a vybereme balíček Entity Framework a nainstalujeme jej:
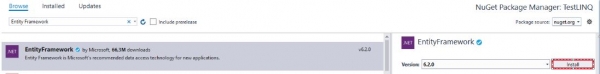
Poté do souboru App.config po uzavření prvku configSections je třeba přidat následující blok:
Do connectionString je třeba napsat řetězec připojení.
Nyní vytvoříme v samostatných souborech 3 rozhraní:
- Implementace rozhraní IBaseEntityID
namespace TestLINQ { public interface IBaseEntityID { int ID { get; set; } } } - Implementace rozhraní IBaseEntityName
namespace TestLINQ { public interface IBaseEntityName { string Name { get; set; } } } - Implementace rozhraní IBaseNameInsertUTCDate
namespace TestLINQ
{
    public interface IBaseNameInsertUTCDate
    {
        DateTime InsertUTCDate { get; set; }
    }
}
A v samostatném souboru vytvoříme základní třídu BaseEntity pro naše dvě entity, která bude obsahovat společná pole:
Implementace základní třídy BaseEntity
namespace TestLINQ
{
    public class BaseEntity : IBaseEntityID, IBaseEntityName, IBaseNameInsertUTCDate
    {
        public int ID { get; set; }
        public string Name { get; set; }
        public DateTime InsertUTCDate { get; set; }
    }
}
Dále v samostatných souborech vytvoříme naše dvě entity:
- Implementace třídy Ref
using System.ComponentModel.DataAnnotations.Schema; namespace TestLINQ { [Table("Ref")] public class Ref : BaseEntity { public int ID2 { get; set; } } } - Implementace třídy Customer
using System.ComponentModel.DataAnnotations.Schema;

namespace TestLINQ
{
    [Table("Customer")]
    public class Customer: BaseEntity
    {
        public int Ref_ID { get; set; }
        public int Ref_ID2 { get; set; }
    }
}
Nyní vytvoříme v samostatném souboru kontext UserContext:
Implementace třídy UserContext
using System.Data.Entity;

namespace TestLINQ
{
    public class UserContext : DbContext
    {
        public UserContext()
            : base("DbConnection")
        {
            Database.SetInitializer(null);
        }

        public DbSet Customer { get; set; }
        public DbSet Ref { get; set; }
    }
}
Dostali jsme hotové řešení pro provádění testů optimalizace s LINQ to SQL prostřednictvím EF pro MS SQL Server:
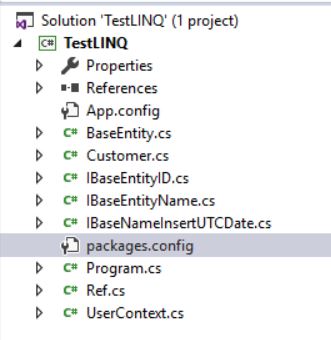
Nyní do souboru Program.cs zadejte následující kód:
Soubor Program.cs
using System;
using System.Collections.Generic;
using System.Linq;

namespace TestLINQ
{
    class Program
    {
        static void Main(string[] args)
        {
            using (UserContext db = new UserContext())
            {
                var dblog = new List();
                db.Database.Log = dblog.Add;

                var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                 && (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };

                var result = query.Take(1000).ToList();

                Console.WriteLine(dblog[1]);

                Console.ReadKey();
            }
        }
    }
}
Nyní spustíme náš projekt.
Na konci běhu se na konzoli zobrazí:
Generovaný SQL dotaz
SELECT TOP (1000)
    [Extent1].[Ref_ID] AS [Ref_ID],
    [Extent1].[Name] AS [Name],
    [Extent2].[Name] AS [Name1]
    FROM  [dbo].[Customer] AS [Extent1]
    INNER JOIN [dbo].[Ref] AS [Extent2] ON ([Extent1].[Ref_ID] = [Extent2].[ID]) AND ([Extent1].[Ref_ID2] = [Extent2].[ID2])
To znamená, že generovaný SQL dotaz LINQ pro MS SQL Server je celkem dobrý.
Nyní změníme podmínku AND na OR v LINQ dotazu:
LINQ dotaz
var query = from e1 in db.Customer
                            from e2 in db.Ref
                            where (e1.Ref_ID == e2.ID)
                                || (e1.Ref_ID2 == e2.ID2)
                            select new { Data1 = e1.Name, Data2 = e2.Name };
Znovu spustíme naši aplikaci.
Provádění skončí chybou související s překročením doby běhu příkazu 30 sekundy:
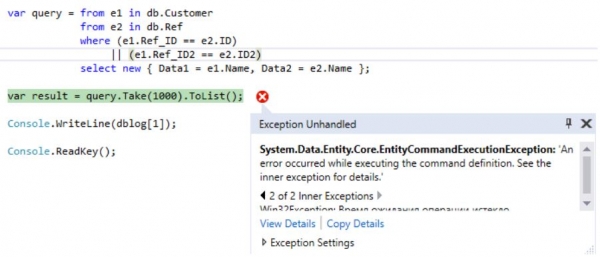
Pokud se podíváme, jaký dotaz byl generován LINQ:
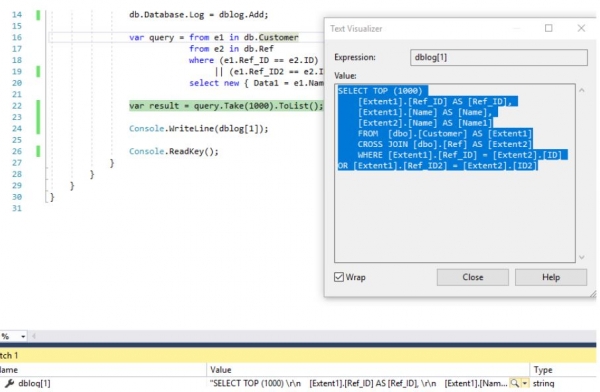
, můžeme potvrdit, že výběr probíhá pomocí kartézského produktu dvou množin (tabulek):
Generovaný SQL dotaz
SELECT TOP (1000)
    [Extent1].[Ref_ID] AS [Ref_ID],
    [Extent1].[Name] AS [Name],
    [Extent2].[Name] AS [Name1]
    FROM  [dbo].[Customer] AS [Extent1]
    CROSS JOIN [dbo].[Ref] AS [Extent2]
    WHERE [Extent1].[Ref_ID] = [Extent2].[ID] OR [Extent1].[Ref_ID2] = [Extent2].[ID2]
Přepišme LINQ dotaz následujícím způsobem:
Optimalizovaný LINQ dotaz
var query = (from e1 in db.Customer
                   join e2 in db.Ref
                   on e1.Ref_ID equals e2.ID
                   select new { Data1 = e1.Name, Data2 = e2.Name }).Union(
                        from e1 in db.Customer
                        join e2 in db.Ref
                        on e1.Ref_ID2 equals e2.ID2
                        select new { Data1 = e1.Name, Data2 = e2.Name });
Pak obdržíme následující SQL dotaz:
SQL dotaz
VYBERTE
    [Limit1].[C1] JAKO [C1],
    [Limit1].[C2] JAKO [C2],
    [Limit1].[C3] JAKO [C3]
    Z ( VYBERTE ODLIŠNÉ TOP (1000)
        [UnionAll1].[C1] JAKO [C1],
        [UnionAll1].[Name] JAKO [C2],
        [UnionAll1].[Name1] JAKO [C3]
        Z  (VYBERTE
            1 JAKO [C1],
            [Extent1].[Name] JAKO [Name],
            [Extent2].[Name] JAKO [Name1]
            Z  [dbo].[Customer] JAKO [Extent1]
            VNITŘNÍ JOIN [dbo].[Ref] JAKO [Extent2] ON [Extent1].[Ref_ID] = [Extent2].[ID]
        UNIE VŠECHNO
            VYBERTE
            1 JAKO [C1],
            [Extent3].[Name] JAKO [Name],
            [Extent4].[Name] JAKO [Name1]
            Z  [dbo].[Customer] JAKO [Extent3]
            VNITŘNÍ JOIN [dbo].[Ref] JAKO [Extent4] ON [Extent3].[Ref_ID2] = [Extent4].[ID2]) JAKO [UnionAll1]
    )  JAKO [Limit1]
Bohužel, v dotazech LINQ může být pouze jedna podmínka spojení, takže je možné udělat ekvivalentní dotaz pomocí dvou dotazů pro každou podmínku s následným sloučením pomocí Union pro odstranění duplicit mezi řádky.
Ano, dotazy budou v obecné rovině neekvivalentní s ohledem na to, že mohou být vráceny úplné duplicity řádků. Nicméně, v reálném životě úplné duplicitní řádky nejsou potřeba a snažíme se jich zbavit.
Porovnejme nyní plány provádění těchto dvou dotazů:
- pro CROSS JOIN v průměru doba provádění 195 s:

- pro INNER JOIN-UNION v průměru doba provádění méně než 24 s:

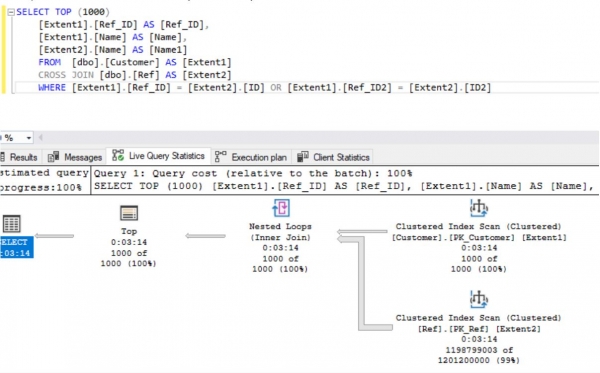
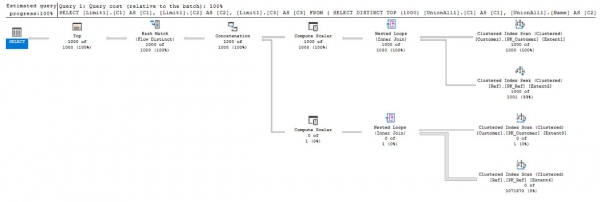
Jak je vidět z výsledků, pro dvě tabulky s miliony záznamů optimalizovaný LINQ dotaz funguje mnohem rychleji než neoptimized.
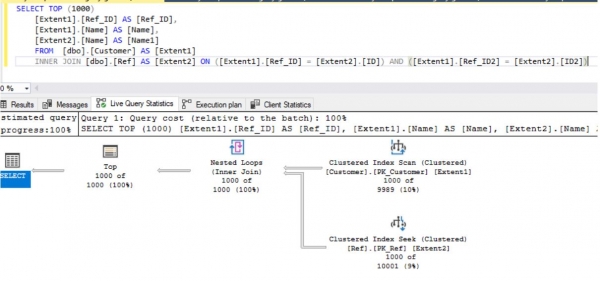
Pro variantu s AND v podmínkách LINQ dotaz vypadá takto:
LINQ dotaz
var query = from e1 in db.Customer
                            from e2 in db.Ref
                            kde (e1.Ref_ID == e2.ID)
                                 && (e1.Ref_ID2 == e2.ID2)
                            vyberte nový { Data1 = e1.Name, Data2 = e2.Name };
skoro vždy bude generován správný SQL dotaz, který se bude provádět v průměru přibližně 1 s:
Také pro manipulace LINQ to Objects místo dotazu v podobě:
LINQ dotaz (1. varianta)
var query = from e1 in seq1
                            from e2 in seq2
                            kde (e1.Key1==e2.Key1)
                               && (e1.Key2==e2.Key2)
                            vyberte nový { Data1 = e1.Data, Data2 = e2.Data };
můžete použít dotaz v podobě:
LINQ dotaz (2. varianta)
var query = from e1 in seq1
                            join e2 in seq2
                            on new { e1.Key1, e1.Key2 } equals new { e2.Key1, e2.Key2 }
                            vyberte nový { Data1 = e1.Data, Data2 = e2.Data };
kde:
Definice dvou polí
Para[] seq1 = new[] { new Para { Key1 = 1, Key2 = 2, Data = "777" }, new Para { Key1 = 2, Key2 = 3, Data = "888" }, new Para { Key1 = 3, Key2 = 4, Data = "999" } };
Para[] seq2 = new[] { new Para { Key1 = 1, Key2 = 2, Data = "777" }, new Para { Key1 = 2, Key2 = 3, Data = "888" }, new Para { Key1 = 3, Key2 = 5, Data = "999" } };
, a typ Para je definován následujícím způsobem:
Definice typu Para
třída Para
{
        veřejný int Key1, Key2;
        veřejný řetězec Data;
}
Tak jsme probrali některé aspekty optimalizace LINQ dotazů pro MS SQL Server.
Bohužel i zkušení a vedoucí .NET vývojáři zapomínají na to, že je nezbytné chápat, co se děje za scénou s těmi instrukcemi, které používají. Jinak se stávají konfigurátory a mohou do budoucna naprogramovat časovanou bombu, ať už při škálování programového řešení, nebo při drobných změnách vnějších podmínek prostředí.
Také byla provedena malá analýza a .
Zdrojové kódy pro test - samotný projekt, vytváření tabulek v databázi TEST a také naplnění těchto tabulek se nachází .
Také v tomto repozitáři ve složce Plány se nacházejí plány provádění dotazů s podmínkami NEBO.
Zdroj: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish