

Při přechodu od monolitické aplikace k mikroslužbové architektuře se setkáváme s novými problémy.
V monolitické aplikaci obvykle stačí jednoduše určit, v které části systému došlo k chybě. Pravděpodobně je problém v kódu samotného monolitu nebo v databázi. Když se však začneme zabývat hledáním problému v mikroslužbové architektuře, už to není tak jasné. Musíme najít celou cestu, kterou požadavek prošel od začátku do konce, a vyčnívat ji z řady stovek mikroslužeb. Přičemž mnohé z nich mají také vlastní úložiště, kde se mohou také vyskytnout jak logické chyby, tak problémy s výkonem a odolností proti výpadkům.
Dlouho jsem hledal nástroj, který by pomohl vyřešit takové problémy (o tom jsem psal na Habru: , ), ale nakonec jsem vytvořil vlastní open-source řešení. V článku hovořím o výhodách přístupu service mesh a sdílím nový nástroj pro jeho realizaci.
Distribuované sledování je rozšířeným řešením problému nalezení chyb v distribuovaných systémech. Ale co když v systému ještě nebyl implementován takový přístup ke shromažďování informací o síťových interakcích, nebo, co je horší, v části systému již funguje, zatímco v jiné části není, protože nebyl přidán do starších služeb? Pro přesné určení kořenové příčiny problému je nezbytné mít úplný obrázek o tom, co se v systému děje. Je obzvlášť důležité rozumět tomu, které konkrétní mikroslužby se podílejí na hlavních kritických obchodních cestách.
Zde nám může pomoci přístup service mesh, který se postará o veškerou mašinerii shromažďování síťových informací na úrovni, na které samotné služby fungují. Tento přístup nám umožňuje zachytit veškerý provoz a analyzovat ho za běhu. A aplikace o něm ani nemusí nic vědět.
Přístup service mesh
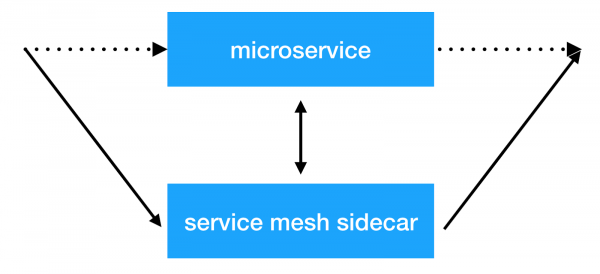
Hlavní myšlenkou přístupu service mesh je přidání další vrstvy infrastruktury nad síť, která nám umožní provádět libovolné úkony s interakcí mezi službami. Většina implementací funguje takto: k každé mikroservise je přidán další kontejner sidecar s transparentním proxy, přes který prochází veškerý příchozí a odchozí provoz služby. A právě zde můžeme provádět klientské vyvažování, aplikovat bezpečnostní politiky, zavádět omezení počtu požadavků a shromažďovat důležité informace o interakci služeb v produkci.
Řešení.
Již existuje několik implementací tohoto přístupu: a . Nabízejí řadu funkcí ihned po vybalení. Současně však přichází i velká zátěž na zdroje. A čím větší je klastr, ve kterém tato systém funguje, tím více zdrojů bude potřeba na udržování nové infrastruktury. V Avitu provozujeme Kubernetes klastry, ve kterých se nachází tisíce instancí služeb (a jejich počet rychle roste). V současné implementaci Istio spotřebovává ~300MB operační paměti na každou instanci služby. Vzhledem k velkému počtu funkcí má transparentní vyvažování také vliv na celkový čas odezvy služeb (až 10ms).
Nakonec jsme se podívali na to, jaké konkrétní možnosti nyní potřebujeme, a rozhodli jsme se, že hlavním důvodem, proč jsme začali implementovat taková řešení, byla možnost shromažďovat trace informace z celého systému průhledně. Také jsme chtěli mít kontrolu nad interakcí služeb a provádět různé manipulace s hlavičkami, které jsou mezi službami předávány.
Nakonec jsme došli k našemu řešení: .
Netramesh
— je to lehké řešení service mesh s nekonečnou škálovatelností bez ohledu na počet služeb v systému.
Hlavními cíli nového řešení byly malá zátěž na zdroje a vysoký výkon. Z hlavních funkcí jsme chtěli mít možnost průhledně odesílat tracing span'y do našeho systému Jaeger.
Dnes většina cloudových řešení běží na Golangu. A samozřejmě, jsou k tomu své důvody. Psát síťové aplikace na Golangu, které pracují asynchronně se vstupem a výstupem a mohou se snadno škálovat na potřebné jádra, je pohodlné a relativně jednoduché. A co je také velmi důležité, výkon je dostatečný pro splnění tohoto úkolu. Proto jsme také zvolili Golang.
Výkon
Zaměřili jsme naše úsilí na dosažení maximálního výkonu. Pro řešení, které se nasazuje vedle každého instance služby, je zapotřebí malé spotřeby operační paměti a procesorového času. A samozřejmě, latence odpovědi by měla být také co nejmenší.
Podívejme se, jaké výsledky jsme dosáhli.
RAM
Netramesh spotřebovává ~10 Mb bez provozu a 50 Mb maximálně při zátěži až 10000 RPS na jednu instanci.
Istio envoy proxy vždy spotřebovává ~300 Mb v našich clusterech se tisíci instancemi. To neumožňuje škálovat jej na celý cluster.
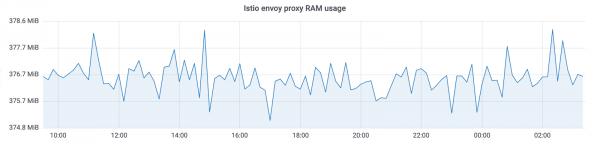
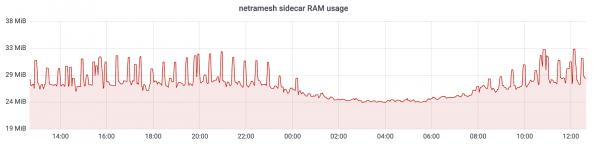
S Netramesh jsme dosáhli snížení spotřeby paměti přibližně 10x.
CPU
Použití CPU je relativně stejné pod zátěží. Závisí na počtu požadavků za jednotku času na sidecar. Hodnoty při 3000 požadavcích za sekundu v maximu:
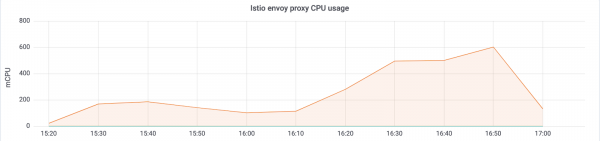
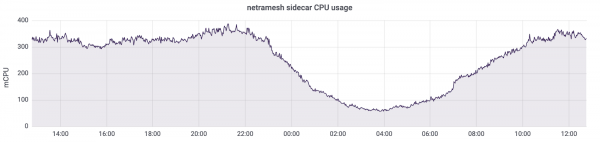
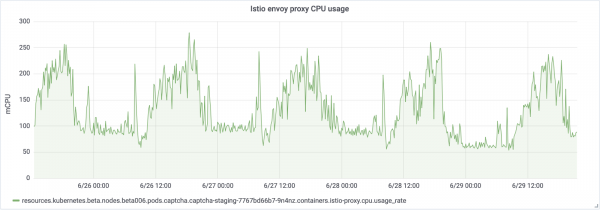
Je tu ještě jeden důležitý bod: Netramesh je řešení bez control plane a bez zátěže nespotřebovává procesorový čas. S Istio sidecar vždy aktualizuje endpointy služeb. Nakonec vidíme takový obraz bez zátěže:
Používáme HTTP/1 pro interakci mezi službami. Zpoždění odpovědi u Istio při proxy přes envoy bylo až 5-10 ms, což je poměrně hodně pro služby, které jsou schopny reagovat na milisekundu. S Netramesh se tento čas snížil na 0,5-2 ms.
Škálovatelnost
Malé množství zdrojů, které každý proxy spotřebovává, umožňuje umístit jej vedle každé služby. Netramesh byl záměrně vytvořen bez komponenty control plane, aby se usnadnilo udržení lehkosti každého sidecaru. Často v řešeních service mesh control plane šíří informace o service discovery do každého sidecaru. Spolu s tím přicházejí i informace o timeoutech a nastaveních vyvažování. To všechno umožňuje dělat spoustu užitečných věcí, ale bohužel také zvětšuje velikost sidecarů.
Objevování služeb

Netramesh nepřidává žádné další mechanismy pro service discovery. Veškerý provoz je transparentně proxy přes netra sidecar.
Netramesh podporuje aplikační protokol HTTP/1. Pro jeho definici se používá konfigurovatelný seznam portů. Obvykle má systém několik portů, přes které dochází k interakci pomocí HTTP. Například pro interakci služeb a externích požadavků používáme porty 80, 8890 a 8080. Tyto porty lze nastavit pomocí proměnné prostředí. NETRA_HTTP_PORTS.
Pokud používáte Kubernetes jako orchestrátor a jeho mechanismus služeb pro vnitroklaustrovou interakci mezi službami, mechanismus zůstává úplně stejný. Nejprve mikroslužba získá IP adresu služby pomocí kube-dns a otevře nové spojení k ní. Toto spojení se nejprve vytváří s lokálním netra-sidecarem a všechny TCP pakety původně dorazí právě do netra. Poté netra-sidecar navazuje spojení s původním cílem. NAT na pod IP na uzlu zůstává stejný jako bez netra.
Distribuované sledování a přenášení kontextu
Netramesh poskytuje funkčnost potřebnou k odesílání sledovacích spanů o HTTP interakci. Netra-sidecar zpracovává HTTP protokol, měří zpoždění dotazů, vybírá potřebné informace z HTTP hlaviček. V konečném důsledku získáváme všechny trace v jednotném systému Jaeger. Pro jemné nastavení lze také použít proměnné prostředí, které poskytuje oficiální knihovna. .
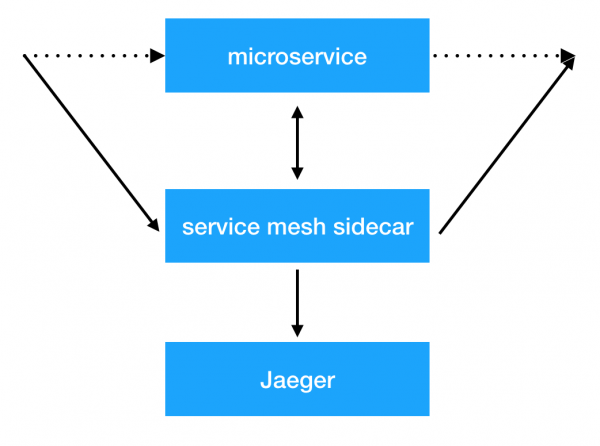
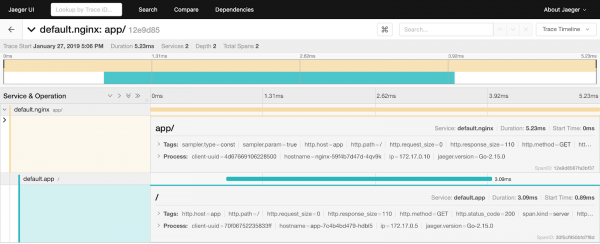
Ale je tu problém. Dokud služby nebudou generovat a přenášet speciální uber hlavičku, neuvidíme propojené sledovací spany v systému. A to je to, co potřebujeme pro rychlé vyhledávání příčin problémů. Zde má Netramesh opět řešení. Proxy čtou HTTP hlavičky a pokud v nich není uber trace id, generují ho. Netramesh také uchovává informace o příchozích a odchozích požadavcích v sidecaru a porovnává je obohacením potřebnými hlavičkami odchozích požadavků. Vše, co je třeba v službách udělat, je přenášet pouze jednu hlavičku. X-Request-Id, kterou lze nakonfigurovat pomocí proměnné prostředí. NETRA_HTTP_REQUEST_ID_HEADER_NAME. Pro řízení velikosti kontextu v Netramesh lze zadat následující proměnné prostředí: NETRA_TRACING_CONTEXT_EXPIRATION_MILLISECONDS (doba, po kterou bude kontext uchováván) a NETRA_TRACING_CONTEXT_CLEANUP_INTERVAL (frekvence úklidu kontextu).
Je také možné kombinovat více cest ve vaší systému označením speciálním sezením markerem. Netra umožňuje nastavit HTTP_HEADER_TAG_MAP pro přeměnu HTTP hlaviček na odpovídající tracing span tagy. To může být obzvláště užitečné pro testování. Po průchodu funkčním testem lze vidět, která část systému byla ovlivněna, filtrováním podle odpovídajícího session klíče.
Určení zdroje požadavku
Pro určení odkud požadavek přišel, lze využít funkčnost automatického přidání hlavičky se zdrojem. Pomocí proměnné prostředí NETRA_HTTP_X_SOURCE_HEADER_NAME lze nastavit název hlavičky, která bude automaticky nastavena. Pomocí NETRA_HTTP_X_SOURCE_VALUE lze nastavit hodnotu, do které bude hlavička X-Source nastavena pro všechny odchozí požadavky.
To umožňuje jednotně po celé síti šířit tuto užitečnou hlavičku. Dále ji lze již využít v službách a přidat do logů, metrik.
Routování provozu a vnitřnosti Netramesh
Netramesh se skládá ze dvou hlavních komponentů. První, netra-init, nastavuje síťová pravidla pro zachycování provozu. Používá k zachycování veškerého nebo části provozu na sidecar, který je druhou hlavní komponentou Netramesh. Můžete nastavit, které porty je třeba zachytit pro příchozí a odchozí TCP sezení: INBOUND_INTERCEPT_PORTS, OUTBOUND_INTERCEPT_PORTS.
Nástroj také nabízí zajímavou možnost — pravděpodobnostní routování. Pokud používáte Netramesh výhradně pro sběr tracing spanů, můžete v produkčním prostředí ušetřit zdroje a zapnout pravděpodobnostní routování pomocí proměnných NETRA_INBOUND_PROBABILITY a NETRA_OUTBOUND_PROBABILITY (od 0 do 1). Výchozí hodnota je 1 (zachycován veškerý provoz).
Po úspěšném zachycení netra sidecar přijímá nové spojení a používá SO_ORIGINAL_DST možnost soketu pro získání původního cílového místa. Poté Netra otevírá nové spojení k původnímu IP adrese a vytváří oboustrannou TCP komunikaci mezi stranami, sledujíce veškerý procházející provoz. Pokud je port definován jako HTTP, Netra se pokouší jej parsovat a trace-it. Pokud je parsování HTTP neúspěšné, Netra se vrátí na TCP a transparentně prozrazuje bajty.
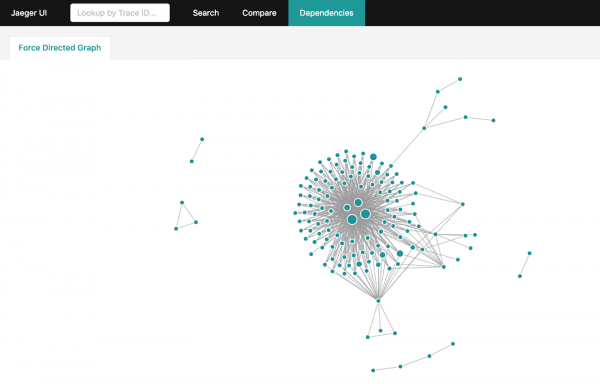
Vytváření grafu závislostí
Po získání velkého množství tracing informací v Jaegeru byste chtěli získat kompletní graf interakcí v systému. Pokud je však váš systém dostatečně zatížen a za den se nahromadí miliardy tracing spanů, agregace těchto dat se stává spíše složitým úkolem. Existuje oficiální způsob, jak to provést: . Nicméně to zabere hodiny na vytvoření kompletního grafu a způsobí, že bude nutné stáhnout celý dataset z Jaegeru za uplynulých 24 hodin.
Pokud používáte Elasticsearch pro uchovávání tracing spanů, můžete využít , která postaví stejný graf během minut, využívající funkcionality a možnosti Elasticsearch.
Jak používat Netramesh
Netra může být jednoduše přidána k jakékoliv službě běžící na jakémkoliv orchestrátoru. Můžete se podívat na příklad .
V současné době Netra nemá možnost automatického nasazení sidecaru k službám, ale plánuje se to implementovat.
Budoucnost Netramesh
Hlavním cílem je dosáhnout minimálních nákladů na zdroje a vysokého výkonu, přičemž poskytuje základní funkce pro sledování a kontrolu meziservisní interakce.
V budoucnu Netramesh získá podporu dalších aplikačních protokolů kromě HTTP. Brzy bude dostupná možnost L7 routingu.
Použijte Netramesh, pokud se setkáváte s podobnými problémy, a neváhejte nám psát dotazy a návrhy.
Zdroj: habr.com
