

Až donedávna bylo v Odnoklassnikách kolem 50 TB dat, která se zpracovávala v reálném čase, uloženo v SQL Serveru. Zajistit rychlý, spolehlivý a zároveň odolný přístup k datovému centru pro takové objemy pomocí SQL DB je prakticky nemožné. Obvykle se v takových případech používá jedno z NoSQL uložišť, ale ne všechno lze převést do NoSQL: některé entity vyžadují záruky ACID transakcí.
To nás přivedlo k použití NewSQL uložiště, tedy DBMS, která poskytuje odolnost, škálovatelnost a rychlost NoSQL systémů a přitom zachovává známé ACID záruky klasických systémů. Funkčních průmyslových systémů této nové třídy je málo, proto jsme takový systém sami realizovali a uvedli ho do průmyslového provozu.
Jak to funguje a co se podařilo — čtěte pod odkazem.
Dnes měsíční publikum „Odnoklassnikov“ činí více než 70 milionů unikátních návštěvníků. My největších sociálních sítí světa a v první dvacítce webů, na kterých uživatelé tráví nejvíce času. Infrastruktura „OK“ zpracovává velmi vysoké zátěže: více než milion HTTP požadavků za sekundu na fronty. Části serverového parku o více než 8000 kusech jsou umístěny blízko sebe — ve čtyřech moskevských datových centrech, což umožňuje zajistit síťovou latenci nižší než 1 ms mezi nimi.
Používáme Cassandru od roku 2010, počínaje verzí 0.6. Dnes máme v provozu několik desítek clusterů. Nejrychlejší cluster zpracovává více než 4 miliony operací za sekundu, zatímco největší uchovává 260 TB.
Nicméně to vše jsou běžné NoSQL clustery, které se používají k ukládání dat. My jsme chtěli nahradit hlavní konzistentní úložiště, Microsoft SQL Server, které bylo používáno od založení „Odnoklassnikov“. Úložiště se skládalo z více než 300 strojů v edici SQL Server Standard, které uchovávaly 50 TB dat — obchodních entit. Tato data se modifikují v rámci ACID transakcí a vyžadují .
Pro rozdělení dat mezi uzly SQL Serveru jsme použili jak vertikální, tak horizontální (sharding). Historicky jsme používali jednoduché schéma shardování dat: každé entitě byl přiřazen token — funkce z ID entity. Entity se stejným tokenem byly umístěny na jeden SQL server. Vztah typu master-detail byl realizován tak, aby tokeny hlavního a odvozeného záznamu vždy souhlasily a nacházely se na jednom serveru. V sociální síti většinu záznamů vytváří uživatel — to znamená, že všechna data uživatele v rámci jedné funkční podsystému jsou uložena na jednom serveru. To znamená, že v obchodní transakci se téměř vždy účastnily tabulky jednoho SQL serveru, což umožnilo zajistit konzistenci dat pomocí místních ACID transakcí, bez potřeby použití rozložených ACID transakcí.
Díky shardování a pro urychlení práce SQL:
- Nepoužíváme Foreign key constraints, protože při shardování může být ID entity umístěno na jiném serveru.
- Nepoužíváme uložené procedury a spouštěče kvůli dodatečné zátěži na CPU databázového systému.
- Nepoužíváme JOINy z důvodu všech výše uvedených věcí a množství náhodných čtení z disku.
- Mimo transakce pro snížení vzájemného blokování používáme úroveň izolace Read Uncommitted.
- Provádíme pouze krátké transakce (průměrně kratší než 100 ms).
- Nepoužíváme víceřádkové UPDATE a DELETE kvůli velkému množství vzájemného blokování — aktualizujeme pouze jeden záznam.
- Dotazy vždy vykonáváme pouze podle indexů — dotaz s plánem pro úplný pohled na tabulku pro nás znamená přetížení databáze a její selhání.
Tyto kroky umožnily vytěžit z SQL serverů téměř maximální výkon. Avšak problémů přibývalo. Pojďme se na ně podívat.
Problémy se SQL
- Jelikož jsme používali vlastní shardování, přidávání nových shardů prováděli administrátoři ručně. Po celou tu dobu škálovatelné repliky dat nezpracovávaly dotazy.
- S rostoucím počtem záznamů v tabulce se snižuje rychlost vkládání a modifikace, při přidání indexů k existující tabulce rychlost klesá násobně, vytváření a obnovování indexů probíhá s výpadkem.
- Přítomnost malého počtu Windows pro SQL Server v produkci ztěžuje správu infrastruktury.
Ale hlavní problém —
Odolnost proti výpadkům
Klasický SQL server má špatnou odolnost vůči výpadkům. Představte si, že máte pouze jeden server databáze a ten selhává jednou za tři roky. V tuto dobu web nefunguje 20 minut, což je přijatelné. Pokud máte 64 serverů, pak web nefunguje jednou za tři týdny. A pokud máte 200 serverů, web nefunguje každý týden. To je problém.
Co lze udělat pro zvýšení odolnosti SQL serveru? Wikipedie nám doporučuje vybudovat : kde v případě selhání jakéhokoliv z komponent je zde duplikát.
To vyžaduje drahý park zařízení: četné duplikace, optická vlákna, sdílená úložiště a zapnutí rezervy funguje nespolehlivě: asi 10% zapnutí končí selháním rezervní uzlu za hlavním uzlem.
Ale hlavní nevýhodou takového vysoce dostupného clusteru je nulová dostupnost při selhání datového centra, ve kterém je umístěn. U "Odclassniky" máme čtyři datová centra a musíme zajistit provoz při úplném výpadku v jednom z nich.
K tomu bychom mohli použít replikaci, integrovanou do SQL Serveru. Toto řešení je mnohem dražší kvůli nákladům na software a trpí dobře známými problémy s replikací - nepředvídatelnými zpožděními transakcí při synchronní replikaci a zpožděními v aplikaci replikací (a důsledkem toho ztracenými modifikacemi) při asynchronní. Předpokládané činí tuto variantu pro nás zcela nepoužitelnou.
Všechny tyto problémy vyžadovaly radikální řešení a začali jsme jejich podrobnou analýzu. Zde se musíme seznámit s tím, co SQL Server obvykle dělá - s transakcemi.
Jednoduchá transakce
Zvažme nejjednodušší transakci z pohledu praktického SQL programátora: přidání fotografie do alba. Alba a fotografie jsou uloženy v různých tabulkách. Album má počítadlo veřejných fotografií. Pak je taková transakce rozdělena na následující kroky:
- Zamkneme album podle klíče.
- Vytvoříme záznam v tabulce fotografií.
- Pokud má fotografie veřejný status, pak zvýšíme v albu počítadlo veřejných fotografií, aktualizujeme záznam a potvrzujeme transakci.
Nebo ve formě pseudokódu:
TX.start("Albums", id);
Album album = albums.lock(id);
Photo photo = photos.create(…);

if (photo.status == PUBLIC ) {
    album.incPublicPhotosCount();
}
album.update();

TX.commit();
Vidíme, že nejběžnější scénář obchodní transakce spočívá v přečtení dat z databáze do paměti aplikačního serveru, provedení nějakých změn a uložením nových hodnot zpět do databáze. Obvykle v takové transakci aktualizujeme několik entit, několik tabulek.
Při provádění transakce může dojít k konkurentnímu modifikování stejných dat z jiného systému. Například, Antispam může rozhodnout, že uživatel je podezřelý, a proto by všechny fotografie uživatele neměly být veřejné, měly by být zaslány na moderaci, což znamená změnit photo.status na nějakou jinou hodnotu a upravit příslušné počítadla. Je zřejmé, že pokud tato operace proběhne bez záruk atomárnosti a izolace konkurenčních modifikací, jak je tomu v , výsledek nebude takový, jaký je potřeba — buď počítadlo fotografií bude ukazovat nesprávnou hodnotu, nebo se všechny fotografie neodešlou na moderaci.
Podobného kódu, který manipuluje různými obchodními entitami v rámci jedné transakce, bylo napsáno velmi mnoho za celé období existence Odnoklassnikov. Zkušenosti z migrací na NoSQL s víme, že největší obtíže (a časové nároky) vyvolává potřeba vyvíjet kód zaměřený na udržování konzistence dat. Proto hlavním požadavkem na nové úložiště bylo zajištění skutečných ACID transakcí pro aplikační logiku.
Další, neméně důležité požadavky byly:
- Při selhání datového centra musí být dostupné jak čtení, tak zápis do nového úložiště.
- Zachování současné rychlosti vývoje. To znamená, že při práci s novým úložištěm by měl být objem kódu přibližně stejný, neměla by vzniknout potřeba dopisovat něco do úložiště, vyvíjet algoritmy pro řešení konfliktů, udržování sekundárních indexů atd.
- Rychlost nového úložiště by měla být dostatečně vysoká jak při čtení dat, tak při zpracování transakcí, což efektivně znamenalo nevhodnost akademicky přísných, univerzálních, ale pomalých řešení, jako například .
- Automatické škálování za chodu.
- Používání běžných levných serverů, bez nutnosti zakupovat exotický hardware.
- Možnost rozvoje úložiště silami vývojářů společnosti. Jinými slovy, priorita byla dána interním nebo open-source řešením, ideálně na Javě.
Řešení, řešení
Analyzováním možných řešení jsme došli k dvěma možným architektonickým volbám:
První — vzít jakýkoliv SQL server a implementovat potřebnou odolnost proti chybám, mechanismus škálování, odolný cluster, řešení konfliktů a distribuované, spolehlivé a rychlé ACID transakce. Tento variant jsme vyhodnotili jako velmi netradiční a časově náročný.
Druhá možnost — vzít hotové NoSQL úložiště s implementovaným škálováním, odolným clusterem, řešením konfliktů a realizovat transakce a SQL sami. Na první pohled se i úkol realizace SQL, nemluvě o ACID transakcích, jeví jako práce na léta. Ale poté jsme si uvědomili, že sada SQL funkcí, které používáme v praxi, je daleko od ANSI SQL tak daleko jako daleko od ANSI SQL. Při bližším pohledu na CQL jsme zjistili, že je dostatečně blízké tomu, co potřebujeme.
Cassandra a CQL
Takže, čím je Cassandra zajímavá, jaké má možnosti?
Za prvé, zde lze vytvářet tabulky s podporou různých typů dat, lze provádět SELECT nebo UPDATE podle primárního klíče.
CREATE TABLE photos (id bigint KEY, owner bigint,…);
SELECT * FROM photos WHERE id=?;
UPDATE photos SET … WHERE id=?;
Pro zajištění konzistence dat replik Cassandra používá . V nejjednodušším případě to znamená, že při umístění tří replik stejného řádku na různých uzlech clusteru je záznam považován za úspěšný, pokud většina uzlů (tj. dvě ze tří) potvrdila úspěšnost této operace zápisu. Data řádku jsou považována za konzistentní, pokud při čtení byly dotazovány většinou uzlů a potvrdily je. Tímto způsobem je zaručena úplná a okamžitá konzistence dat při selhání jednoho uzlu, pokud existují tři repliky. Tento přístup nám umožnil realizovat ještě spolehlivější schéma: vždy odesílat požadavky na všechny tři repliky a čekat na odpověď od dvou nejrychlejších. Pozdní odpověď třetí repliky je v takovém případě odmítnuta. Na uzlu, který odpovídá pozdě, mohou tímto způsobem vzniknout vážné problémy – zpomalení, shromažďování odpadků v JVM, přímé uvolnění paměti v linuxovém jádře, selhání hardwaru nebo odpojení od sítě. Nicméně to nijak neovlivňuje operace klienta a data.
Přístup, kdy se obracíme na tři uzly a dostáváme odpověď od dvou, se nazývá : požadavek na nadbytečné repliky je odeslán ještě předtím, než „odpadne“.
Další z výhod Cassandry je Batchlog – mechanismus, který zaručuje buď úplné použití, nebo úplné nepoužití souboru vašich změn. To nám umožňuje vyřešit A v ACID – atomaritu hned „z krabice“.
Nejblíže transakcím v Cassandře jsou takzvané „“. Ale od „opravdových“ ACID transakcí jsou daleko: ve skutečnosti je to možnost provést na datech pouze jedné položky, přičemž se používá konsensus podle těžkého protokolu Paxos. Proto rychlost těchto transakcí není vysoká.
Co nám v Cassandře chybělo
Takže jsme se museli postarat o implementaci skutečných ACID transakcí v Cassandře. S jejichž pomocí bychom mohli snadno implementovat dvě další pohodlné funkce klasických DBMS: konzistentní rychlé indexy, což by nám umožnilo provádět výběry dat nejen podle primárního klíče a běžný generátor monotónních auto-incrementních ID.
C*One
Tak se zrodila nová DBMS C*One, skládající se ze tří typů serverových uzlů:
- Úložiště – (téměř) standardní servery Cassandry odpovědné za ukládání dat na místní disky. S rostoucím zatížením a objemem dat je jejich počet snadno škálovatelný na desítky a stovky.
- Koordinátoři transakcí zajišťují provádění transakcí.
- Klienti jsou aplikační servery, které realizují obchodní operace a iniciují transakce. Takových klientů může být tisíce.
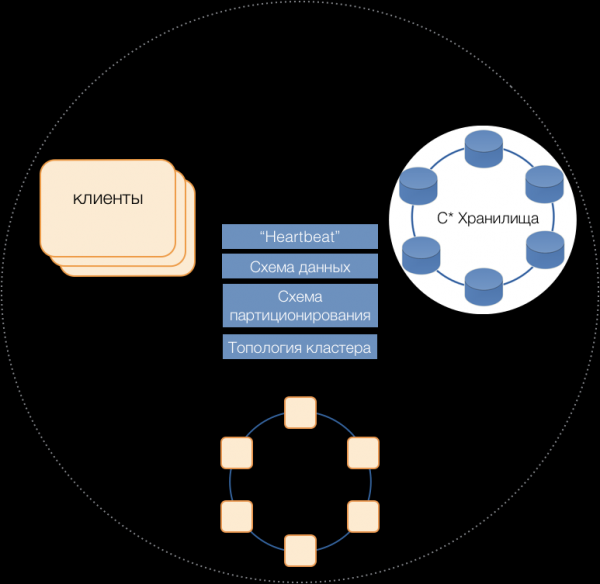
Servery všech typů jsou součástí společného klastru, používají interní protokol zpráv Cassandra k vzájemné komunikaci a k výměně informací o klastru. Pomocí Heartbeat se servery dozvídají o vzájemných selháních, udržují jednotnou schéma dat – tabulky, jejich strukturu a replikaci; schéma partitioningu, topologii klastru, atd.
Klienti
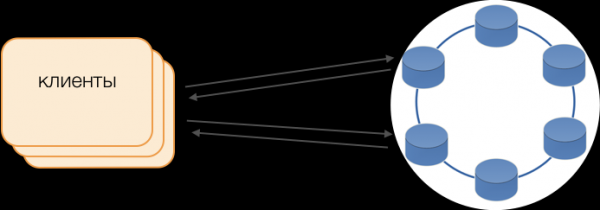
Místo standardních ovladačů se používá režim Fat Client. Takový uzel neuchovává data, ale může fungovat jako koordinátor provádění dotazů, což znamená, že klient sám zastává funkci koordinátora svých dotazů: vyžaduje repliky úložiště a řeší konflikty. To je nejen spolehlivější a rychlejší než standardní ovladač, který vyžaduje komunikaci s vzdáleným koordinátorem, ale také umožňuje spravovat přenos dotazů. Mimo otevřenou transakci na klientovi jsou dotazy směrovány do úložišť. Pokud však klient otevřel transakci, jsou všechny dotazy v rámci transakce směrovány ke koordinátorovi transakcí.
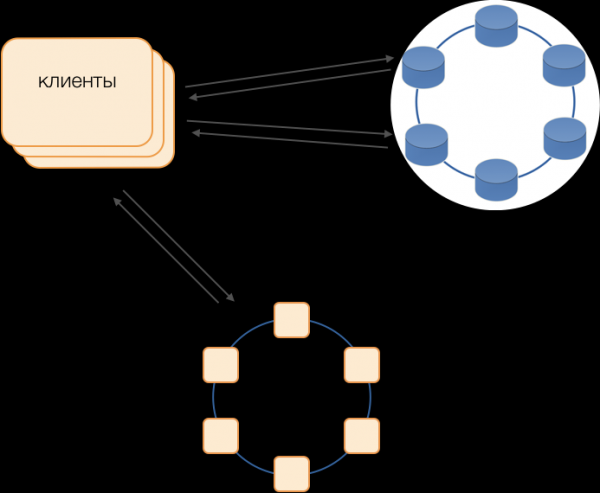
Koordinátor transakcí C*One
Koordinátor je to, co jsme implementovali pro C*One od nuly. Odpovídá za správu transakcí, zámků a pořadí aplikace transakcí.
Pro každou obsluhovanou transakci koordinátor generuje časovou značku: každá následující je větší než u předchozí transakce. Vzhledem k tomu, že v Cassandře je systém řešení konfliktů založen na časových značkách (z dvou konfliktujících záznamů je aktuální považována ta s pozdější časovou značkou), bude konflikt vždy vyřešen ve prospěch následující transakce. Tak jsme realizovali – levný způsob, jak řešit konflikty v distribuovaném systému.
Zámky
Pro zajištění izolace jsme se rozhodli použít ten nejjednodušší způsob – pesimistické zámky podle primárního klíče záznamu. Jinými slovy, v transakci je třeba nejprve záznam zamknout, poté přečíst, modifikovat a uložit. Pouze po úspěšném potvrzení může být záznam odemčen, aby konkurenční transakce mohly k němu přistupovat.
Implementace takové blokace je jednoduchá v nerovnoměrně rozloženém prostředí. V distribuovaném systému existují dvě hlavní cesty: buď implementovat distribuovanou blokaci na clusteru, nebo rozložit transakce tak, aby transakce týkající se jedné položky vždy odbavoval stejný koordinátor.
Jelikož máme již data rozložená do skupin lokálních transakcí v SQL, bylo rozhodnuto přidělit koordinátorům skupiny lokálních transakcí: jeden koordinátor provádí všechny transakce s tokenem od 0 do 9, druhý - s tokenem od 10 do 19, a tak dále. Výsledkem je, že každý z instancí koordinátora se stává mistrem skupiny transakcí.
Poté mohou být blokace implementovány jako obyčejná HashMap v paměti koordinátora.
Selhání koordinátorů
Jelikož jeden koordinátor výhradně odbavuje skupinu transakcí, je velmi důležité rychle určit, zda došlo k jeho selhání, aby opětovný pokus o provedení transakce spadal do časového limitu. Aby to bylo rychlé a spolehlivé, použili jsme plně propojený kvórumový heartbeat protokol:
V každém datovém centru je umístěno minimálně dvě uzly koordinátora. Pravidelně každý koordinátor rozesílá heartbeat zprávu ostatním koordinátorům a informuje je o své funkčnosti, jakož i o tom, jaké heartbeat zprávy od kterých koordinátorů v clusteru naposledy přijímal.
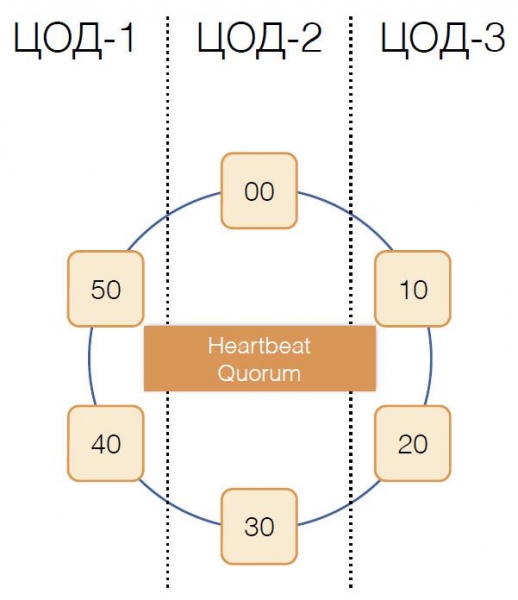
Přijímajíc podobné informace od ostatních v rámci jejich heartbeat zpráv, každý koordinátor rozhoduje, které uzly clusteru fungují a které ne, podle principu kvóra: pokud uzel X obdržel od většiny uzlů v clusteru informaci o normálním obdržení zpráv z uzlu Y, pak Y funguje. A naopak, jakmile většina uzlů oznámí, že nepřijíma zprávy z uzlu Y, znamená to, že Y selhal. Zajímavé je, že pokud kvórum oznámí uzlu X, že od něj již více zpráv neobdrželo, uzel X se bude považovat za selhaný.
Heartbeat zprávy se zasílají velkou frekvencí, přibližně 20krát za sekundu, s intervalem 50 ms. V Javě je obtížné zaručit reakci aplikace během 50 ms kvůli podobné délce pauz způsobených garbage collectorem. Podařilo se nám dosáhnout této doby odezvy pomocí garbage collectoru G1, který umožňuje stanovit cíl pro délku pauz GC. Nicméně, občas, poměrně vzácně, pauzy garbage collectoru přesáhnou 50 ms, což může vést k falešnému zjištění selhání. Aby k tomu nedošlo, koordinátor neohlásí selhání vzdáleného uzlu po prvním ztraceném heartbeat zprávě, pouze pokud jich chybí několik po sobě.
Ale nestačí rychle pochopit, který uzel přestal fungovat. Je potřeba s tím něco dělat.
Zálohování
Klasický scénář předpokládá, že v případě selhání mastera se spustí volby nového pomocí jednoho z algoritmů. Nicméně, tyto algoritmy mají dobře známé problémy se shodou v čase a délkou samotného procesu voleb. Takovýchto dodatečných zpoždění jsme se dokázali vyhnout pomocí schématu nahrazování koordinátorů v plně propojené síti:
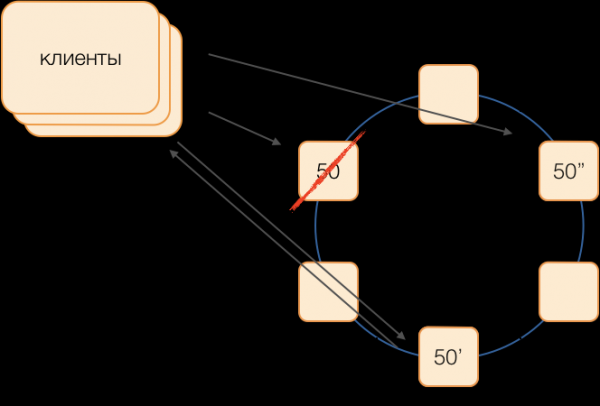
Představme si, že chceme provést transakci ve skupině 50. Předem určíme schéma nahrazování, tedy které uzly budou vykonávat transakce skupiny 50 v případě selhání hlavního koordinátora. Naším cílem je udržet systém funkční při selhání datového centra. Určíme, že prvním záložním uzlem bude uzel z jiného datového centra a druhým záložním uzlem bude uzel z třetího. Toto schéma se vybírá jednou a nemění se, dokud nedojde ke změně topologie clusteru, tedy dokud do něj nevstoupí nové uzly (což se stává velmi zřídka). Pořadí výběru nového aktivního mastera při selhání starého bude vždy takové: prvním záložním uzlem se stane první záložní, a pokud i ten přestane fungovat – druhý záložní.
Toto schéma je spolehlivější než univerzální algoritmus, protože pro aktivaci nového mastera stačí stanovit fakt selhání starého.
Ale jak klienti poznají, který z mistrů právě pracuje? Není možné rozeslat informace na tisíce klientů za 50 ms. Může nastat situace, kdy klient odešle žádost o otevření transakce, aniž by věděl, že tento mistr již nefunguje, a žádost uvázne na časovém limitu. Aby se tomu zabránilo, klienti spekulativně posílají žádost o otevření transakce rovnou mistru skupiny a oběma jeho zálohám, ale odpoví pouze ten, kdo je aktuálně aktivní mistr. Veškerou následující komunikaci v rámci transakce klient provádí pouze s aktivním mistrem.
Záložní mistři umístí přijaté žádosti na cizí transakce do fronty nenarozených transakcí, kde zůstávají nějakou dobu. Pokud aktivní mistr zemře, nový mistr zpracovává žádosti o otevření transakcí ze své fronty a odpovídá klientovi. Pokud klient již stihl otevřít transakci se starým mistrem, druhá odpověď bude ignorována (a zjevně taková transakce se nedokončí a bude opakována klientem).
Jak funguje transakce
Představme si, že klient zaslal koordinátorovi žádost o otevření transakce pro určitou entitu s daným primárním klíčem. Koordinátor tuto entitu zablokuje a umístí ji do tabulky zámků v paměti. Pokud je to nutné, koordinátor načte tuto entitu ze skladu a uloží získaná data do stavu transakce v paměti koordinátora.
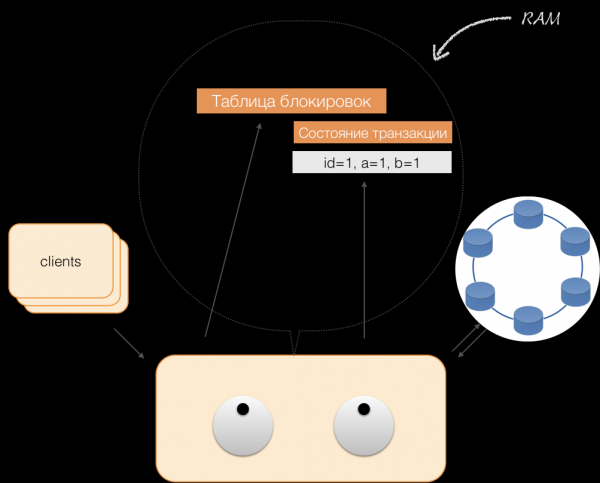
Když klient chce změnit data v transakci, zašle koordinátorovi žádost o modifikaci entity, a ten umístí nová data do tabulky stavu transakcí v paměti. Na tomto zapisování je konec - zápis do skladu se neprovádí.
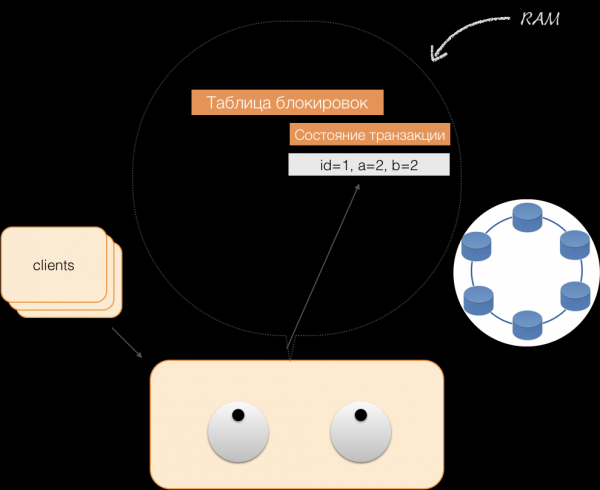
Když klient v rámci aktivní transakce požaduje vlastní změněná data, koordinátor postupuje takto:
- pokud je ID již v transakci, data se berou z paměti;
- pokud ID v paměti není, chybějící data se načtou z uzlů skladu, spojí se již existujícími v paměti a výsledek se předá klientovi.
Tímto způsobem může klient přečíst své vlastní změny, zatímco ostatní klienti tyto změny nevidí, protože jsou uchovávány pouze v paměti koordinátora a v uzlech Cassandra ještě neexistují.
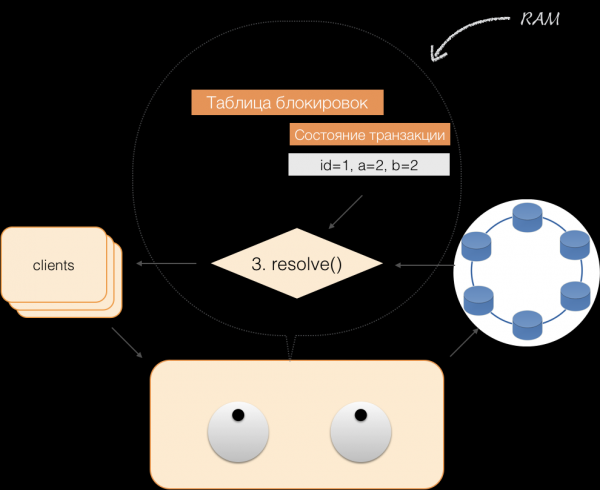
Když klient pošle commit, stav, který měl služba v paměti, je koordinátorem uložen do logged batch a jako logged batch je odeslán do úložišť Cassandra. Úložiště vykonají vše potřebné, aby byl tento balíček atomárně (úplně) aplikován, a vrátí odpověď koordinátorovi, který uvolní zámky a potvrdí úspěšnost transakce klientovi.
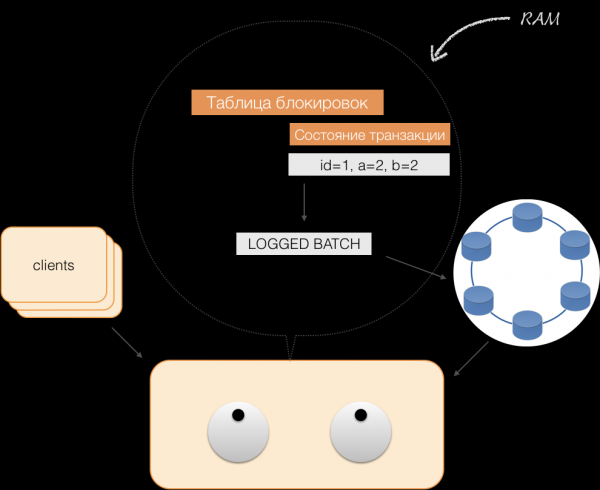
A pro rollback stačí koordinátorovi pouze uvolnit paměť obsazenou stavem transakce.
V důsledku výše uvedených vylepšení jsme implementovali principy ACID:
- Atomarita. To je záruka, že žádná transakce nebude v systému zafixována částečně, budou buď provedeny všechny její podoperace, nebo žádná. Tento princip je u nás dodržován díky logged batch v Cassandře.
- Konzistence. Každá úspěšná transakce podle definice zafixuje pouze platné výsledky. Pokud je po otevření transakce a provedení části operací zjištěno, že výsledek je neplatný, provádí se rollback.
- Izolovanost. Při provádění transakce by paralelní transakce neměly mít vliv na její výsledek. Soutěžící transakce jsou izolovány pomocí pesimistických zámků na koordinátorovi. Pro čtení mimo transakci se dodržuje princip izolovanosti na úrovni Read Committed.
- Odolnost. Nezávisle na problémech na spodních úrovních — výpadku systému, selhání hardwaru — změny, které provedla úspěšně dokončená transakce, by měly zůstat uchovány po obnovení fungování.
Čtení podle indexů
Vezměme si jednoduchou tabulku:
CREATE TABLE photos (
id bigint primary key,
owner bigint,
modified timestamp,
…)
Ta má ID (primární klíč), vlastníka a datum změny. Je potřeba udělat velmi jednoduchý dotaz — vybrat data podle vlastníka s datem změny „za posledních 24 hodin“.
SELECT *
WHERE owner=?
AND modified>?
Aby takový dotaz běžel rychle, je v klasické SQL DBMS potřeba vytvořit index na sloupcích (owner, modified). To můžeme udělat poměrně snadno, protože nyní máme záruky ACID!
Indexy v C*One
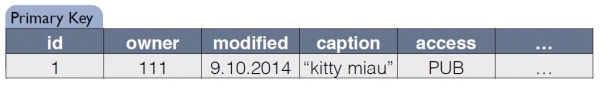
Existuje původní tabulka s fotografiemi, ve které je ID záznamu primární klíč.
Pro index C*One vytvoří novou tabulku, která je kopií původní. Klíč se shoduje s indexovým výrazem, navíc zahrnuje i primární klíč záznamu z původní tabulky:
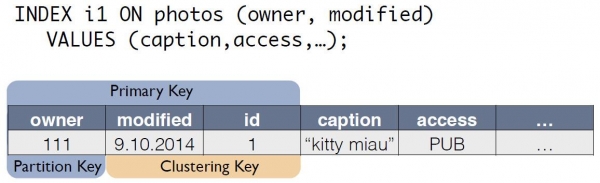
Nyní lze dotaz na „vlastníka za posledních 24 hodin“ přeformulovat jako SELECT z jiné tabulky:
SELECT * FROM i1_test
WHERE owner=?
AND modified>?
Konzistence dat původní tabulky photos a indexové tabulky i1 je automaticky udržována koordinátorem. Na základě samotné datové schématu při získání změny koordinátor generuje a ukládá změnu nejen původní tabulky, ale i změny kopií. Neprovádějí se žádné další akce s indexovou tabulkou, logy nejsou čteny, zámky nejsou používány. To znamená, že přidání indexů téměř nezatěžuje zdroje a prakticky neovlivňuje rychlost aplikace modifikací.
Díky ACID se nám podařilo implementovat indexy „jako v SQL“. Tyto indexy mají konzistenci, dají se škálovat, rychle fungují, mohou být složené a integrovány do jazyka dotazů CQL. Pro podporu indexů není třeba měnit aplikační kód. Vše je jednoduché jako v SQL. Co je nejdůležitější, indexy neovlivňují rychlost provádění modifikací původní tabulky transakcí.
Co jsme získali
C*One jsme vyvinuli před třemi lety a uvedli do průmyslového provozu.
Co jsme tedy na závěr získali? Posuďme to na příkladu subsystému zpracování a ukládání fotografií, jednoho z nejdůležitějších typů dat v sociální síti. Nemluvíme o samotných tělech fotografií, ale o různých meta informacích. V současnosti v „Odnoklassnikách“ existuje asi 20 miliard takových záznamů, systém zpracovává 80 tisíc dotazů za sekundu, až 8 tisíc ACID transakcí za sekundu týkajících se modifikace dat.
Když jsme používali SQL s replication factor = 1 (ale v RAID 10), meta informace fotografií byly uloženy na vysoce dostupném clusteru o 32 strojích s Microsoft SQL Server (plus 11 záložních). Také bylo vyčleněno 10 serverů pro ukládání záloh. Celkem tedy 50 nákladných strojů. Přičemž systém fungoval na nominálním zatížení, bez rezervy.
Po migraci na nový systém jsme získali replication factor = 3 — jednu kopii v každém datovém centru. Systém se skládá z 63 uzlů úložiště Cassandra a 6 strojů koordinátorů, celkem 69 serverů. Ale tyto stroje jsou výrazně levnější, jejich celkové náklady činí přibližně 30 % nákladů systému na SQL. Zatímco zatížení je na úrovni 30 %.
S implementací C*One se snížily i latence: operace zápisu v SQL trvala přibližně 4,5 ms. V C*One — přibližně 1,6 ms. Délka transakce je v průměru méně než 40 ms, commit probíhá za 2 ms, délka čtení a zápisu — v průměru 2 ms. 99. percentil — pouze 3-3,1 ms, počet timeoutů se snížil 100krát — a to díky širokému využití spekulací.
K dnešnímu dni bylo vyřazeno z provozu většina uzlů SQL Serveru, nové produkty jsou vyvíjeny pouze s využitím C*One. Přizpůsobili jsme C*One pro práci v našem cloudu. , což umožnilo zrychlit nasazení nových klastrů, zjednodušit konfiguraci a automatizovat provoz. Bez zdrojového kódu by to bylo mnohem složitější a méně efektivní.
Nyní pracujeme na převodu ostatních našich úložišť do cloudu — ale to už je úplně jiný příběh.
Zdroj: habr.com
