

Toto je překlad mého článku na Medium — , který se ukázal jako docela populární, pravděpodobně díky své jednoduchosti. Proto jsem se rozhodl napsat ho v ruštině a trochu doplnit, aby obyčejnému člověku, který není specialistou na data, bylo jasné, co je to datové skladiště (DW), co je to datové jezero (Data Lake) a jak spolu fungují.
Proč jsem chtěl psát o datovém jezeře? Pracuji s daty a analytikou více než 10 let, a nyní pracuji s velkými daty v Amazon Alexa AI v Cambridge, který je v Bostonu, přičemž sám žiji ve Victorii na Vancouveru a často jsem jak v Bostonu, tak v Seattlu a Vancouveru, a někdy dokonce i v Moskvě vystupuji na konferencích. Také občas píšu, ale většinou píšu v angličtině a napsal jsem už , také mám potřebu sdílet trendyd analytiky ze Severní Ameriky, a občas píšu na .
Vždy jsem pracoval s datovými skladišti, a od roku 2015 jsem se intenzivně věnoval Amazon Web Services, a vůbec jsem přešel na cloudovou analytiku (AWS, Azure, GCP). Sleduji vývoj analytických řešení od roku 2007 a sám jsem dokonce pracoval pro dodavatele datových skladišť Teradata a implementoval je ve Sberbank, tehdy se objevila Big Data s Hadoop. Všichni začali říkat, že éra datových skladišť skončila a teď je všechno na Hadoopu, a pak se začalo mluvit o datovém jezeře, opět, že nyní datovému skladišti určitě přišel konec. Ale naštěstí (možná pro někoho bohužel, kdo vydělával spoustu peněz na nastavení Hadoopu) datové skladiště nezmizelo.
V tomto článku se podíváme na to, co je datové jezero. Článek je určen lidem, kteří mají málo zkušeností s datovými skladišti nebo je nemají vůbec.
Na obrázku je jezero Bled, což je jedno z mých oblíbených jezer, i když jsem tam byl jen jednou, ale pamatuji si ho na celý život. Ale budeme hovořit o jiném typu jezera — datovém jezeře. Možná už jste mnohokrát slyšeli tento termín, ale další definice nikdy neuškodí.
Nejprve zde jsou nejpopulárnější definice datového jezera:
"souborové úložiště všech typů surových dat, která jsou dostupná k analýze kýmkoli v organizaci" — Martin Fowler.
„Pokud si myslíte, že datová vitrína je jako láhev vody – vyčištěné, zabaleno a připravené k pohodlné konzumaci, pak naše datové jezero je obrovská nádrž s vodou v jejím přirozeném stavu. Uživatelé si mohou nabrat vodu pro sebe, ponořit se do hloubky, zkoumat“ – James Dixon.
Nyní už víme, že datové jezero se týká analytiky, umožňuje nám uchovávat velké objemy dat v jejich původní podobě a máme potřebný a pohodlný přístup k těmto datům.
Často rád zjednodušuji věci, pokud mohu složitý termín vysvětlit jednoduchými slovy, znamená to, že jsem pochopil, jak to funguje a k čemu je to potřeba. Například, jak jsem si prohlížel fotografie na iPhonu, došlo mi, že to je opravdové datové jezero, dokonce jsem vytvořil snímek pro konference:
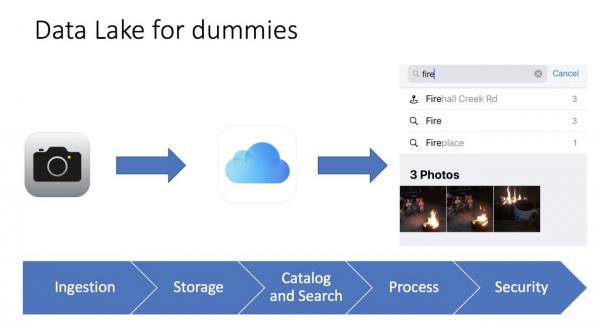
Všechno je velmi jednoduché. Uděláme fotografii telefonem, fotografie se uloží do telefonu a může být uložena v iCloudu (úložné místo v cloudu). Také telefon sbírá metadata fotografie: co je na obrázku, geolokace, čas. Výsledkem je, že můžeme použít pohodlné rozhraní iPhonu k nalezení naší fotografie a dokonce vidíme ukazatele, například, když hledám fotografie se slovem oheň (fire), najdu 3 fotografie s obrázkem ohniště. Pro mě je to jako nástroj Business Intelligence, který funguje velmi rychle a přesně.
A samozřejmě, nesmíme zapomínat na bezpečnost (autentizaci a autorizaci), jinak se naše data mohou snadno dostat do veřejného přístupu. Existuje mnoho zpráv o velkých korporacích a startupech, jejichž data se dostala do veřejného přístupu kvůli nedbalosti vývojářů a nedodržování jednoduchých pravidel.
Dokonce i takový jednoduchý obrázek nám pomáhá představit si, co je to datové jezero, jeho rozdíly od tradičního datového úložiště a jeho hlavní prvky:
- Načítání dat (Ingestion) — klíčová složka datového jezera. Data mohou vstupovat do datového úložiště dvěma způsoby — batch (nahrávání s intervaly) a streaming (přenos dat).
- Úložný prostor pro soubory (Storage) — hlavní složka Datového Jezera. Musíme mít úložiště, které je snadno škálovatelné, mimořádně spolehlivé a má nízké náklady. Například v AWS je to S3.
- Katalog a Vyhledávání (Katalog a vyhledávání) — abychom se vyhnuli Datovým bažinám (což je situace, kdy shromáždíme všechna data do jedné hromady a následně je nelze efektivně zpracovávat), je nezbytné vytvořit vrstvu metadat pro klasifikaci dat, aby uživatelé snadno našli data, která potřebují pro analýzu. Dále je možné použít další hledací řešení, například ElasticSearch. Hledání pomáhá uživateli vyhledávat potřebná data prostřednictvím uživatelsky přívětivého rozhraní.
- Zpracování (Proces) — tento krok se zabývá zpracováním a transformací dat. Můžeme transformovat data, měnit jejich struktury, čistit a mnoho dalšího.
- Bezpečnost (Bezpečnost) — je důležité investovat čas do návrhu bezpečnosti řešení. Například šifrování dat během jejich uchovávání, zpracování a přenosu. Je důležité používat metody autentizace a autorizace. Na závěr potřebujeme nástroj pro audit.
Z praktického hlediska můžeme charakterizovat datové jezero třemi atributy:
- Shromažďujte a ukládejte cokoliv — datové jezero obsahuje všechna data, jak surová nepropracovaná data za jakékoliv časové období, tak i zpracovaná/čistá data.
- Hluboká analýza — datové jezero umožňuje uživatelům zkoumat a analyzovat data.
- Flexibilní přístup — datové jezero poskytuje flexibilní přístup k různým datům a různým scénářům.
Nyní se můžeme podívat na rozdíl mezi úložištěm dat a datovým jezerem. Lidé se obvykle ptají:
- A co úložiště dat?
- Nahrazujeme úložiště dat datovým jezerem, nebo ho rozšiřujeme?
- Můžeme se vlastně obejít bez datového jezera?
Stručně řečeno, jasná odpověď neexistuje. Vše závisí na konkrétní situaci, dovednostech v týmu a rozpočtu. Například migrace úložiště dat na Oracle do AWS a vytvoření datového jezera dceřinou společností Amazon — Woot — .
Na druhou stranu dodavatel Snowflake tvrdí, že už nemusíte přemýšlet o datovém jezeře, protože jejich datová platforma (do roku 2020 to bylo úložiště dat) vám umožňuje kombinovat datové jezero a úložiště dat. Pracoval jsem trochu se Snowflake, a to je skutečně jedinečný produkt, který to dokáže. Cena je jiná otázka.
Na závěr, moje osobní názory jsou, že stále potřebujeme datové sklad jako hlavní zdroj dat pro naše reportování, a vše, co se nevejde, uchováváme v datovém jezeře. Celá role analytiky spočívá v poskytování snadného přístupu podnikům pro rozhodování. Ať se nám to líbí nebo ne, podnikoví uživatelé pracují efektivněji s datovým skladem než s datovým jezerem, například v Amazonu — je tu Redshift (analytické datové sklad) a je tu Redshift Spectrum/Athena (SQL rozhraní pro datové jezero v S3 na bázi Hive/Presto). Totéž platí pro další moderní analytické datové sklady.
Podívejme se na typickou architekturu datového skladu:
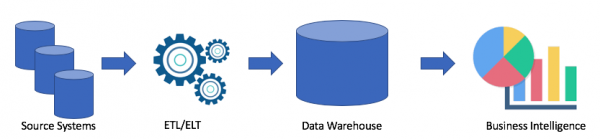
To je klasické řešení. Máme zdrojové systémy, pomocí ETL/ELT kopírujeme data do analytického datového skladu a připojujeme k řešení Business Intelligence (moje oblíbené Tableau, a vaše?).
Takové řešení má následující nevýhody:
- ETL/ELT operace vyžadují čas a zdroje.
- Obvykle je paměť pro uchovávání dat v analytickém datovém skladu drahá (například Redshift, BigQuery, Teradata), protože musíme zakoupit celé klastr.
- Podnikoví uživatelé mají přístup k vyčištěným a často agregovaným datům a nemají možnost získat syrová data.
Samozřejmě, vše závisí na vašem případě. Pokud nemáte problémy s vaším datovým skladem, není vám datové jezero vůbec potřeba. Ale když se objeví problémy s nedostatkem místa, výkonem nebo cena hraje klíčovou roli, můžete zvážit variantu datového jezera. Právě proto je datové jezero velmi populární. Zde je příklad architektury datového jezera:
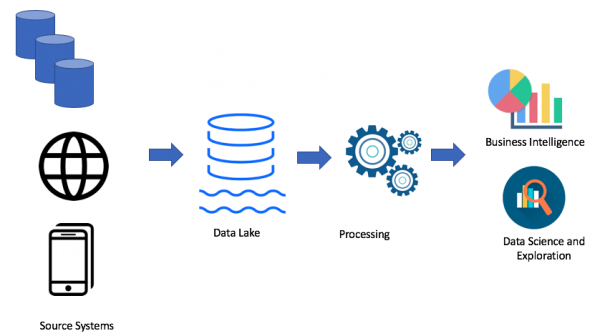
Použitím přístupu datového jezera nahráváme syrová data do našeho datového jezera (batch nebo streaming), dále zpracováváme data podle potřeby. Datové jezero umožňuje podnikovým uživatelům vytvářet vlastní datové transformace (ETL/ELT) nebo analyzovat data v řešeních Business Intelligence (pokud je k dispozici požadovaný ovladač).
Cílem jakéhokoli analytického řešení je sloužit podnikovým uživatelům. Proto bychom měli vždy pracovat na základě požadavků podniku. (V Amazonu to je jeden z principů — working backwards).
Prací jak s datovým skladem, tak s datovým jezerem můžeme porovnat obě řešení:
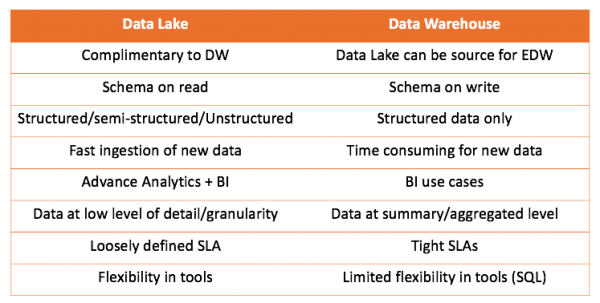
Hlavní závěr, který lze učinit, je, že datové sklady nesoutěží s datovými jezery, ale spíše je doplňují. Je to však na vás, co se hodí pro vaši situaci. Vždy je zajímavé to zkusit sami a učinit správné závěry.
Chtěl bych také vyprávět o jednom z případů, kdy jsem začal používat přístup datového jezera. Všechno je to docela banální, snažil jsem se použít nástroj ELT (měli jsme Matillion ETL) a Amazon Redshift, mé řešení fungovalo, ale neodpovídalo požadavkům.
Potřeboval jsem vzít webové protokoly, transformovat je a agregovat, abych poskytl data pro dva případy:
- Marketingový tým chtěl analyzovat aktivitu botů pro SEO
- IT chtělo sledovat metriky provozu webových stránek
Velmi jednoduché, opravdu jednoduché protokoly. Zde je příklad:
https 2018-07-02T22:23:00.186641Z app/my-loadbalancer/50dc6c495c0c9188
192.168.131.39:2817 10.0.0.1:80 0.086 0.048 0.037 200 200 0 57
"GET https://www.example.com:443/ HTTP/1.1" "curl/7.46.0" ECDHE-RSA-AES128-GCM-SHA256 TLSv1.2
arn:aws:elasticloadbalancing:us-east-2:123456789012:targetgroup/my-targets/73e2d6bc24d8a067
"Root=1-58337281-1d84f3d73c47ec4e58577259" "www.example.com" "arn:aws:acm:us-east-2:123456789012:certificate/12345678-1234-1234-1234-123456789012"
1 2018-07-02T22:22:48.364000Z "authenticate,forward" "-" "-"
Jeden soubor vážil 1-4 megabajty.
Ale byla tu jedna obtížnost. Měli jsme 7 domén po celém světě a za jeden den se vytvářelo 7000 souborů. To není až tak velký objem, celkem 50 gigabajtů. Ale velikost našeho klastru Redshift byla také malá (4 uzly). Načítání tradičním způsobem jednoho souboru trvalo přibližně minutu. To znamená, že problém nebylo možné vyřešit přímo. A to byl ten případ, kdy jsem se rozhodl použít přístup datového jezera. Řešení vypadalo přibližně takto:
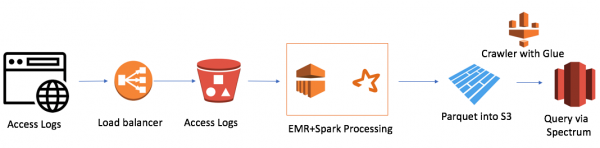
Je to dost jednoduché (chci poznamenat, že výhodou práce v cloudu je jednoduchost). Použil jsem:
- AWS Elastic Map Reduce (Hadoop) jako výpočetní výkon
- AWS S3 jako úložiště souborů s možností šifrování dat a rozlišování přístupu
- Spark jako InMemory výpočetní výkon a PySpark pro logiku a transformaci dat
- Parquet jako výsledek práce Spark
- AWS Glue Crawler jako sběrač metadat o nových datech a partiích
- Redshift Spectrum jako SQL rozhraní k datovému jezeru pro stávající uživatele Redshift
Nejmenší klastr EMR+Spark zpracoval všechny dávky souborů za 30 minut. Existují i další případy pro AWS, obzvláště hodně souvisejících s Alexou, kde je dat velmi mnoho.
Nedávno jsem se dozvěděl o jedné nevýhodě datového jezera – týká se to GDPR. Problém nastává, když klient požádá o jejich odstranění a data se nachází v jednom z souborů; nemůžeme použít jazyk pro manipulaci s daty a operaci DELETE, jako to děláme v databázi.
Doufám, že článek objasnil rozdíl mezi datovým skladem a datovým jezerem. Pokud vás to zaujalo, mohu přeložit další své články nebo články profesionálů, které čtu. Také mohu přiblížit řešení, se kterými pracuji, a jejich architekturu.
Zdroj: habr.com
