

Klasický dotaz, který vývojář téměř vždy pokládá svému DBA nebo majiteli firmy – konzultantovi pro PostgreSQL, zní: „Proč se dotazy na databázi vykonávají tak dlouho?“
Tradiční soubor příčin:
- neefektivní algoritmus
když se rozhodnete provést JOIN několika CTE s desítkami tisíc záznamů - Tento moment je velmi aktuální právě pro PostgreSQL, když jste velký dataset 'nalili' na server, děláte dotaz – a on vám 'seká' po tabulce. Protože včera tam bylo 10 záznamů, a dnes 10 milionů, ale PostgreSQL o tom ještě neví, a je třeba mu to naznačit. [
pokud se skutečné rozložení dat v tabulce již výrazně liší od posledního součtu ANALYZE - Umístili jste velkou a zatíženou databázi na slabý server, který postrádá disk, paměť a výkonnost samotného procesoru. A to je vše… Někde je strop výkonnosti, nad který už nemůžete skočit.
a již nestačí vyhrazené výpočetní prostředky CPU, neustále se zvyšují gigabajty paměti nebo disk nestačí na všechny „požadavky“ databáze - blokace od konkurenčních procesů
A pokud jsou zámky dost složité na zachycení a analýzu, pro všechno ostatní nám stačí plán dotazu, který lze získat pomocí (lepší je samozřejmě hned EXPLAIN (ANALYZE, BUFFERS) …) nebo .
Ale jak je uvedeno v téže dokumentaci,
„Pochopení plánu je umění, a abyste se ho naučili, je potřeba určité zkušenosti, …“
Ale můžete se obejít i bez něj, pokud použijete vhodný nástroj!
Jak obvykle vypadá plán dotazu? Nějak takto:
Index Scan using pg_class_relname_nsp_index on pg_class (actual time=0.049..0.050 rows=1 loops=1)
  Index Cond: (relname = $1)
  Filter: (oid = $0)
  Buffers: shared hit=4
  InitPlan 1 (returns $0,$1)
    ->  Limit (actual time=0.019..0.020 rows=1 loops=1)
          Buffers: shared hit=1
          ->  Seq Scan on pg_class pg_class_1 (actual time=0.015..0.015 rows=1 loops=1)
                Filter: (relkind = 'r'::"char")
                Rows Removed by Filter: 5
                Buffers: shared hit=1
nebo takto:
"Append  (cost=868.60..878.95 rows=2 width=233) (actual time=0.024..0.144 rows=2 loops=1)"
"  Buffers: shared hit=3"
"  CTE cl"
"    ->  Seq Scan on pg_class  (cost=0.00..868.60 rows=9972 width=537) (actual time=0.016..0.042 rows=101 loops=1)"
"          Buffers: shared hit=3"
"  ->  Limit  (cost=0.00..0.10 rows=1 width=233) (actual time=0.023..0.024 rows=1 loops=1)"
"        Buffers: shared hit=1"
"        ->  CTE Scan on cl  (cost=0.00..997.20 rows=9972 width=233) (actual time=0.021..0.021 rows=1 loops=1)"
"              Buffers: shared hit=1"
"  ->  Limit  (cost=10.00..10.10 rows=1 width=233) (actual time=0.117..0.118 rows=1 loops=1)"
"        Buffers: shared hit=2"
"        ->  CTE Scan on cl cl_1  (cost=0.00..997.20 rows=9972 width=233) (actual time=0.001..0.104 rows=101 loops=1)"
"              Buffers: shared hit=2"
"Planning Time: 0.634 ms"
"Execution Time: 0.248 ms"
Ale číst plán textem „z papíru“ je velmi složité a nepřehledné:
- v uzlu se zobrazuje součet zdrojů podstromu
to znamená, abyste pochopili, kolik času bylo potřebné k vykonání konkrétního uzlu, nebo kolik přesně to čtení z tabulky zvedlo dat z disku – musíte nějak odečíst jedno od druhého - čas uzlu je potřeba násobit cykly
Ano, odčítání není vůbec ta nejsložitější operace, kterou je třeba provádět „v hlavě“ — vždyť čas provedení je uveden průměrně pro jedno provedení uzlu, a těch může být stovky. - No a to vše dohromady brání odpovědět na základní otázku — kdo vlastně. „Slabý článek.“?
Když jsme se pokusili vysvětlit to několika stovkám našich vývojářů, pochopili jsme, že zvenčí to vypadá přibližně takto:
A tedy, potřebujeme...
Náklad
Snažili jsme se shromáždit všechny klíčové mechanismy, které pomáhají podle plánu a dotazu pochopit, „kdo je viník a co dělat“. A také sdílet část svého zkušenosti se komunitou.
Představujeme a využívejte —
Přehlednost plánů
Je snadné pochopit plán, když vypadá takto?
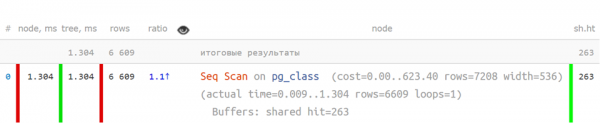
Seq Scan on pg_class (skutečný čas=0.009..1.304 řádků=6609 smyček=1)
  Buffers: shared hit=263
Planning Time: 0.108 ms
Execution Time: 1.800 ms
Neboli.
Ale takto, ve zkrácené podobě, když jsou klíčové ukazatele odděleny — už to je mnohem srozumitelnější:
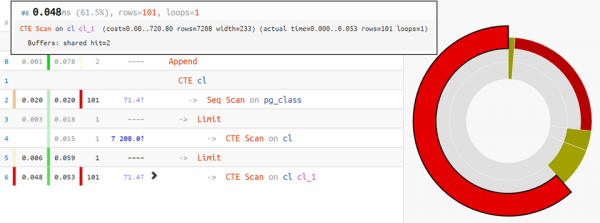
Ale pokud je plán složitější — pomůže nám koláčový graf rozložení času podle uzlů:
A pro ty nejobtížnější varianty přichází na pomoc graf výkonu:
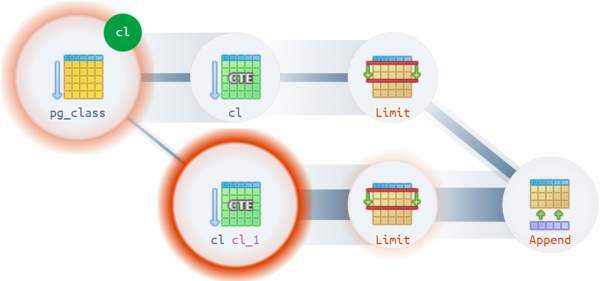
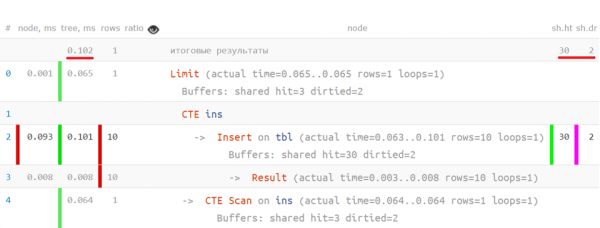
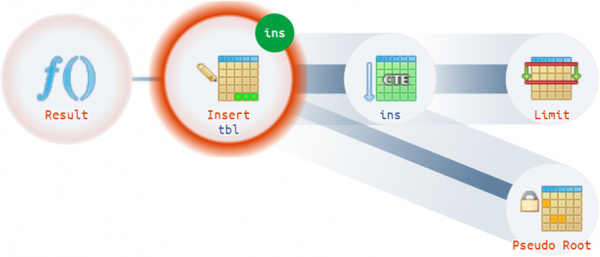
Například existují dost netriviální situace, kdy plán může mít více než jeden skutečný kořen:
Strukturální nápovědy
Pokud je celá struktura plánu a jeho slabá místa již rozložena a viditelná — proč je neoznačit vývojáři a nevysvětlit „dětským jazykem“?
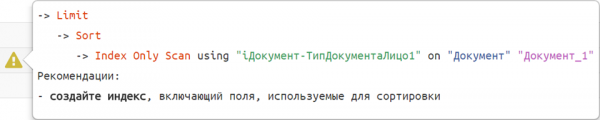 Takových vzorů doporučení jsme již shromáždili několik desítek.
Postrový profiler dotazu
Nyní, pokud na analyzovaný plán aplikujete původní dotaz, uvidíte, kolik času bylo věnováno každému jednotlivému operátoru — přibližně takto:
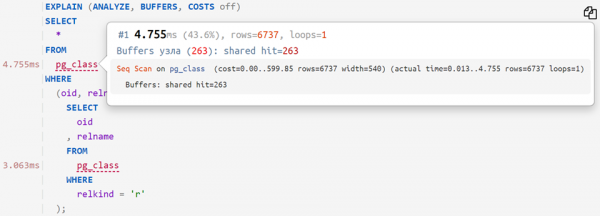
… nebo dokonce takto:
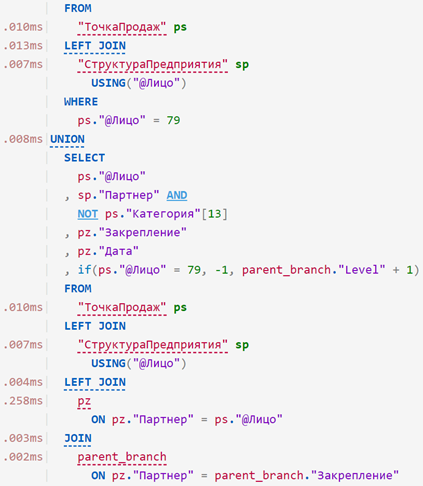
Dosazení parametrů do dotazu
Pokud jste „připojili“ k plánu nejen dotaz, ale i jeho parametry z DETAIL_řádku logu, můžete jej navíc zkopírovat v jedné z variant:
- s dosazením hodnot do dotazu
pro přímé provedení na své databázi a následnou profilaciSELECT 'const', 'param'::text; - s dosazením hodnot přes PREPARE/EXECUTE
pro simulaci práce plánovače, kdy může být parametrická část ignorována — například při práci s partitionovanými tabulkamiDEALLOCATE ALL; PREPARE q(text) AS SELECT 'const', $1::text; EXECUTE q('param'::text);
Archiv plánů
Vkládejte, analyzujte, sdílejte se svými kolegy! Plány zůstanou v archivu a budete se k nim moci vrátit později:
Ale pokud nechcete, aby váš plán viděli ostatní, nezapomeňte zaškrtnout políčko „nepublikovat v archivu“.
V následujících článcích se podělím o ty složitosti a řešení, které se při analýze plánu objevují.
Zdroj: habr.com
