

Pokud se dostanete k produktu, který se vyvíjí více než deset let, není překvapením, že se v něm nacházejí zastaralé technologie. Ale co když za půl roku musíte zvládnout zátěž desetkrát vyšší a cena výpadků vzroste o stovky procent? V takovém případě potřebujete skvělého inženýra pro vysokou zátěž. Ale protože nemáme žádného takového odborníka, svěřili jsme řešení problému mně. V první části článku se podělím o to, jak jsme migrovali z Redis na Redis-cluster, a ve druhé části poskytnu rady, jak začít používat cluster a na co se zaměřit při jeho provozu.
Výběr technologie
Je opravdu tak špatný samostatný Redis (standalone redis) v konfiguraci 1 master a N slave? Proč ho nazývám zastaralou technologií?
Ne, Redis není tak špatný… Ale jsou zde některé nedostatky, které nelze ignorovat.
Za prvé, Redis nepodporuje mechanismy pro havarijní obnovu po selhání hlavního serveru. Abychom tento problém vyřešili, použili jsme konfiguraci s automatickým přepnutím VIP na nový master, změnou role jednoho ze slave a přepínáním ostatních. Tento mechanismus fungoval, ale nedalo se to nazvat spolehlivým řešením. Za prvé, docházelo k falešným spouštěním, a za druhé, bylo to jednorázové, a po spouštění byly potřebné ruční zásahy k opětovnému zprovoznění.
Za druhé, přítomnost pouze jednoho masteru vedla k problému shardingu. Museli jsme vytvořit několik nezávislých clusterů „1 master a N slave“, poté ručně distribuovat databáze mezi těmito stroji a doufat, že zítra se jedna z databází nenafoukne natolik, že ji bude třeba přenést na samostatný instance.
Jaké jsou možnosti?
- Nejdražší a nejbohatší řešení — Redis-Enterprise. To je krabicové řešení s plnou technickou podporou. I když se to zdá být ideální z technického hlediska, z ideologických důvodů nám to nevyhovovalo.
- Redis-cluster. Z krabice je podporováno havarijní přepínání master a sharding. Rozhraní se skoro neliší od běžné verze. Vypadá slibně, o úskalí budeme mluvit dále.
- Tarantool, Memcache, Aerospike a další. Všechny tyto nástroje dělají víceméně to samé. Ale každý z nich má své nevýhody. Rozhodli jsme se nedávat všechny vejce do jedné basket, Memcache a Tarantool používáme k jiným úlohám a dopředu mohu říci, že jsme měli více problémů s nimi.
Specifika použití
Podívejme se, jaké úkoly jsme historicky řešili pomocí Redis a jaké funkčnosti jsme využívali:
- Cache před dotazy na vzdálené služby jako 2GIS | Golang
GET SET MGET MSET "SELECT DB"
- Cache před MYSQL | PHP
GET SET MGET MSET SCAN "KEY BY PATTERN" "SELECT DB"
- Hlavní úložiště pro službu správy sezení a koordinátů řidičů | Golang
GET SET MGET MSET "SELECT DB" "ADD GEO KEY" "GET GEO KEY" SCAN
Jak vidíte, žádná vyšší matematika. V čem je tedy obtížnost? Pojďme si to podrobněji rozebrat podle každé metody.
Metoda
Popis
Vlastnosti Redis-cluster
Řešení
GET SET
Zapsat/číst klíč
MGET MSET
Zapsat/číst několik klíčů
Klíče budou uloženy na různých uzlech. Hotové knihovny umí provádět Multi-operace pouze v rámci jednoho uzlu
Nahradit MGET pipeline z N GET operací
SELECT DB
Vybrat databázi, se kterou budeme pracovat
Nepodporuje více databází
Ukládat vše do jedné databáze. Přidat k klíčům prefixy
SCAN
Projít všemi klíči v databázi
Protože máme jednu databázi, procházet všemi klíči v clusteru je příliš nákladné
Udržovat invariant uvnitř jednoho klíče a provádět HSCAN na tomto klíči. Nebo se toho úplně vzdát
GEO
Operace s geoklíčem
Geoklíč se nedá shardovat
KEY BY PATTERN
Hledání klíče podle vzoru
Protože máme jednu databázi, budeme hledat mezi všemi klíči v clusteru. Příliš nákladné
Vzdát se nebo udržovat invariant, stejně jako v případě SCANu
Redis vs Redis-cluster
Co ztrácíme a co získáváme při přechodu na cluster?
- Nevýhody: ztrácíme funkcionalitu několika databází.
- Pokud chceme uchovávat v jednom clusteru logicky nesouvisející data, budeme muset vytvářet zástěry pomocí prefixů.
- Ztrácíme všechny operace "podle databáze", jako například SCAN, DBSIZE, CLEAR DB atd.
- Multi-operace se staly výrazně složitějšími na implementaci, protože může být nutné komunikovat s několika uzly.
- Výhody:
- Odolnost vůči chybám ve formě havarijního přepnutí mastera.
- Shardování na straně Redis.
- Atomární přenos dat mezi uzly bez prostoju.
- Přidání a redistribuce výkonu a zátěží bez prostoju.
Myslím, že pokud nepotřebujete zajistit vysokou úroveň odolnosti proti výpadkům, pak migrace na cluster za to nestojí, protože to může být složitý úkol. Ale pokud bychom měli vybrat mezi samostatnou verzí a clusterem, měli bychom volit cluster, protože není nijak horší a navíc to z vás sníží část bolesti hlavy.
Příprava na migraci
Začněme s požadavky na migraci:
- Musí být bezproblémová. Úplné zastavení služby na 5 minut nás neuspokojí.
- Musí být maximálně bezpečná a postupná. Rádi bychom mít nějakou kontrolu nad situací. Nechceme vše hodit najednou a modlit se nad tlačítkem pro návrat.
- Minimální ztráty dat během migrace. Chápeme, že atomární migrace bude velmi složitá, takže připouštíme určitou nesynchronizaci mezi daty v běžném a clusterovém Redis.
Údržba clustera
Těsně před samotnou migrací bychom se měli zamyslet nad tím, zda můžeme udržovat cluster:
- Grafy. Používáme Prometheus a Grafana pro grafy zatížení procesorů, využití paměti, počet klientů, počet operací GET, SET, AUTH atd.
- Expertní znalosti. Představte si, že zítra budete mít na starosti obrovský cluster. Pokud se rozbije, nikdo kromě vás ho nebude moci opravit. Pokud začne zpomalovat — všichni se k vám poženou. Pokud bude potřeba přidat zdroje nebo přerozdělit zátěž — opět k vám. Abychom nezvinuli vlasy ve 25, měli bychom tyto případy předem zvážit a ověřit si, jak se technologie zachová při různých akcích. O tom se podrobněji pobavíme v části „Expertní znalosti“.
- Monitoring a upozornění. Když se cluster rozbije, chceme o tom vědět jako první. Omezili jsme se na upozornění, že všechny uzly vracejí stejné informace o stavu clustera (ano, může to být i jinak). A ostatní problémy si můžeme rychleji všimnout podle upozornění klientských služeb Redis.
Migrace
Jak budeme migrovat:
- Nejdříve je třeba připravit knihovnu pro práci s klastrem. Jako základ pro verzi v Gо jsme vzali go-redis a trochu si ji upravili. Implementovali jsme Multi-metody prostřednictvím pipeline a také mírně upravili pravidla opakování dotazů. S verzí pro PHP jsme měli více problémů, ale nakonec jsme se rozhodli pro php-redis. Nedávno zavedli podporu klastru a z našeho pohledu vypadá dobře.
- Dále je třeba rozvinout samotný klastr. To se dělá doslova ve dvou příkazech na základě konfiguračního souboru. O nastavení podrobněji diskutujeme níže.
- Pro postupný přechod používáme dry-mode. Jelikož máme dvě verze knihovny se stejným rozhraním (jednu pro běžnou verzi, druhou pro klastr), není nic jednoduššího než vytvořit wrapper, který bude pracovat s jednotlivou verzí a zároveň duplikovat všechny dotazy do klastru, porovnávat odpovědi a zapisovat rozdíly do logů (v našem případě do NewRelic). Takže i když se při spuštění klastrální verze něco pokazí, náš production to neovlivní.
- Při spuštění klastru v dry- režimu můžeme klidně sledovat graf rozdílů odpovědí. Pokud podíl chyb pomalu, ale jistě směřuje k určité malé konstantě, znamená to, že je vše v pořádku. Proč však rozdíly stále existují? Protože zápis v jednotlivé verzi probíhá trochu dříve než v klastru, a díky mikrologu se mohou údaje lišit. Zbylo jen podívat se na logy rozdílů, a pokud jsou všechny vysvětlitelné neatomaritou zápisu, můžeme pokračovat dál.
- Nyní můžeme přepnout dry-mode na opačnou stranu. Budeme zapisovat a číst z klastru, a duplikovat do jednotlivé verze. Proč? Během příštího týdne bychom chtěli sledovat práci klastru. Pokud se náhle zjistí, že v max. zatížení jsou nějaké problémy, nebo jsme něco nepředpokládali, máme vždy k dispozici havarijní návrat na starý kód a aktuální data díky dry-mode.
- Zbývá pouze vypnout dry-mode a demontovat jednotlivou verzi.
Odbornost
Nejprve stručně o zařízení klastru.
Nejdříve, Redis je key-value úložiště. Jako klíč se používají libovolné řetězce. Jako hodnoty mohou být používána čísla, řetězce a celé struktury. Těch je velké množství, ale pro pochopení obecného zařízení nám to není důležité.
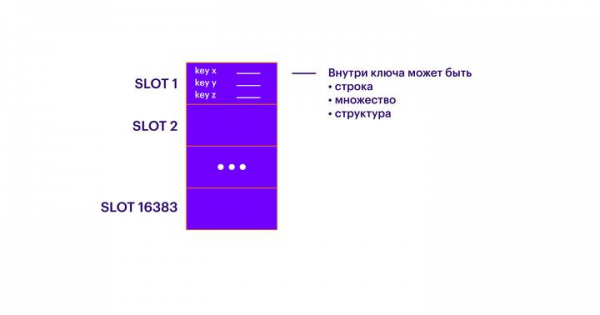
Další úroveň abstrakce po klíčích jsou sloty (SLOTS). Každý klíč patří do jednoho ze 16 383 slotů. Uvnitř každého slotu může být libovolný počet klíčů. Takže všechny klíče se dělí na 16 383 disjunktních množin.
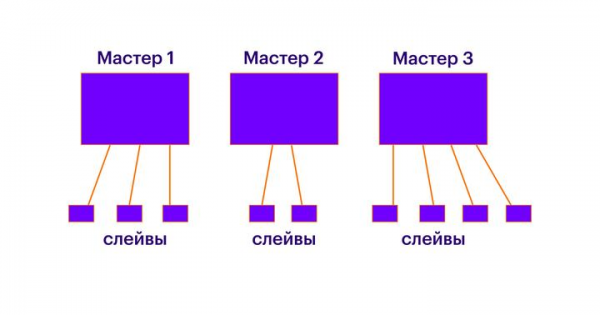
Dále musí být v clusteru N master nodů. Každou nodu lze představovat jako samostatnou instanci Redis, která ví vše o ostatních nodech uvnitř clusteru. Každá master nod obsahuje určité množství slotů. Každý slot patří pouze jedné master nodě. Všechny sloty je třeba rozdělit mezi nody. Pokud nějaké sloty nejsou rozděleny, klíče, které v nich jsou uloženy, budou nedostupné. Každou master nod má smysl spustit na samostatném logickém nebo fyzickém stroji. Také je dobré si pamatovat, že každá noda pracuje pouze na jednom jádru, a pokud chcete spustit na jednom logickém stroji více instancí Redis, ujistěte se, že poběží na různých jádrech (to jsme nezkoušeli, ale teoreticky by to mělo fungovat). V podstatě master nody poskytují běžné shardování a větší počet master nodů umožňuje škálování požadavků na zápis a čtení.
Jakmile jsou všechny klíče rozděleny podle slotů a sloty rozloženy mezi master nody, lze k každé master nodě přidat libovolný počet slave nodů. Uvnitř každého takového páru "master-slave" bude fungovat standardní replikace. Slaves jsou potřeba pro škálování požadavků na čtení a pro výpadkové přepínání v případě selhání masteru.
Teď si povězme o operacích, které bychom měli umět provádět.
K systému se budeme obracet pomocí Redis-CLI. Vzhledem k tomu, že Redis nemá jediný vstupní bod, lze provádět následující operace na libovolné z nodů. V každém bodě zvlášť upozorňuji na možnost provedení operace pod zátěží.
- První a nejdůležitější, co budeme potřebovat: operace cluster nodes. Ta vrací stav clusteru, ukazuje seznam nodů, jejich role, rozložení slotů atd. Další informace lze získat pomocí cluster info a cluster slots.
- Bylo by dobré umět přidávat a odstraňovat nody. K tomu slouží operace cluster meet a cluster forget. Všimněte si, že cluster forget je třeba použít na KAŽDÉ nodě, jak na masterech, tak na replikách. Na jedné nodě stačí pouze vyvolat cluster meet. Tato odlišnost může být matoucí, proto je lepší se o ní dozvědět před uvedením clusteru do provozu. Přidání nody se bezpečně provádí v provozu a nijak neovlivňuje práci clusteru (což je logické). Pokud se chystáte odstranit nodu z clusteru, měli byste se ujistit, že na ní nezbyly sloty (jinak riskujete ztrátu přístupu ke všem klíčům na této nodě). Také neodstraňujte master, který má slaye, jinak dojde k zbytečnému hlasování o novém masterovi. Pokud na nodech už sloty nejsou, je to malý problém, ale proč mít navíc volby, když lze nejprve odstranit slaye.
- Pokud je třeba násilím vyměnit master a slave, pak je vhodný příkaz cluster failover. Při jeho vyvolání v provozu je třeba chápat, že během provádění operace bude master nedostupný. Obvykle přepnutí probíhá za méně než sekundu, ale není atomické. Můžete se spolehnout, že část požadavků na master v tuto chvíli skončí chybou.
- Před odebráním uzlu z clustera by na něm neměly zůstat žádné sloty. Je lepší je přerozdělit pomocí příkazu cluster reshard. Sloty budou přesunuty z jednoho mastera na druhý. Celá operace může trvat několik minut, v závislosti na objemu přenášených dat. Avšak proces přesunu je bezpečný a nijak neovlivňuje provoz clusteru. Tímto způsobem lze všechny data přesunout z jednoho uzlu na druhý přímo během zatížení, aniž byste se museli obávat jejich dostupnosti. Existují však určité nástrahy. Za prvé, přesun dat znamená určitou zátěž pro jak uzel příjemce, tak odesílatele. Pokud je uzel příjemce již silně zatížený procesorem, neměli byste ho zatěžovat také příjmem nových dat. Za druhé, jakmile na masteru odesílatele nezůstane žádný slot, všichni jeho slave okamžitě přejdou k masteru, na který byly tyto sloty přesunuty. Problém je v tom, že všichni tito slave se chtějí synchronizovat najednou. A budete mít štěstí, pokud to bude částečná, a ne plná synchronizace. Mějte to na paměti a kombinujte operace přenosu slotů a odpojování/přesunu slave. Nebo doufejte, že máte dostatek rezervy.
- Co dělat, když při přesunu zjistíte, že jste někde ztratili sloty? Doufám, že se vás tento problém nedotkne, ale pokud ano, existuje operace cluster fix. Ta nějakým způsobem rozptýlí sloty po uzlech náhodně. Doporučuji zkontrolovat její funkci tím, že předtím odstraníte z clusteru uzel s rozdělenými sloty. Vzhledem k tomu, že data v nerozdělených slotech jsou tak jako tak nedostupná, je již pozdě se obávat problémů s dostupností těchto slotů. Na druhou stranu operace na rozdělené sloty nebude mít vliv.
- Další užitečná operace je monitor. Umožňuje v reálném čase vidět celý seznam dotazů, které přicházejí na uzel. Co víc, můžete ji použít s grepem a zjistit, zda je potřebný provoz.
Také je třeba zmínit postup pro přepnutí hlavního uzlu v nouzi. Zkrátka, tento postup existuje a podle mého názoru funguje skvěle. Nicméně, nemějte na mysli, že když vytáhnete kabel ze zásuvky u stroje s hlavním uzlem, Redis se okamžitě přepne a klienti si nevšimnou ztráty. Z mé zkušenosti trvá přepnutí několik sekund. Během této doby bude část dat nedostupná: dojde k zjištění nedostupnosti hlavního uzlu, uzly hlasují pro nového, slave se přepnou a data se synchronizují. Nejlepší způsob, jak se osobně ujistit, že schéma funguje, je provést místní cvičení. Zvyšte si cluster na svém notebooku, dejte mu minimální zátěž, imitujte pád (například zablokováním portů) a zhodnoťte rychlost přepnutí. Podle mě pouze pohrát si tímto způsobem den nebo dva si lze být jisti, že technologie funguje. Nebo se spolehnout, že software, který používá polovina internetu, určitě funguje.
Konfigurace
Často je konfigurace první věcí, kterou je třeba vyřešit při práci s nástrojem. A když už vše funguje, nechce se nám s konfigurací pohybovat. Je nutné vynaložit určité úsilí, abychom se donutili vrátit se k nastavením a důkladně je projít. Z mé paměti si pamatuji alespoň dva vážné problémy kvůli nepozornosti k konfiguraci. Věnujte zvláštní pozornost následujícím bodům:
- timeout 0
Doba, po které se uzavírají neaktivní spojení (v sekundách). 0 — neuzavírají se
Ne každá naše knihovna uměla správně uzavírat spojení. Vypnutím tohoto nastavení riskujeme překročení limitu počtu klientů. Na druhou stranu, pokud takový problém existuje, automatické přerušení ztracených spojení jej zamaskuje, a my si toho nemusíme všimnout. Kromě toho by toto nastavení nemělo být zapnuto při používání persist-zapojení. - Save x y & appendonly yes
Uložení RDB snímku.
Problémy RDB/AOF podrobně prodiskutujeme níže. - stop-writes-on-bgsave-error no & slave-serve-stale-data yes
Pokud je zapnuto, pak při chybě RDB snímku hlavní uzel přestane přijímat požadavky na změnu. Pokud se ztratí spojení s hlavním uzlem, slave může pokračovat v odpovídání na požadavky (yes). Nebo přestane odpovídat (no).
Nesouhlasíme se situací, kdy se Redis promění v dýni. - repl-ping-slave-period 5
Po tomto časovém úseku začneme mít obavy, že master selhal a je čas provést proceduru failoveru.
Bude nutné ručně hledat vyvážení mezi falešnými aktivacemi a spuštěním failoveru. Z naší praxe to trvá 5 sekund. - repl-backlog-size 1024mb & epl-backlog-ttl 0
Přesně tolik dat můžeme uchovávat v bufferu pro odpojenou repliku. Pokud buffer vyčerpáme, budeme muset zcela synchronizovat.
Praxe ukazuje, že je lepší nastavit hodnotu vyšší. Důvodů, proč může replika začít zaostávat, je dostatek. Pokud zaostává, pravděpodobně váš master už má velké potíže, a úplná synchronizace bude poslední kapkou. - maxclients 10000
Maximální počet současných klientů.
Z naší zkušenosti je lepší nastavit hodnotu vyšší. Redis si skvěle poradí s 10 tisíci připojeními. Jen se ujistěte, že je v systému dostatek socketů. - maxmemory-policy volatile-ttl
Pravidlo, podle kterého se klíče odstraňují při dosažení limitu dostupné paměti.
Zde není důležité samo pravidlo, ale pochopení, jak to bude probíhat. Redis lze pochválit za schopnost normálně fungovat při dosažení paměťového limitu.
Problematika RDB a AOF
I když Redis uchovává všechny informace v paměti, existuje také mechanismus pro ukládání dat na disk. A konkrétně tři mechanismy:
- RDB-snapshot — kompletní snímek všech dat. Nastavuje se pomocí konfigurace SAVE X Y a čte se jako „Uložit kompletní snímek všech dat každých X sekund, pokud se změnilo alespoň Y klíčů.“
- Append-only file — seznam operací v pořadí jejich provádění. Přidává nové přicházející operace do souboru každých X sekund nebo každých Y operací.
- RDB a AOF — kombinace dvou předchozích.
Všechny metody mají svoje výhody a nevýhody, nebudu je všechny vyjmenovávat, jen upozorním na mně ne zcela zřejmé aspekty.
Za prvé, pro uložení RDB-snímku je třeba vyvolat FORK. Pokud je dat hodně, může to způsobit zamrznutí celého Redis na dobu od několika milisekund do sekundy. Kromě toho musí systém vyhradit paměť na takový snímek, což vede k potřebě mít na logické mašině dvojnásobek operační paměti: pokud je pro Redis vyhrazeno 8 GB, musí být na virtuálním stroji s ním dostupných 16.
Za druhé, existují problémy s částečnou synchronizací. V režimu AOF se při znovu připojení slave místo částečné synchronizace může provádět úplná. Proč se to tak děje, nedokážu pochopit. Ale stojí za to na to pamatovat.
Tyto dva body již nutí zamyslet se nad tím, zda skutečně potřebujeme tato data na disku, když jsou stejně vše duplikováno slavy. Ztratit data lze pouze při selhání všech slavy, což je problém úrovně "požár v datovém centru". Jako kompromis lze navrhnout ukládat data pouze na slavy, ale v tomto případě je třeba zajistit, aby se tyto slavy nikdy nestaly masterem při havarijním obnovení (pro to existuje nastavení priority slavy v jejich konfiguraci). V každém konkrétním případě se zamýšlíme, zda máme ukládat data na disk, a většinou odpovídáme "ne".
Závěr
Na závěr doufám, že jsem dokázal poskytnout obecnou představu o fungování redis-clusteru těm, kdo o něm nikdy neslyšeli, a také jsem upozornil na nějaké nepříliš zřejmé momenty pro ty, kdo ho používají již dlouho.
Děkuji za váš čas a jako obvykle jsou vítány komentáře k tématu.
Zdroj: habr.com
