

Další uživatel chce na pevný disk zapsat nový blok dat, ale pro to mu chybí volné místo. Nicméně se mu nechce nic odstraňovat, protože "všechno je velmi důležité a potřebné". Co s tím teď uděláme?
Takový problém nepostihuje pouze jeho. Na našich pevných discích leží terabajty informací, a toto množství se ani nepokouší zmenšit. Jak unikátní však tyto informace jsou? Koneckonců, všechny soubory jsou jen množiny bitů určité délky a pravděpodobně se nový soubor příliš neliší od toho, který už máme uložený.
Je jasné, že vyhledávat již uložené bloky informací na pevném disku je úkol, který není příliš efektivní. Na druhou stranu, pokud je rozdíl malý, bylo by možné jej trochu přizpůsobit…
TL;DR — druhý pokus o popsání podivné metody optimalizace dat pomocí JPEG souborů, nyní ve srozumitelnější podobě.
O bitech a rozdílech
Pokud vezmeme dva zcela náhodné bloky dat, tak v nich průměrně souhlasí polovina obsažených bitů. Opravdu, mezi možnými kombinacemi pro každý pár (’00, 01, 10, 11′) přesně polovina má shodné hodnoty, to je jednoduché.
Ale samozřejmě, pokud vezmeme dva soubory a přizpůsobíme jeden druhému, jeden z nich ztratíme. Pokud ale budeme uchovávat změny, prostě znovu vynalezneme , které existuje i bez nás, i když obvykle není používáno pro stejné účely. Můžeme se snažit integrovat menší sekvenci do větší, ale i tak riskujeme ztrátu kritických segmentů dat při neuváženém používání se vším.
Jaké rozdíly tedy můžeme odstranit? To znamená, že zapisovaný nový soubor od uživatele — je prostě sekvence bitů, se kterou jako takovou nemůžeme nic udělat. Musíme tedy najít na pevném disku takové bity, které můžeme měnit, aniž bychom museli uchovávat rozdíl, aby bylo možné přežít jejich ztrátu bez vážných následků. A má smysl měnit nejen samotný soubor ve FS, ale také nějaké méně citlivé informace uvnitř něj. Ale jaké a jak?
Metody přizpůsobení
Když přijde na pomoc ztrátové komprimované soubory. I když jsou všechny tyto jpeg, mp3 a další formáty ztrátově komprimované, obsahují spoustu bitů, které lze bezpečně modifikovat. Můžeme použít pokročilé techniky, které nenápadně mění jejich komponenty na různých úsecích kódování. Počkejte. Pokročilé techniky... nenápadná modifikace... jedny bity na jiné... to je skoro jako !
Opravdu, vkládání jedné informace do druhé je něco, co připomíná její metody. Také se mi líbí nenápadnost provedených změn pro lidské smysly. Odtud se cesty rozcházejí — tajnost je to, co nám chybí: naším cílem je vložit uživateli na jeho pevný disk další informace, které mu pouze uškodí. Zapomene na to.
Proto, i když je můžeme použít, musíme provést určité modifikace. A dál vám ukážu a vysvětlím je na příkladu jedné z existujících metod a rozšířeného formátu souborů.
O šakalích
Pokud už budeme komprimovat, pak to nejvíc komprimovatelné na světě. Řeč je samozřejmě o JPEG souborech. Nejen, že existuje spousta nástrojů a existujících metod pro vkládání dat do nich, ale je to také nejsledovanější grafický formát na této planetě.
Nicméně, abychom se vyhnuli psíkům, musíme omezit své pole působnosti na soubory tohoto formátu. Nikdo nemá rád jednobarevné čtverce, které vznikají přílišnou komprimací, proto bychom se měli omezit na práci s již komprimovaným souborem, vyhýbajíc se překódování. Konkrétně — s celočíselnými koeficienty, které zůstávají po operacích zajišťujících ztrátu dat — DCT a kvantizaci, což je skvěle zobrazeno v kódovací schématu (děkuji wiki národní knihovny Bauman):
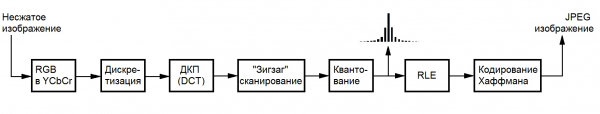
Existuje mnoho možných metod optimalizace jpeg souborů. Existuje optimalizace bez ztrát (jpegtran), existuje optimalizace „„, která ve skutečnosti vkládá ještě další, ale nás to nezajímá. Pokud je uživatel ochoten vkládat jednu informaci do druhé kvůli zvýšení volného místa na disku, buď své obrázky dávno optimalizoval, nebo to vůbec nechce dělat kvůli strachu z úbytku kvality.
F5
S těmito podmínkami vyhovuje celá řada algoritmů, se kterými se lze seznámit. . Nejvyspělejší z nich je algoritmus pod autorským vedením Andrease Westfelda, který pracuje s koeficienty jasových komponent, protože lidské oko je nejméně citlivé právě na jejich změny. Navíc využívá metodiku vkládání, založenou na kódování matice, což umožňuje provádět tím méně změn při vkládání stejného množství informací, čím větší je velikost používaného kontejneru.
Sama změna spočívá v redukci absolutní hodnoty koeficientů o jednotku za určitých podmínek (to znamená, že ne vždy), což umožňuje použít F5 pro optimalizaci ukládání dat na pevném disku. Je to tím, že koeficient po takové změně pravděpodobně zabere méně bitů po provedení Huffmanova kódování kvůli statistickému rozložení hodnot v JPEG a nové nuly přinesou výhodu při jejich kódování pomocí RLE.
Nutné modifikace spočívají v odstranění části odpovídající tajnosti (heslové permutace), která šetří zdroje a čas provádění, a přidání mechanismu pro práci s mnoha soubory místo jednoho najednou. Podrobnosti o procesu změny pravděpodobně nebudou čtenáři zajímat, proto přejdeme k popisu implementace.
Vysoce technologie
Pro demonstraci fungování takového přístupu jsem implementoval metodu v čistém C a provedl řadu optimalizací, jak co se týče rychlosti provádění, tak paměti (nevíte, kolik ty obrázky váží bez komprese i po DCT). Cross-platformnost byla dosažena použitím kombinace knihoven. , a , za což jim děkuji. Vše se sestavuje pomocí 'make', takže uživatelé Windows si pro hodnocení chtějí nainstalovat nějaký Cygwin nebo se zabývat Visual Studiem a knihovnami sami.
Implementace je dostupná ve formě konzolového nástroje a knihovny. Více o používání poslední zmíněné se zájemci mohou seznámit v readme v repozitáři na GitHubu, jehož odkaz přiložím na konci příspěvku.
Jak používat?
S opatrností. Obrázky používané pro balení jsou vybírány pomocí regulárního výrazu ve zvolené kořenové složce. Po dokončení lze soubory přesouvat, přejmenovávat a kopírovat dle potřeby v jejím rámci, měnit souborové a operační systémy atd. Nicméně je nutné být velmi opatrný a nijak neměnit bezprostřední obsah. Ztráta hodnoty i jednoho bitu může vést k nemožnosti obnovení informací.
Po dokončení práce nástroj zanechá speciální soubor archivu, který obsahuje všechny potřebné informace pro dekompresi, včetně údajů o použitých obrázcích. Sám o sobě váží přibližně několik kilobajtů a nemá žádný podstatný vliv na zabrané diskové místo.
Možné kapacity lze analyzovat pomocí příznaku '-a': './f5ar -a [vyhledávací složka] [Perl-kompatibilní regulární výraz]'. Balení se provádí příkazem './f5ar -p [vyhledávací složka] [Perl-kompatibilní regulární výraz] [balený soubor] [název archivu]', zatímco dekomprese se provádí pomocí './f5ar -u [archivový soubor] [název obnoveného souboru]'.
Demonstrace funkce
Abych ukázal účinnost metody, nahrál jsem sbírku 225 zcela bezplatných fotografií psů z služby a našel v dokumentech velký pdf soubor o 45 megabytech druhého svazku Knuth.
Sekvence je docela jednoduchá:
$ du -sh knuth.pdf dogs/
44M knuth.pdf
633M dogs/

$ ./f5ar -p dogs/ .*jpg knuth.pdf dogs.f5ar
Čtení kompresního souboru... ok
Inicializace archivu... ok
Analýza kapacity knihovny... hotovo za 17.0s
Zjištěná dostatečná kapacita je 48439359 bajtů
Zjištěná možná kapacita až 102618787 bajtů
Kompresování... hotovo za 39.4s
Uložení archivu... ok

$ ./f5ar -u dogs/dogs.f5ar knuth_unpacked.pdf
Inicializace archivu... ok
Čtení archívového souboru... ok
Naplnění archivu soubory... hotovo za 1.4s
Dekompresování... hotovo za 21.0s
Zápis extrahovaných dat... ok

$ sha1sum knuth.pdf knuth_unpacked.pdf
5bd1f496d2e45e382f33959eae5ab15da12cd666 knuth.pdf
5bd1f496d2e45e382f33959eae5ab15da12cd666 knuth_unpacked.pdf

$ du -sh dogs/
551M dogs/
Snímky pro milovníky
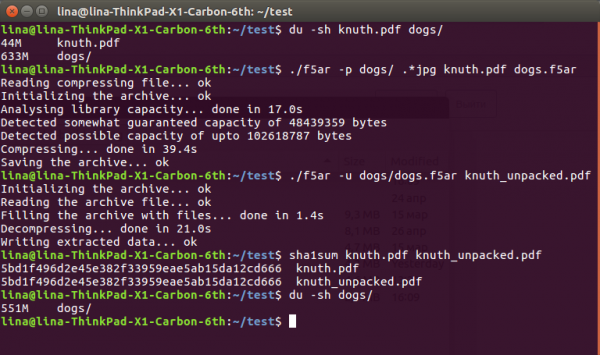
Rozbalený soubor je stále možné a nutné číst:
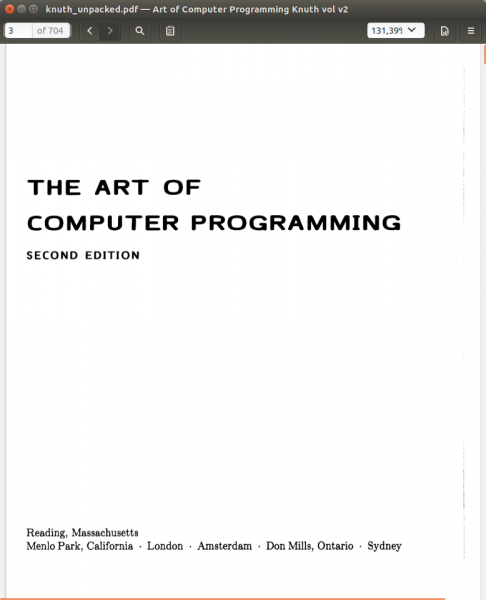
Jak je vidět, z původních 633 + 36 == 669 megabajtů dat na pevném disku jsme se dostali k příjemnějším 551. Takový radikální rozdíl je vysvětlen právě tímto snížením hodnot koeficientů, které ovlivňují jejich následné bezeztrátové kompresi: snížení jedné pouze o jednotku může na konečném souboru „odříznout“ pár bajtů. I tak jde ale o ztráty dat, byť velmi malé, s nimiž se budeme muset smířit.
Naštěstí nejsou pro oko vůbec viditelné. Pod spoilerem (protože habrastorage neumí velké soubory) si čtenář může porovnat rozdíl nejenom vizuálně, ale také jejich intenzitu, která vzniká odečtením hodnoty upravené komponenty od originální: , , (čím je barva bledší, tím menší je rozdíl v bloku).
Na závěr
Vzhledem ke všem těmto komplikacím se může jevit jako mnohem jednodušší řešení koupit pevný disk nebo všechno nahrát do cloudu. Ale přestože žijeme v tak krásné době, neexistují žádné záruky, že zítra se bude ještě možné připojit k internetu a nahrát někde svá přebytečná data. Nebo přijít do obchodu a koupit si další pevný disk s kapacitou tisíc terabajtů. Ale už použité disky doma mohou být vždy k dispozici.
->
Zdroj: habr.com
