

Před dvěma lety jsem psal příspěvek o . Nyní došlo k určitému vývoji projektu a také jsem zveřejnil pod , a proto jsem se rozhodl napsat na habr tuto malou recenzi.
[ ]
Komu by to mohlo být zajímavé
Může vás to zajímat, pokud pracujete v malém týmu nebo dokonce sami. Nemáte monitoring a nejste si jisti, zda je vůbec potřeba. Nebo jste vyzkoušeli nějaký populární seriózní monitoring „pro velké kluky“, ale pro vás nějak „neuspěl“, nebo funguje v téměř výchozí konfiguraci a příliš váš život nezměnil. A také — pokud určitě neplánujete vyčlenit celého zaměstnance (nebo dokonce oddělení) na to, aby alespoň pár hodin denně monitoroval v dashboardu monitoringu nebo jej nastavoval.
V čem je okerr neobvyklý
Dále ukážu zajímavé rysy okerru, které jej odlišují od některých jiných monitorování.
Okerr — to je hybridní monitoring
Při vnitřním monitorování se na sledovaných strojích spouští „agent“, který předává data na server monitorování (například volné místo na discích). Při externím — server provádí kontrolu přes síť (například ping nebo dostupnost webové stránky). Každý přístup má svá omezení. Okerr využívá oba přístupy. Kontroly uvnitř serverů provádí velmi lehký (30Kb) agent nebo vaše vlastní skripty a aplikace, zatímco síťové — prostřednictvím senzorů okerr v různých zemích.
okerr — to není jen software, ale také služba
Serverová část jakéhokoli monitorování je velká a složitá záležitost, obtížně se instaluje a nastavuje, vyžaduje zdroje. S okerr můžete nainstalovat svůj vlastní server monitorování (je zdarma a open-source), nebo můžete jednoduše využívat pouze klientskou část a využívat službu našeho serveru. Také zdarma.
Pokud monitorování umožňuje kompenzovat nedostatek spolehlivosti serverů a aplikací, vyvstává filozofická otázka — kdo hlídá strážce? Jak nám monitorování řekne o problému, pokud samo 'zemře' z nějakého důvodu, odděleně nebo společně s dalšími vašimi zdroji (například selhal kanál do datového centra)? Při použití externí služby okerr — tento problém se řeší — obdržíte alert, i když celé datové centrum s vašimi servery bude bez elektřiny nebo vystaveno zombie útoku.
Samozřejmě existuje riziko, že server okerr sám nebude dostupný, to je pravda (jak je známo, 90 % spolehlivosti se vždy dosáhne snadno a 'zdarma', 99 % — s minimem úsilí, a každá další devítka — exponenciálně složitější). Ale zaprvé, šance na to je menší, a zadruhé, problém může zůstat nepovšimnut pouze pokud se časově překryje s problémy na našich serverech. Pokud máme spolehlivost 99.9 %, a vy 99.9 % (ne příliš vysoká čísla), pak šance na nepovšimnutý výpadek — 0.1 % z 0.1 % = 0.0001 %. Přidat si tři devítky spolehlivosti téměř bez úsilí a nákladů — to není špatné!
Další výhodou monitorování jako služby — hostingový poskytovatel nebo webová studio může nainstalovat server okerr a poskytovat přístup klientům jako placenou nebo bezplatnou doplňkovou službu. Vaši konkurenti mají pouze hosting a webové stránky — a vy máte spolehlivý hosting s monitorováním.
Okerr — to jsou indikátory
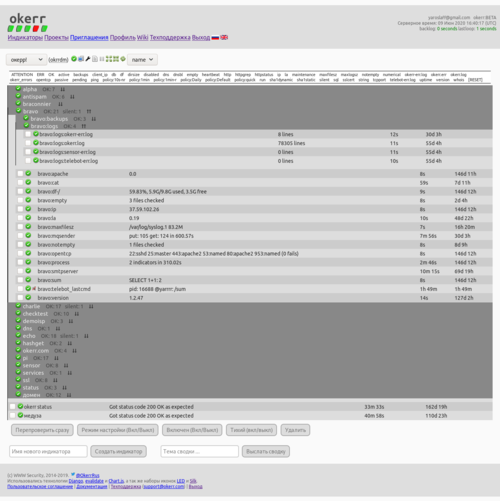
Indikátor — to je 'žárovka'. Má dva základní stavy — zelený (OK) nebo červený (ERR). V projektu je mnoho seskupených (například podle serverů) indikátorů. Na hlavní stránce projektu okamžitě vidíte, buď máte všechno zelené (a můžete zavřít), nebo něco svítí červeně a je třeba to opravit. Při přechodu mezi těmito stavy se posílá upozornění. Jednou denně, zatímco nastavíte — se posílá souhrn projektu.
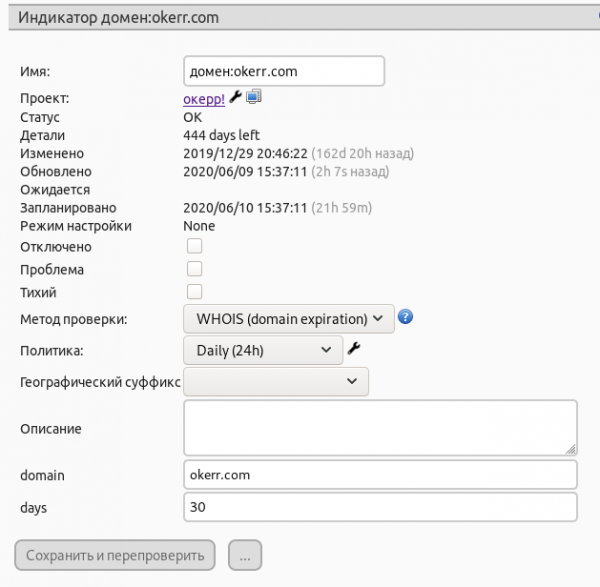
Každý indikátor okerr má vestavěné podmínky, podle kterých mění stav (v Zabbixu se tomu říká trigger). Například, průměrná zátěž musí být nižší než 2 (samozřejmě, to se dá nastavit). A pro každou vnitřní kontrolu (průměrná zátěž, volný disk, …) — je watchdog. Pokud z nějakého důvodu nedostaneme úspěšné potvrzení v určeném čase — registruje se chyba a odesílá se alert.
Naše běžné pracovní schéma zahrnuje ranní kontrolu e-mailu, kde mezi ostatními zprávami kontrolujeme shrnutí (čas jeho vypracování si určujeme na začátek pracovní doby). Pokud je vše v pořádku, věnujeme se dalším důležitým záležitostem (ale pro jistotu se můžeme rychle podívat na dashboard okerr, abychom se ujistili, že je i v tuto chvíli všechno zelené). Pokud přijde upozornění, reagujeme.
Samozřejmě existuje možnost jednoduše sledovat «informační» indikátory (abychom viděli stav sítě z monitoringu), ale vše je navrženo tak, abychom snadno a rychle vytvářeli indikátory pro automatické sledování a zasílání upozornění.
Důvod, proč nastavujete okerr, spočívá v upozorněních, abyste mohli během minuty vytvořit indikátor, který může „spát“ celý rok, jen přijímat aktualizace, a když se po roce něco pokazí, rozsvítí se a odešle upozornění. Minuta, kterou jste jednou strávili vytvářením indikátoru, se vyplatila, hned jste se dozvěděli o problému, dříve než kdokoliv jiný. Možná jste to i opravili, ještě než si toho někdo jiný všiml. Rychle vyřešené se nepovažuje za selhané!
Bezpečnost
Bylo by škoda, kdybyste nasazovali monitoring kvůli zvýšení spolehlivosti a nakonec vás skrze něj napadli přes síť, a existuje poměrně hodně síťových zranitelností různých monitorovacích nástrojů (, ).
Agenta (okerrmod z balíku ), který běží na systému — to není síťový server, ale klient. Proto na sledovaném serveru nejsou otevřené další porty, klient snadno funguje za firewallem nebo NATem a je velmi obtížné (dalo by se říct „nemožné“) ho napadnout přes síť, jelikož v podstatě neposlouchá na síťovém socketu.
Kompletní pokrytí monitorování
Naším pravidlem je nyní, že se dozvídáme o všech technických problémech z okerr. Pokud náhle dojde k porušení pravidla (okerr nás neupozornil na blížící se problém (pokud je to možné) nebo na to, že už nastal) — přidáváme kontroly do okerr.
Externí kontroly
Poměrně typový soubor:
- ping
- http status
- kontrola platnosti a čerstvosti SSL certifikátu (upozorní, pokud brzy vyprší)
- otevřený TCP port a banner na něm
- http grep (na stránce [nemělo by] být určité textové výrazy)
- sha1 hash, abychom odhalili změnu stránky.
- DNS (DNS záznam by měl mít určitou hodnotu)
- WHOIS (upozorní, pokud doména brzy vyprší)
- Antispam DNSBL (kontrola hostitele hned podle 50+ antispamových blacklistů)
Interní kontroly
Také docela typická sada (ale snadno rozšiřitelná).
- df (volné místo na discích)
- load average
- opentcp (otevřené naslouchající TCP sockety — upozorní, pokud něco začalo nebo spadlo)
- uptime — prostě uptime serveru. Upozorní, pokud se sníží (t.j. server se restartoval)
- client_ip
- dirsize — používáme k sledování, kdy nám rootfs virtuálek překročí povolenou velikost, aniž bychom nastavili přísná omezení, a k velikostem domovských adresářů uživatelů.
- empty a nonempty — sledují soubory, které by měly být prázdné (nebo ne prázdné). Například error log samotného serveru okerr — měl by být prázdný, a pokud tam je alespoň jedna řádka — dostanu upozornění a zkontroluji. Naopak mail.log na poštovním serveru by měl být NE prázdný (po N minutách po rotaci). A někdy se nám stal prázdným, po aktualizaci systému, když logrotate nedokázal správně restartovat rsyslog.
- linecount — počet řádků v souboru (jako wc -l). Používáme jako mírnější náhradu za empty, když error log může růst, ale pouze pomalu (například, google bot se snaží dostat na některé uzavřené stránky). Nastavený limit na 2 řádky za 20 minut. Pokud to bude více — dostaneme alert.
Zajímavé interní kontroly
Pokud jste dosud četli "šikmo", teď bude zajímavější přečíst si to pečlivěji.
backups
Sleduje zálohy v adresáři. U nás mají soubory záloh názvy jako „ServerName-20200530.tar.gz“. Pro každý server se v okerr vytváří indikátor ServerName-DATE.tar.gz (skutečné datum se mění na řetězec „DATE“). Sleduje se jak přítomnost čerstvé zálohy, tak její velikost (například nemůže být menší než 90 % předchozí zálohy).
Co je potřeba udělat, aby nová záloha začala být sledována, poté co jsme ji začali vytvářet a vkládat do tohoto adresáře? Nic! To je velmi pohodlný přístup, když potřebujete udělat „nic“, protože:
- Udělání „nic“ je docela rychlé, šetří to čas.
- Je obtížné zapomenout udělat „nic“.
- Je obtížné udělat „nic“ špatně, s chybou. Nic — to je nejspolehlivější metoda.
Pokud se náhle přestanou objevovat čerstvé soubory zálohy — dostanete alert. Pokud například vypnete jeden ze serverů, a jeho záloh již nemá být — musíte odstranit indikátor (přes webové rozhraní nebo ze shellu přes API).
maxfilesz
Sleduje velikost největších souborů (obvykle: /var/log/*). To umožňuje odhalovat nepředvídatelné problémy, jako například bruteforce útoky nebo rozesílání spamu přes server.
runstatus/runline
Jsou to dva důležité proxy moduly pro spouštění dalších programů na serveru. Runstatus informuje o výstupním kódu programu. Například u okerr není potřeba modul pro kontrolu, zda služby systemd běží. To se provádí prostřednictvím runstatus (viz níže). Runline informuje na server o řádku, který program vrací. Například, temp_RUN="cat /sys/class/thermal/thermal_zone0/temp" v konfiguraci Runline na našem serveru vytváří indikátor servername:temp s teplotou procesoru.
sql
Provádí číselný dotaz na MySQL a vrací výsledek do indikátoru. V jednoduchém případě lze udělat například „SELECT 1“ — to ověří, že systém databáze funguje celkově.
Ale mnohem zajímavější použití — například sledovat počet objednávek v internetovém obchodě. Pokud víte, že během hodiny máte od 100 objednávek, můžete nastavit minimální hranici na 100 nebo 80. Pak, pokud náhle klesnou vaše prodeje — dostanete upozornění a můžete se tím zabývat.
Všimněte si — je jedno, z jakého nepředvídatelného důvodu se to stalo:
- Server je jednoduše nedostupný (bez elektřiny nebo s výpadkem sítě) a upozornění přišlo, protože indikátor ‚vypršel‘.
- Server je nějak zatížen, pomalu pracuje nebo dochází k ztrátě paketů, uživatelům to není příjemné a odcházejí bez nákupů.
- Server skončil na spamech a e-maily od něj nejsou přijímány, uživatelé se nemohou registrovat.
- Skončil rozpočet reklamní kampaně, bannery se nezobrazují.
Může existovat tolik důvodů, a všechny je předem neprozíráte, a technicky je složité je sledovat. Ale je pohodlné sledovat konečný parametr (objednávky) a podle nich určit, že situace je podezřelá a zasluhuje si prozkoumat.
Logické indikátory
Umožňuje používat logické výrazy (syntax Pythonu) prostřednictvím modulu (). Pro výrazy jsou k dispozici data projektu a jeho indikátorů. Například v kapitole o SQL kontrole výše, možná jste si všimli slabého místa — ve dne máme od 100 prodejů za hodinu, ale v noci — 20, a to je normální, není to problém. Co teď? Indikátor bude přece v noci neustále panikařit.
Můžete vytvořit dva indikátory, denní a noční. Oba mohou být "tichými" (nebudou posílat upozornění). A vytvořit logický indikátor, který vyžaduje, aby byl denní indikátor OK do 20:00, a po 20:00 je dostatečné, aby byl noční indikátor OK.
Další příklad použití logického indikátoru je eskalace. Například projektový manažer se odhlašuje z alertů (není to pro něj nutné, administrátoři by měli reagovat na běžné problémy), ale hlásí se na logický indikátor, který zčervená, pokud jakýkoli indikátor v projektu není ve stanoveném čase opraven.
Dále — je zde možnost stanovit povolený čas pro práci, například od 3 do 5 ráno. Nezajímá nás, pokud servery a stránky "padnou" v tuto dobu. Ale v 5:00 musí fungovat. Pokud nefungují v jakoukoli jinou dobu — alert. Také logický indikátor umožňuje brát v úvahu zálohování serverů. Pokud máte 5 webových serverů, mohou administrátoři kdykoli vypnout 1-2 servery. Ale pokud bude v provozu méně než 3 z 5 serverů — bude alert.
Příklady výše nejsou funkce okerr, nejsou to nějaké funkce, které je třeba aktivovat a nastavit. Všechny tyto funkce v okerr nejsou, zato existuje logický modul, který umožňuje implementovat tuto funkcionalitu (Přibližně jako v programovacím jazyce — pokud máme aritmetické operátory, nepotřebujeme k jazyku zvláštní funkci pro výpočet 20% DPH, to si vždy můžeme udělat sami podle svých potřeb).
Logický indikátor je pravděpodobně jedním z mála relativně složitých témat v okerr, ale dobrá zpráva je, že je nemusíte zvládnout, dokud nenastane potřeba. Ale přitom velmi rozšiřují možnosti, přičemž zachovávají systém dostatečně jednoduchý.
Přidání vlastních kontrol
Chtěl bych velmi zdůraznit myšlenku, že okerr není soubor tisíce hotových kontrol na všechny možné situace, ale naopak — především — jednoduchý motor se snadnou možností vytváření vlastních kontrol. Vytváření vlastních kontrol v okerr není úkol pro hackery, spoluvytvářející systém, nebo alespoň pokročilé uživatele okerr, ale zvládnutelný úkol pro každého administrátora, který před měsícem poprvé nainstaloval linux.
Kontroly na minimálech se provádějí prostřednictvím modulu :
Tento řádek v konfiguraci informuje, pokud se náhodou /bin/true nespustí nebo nevrátí 0.
true_OK=\/bin\/trueStačí jen jeden řádek – a už jsme trochu rozšířili funkcionalitu okerr.
I taková kontrola má svou hodnotu: pokud váš server spadne, odpovídající indikátor na serveru okerr se včas neaktualizuje a po uplynutí doby se objeví alert.
Tato kontrola vás informuje, že server apache2 spadl (protože nikdy nevíte…):
apache_OK="systemctl is-active --quiet apache2"Pokud ovládáte jakýkoli programovací jazyk, alespoň umíte psát shell skripty – už můžete přidávat své vlastní kontroly.
O něco složitější je napsat (v jakémkoli jazyce) svůj modul pro okerrmod. V nejjednodušším případě vypadá takto:
#!/usr/bin/python3

print("STATUS: OK")
Opravdu to není až tak složité? Modul musí provést samotnou kontrolu a vypsat výsledky na STDOUT. Složitější modul například dává toto:
$ okerrmod --dump df
NAME: pi:df-\/
TAGS: df
METHOD: numerické|maxlim=90
DETAILS: 49.52%, 13.9G\/28.2G využito, 13.0G volných
STATUS: 49.52

NAME: pi:df-\/boot
TAGS: df
METHOD: numerické|maxlim=90
DETAILS: 84.32%, 53.1M\/62.9M využito, 9.9M volných
STATUS: 84.32
Aktualizuje několik indikátorů najednou (odděleny prázdným řádkem), v případě potřeby je vytvoří, uvádí detaily kontroly a tag, podle nějž lze v dashboardu snadno najít potřebné indikátory.
Telegram
Existuje Telegram bot . Není třeba zaplňovat telefon jednotlivými aplikacemi (sám nemám rád, že pro Pětku je potřeba jedna aplikace s kartou, pro Lenta druhá, pro MTS třetí, a tak dál pro všechny). Jeden Telegram stačí. Přes Telegram můžete ihned dostávat alerty a kontrolovat stav projektu a vydat příkaz k opětovnému ověření všech problematických indikátorů. Když vyjdete z divadla\/letadla, dvě hodiny jste nebyli na pulzu, zapnete telefon, kliknete na jedno tlačítko v chat-botu, a ujistíte se, že je všechno v pořádku.
Stránky stavu
V dnešní době jsou stránky stavu téměř nutností pro jakýkoli podnik, který má IT, zodpovědný přístup k spolehlivosti a respektuje své klienty\/uživatele.
Představte si situaci — uživatel chce něco udělat, zjistit informace nebo dokončit objednávku, a něco nefunguje. Neví, v čem je problém, na čí straně leží a kdy bude vyřešen. Možná je váš web prostě nefunkční? Nebo se pokazil před půl rokem a opraví se za dva roky? Ale ledničku potřebuje koupit už teď, už je v košíku… A je to úplně jiné, když uživatel vidí, že něco není v pořádku (alespoň je jasné, že problém není na jeho straně), že problém byl zjištěn, že na něm už pracujete a možná jste dokonce napsali přibližný čas opravy. Uživatel se může přihlásit a dostat na e-mail upozornění, když bude problém vyřešen a bude možné udělat to, co chtěl (koupit ledničku).
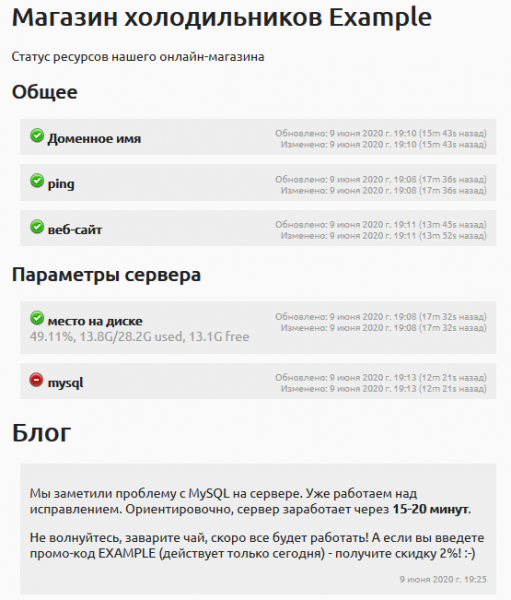
Problémy a výpadky — občas se to stane každému. Ale uživatelé a partneři více důvěřují těm, kdo jsou otevřenější a odpovědněji k tomu přistupují.
Tady . Tady jsou příklady, jak tyto stránky vypadají u projektů a . .
Failover
Abych tuto část ještě více nerozšiřoval, znovu se odvolám na svůj předchozí článek — . Pokud můžete vytvořit záložní server, pomocí failoveru v zásadě nebudete mít dlouhé výpadky — jakmile bude problém objeven, uživatelé se automaticky přesměrují na funkční záložní server. A to mi přijde jako velmi zajímavá a atraktivní funkce, která se jen málokde nachází.
Nízké systémové požadavky
Pro servery okerr — používáme stroje s RAM od 2Gb. Pro síťové senzory stačí dokonce i 512Mb. Klientská část — prakticky téměř žádná. (Balíček váží 26 Kb, ale vyžaduje Python3 a standardní knihovny). Klient se spouští z cron skriptu, takže má nulovou trvalou spotřebu paměti. Mezi sledovanými stroji máme senzory (super levné VPS s 512Mb RAM) a Raspberry Pi. Můžete dokonce bez klientské části ! (viz níže)
S ohledem na to — okerr je pravděpodobně nejvíce bezplatný monitorovací systém z existujících, protože i použití jiného bezplatného open-source systému jako Zabbix nebo Nagios vyžaduje vyčlenit mu zdroje (server), což už něco stojí. Kromě toho je stejně vyžadována určitá údržba serveru. S okerr — tuto část lze zcela odstranit. Nebo ji můžete ponechat a použít vlastní server — záleží, co se vám více líbí.
API a integrace do vlastního softwaru
Jednoduchá a otevřená architektura. Okerr má docela jednoduché , se kterým se snadno pracuje. Potřebujete vytvořit 1000 indikátorů? Jeden shell skript o 3-4 řádcích to zvládne. Potřebujete přeorientovat 1000 indikátorů? Také velmi snadné. Například chceme znovu zkontrolovat všechny naše HTTPS certifikáty právě z ruského senzoru:
#!/bin/sh

for indicator in `okerrclient --api-filter sslcert`
do
    echo set location for $indicator
    okerrclient --api-set location=ru retest=1 --name $indicator
done
Indikátor můžete aktualizovat i pomocí našeho klientského modulu, nebo dokonce bez něj, prostě přes curl.
# short and nice (using okerrupdate and config file)
$ okerrupdate MyIndicator OK

# only curl is enough!
$ curl -d 'textid=MyProject&name=MyIndicator&secret=MySecret&status=OK' https://bravo.okerr.com/
Indikátory lze aktualizovat přímo z vaší aplikace. Například odesíláním heartbeat signálů, aby okerr věděl, že je spuštěn, a spustil alarm, pokud selhal nebo zamrzl. Mimochodem, komponenty okerr to tak dělají — okerr se sám sleduje, a problémy v téměř jakémkoliv modulu budou odhaleny a vygenerují upozornění na problém. (A v případě tohoto „téměř“ — jsou vzájemně kontrolovány z jiného serveru)
Tady je takový kód (zjednodušeně) v našem telegramovém botu:
from okerrupdate import OkerrProject, OkerrExc

op = OkerrProject()
uptimei = op.indicator("{}:telebot_uptime".format(hostname))
...
uptimei.update('OK', 'pid: {} Uptime: {} cmds: {}'.format(
        os.getpid(), dhms(uptime), commands_cnt))
Pro aktualizaci indikátorů z Python programů — existuje knihovna , pro jakékoli jiné jazyky — není knihovna, ale můžete buď vyvolat skript okerrupdate, nebo provést HTTP požadavek na server okerr.
Jak nám pomáhá okerr
Okerr změnil náš život. Opravu. Možná, že jiný monitorovací systém by to také mohl udělat, ale s okerr se nám snadno pracuje a má všechny funkce, které jsme potřebovali (co chybělo — jsme dopsali). Kromě toho, pokud nějaká funkce chybí — zeptejte se, a já ji přidám (nepřijímám sliby, ale chci, aby okerr byl nejlepším monitorovacím systémem pro malé a střední projekty). Nebo, ještě lépe, přidejte ji sami — je to jednoduché.
Podařilo se nám žít podle principu „o všech problémech se dozvědět z okerr“. Pokud nastala nějaká problémová situace, o které jsme se nedozvěděli z okerr – přidáváme kontrolu do okerr. (v tomto případě pod „my“ chápu nás jako uživatele systému, nikoliv spolu- vývojáře). Na začátku to bylo často, ale nyní je to velmi vzácné.
Monitoring
S okerr sledujeme velikosti logů na všech serverech. Věnovat se pozorně každému řádku logu je samozřejmě nemožné, ale samotné sledování rychlosti růstu – už toho hodně napovídá. Díky tomu jsme zjistili odesílání spamu, bruteforce útoky na hesla a když se nějaké aplikace 'zblázní', když se jim nedaří a stále to znovu a znovu opakují (každý čas přidávají pár řádků do logu).
SSL certifikáty. Téměř okamžitě po spuštění. náš zákazník začal svým klientům poskytovat zdarma SSL certifikáty (přibližně tisíc z nich). A to se ukázalo jako naprostý horor pro administraci! Jde o to, že weby jsou 'živé', klienti občas něco chtějí, programátoři to dělají. Mohou například zcela svobodně přesunout web na jiný DocumentRoot. Nebo přidat bezpodmínečný Rewrite do konfigurace virtuálního hostitele. Samozřejmě, po takovém zásahu se automatické aktualizace certifikátů rozpadá. Nyní se všechny naše SSL hosty přidávají do okerr automaticky prostřednictvím dalšího našeho užitečného nástroje z balíčku. . Stačí pouze spustit a2okerr.py — a pokud na serveru přibylo několik nových webů – automaticky se objeví v okerr. Pokud náhodou certifikát není aktualizován, tři týdny před vypršením certifikátu – jsme v obraze a zkoumáme, proč se neaktualizuje, sakra. a2certbot.py ze stejného balíčku – velmi pomáhá v tomto (ihned zkontroluje nejpravděpodobnější problémy – a píše, co bylo dobře zkontrolováno a kde pravděpodobně problém existuje).
Sledujeme dobu vypršení všech našich domén. A všechny naše poštovní servery, které odesílají poštu – také kontrolujeme v 50+ různých blacklistích. (A občas se do nich dostanou). Mimochodem, víte, že poštovní servery google jsou také na blacklistu? Jen pro sebezkušení jsme přidali mail-wr1-f54.google.com k sledovaným serverům, a opravdu je na blacklistu SORBS! (To je k otázce o hodnotě 'antispamérů')
Zálohy — již jsem zmínil, jak snadno je sledovat s okerr. Ale my také sledujeme čerstvé zálohy na našem serveru, a (s pomocí samostatného nástroje, který využívá okerr) — zálohy, které nahráváme na Amazon Glacier. A ano — občas se vyskytnou problémy. Ne nadarmo jsme je sledovali.
Používáme indikátor eskalace. Ten ukazuje, pokud nějaký problém nebyl dlouho vyřešen. A já sám, když řeším nějaké úkoly, občas na ně mohu zapomenout. Eskalace je dobré připomenutí, i když si sám své úkoly sleduji.
Celkově považuji za to, že kvalita naší práce vzrostla několikanásobně. Doba výpadků je téměř nulová (no, nebo klient nemá šanci si toho všimnout. Jen tssss!), a objem práce se snížil, zatímco podmínky práce jsou klidnější. Přešli jsme od hektické práce se zalepováním děr lepicí páskou k klidné a vyvážené práci, kdy jsou mnohé problémy předvídatelné a máme čas je předejít. I skutečně se vyskytlé problémy se nyní snadněji opravují: za prvé, dozvídáme se o nich dříve, než klienti začnou panikařit, za druhé, často se stává, že problém souvisí s nedávným zásahem (pokud jsem opravil něco jiného, pokazil jsem jiné) — proto je snazší se s ním vyrovnat hned.
A tady byl ještě jeden případ...
Víte, že v populárním Debianu 9 (Stretch) je tak populární balíček jako phpmyadmin stále (už mnoho měsíců!) v statusu vulnerable? (). Když byla zranitelnost oznámena — rychle jsme ji kryli různými způsoby. Ale nastavil jsem v okerr sledování stránky security-trackeru, abych věděl, kdy bude k dispozici 'hezké' řešení (přes SHA1 hash obsahu). Několikrát mě indikátor upozornil, stránka se změnila, ale jak vidíte — až dodnes (od ledna 2019!) tam není uvedeno, že problém byl vyřešen. Možná někdo ví, co je tam za problém, že tak důležitý balíček je více než rok vulnerable?
Další situace podobná té minulé: po zranitelnosti v SSH bylo nutné aktualizovat všechny servery. A když zadáte úkol, je třeba kontrolovat jeho plnění. (Podřízení mají tendenci špatně chápat, zapomínat, plést si to a dělat chyby). Proto jsme nejprve do okerr přidali kontrolu verze SSH na všech serverech a přes okerr sledovali, aby se aktualizace na všechny servery nainstalovaly. (Pohodlné! Vybrali jsme tento typ indikátoru a hned vidíme, na kterém serveru je která verze). Když jsme se ujistili, že úkol byl splněn na všech serverech, odstranili jsme indikátory.
Několikrát se stalo, že se nějaký problém objevil, a pak sám od sebe zmizel. (asi to znáte všichni?). Než si toho všimnete a zkontrolujete to, už není co kontrolovat — všechno už funguje dobře. Ale potom se to opět porouchá. U nás to bylo například u produktů, které jsme nahrávali na Amazon Marketplace (MWS). V určitém okamžiku byly nahrané zásoby nesprávné (nebyla správná množství zboží a ceny). Zjistili jsme to. Ale abychom to zjistili — bylo důležité o problému ihned vědět. Bohužel, MWS, stejně jako všechny služby Amazonu — má trochu zpoždění, takže tam vždy byl skluz, ale přesto se nám podařilo alespoň přibližně zachytit spojení mezi problémem a skripty, které ho způsobují (udělali jsme kontrolu, přidali ji do okerr a kontrolovali hned při obdržení alertu).
Nedávno se do naší sbírky zajímavých případů přidal velký a drahý evropský hosting, který využívá náš zákazník. Najednou zmizely všechny naše servery! Nejprve si zákazník sám (rychleji než Okerr!) všiml, že web, se kterým pracoval, se neotevírá, a vytvořil ticket. Ale nezmizel jen jeden web, ale všechny! (Natášo, všechno jsme shodili!). V této situaci také Okerr začal posílat dlouhé zprávy se všemi indikátory, které mu svítily. Panika, panika, běháme v kruzích (co jiného dělat?). Pak se vše obnovilo. Ukázalo se, že v datovém centru probíhaly plánované práce (jednou za několik let) a měli nás samozřejmě varovat. Ale došlo k nějaké chybě a neupozornili nás. No, o infarkt víc, o infarkt míň. Ale po obnovení všeho — musíme to všechno zkontrolovat! Nedokážu si představit, jak bych to dělal ručně. Okerr to během několika minut všechno otestoval. Ukázalo se, že většina serverů byla pouze dočasně nedostupná, ale fungovala. Některé se přetížily, ale také se vzpamatovaly. Z všech ztrát jsme ztratili dvě zálohy, které se měly vytvořit a nahrát v době, kdy probíhal ten úplný chaos. Ani jsem je nezačal vytvářet, prostě po dni přišly upozornění, že je všechno v pořádku, zálohy se objevily. Tento příklad se mi velmi líbí, protože Okerr se ukázal jako velmi užitečný v situaci, o které jsme ani předtím nepřemýšleli, ale v tom spočívá úkol monitorování — čelit nepředvídatelnému.
Pro senzory Okerr používáme co nejlevnější hostitelské služby (kde kvalita a spolehlivost nejsou důležité, vzájemně se pojišťují). Takže jsme nedávno našli velmi perspektivní hosting za super nízkou cenu, benchmarky jsou úžasné. Ale… někdy se stává, že odchozí spojení z virtuálního stroje se provádí s jinou (sousední) IP. Zázraky. Modul client_ip s nedostává správnou IP. A podle serverových logů indikátoru je vidět, že aktualizace také přišla z této sousední IP. Momentálně to řešíme se supportem. Dobře, že jsme si toho všimli v klidném období. Ale například se často stává, že přístup je nastaven na základě bílé IP-listiny — a pokud server někdy na krátký čas takto bliká — může to trvat velmi dlouho, než tuto chybu odhalíme.
A ještě — pokud mluvíme o VPS hostinzích — vždy používáme cenově dostupné (hetzner, ovh, scaleway). Jak co se týče benchmarků, tak stability — velmi se nám líbí. A pro jiné projekty využíváme i výrazně dražší Amazon EC2. Takže díky okerr máme svůj opodstatněný názor. Padají — jak ti, tak oni. A neřekl bych, že během našich dlouhých pozorování levné hostinky jako hetzner byly znatelně méně stabilní než EC2. Takže, pokud nejste zvyklí na jiné funkce Amazonu — proč platit víc? 🙂
Co dál?
Pokud jsem vás v této fázi ještě příliš neodehnal od Okerr’a — vyzkoušejte to! Přímo na tomto odkazu se můžete přihlásit do (Klikněte hned teď!). Ale mějte na paměti — demoverze účtu je společná pro všechny, takže pokud něco děláte — někdo jiný v tomtéž účtu vám může v tu chvíli překážet. Nebo (lépe) se zaregistrujte přes odkaz na — všechno je jednoduché, bez SMS. Pokud nemáte rádi používání svého skutečného e-mailu — můžete použít jednorázový, třeba od mailinator’u (Doporučuji ). Takové účty mohou být po nějakém čase odstraněny — ale pro testování budou stačit.
Po registraci budete vyzváni k absolvování školení (vykonání několika nezkušených úkolů). Počáteční limity jsou velmi malé, ale pro školení nebo jeden server jsou dostatečné. Po absolvování školení — limity (například maximální počet indikátorů) budou zvýšeny.
Z dokumentace — především na serverovou část a na klienta (). Ale pokud něco není jasné — napište na support (at) okerr.com nebo zanechte tiket — pokusíme se rychle vše vyřešit.
Pokud budete používat seriózně a těch zvýšených limitů nebude dost — také, napište na support, zvýšíme je (zdarma).
Chcete nainstalovat server okerr na svůj server? Tady je . Doporučujeme instalovat na čistou virtuální mašinu, pak to půjde jednoduše udělat pomocí instalačního skriptu. Na své virtuální mašině — žádná omezení :-). No a opět — pokud by něco — vždy se budeme snažit pomoci.
Chceme, aby tento projekt vzletěl, aby se svět stal bezpečnějším díky nám. Díky bezplatnému softwaru a službám se svět stal přívětivějším a vyvíjí se dynamicky. Zdroje lze uchovávat na bezplatném GitHubu, pro e-mail lze používat bezplatný Gmail. Používáme bezplatný pro podporu. Na nic z toho není potřeba platit servery, není potřeba stahovat a nastavovat a řešit různé problémy s provozem. Každý nový projekt, každý tým — hned má e-mail, repozitáře a CRM. A to vše je vysoce kvalitní, zdarma a okamžitě. Chceme, aby pro monitorování to bylo stejné — malé firmy a projekty by mohly zdarma používat okerr a dokonce v době svého vzniku a růstu mít spolehlivost jako u vážných a velkých projektů.
Zdroj: habr.com
