

Ve zprávě Andrey Borodin ukáže, jak vzali v úvahu zkušenosti s měřítkem PgBouncer při návrhu connection pooler. , jak byl nasazen do produkčního prostředí. Dále prodiskutujeme, jaké funkce by connection pooler měl mít v nových verzích: pro nás je důležité nejen uspokojit naše potřeby, ale také rozvíjet komunitu uživatelů. .
Video:
Ahoj všichni! Jmenuji se Andrej.
V Yandexu se věnuji vývoji open source databází. A dnes máme téma o connection pooler.
Pokud víte, jak nazvat connection pooler česky, dejte mi vědět. Velmi rád bych našel dobrý technický termín, který se ustálí v technické literatuře.
Téma je poměrně složité, protože v mnoha databázích je connection pooler vestavěný a není vůbec třeba o něm vědět. Určitá nastavení samozřejmě existují, ale v Postgresu to tak nefunguje. Paralelně (na HighLoad++ 2019) běží prezentace Nikolaje Samokhvalova o nastavení dotazů v Postgresu. A já chápu, že sem přišli lidé, kteří už dotazy nastavili ideálně, a to jsou lidé, kteří čelí vzácnějším systémovým problémům, které se týkají sítě a využívání zdrojů. A místy to mohlo být docela složité v tom smyslu, že problémy nejsou zřejmé.
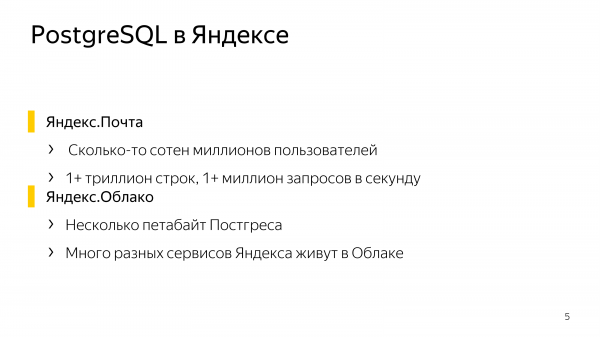
V Yandexu máme Postgres. V Yandex. Cloudu žije mnoho služeb Yandexu. A máme několik petabajtů dat, které generují ne méně než milion dotazů za sekundu v Postgresu.
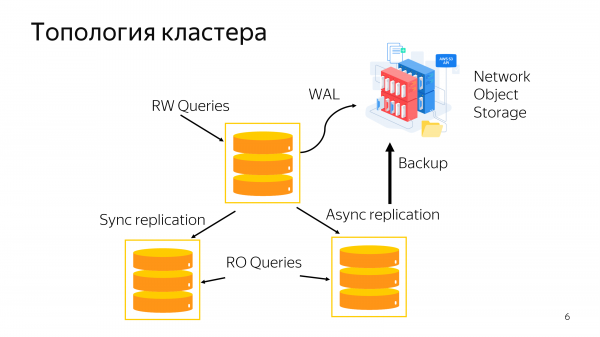
A poskytujeme dostatečně typický klastr všem službám – to je hlavní primary uzel, běžné dvě repliky (synchronní a asynchronní), zálohování, škálování čtení na replikách.
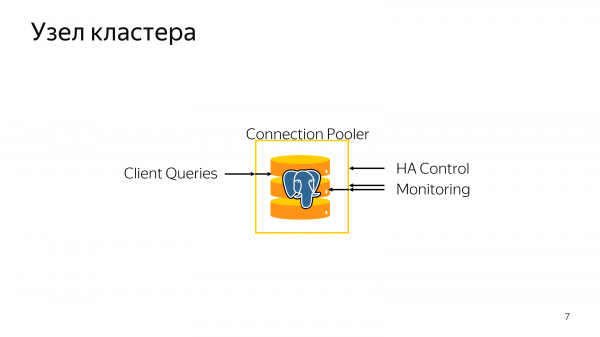
Každý uzel klastru je Postgres, na kterém vedle Postgres a systémů monitorování je ještě nainstalován connection pooler. Connection pooler se používá pro fencing a pro své hlavní určení.
Jaké je hlavní určení connection pooler?
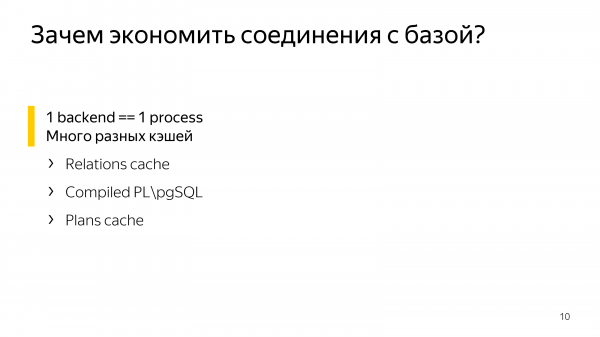
V Postgresu je přijat procesní model pro práci s databází. To znamená, že jedno spojení – to je jeden proces, jeden backend Postgres. A v tomto backendu je spousta různých cache, které je poměrně nákladné mít různé pro různá spojení.
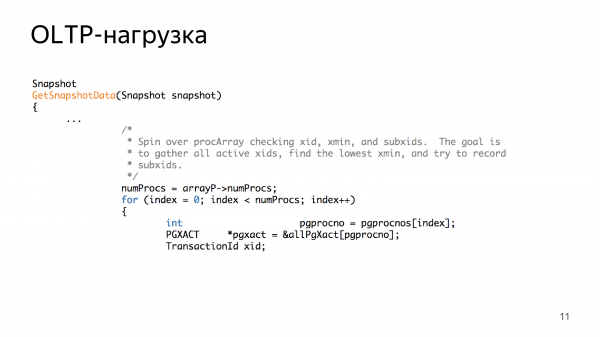
Kromě toho, v kódu Postgres existuje pole, které se nazývá procArray. Obsahuje základní informace o síťových připojeních. A téměř všechny algoritmy zpracování procArray mají lineární složitost, procházejí celým polem síťových připojení. Je to docela rychlý cyklus, ale s vysokým počtem příchozích síťových připojení se to vše stává o něco dražší. A když se to stane o něco dražší, nakonec můžete zaplatit velmi vysokou cenu za velké množství síťových připojení.
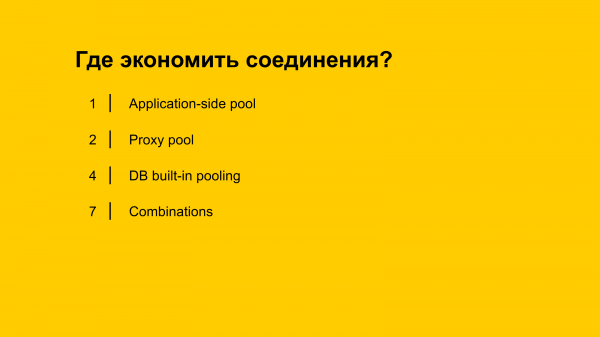
Existují 3 možné přístupy:
- Na straně aplikace.
- Na straně databáze.
- A mezi nimi, tj. různé kombinace.
Bohužel, integrovaný pooler je nyní ve vývoji. Přátelé z společnosti PostgreSQL Professional se tím většinou zabývají. Kdy se objeví, je těžké předpovědět. A vlastně máme na výběr dvě řešení. Je to pool na straně aplikace a proxy pool.
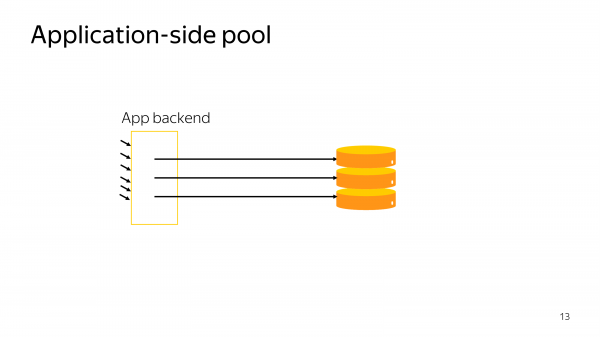
Pool na straně aplikace je nejjednodušší způsob. A téměř všechny clientské ovladače vám poskytují způsob, jak prezentovat miliony vašich připojení v kódu jako několik desítek připojení k databázi.
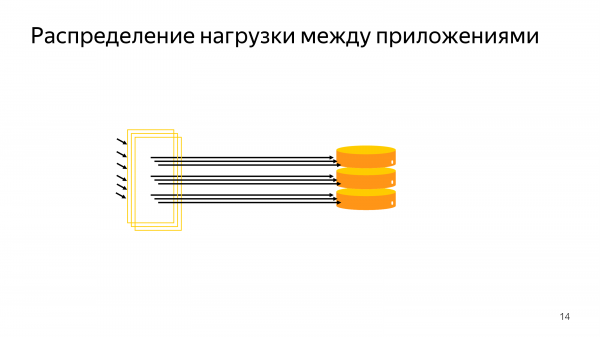
Vzniká problém, když chcete škálovat backend, chcete ho nasadit na mnoho virtuálních strojů.
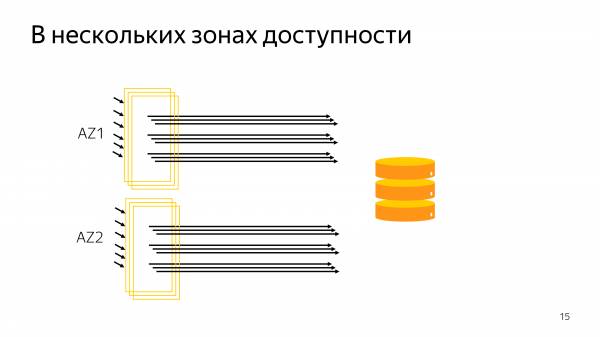
Pak si také uvědomíte, že máte několik zón dostupnosti, několik datacenter. A přístup s poolováním na straně klienta vede k velkým číslům. Velká čísla jsou okolo 10 000 připojení. To je maximum, které může fungovat normálně.
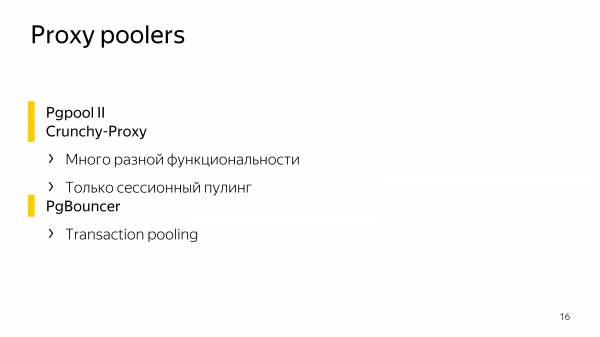
Pokud mluvíme o proxy poolerech, existují dva poolery, které umí spoustu věcí. Nejsou to jen poolery. Jsou to poolery + skvělá funkčnost. To jsou a .
Ale bohužel, tato další funkčnost není pro všechny potřeba. A vede to k tomu, že poolery podporují pouze session pooling, tj. jeden příchozí klient, jeden odchozí klient do databáze.
Pro naše úkoly to není příliš vhodné, proto používáme PgBouncer, který implementuje transaction pooling, tj. serverová spojení se mapují na klientská spojení pouze na dobu transakce.
A při naší zátěži – to je pravda. Ale existuje několik problémů..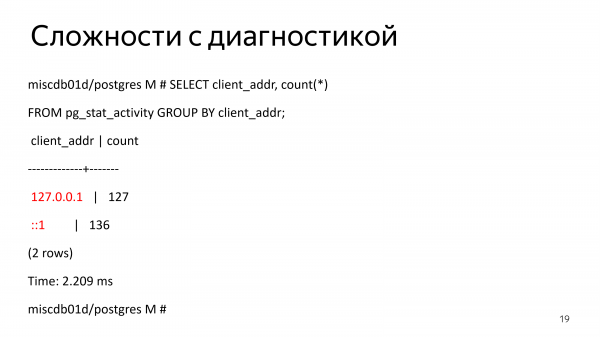
Problémy začínají, když chcete diagnostikovat relaci, protože všechna příchozí připojení jsou lokální. Všechna přišla z loopback a jaksi je obtížné sledovat relaci.
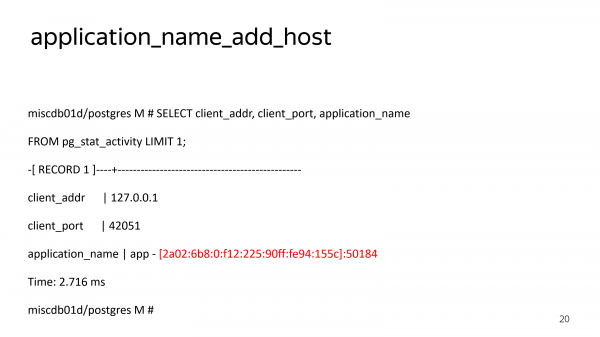
Samozřejmě, můžete použít application_name_add_host. Je to způsob na straně Bouncer, jak přidat IP adresu do application_name. Avšak application_name je nastavena dodatečným připojením.
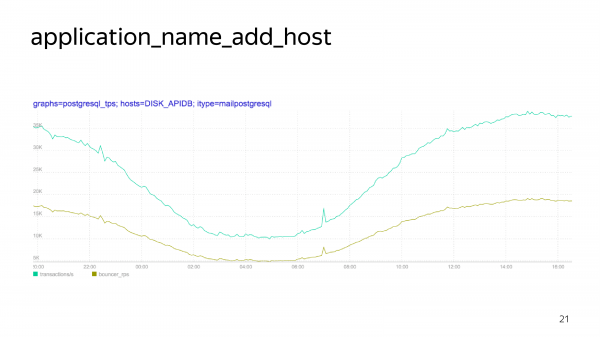
Na tomto grafu, kde žlutá čára představuje skutečné požadavky, a modrá – požadavky, které přicházejí do databáze. A tato rozdílnost – to je přesně nastavení application_name, které je potřeba pouze pro sledování, ale rozhodně není bez nákladů.
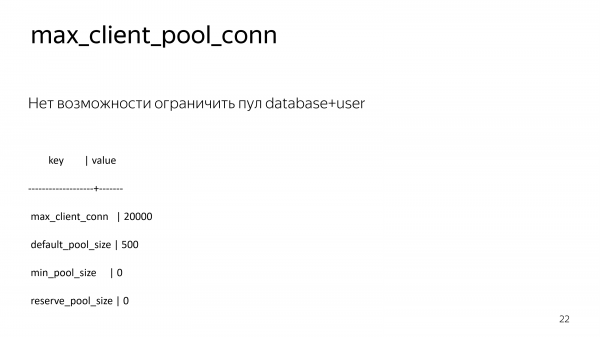
Kromě toho není možné v Bounceru omezit jeden pool, tj. počet připojení k databázi pro určitého uživatele, k určité databázi.
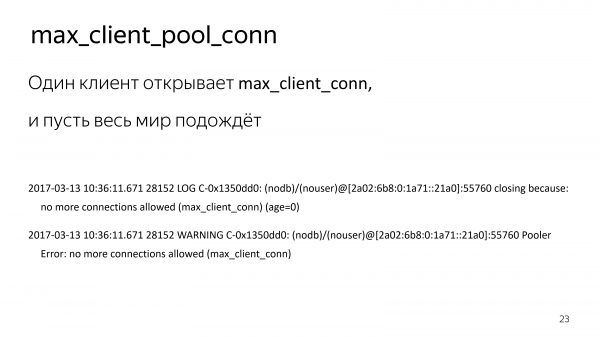
K čemu to vede? Máte přetíženou službu napsanou v C++ a někde blízko malý servis na nodu, který na databázi nedělá nic špatného, ale jeho ovladač se zblázní. Otevírá 20 000 připojení, a všechno ostatní počká. I váš kód je v pořádku.
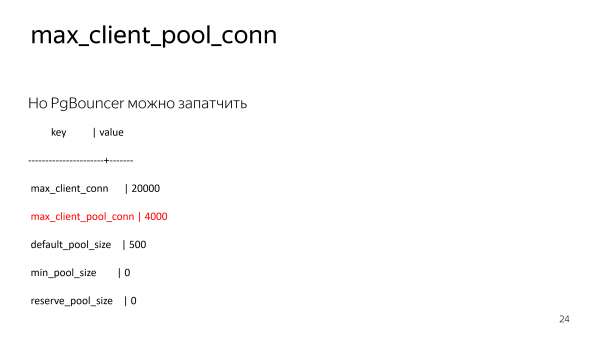
Samozřejmě jsme napsali malý patch pro Bouncer, který přidal toto nastavení, tj. omezení klientů na pool.
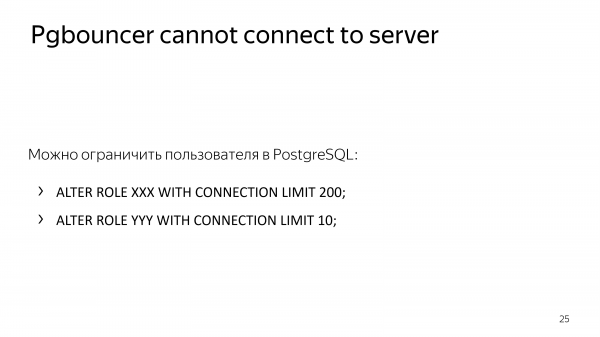
Bylo by možné to udělat na straně Postgres, tj. omezit role v databázi počtem připojení.
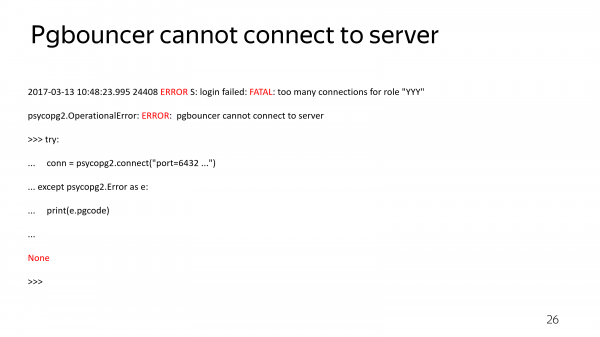
Ale pak ztrácíte možnost pochopit, proč nemáte připojení k serveru. PgBouncer nezprostředkovává chybu připojení, stále vrací stejnou informaci. A vy nemůžete zjistit: možná jste změnili heslo, možná jednoduše databáze spadla, možná je něco špatně. Ale žádná diagnostika není k dispozici. Pokud nelze navázat sezení, nezjistíte, proč to nelze udělat.
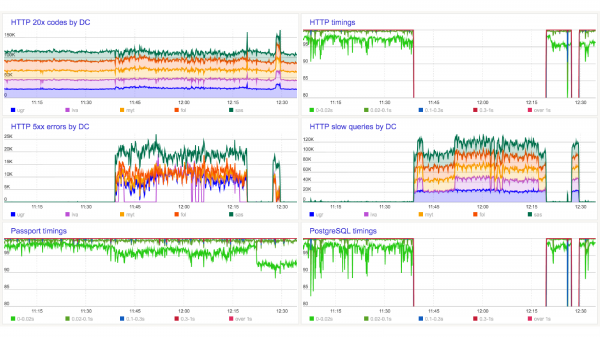
V určitém okamžiku se díváte na grafy aplikace a vidíte, že aplikace nefunguje.
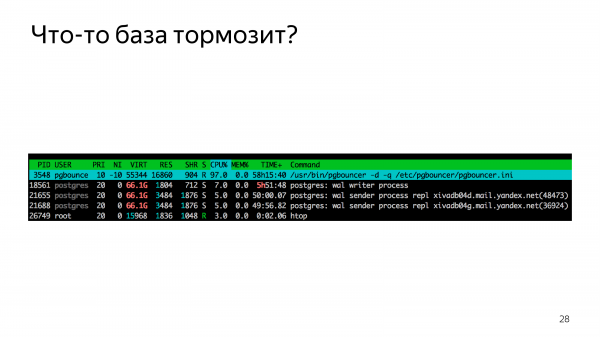
Díváte se na top a vidíte, že Bouncer je jednovláknový. To je zlomový moment v životě služby. Chápete, že jste se připravovali na škálování databáze za rok a půl, ale potřebujete škálovat pooler.
Dospěli jsme k závěru, že potřebujeme více PgBouncerů.
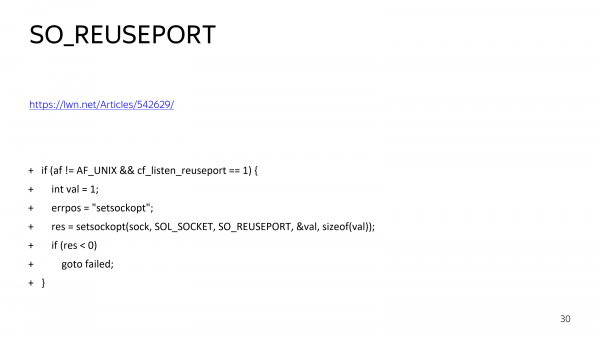
Trochu jsme patchovali Bouncer.
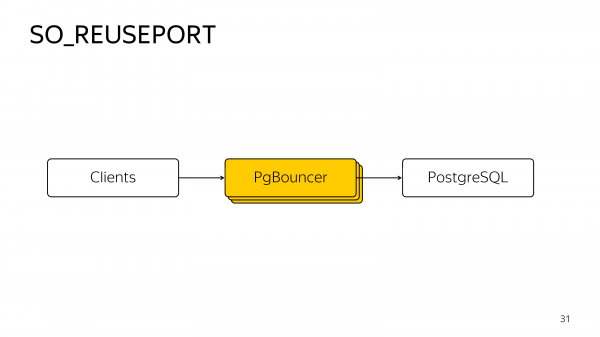
A udělali tak, že může být spuštěno několik Bouncerů s opětovným využitím TCP portu. A již operační systém automaticky rozděluje příchozí TCP připojení mezi nimi round-robin.
Je to transparentní pro klienty, tj. všechno vypadá tak, jako byste měli jednoho Bouncera, ale máte fragmentaci idle připojení mezi spuštěnými Bouncery.
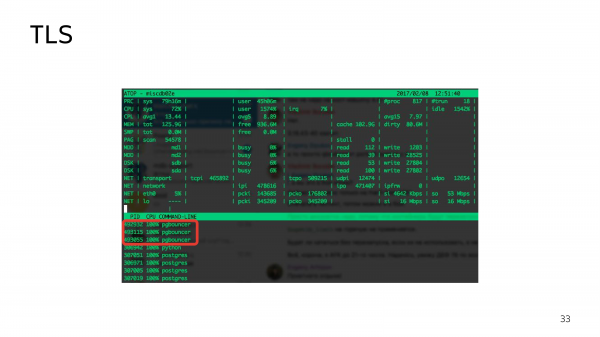
A v určitém okamžiku můžete zjistit, že těchto 3 Bouncerů využívá každé své jádro na 100 %. Potřebujete jich poměrně hodně.
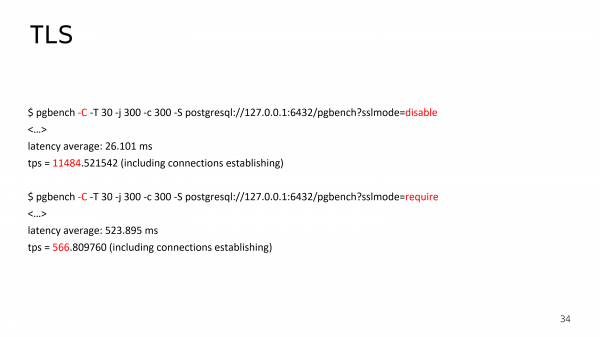
Protože máte TLS. Máte šifrované připojení. A pokud benchmarkujete Postgres s TLS a bez TLS, zjistíte, že počet navázaných připojení klesá téměř o dvě řády s aktivací šifrování, protože TLS handshake spotřebovává prostředky procesoru.
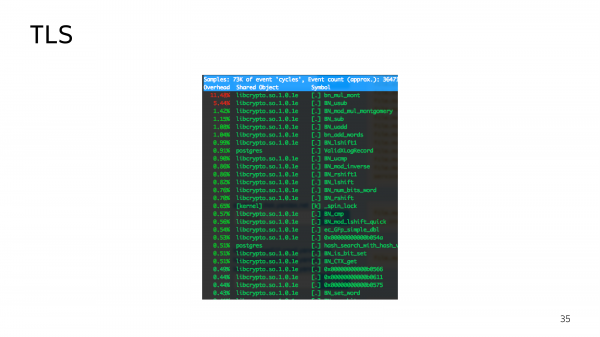
A na vrcholu můžete vidět poměrně hodně kryptografických funkcí, které se vykonávají při vlně příchozích připojení. Vzhledem k tomu, že náš primary může přepínat mezi dostupnostními zónami, je vlna příchozích připojení poměrně typická situace. To znamená, že z nějakého důvodu starý primary nebyl dostupný, a celá zátěž byla zaslána do jiného datacentra. Všichni najednou přijdou pozdravit s TLS.
A velké množství TLS handshake se může už nemít potřebu pozdravit s Bouncerem, ale může mu přitom škrtit hrdlo. Kvůli timeoutu se vlna příchozích připojení může stát nekončící. Pokud máte retry do databáze bez exponenciálního backoffu, nebudou přicházet znovu a znovu v koherentní vlně.
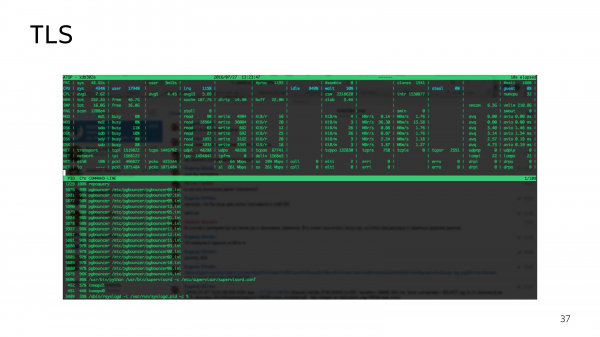
Toto je příklad 16 PgBouncerů, které zatěžují 16 jader na 100 %.
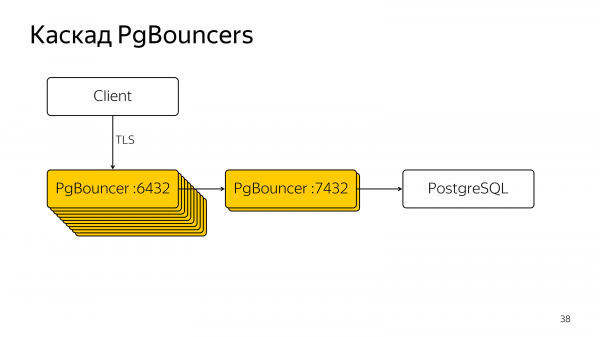
Dospěli jsme k kaskádovému PgBounceru. To je nejlepší konfigurace, kterou lze dosáhnout na naší zátěži s Bouncerem. Vnější Bouncers slouží pro TCP handshake, zatímco vnitřní Bouncers slouží pro skutečné pooling, aby se příliš netříštily vnější připojení.
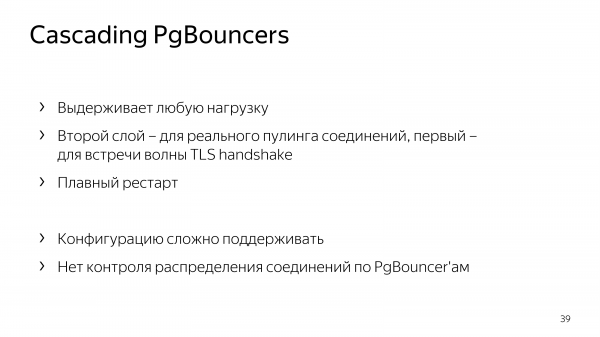
V takové konfiguraci je možný plynulý restart. Můžete restartovat všechny tyto 18 Bouncerů jedno po druhém. Ale udržování takové konfigurace je poměrně složité. Systémoví administrátoři, DevOps a lidé, kteří skutečně nesou zodpovědnost za tento server, nebudou z takové schématu příliš nadšeni.
Mohlo by se zdát, že můžeme všechny naše úpravy propagovat do open source, ale Bouncer se příliš dobře nepodporuje. Například možnost spustit několik PgBouncerů na jednom portu byla zakotvena před měsícem. A pull request s touto funkcí byl před několika lety.
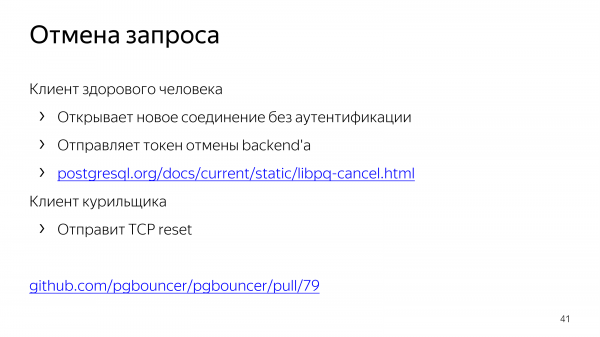
Nebo další příklad. V Postgres můžete zrušit prováděný dotaz zasláním tajného klíče přes jiné spojení bez další autentizace. Někteří klienti však posílají pouze TCP-reset, tedy přeruší síťové spojení. Co v tomto případě udělá Bouncer? Nic. Bouncer bude pokračovat v provádění dotazu. Pokud máte obrovské množství spojení, která malými dotazy zatížila databázi, jednoduše přerušení spojení s Bouncerem nebude stačit, je potřeba také ukončit ty dotazy, které běží v databázi.
Bylo to opraveno a tento problém zatím nebyl sloučen do upstreamu Bouncera.
A tak jsme dospěli k tomu, že potřebujeme svůj vlastní connection pooler, který se bude vyvíjet, patchovat, v němž budeme moci okamžitě opravovat problémy a který musí být samozřejmě vícerozměrný.
Vícevláknovost jsme si stanovili jako hlavní úkol. Musíme dobře zvládat nápor příchozích TLS spojení.
Za tímto účelem jsme museli vyvinout samostatnou knihovnu, která se jmenuje Machinarium, a která je určena k popisu strojových stavů síťového spojení jako sekvenčního kódu. Pokud se podíváte na zdrojový kód libpq, uvidíte poměrně složité volání, která vám mohou vrátit výsledek a říct: „Zavolej mě později. Teď mám I/O, ale až I/O skončí, budu mít zátěž pro procesor“. A to je víceúrovňový systém. Síťová interakce se obvykle popisuje jako strojový stav. Mnoha pravidly typu „Pokud jsem dříve obdržel hlavičku paketu velikosti N, nyní očekávám N bytů“, „Pokud jsem posílal paket SYNC, nyní očekávám paket s metadaty výsledku“. Vytváří to poměrně obtížný kontrintuitivní kód, jako kdyby byl labyrint převeden na lineární rozložení. Udělali jsme to tak, že místo strojového stavu programátor popisuje hlavní cestu interakce jako běžný imperativní kód. Jen v tomto imperativním kódu je třeba vložit místa, kde je třeba přerušit sekvenci provádění čekáním na data ze sítě, předávající kontext provádění jiné koruně (green threadu). Tento přístup je podobný tomu, že vyzdvihneme nejžádanější cestu v labyrintu a zapíšeme ji za sebou, a pak k ní přidáme odbočky.
Nakonec máme jeden proud, který provádí TCP accept a round-robin přenáší mnoho workerům TPC připojení.
Každé klientské připojení vždy pracuje na jednom procesoru. To umožňuje, aby bylo cache-friendly.
Kromě toho jsme mírně upravili shromažďování malých paketů do jednoho velkého paketu, abychom uvolnili systémový TCP stack.
Dále jsme vylepšili transakční pooling tak, že Odyssey při nastavené konfiguraci může odeslat CANCEL a ROLLBACK v případě porušení síťového připojení, t. j. pokud na žádost nikdo nečeká, Odyssey řekne databázi, aby se nesnažila provést tuto žádost, která by mohla spotřebovat cenné zdroje.
Pokud je to možné, uchováváme připojení ke stejnému klientovi. To umožňuje, abychom nepřestavovali application_name_add_host. Pokud to je možné, nemáme další přeinstalaci parametrů, které jsou potřebné pro diagnostiku.
Pracujeme v zájmu Yandex.Cloud. A pokud používáte managed PostgreSQL a máte nastavený connection pooler, můžete vytvořit logickou replikaci ven, t. j. odejít od nás, pokud budete chtít, pomocí logické replikace. Bouncer ven proud logické replikace neodevzdá.
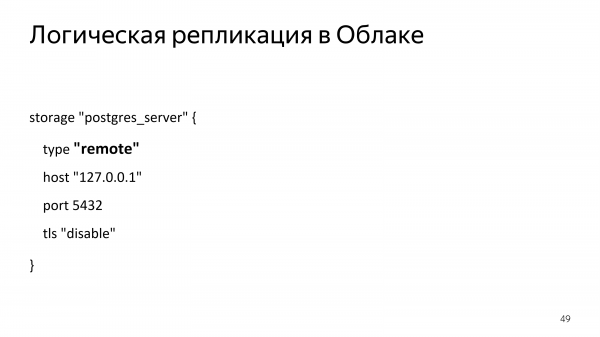
To je příklad nastavení logické replikace.
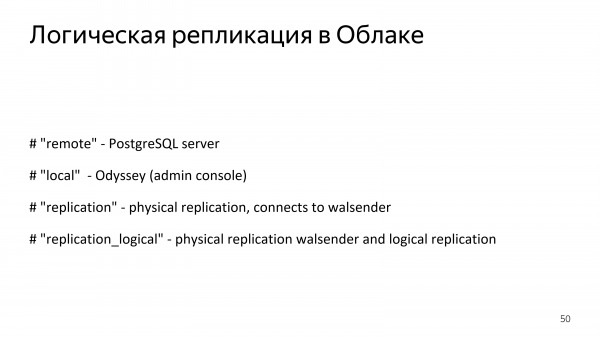
Kromě toho máme podporu fyzické replikace ven. V Cloudu je to samozřejmě nemožné, protože by vám cluster dal příliš mnoho informací o sobě. Ale ve vašich instalacích, pokud potřebujete fyzickou replikaci přes connection pooler v Odyssey, je to možné.
V Odyssey je plně kompatibilní monitoring s PgBouncer. Máme stejnou konzoli, která vykonává téměř všechny stejné příkazy. Pokud něco chybí, pošlete pull request nebo alespoň issue na GitHub, budeme doplňovat potřebné příkazy. Základní funkčnost konzole PgBouncer již máme.
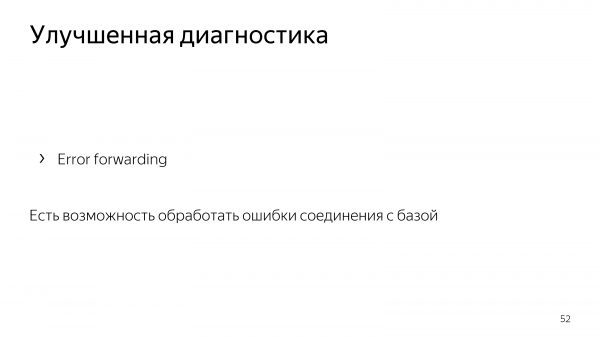
A samozřejmě máme error forwarding. Vrátíme tu chybu, kterou databáze nahlásila. Získáte informace o tom, proč se vám nedaří připojit k databázi, a ne jen to, že se vám nedaří.
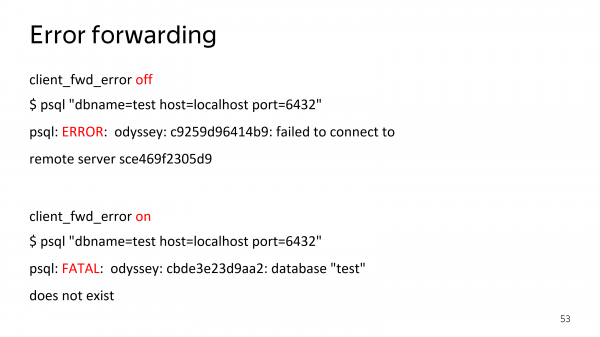
Tato funkce se vypíná v případě, že potřebujete 100% kompatibilitu s PgBouncer. Můžeme se chovat stejně jako Bouncer, jen tak pro jistotu.
Vývoj
Několik slov o zdrojovém kódu Odyssey.
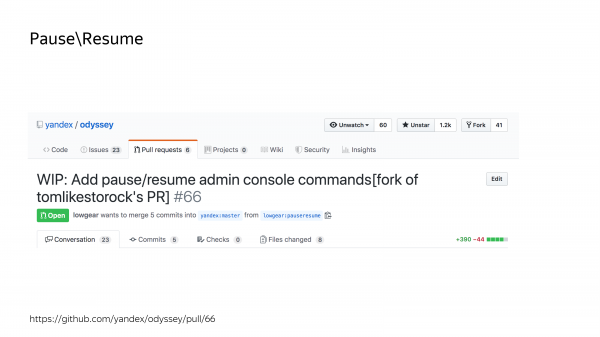
Například existují příkazy „Pozastavit / Pokračovat“. Ty se obvykle používají pro aktualizaci databáze. Pokud potřebujete aktualizovat Postgres, můžete jej pozastavit v connection pooleru, provést pg_upgrade a poté obnovit. Na straně klienta to bude vypadat tak, jako by se databáze jednoduše zpomalila. Tuto funkčnost nám přinesli lidé z komunity. Zatím ještě není sloučena, ale brzy bude. (Už sloučena)
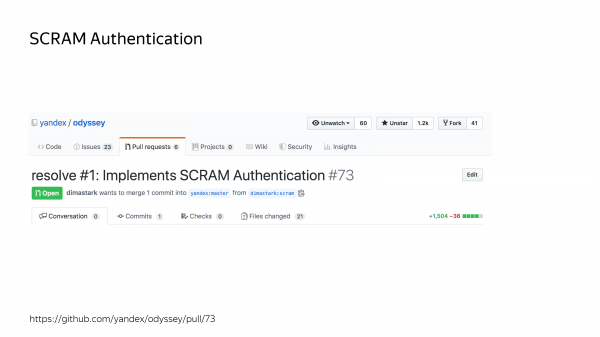
— už sloučena
Kromě toho je jednou z nových funkcí v PgBouncer podpora SCRAM Authentication, kterou nám také přinesl člověk, který nepracuje ve Yandex.Cloud. Obě funkce jsou složité a důležité.
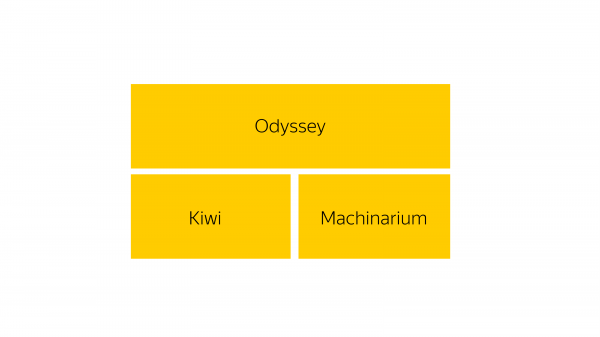
Proto bych chtěl povědět, z čeho je Odyssey vyroben, možná i vy teď chcete trochu psát kód.
Máte základní strukturu Odyssey, která se opírá o dvě hlavní knihovny. Knihovna Kiwi je implementací Postgresového protokolu zpráv. Tedy nativní proto 3 u Postgres je standardní zpráva, se kterou si frontend a backend mohou vyměňovat informace. Tyto zprávy jsou implementovány v knihovně Kiwi.
Knihovna Machinarium je knihovna pro implementaci vláken. Malý fragment tohoto Machinarium je napsán v assembleru. Ale nebojte se, je jich jen 15 řádků.
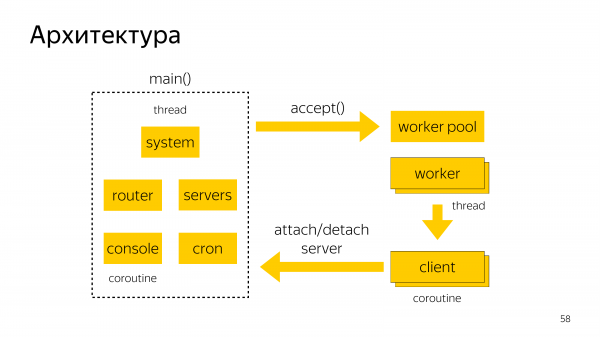
Architektura Odyssey. Existuje hlavní stroj, ve kterém jsou spuštěny coroutines. V tomto stroji se implementuje přijetí příchozích TCP spojení a jejich rozdělení mezi pracovníky.
Uvnitř jednoho pracovníka může pracovat zpracovatel několika klientů. A také v hlavním vlákně běží konzole a zpracování crone úloh pro odstranění spojení, která již nejsou potřeba v poolu.
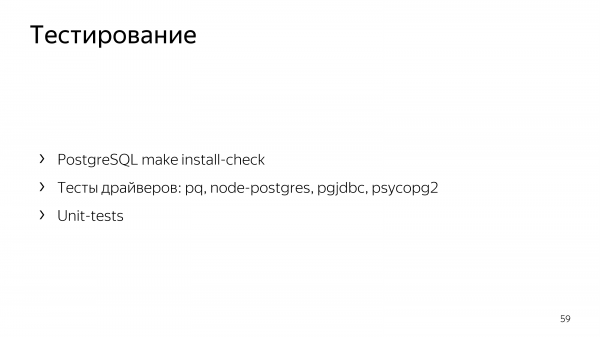
Pro testování Odyssey se používá standardní sada testů Postgres. Stačí spustit install-check přes Bouncer a přes Odyssey, a získáme nulový div. Několik testů spojených s formátováním dat neprobíhá úplně stejně v Bouncer a v Odyssey.
Kromě toho existuje mnoho ovladačů, které mají vlastní testování. A jejich testy používáme pro testování Odyssey.
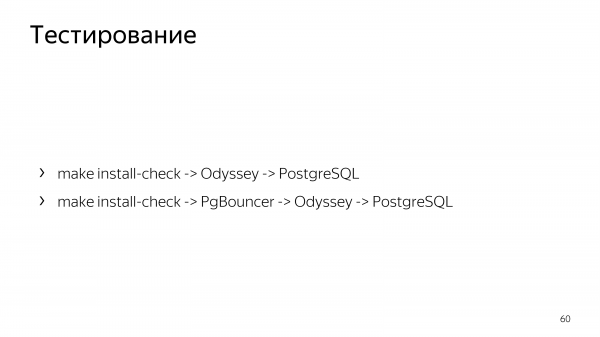
Kromě toho, kvůli naší kaskádové konfiguraci musíme testovat různé kombinace: Postgres + Odyssey, PgBouncer + Odyssey, Odyssey + Odyssey, abychom byli jisti, že pokud Odyssey skončil v nějaké části v kaskádě, funguje nadále tak, jak očekáváme.
Hřebíky
Používáme Odyssey v produkci. A nebylo by fér, kdybych řekl, že všechno prostě funguje. Ne, jako ano, ale ne vždy. Například v produkci to prostě fungovalo, pak přišli naši kamarádi z PostgreSQL Professional a řekli, že máme memory leak. Opravdu to bylo, opravili jsme to. Ale byla to prostě náhoda.
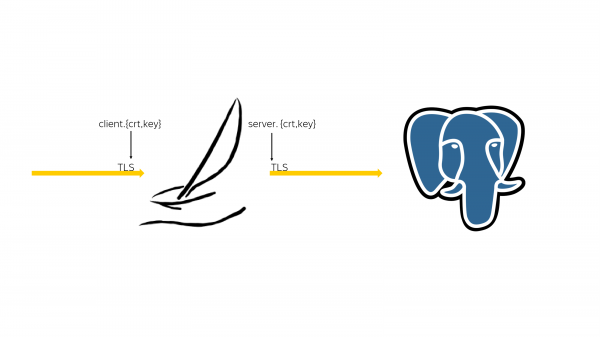
Pak jsme zjistili, že v connection pooleru jsou příchozí TLS spojení a odchozí TLS spojení. A pro ta spojení jsou potřeba klientské certifikáty a serverové certifikáty.
Serverové certifikáty Bouncer a Odyssey je čtou z pcache, ale klientské certifikáty není nutné číst z pcache, protože náš škálovatelný Odyssey nakonec naráží na systémový výkon při četbě tohoto certifikátu. Bylo to pro nás překvapení, protože nenastalo hned. Zpočátku se lineárně škáloval, ale po 20 000 příchozích souběžných připojení se tento problém projevil.
Pluggable Authentication Method je možnost autentizace vestavěnými linuxovými prostředky. V PgBouncer je to realizováno tak, že existuje samostatný thread na čekání na odpověď od PAM a je zde hlavní thread PgBouncer, který obsluhuje aktuální spojení a může je požádat, aby nějakou chvíli pobyly v threadu PAM.
Toto jsme nezrealizovali z jednoho prostého důvodu. Máme přece hodně threadů. Proč bychom to potřebovali?
V důsledku toho mohou vznikat problémy, že pokud máte PAM autentizaci a ne PAM autentizaci, pak velká vlna PAM autentizace může významně zdržovat ne PAM autentizaci. To je jedna z těch věcí, které jsme neopravili. Ale pokud to chcete opravit, můžete se o to postarat.
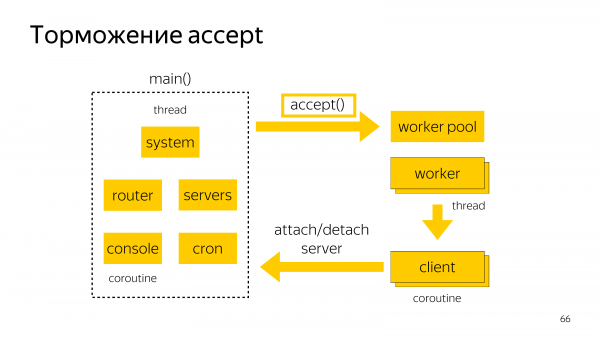
Další problém byl ten, že máme jeden thread, který přijímá všechna příchozí spojení. A poté je předává do worker poolu, kde proběhne TLS handshake.
Pokud tedy máte koherentní vlnu ze 20 000 síťových spojení, všechny budou přijaty. A na straně klienta libpq začne odpočet časových limitů. Podle defaultu tam prý je 3 sekundy.
Pokud se nemohou všechny najednou připojit k databázi, pak se nemohou připojit k databázi, protože to vše může být kryto neexponenciálním opakováním.
Dospěli jsme k tomu, že jsme zde zkopírovali schéma z PgBouncer, kde máme throttling počtu TCP spojení, kterým děláme accept.
Pokud vidíme, že akceptujeme připojení, ale nakonec nestihnou proběhnout handshake, zařazujeme je do fronty, aby nevyužívaly prostředky procesoru. To vede k tomu, že současný handshake nemusí probíhat pro všechna připojení, která přišla. Ale alespoň někdo se dostane do databáze, i když je zátěž dost vysoká.
Roadmap
Co bychom rádi viděli v budoucnu v Odyssey? Co jsme ochotni vyvíjet sami a co očekáváme od komunity?
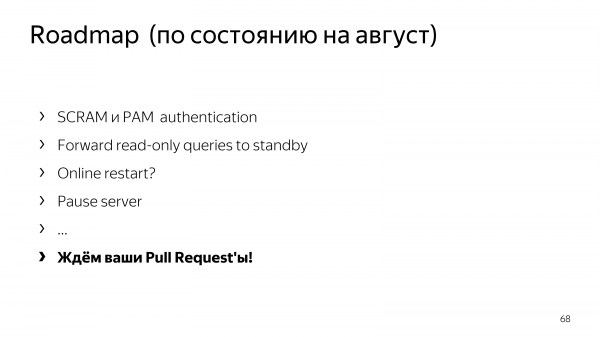
K srpnu 2019.
Takto vypadal roadmap Odyssey v srpnu:
- Chtěli jsme autentizaci SCRAM a PAM.
- Chtěli jsme směrovat čtenářské dotazy na standby.
- Rádi bychom online-restart.
- A možnost pozastavit server.
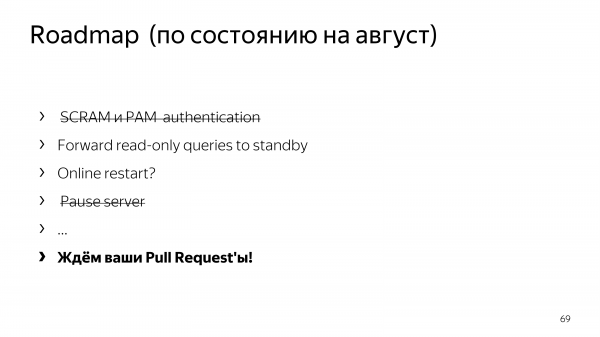
Polovina této roadmapy byla splněna, a to dokonce ne námi. A to je dobře. Takže pojďme probrat, co zbývá a přidat další.
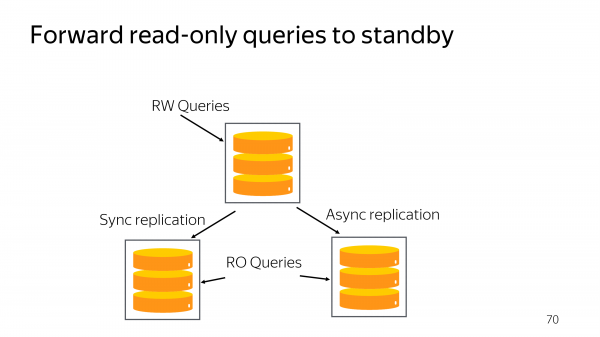
? У нас есть реплики, которые без выполнения запросов будут просто греть воздух. Они нам необходимы для обеспечения failover и switchover. В случае проблем в одном из дата-центре хотелось бы их занять какой-то полезной работой. Потому что те же самые центральные процессоры, ту же самую память мы не можем сконфигурировать по-другому, потому что иначе не будет работать репликация.
V podstatě od verze 10 v Postgres existuje možnost při připojení také uvést session_attrs. Můžete v připojení vyjmenovat všechny databázové hostitele a říci, proč jdete do databáze: zapisovat nebo pouze číst. A ovladač sám vybere prvního hostitele v seznamu, který mu vyhovuje a splňuje požadavky session_attrs.
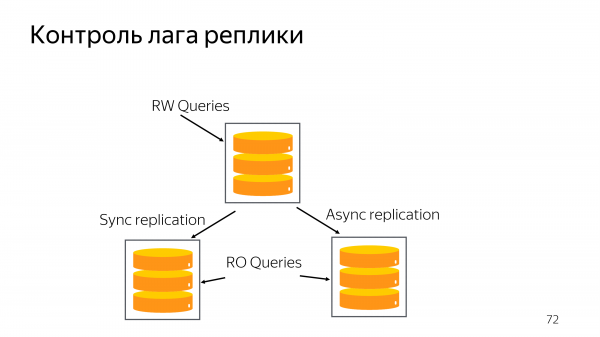
Ale problém tohoto přístupu je v tom, že neřídí zpoždění replikace. Může existovat nějaká replikace, která je zpožděna na nepřijatelně dlouhou dobu pro vaši službu. Abychom umožnili plnohodnotné provádění čtenářských dotazů na replikaci, v podstatě musíme v Odyssey podpořit, aby nefungovalo, když číst nelze.
Odyssey by měl občas jít do databáze a zjišťovat replikaci od primárního serveru. A pokud dosáhne limitu, novým dotazům do databáze by měl být zabráněno, říct klientovi, aby znovu inicioval připojení a možná zvolil jiného hostitele pro provádění dotazů. To umožní databázi rychleji obnovit zpoždění replikace a znovu se vrátit k odpovědi na dotazy.
Termíny realizace je obtížné nazvat, protože je to open source. Ale doufám, že to nebude trvat 2,5 roku jako u kolegů z PgBouncer. Tuto funkci bychom rádi viděli v Odyssey.
Nyní můžete vytvořit připravený příkaz dvěma způsoby. Za prvé, můžete provést SQL příkaz, konkrétně „prepared“. Abyste pochopili tento SQL příkaz, musíme se naučit chápat SQL na straně Bouncer. To by bylo přehnané, protože potřebujeme kompletní parser. Nemůžeme analyzovat každý SQL příkaz.
Existuje však připravený příkaz na úrovni protokolu zpráv na proto3. A to je místo, kdy informace o tom, že se vytváří připravený příkaz, přichází ve strukturovaném formátu. A mohli bychom podpořit pochopení, že na nějakém serverovém spojení klient požádal o vytvoření připravených příkazů. A i když byla transakce uzavřena, potřebujeme nadále udržovat koherenci serveru a klienta.
Ale zde se objevuje rozpor v dialogu, protože někdo říká, že je třeba chápat, který konkrétní připravený příkaz vytvořil klient a oddělit serverové spojení mezi všemi klienty, kteří toto serverové spojení vytvořili, tj. kteří vytvořili takový připravený příkaz.
Andres Freund řekl, že pokud k vám přišel klient, který již vytvořil takový připravený příkaz v jiném serverovém spojení, vytvořte ho za něj. Ale zdá se, že je trochu špatné provádět dotazy v databázi místo klienta, ale z pohledu vývojáře, který píše protokol pro interakci s databází, by bylo pohodlné, kdyby mu prostě dali síťové spojení, ve kterém je takový připravený dotaz.
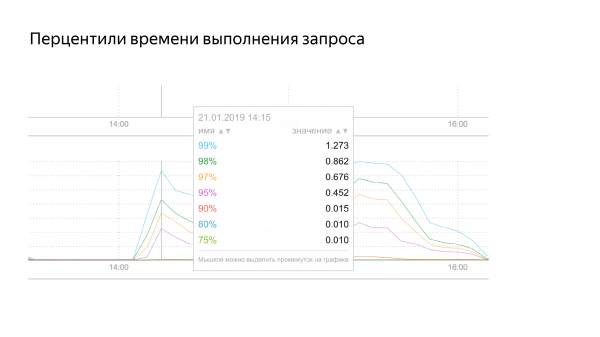
A ještě jedna funkce, kterou musíme implementovat. Nyní máme monitorování kompatibilní s PgBouncer. Můžeme vrátit průměrnou dobu trvání dotazu. Ale průměrná doba je průměrná teplota v nemocnici: někdo je studený, někdo teplý – průměrně jsou všichni zdraví. To není pravda.
Musíme implementovat podporu percentilů, které by naznačovaly, že existují pomalé dotazy, které spotřebovávají zdroje, a udělaly by monitorování přijatelnějším.
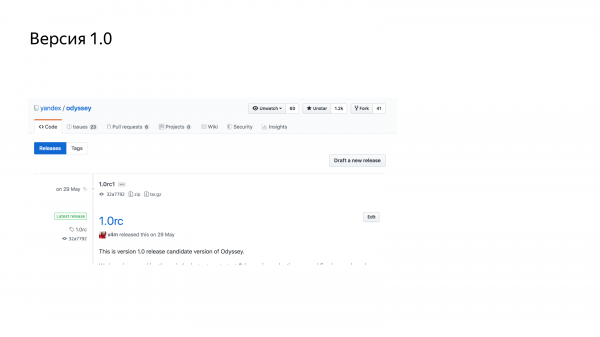
Nejdůležitější je, že chci verzi 1.0 (už byla vydána verze 1.1). Faktem je, že nyní je Odyssey ve verzi 1.0rc, tj. release candidate. A všechna úskalí, která jsem vyjmenoval, byla opravena právě s touto verzí, kromě úniku paměti.
Co pro nás bude znamenat verze 1.0? Spouštíme Odyssey na našich serverech. Již teď funguje na našich základech, ale když dosáhne bodu 1 000 000 dotazů za sekundu, můžeme říct, že to je konečná verze a tuto verzi můžeme nazvat 1.0.
V komunitě několik lidí požádalo, aby ve verzi 1.0 byla také pauza a SCRAM. To by však znamenalo, že budeme muset uvést do produkce již další verzi, protože ani SCRAM, ani pauza zatím nebyly začleněny. Ale pravděpodobně tento problém bude vyřešen dost rychle.
Čekám na vaše pull requesty. A také bych rád slyšel, jaké máte problémy s Bouncerem. Pojďme je prodiskutovat. Možná budeme moci implementovat nějaké funkce, které potřebujete.
Na tomto skončila má část, rád bych vás slyšel. Děkuji!
Otázky
Pokud nastavím svůj application_name, bude správně přenášen, včetně transaction pooling v Odyssey?
V Odyssey nebo v Bounceru?
V Odyssey. V Bounceru se přenáší.
Sestavu vytvoříme.
A pokud se moje skutečné připojení bude skákat mezi jinými připojeními, bude přenášeno?
Vytvoříme sadu všech parametrů, které jsou uvedeny v seznamu. Nemohu říct, zda je application_name v tomto seznamu. Myslím, že jsem ho tam viděl. Nastavíme všechny stejné parametry. Jedním dotazem tam set udělá vše, co bylo nastaveno klientem při spuštění.
Děkuji, Andreji, za prezentaci! Dobrá prezentace! Jsem rád, že Odyssey se každou minutou vyvíjí rychleji a rychleji. Přeji, abyste pokračovali. Již jsme vás kontaktovali s žádostí o multi data-source připojení, aby se Odyssey mohl připojit současně k různým databázím, t. j. master slave, a poté se automaticky po failoveru připojit k novému masteru.
Ano, zdá se, že si pamatuji tuto diskusi. Nyní je několik úložišť. Ale přepínání mezi nimi není. Musíme na své straně dotazovat server, zda je ještě živý a pochopit, že došlo k failoveru, kdo zavolá pg_recovery. Mám standardní způsob, jak pochopit, že jsme přišli na ne master. A jak to máme pochopit z chyb, nebo jak? T. j. myšlenka je zajímavá, diskutuje se o ní. Pište více komentářů. Pokud máte pracovní ruce, které znají C, je to vůbec skvělé.
Otázka měřítka replik nás také zajímá, protože chceme, aby přijetí replikovaných clusterů bylo pro vývojáře aplikací co nejjednodušší. Ale chtěli bychom více komentářů, tj. jak přesně to udělat, jak to udělat dobře.
Otázka také ohledně replik. Měli byste mít master a několik replik. A je jasné, že do replik se připojují méně často než k masteru, protože se mohou lišit. Říkali jste, že rozdíl v datech může být takový, že nebude vyhovovat vašemu podnikání a nebudete tam přistupovat, dokud se znovu neproreplikují. Přičemž, pokud jste k nim dlouho nepřistupovali a pak začali, tak ta data, která potřebujete, nebudou dostupná hned. To znamená, že pokud neustále používáme master, tak tam je cache vyhřátá, zatímco v replikaci je cache trochu pozadu.
Ano, je to pravda. V pcache nebudou bloky dat, které chcete, v real cache nebude informace o tabulkách, které chcete, v plánech nebudou rozparsované dotazy, vůbec nic tam nebude.
A když máte nějaký cluster a přidáte do něj novou replikaci, tak dokud se nespustí, bude to v ní špatné, tj. buduje si svou cache.
Pochopil jsem myšlenku. Správným přístupem by bylo spustit malý procento dotazů prvně na replikaci, které by vyhřály cache. Řekněme, že máme podmínku, že bychom se měli opozdit maximálně o 10 sekund za masterem. A tuto podmínku aktivovat ne jednou, ale plynule pro některé klienty.
Ano, zvyšovat váhu.
To je dobrý nápad. Ale nejprve je potřeba implementovat to vypnutí. Nejprve se musíme odpojit a pak přemýšlet, jak se připojit. Je to skvělá funkce pro plynulé připojení.
V nginx je taková možnost pomalu začít v clusteru pro server. A postupně zvyšuje zátěž.
Ano, skvělý nápad, vyzkoušíme to, až se k tomu dostaneme.
Zdroj: habr.com
