

Úvod do operačních systémů
Ahoj, Habr! Rád bych vám představil sérii článků-překladů jedné zajímavé literatury, kterou považuji za hodnotnou — OSTEP. Tento materiál se hlouběji zabývá prací unixových operačních systémů, konkrétně prací s procesy, různými plánovači, pamětí a dalšími komponentami, které tvoří moderní OS. Originál všech materiálů můžete vidět tady . Upozorňuji, že překlad byl proveden neprofesionálně (poměrně volně), ale doufám, že jsem zachoval celkový smysl.
Laboratorní práce k tomuto předmětu najdete zde:
Další části:
A můžete také nahlédnout na můj kanál na =)
Úvod do plánovače
Podstata problému: Jak vyvinout politiku plánovače
Jak by se měly vyvíjet základní rámce politik plánovače? Jaké by měly být klíčové předpoklady? Jaké metriky jsou důležité? Jaké základní techniky byly použity v raných výpočetních systémech?
Předpoklady pracovní zátěže
Než začneme diskutovat o možných politikách, udělejme si několik zjednodušujících odboček o procesech spuštěných v systému, které společně nazýváme pracovní zátěží. Určení pracovní zátěže je kritickou částí vytváření politik, a čím více víte o zátěži, tím kvalitnější politiku budete schopni napsat.
Uděláme následující předpoklady o procesech spuštěných v systému, které jsou také někdy nazývány jobs (úkoly). Všechny tyto předpoklady jsou prakticky nerealistické, ale jsou potřebné pro rozvoj myšlenky.
- Každý úkol je spuštěn stejnou dobu,
- Všechny úkoly jsou zadány současně,
- Zadaný úkol běží až do svého dokončení,
- Všechny úkoly používají pouze CPU,
- Doba běhu každého úkolu je známa.
Metriky plánovače
Kromě určitých předpokladů o zátěži je také nutný nástroj pro porovnání různých plánovacích politik: metriky plánovače. Metrika je jen nějaká míra něčeho. Existuje určité množství metrik, které lze použít pro porovnání plánovačů.
Jako příklad použijeme metriku, která se nazývá čas obratu (turnaround time). Čas obratu úkolu je definován jako rozdíl mezi časem dokončení úkolu a časem příchodu úkolu do systému.
Tturnaround=Tcompletion−Tarrival
Jelikož jsme předpokládali, že všechny úkoly přišly ve stejnou dobu, Ta=0 a tím pádem Tt=Tc. Tato hodnota se samozřejmě změní, když změníme výše uvedené předpoklady.
Další metrikou je fairness (spravedlnost). Výkon a spravedlnost jsou často protichůdné vlastnosti v plánování. Například plánovač může optimalizovat výkon, ale na úkor čekání na spuštění jinými úkoly, čímž se snižuje spravedlnost.
FIRST IN FIRST OUT (FIFO)
Nejdůležitější algoritmus, který můžeme implementovat, se nazývá FIFO nebo first come (in), first served (out)Tento algoritmus má několik výhod: je velmi jednoduchý na implementaci a vyhovuje všem našim předpokladům, přičemž vykonává práci docela dobře.
Zvažme jednoduchý příklad. Předpokládejme, že byly současně zadány 3 úkoly. Ale předpokládejme, že úkol A přišel o něco dříve než ostatní, takže v seznamu vykonávání bude dříve než ostatní, stejně jako B vzhledem k V. Předpokládejme, že každý z nich bude prováděn 10 sekund. Jaký bude průměrný čas vykonávání těchto úkolů?
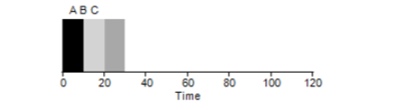
Po sečtení hodnot — 10+20+30 a jejich dělení třemi, získáme průměrný čas vykonávání programu roven 20 sekundám.
Nyní se pokusíme změnit naše předpoklady. Konkrétně předpoklad 1, a tím pádem nebudeme více předpokládat, že každý úkol se vykonává stejnou dobu. Jak se v tomto případě osvědčí FIFO?
Jak se ukazuje, různá doba vykonávání úkolů má velmi negativní vliv na produktivitu algoritmu FIFO. Předpokládejme, že úkol A bude vykonáván 100 sekund, zatímco B a V stále po 10 každá.
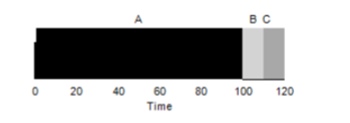
Jak je vidět z obrázku, průměrný čas pro systém bude (100+110+120) / 3 = 110. Tento efekt se nazývá efekt konvoje, kdy někteří krátkodobí spotřebitelé nějakého zdroje čekají v řadě za těžkým spotřebitelem. Je to podobné jako fronta v obchodě, kdy před vámi stojí zákazník s plným vozíkem. Nejlepší řešení problému je pokusit se změnit pokladnu nebo si prostě odpočinout a zhluboka dýchat.
Nejkratší úkol první
Může se nějak vyřešit podobná situace s těžkými procesy? Samozřejmě. Jiný typ plánování se nazýváNejkratší úkol první (SJF). Jeho algoritmus je také dost primitivní — jak napovídá název, nejprve budou spuštěny nejkratší úkoly jeden za druhým.
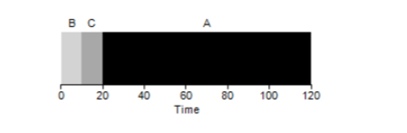
V tomto příkladu bude výsledkem spuštění těchto stejných procesů zlepšení průměrného obratu programů a bude rovno 50 místo 110, což je prakticky dvakrát lepší.
Takže za předpokladu, že všechny úkoly přicházejí ve stejnou dobu, se algoritmus SJF jeví jako nejoptimálnější. Naše předpoklady se však stále nezdají realistické. Tentokrát změníme předpoklad 2 a představíme si, že úkoly mohou přicházet kdykoliv, nikoli všechny najednou. K jakým problémům to může vést?
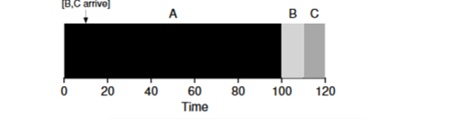
Představme si, že úkol A (100s) přichází jako první a začíná se vykonávat. V okamžiku t=10 přicházejí úkoly B a C, z nichž každý trvá 10 sekund. Průměrný čas provádění tedy bude (100+(110-10)+(120-10))/3 = 103. Co by plánovač mohl udělat, aby zlepšil situaci?
Shortest Time-to-Completion First (STCF)
Abychom zlepšili situaci, opustíme předpoklad 3, že program je spuštěn a běží až do dokončení. Dále budeme potřebovat podporu hardware a, jak jste možná uhádli, budeme používat časovač k přerušení běžícího úkolu a přepínání kontextů. Takže plánovač může něco udělat v okamžiku příchodu úkolů B a C — přerušit vykonávání úkolu A a zahájit zpracování úkolů B a C, a po jejich dokončení pokračovat ve vykonávání procesu A. Takový plánovač se nazývá STCFnebo Preemptive Job First.
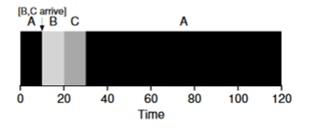
Výsledkem práce tohoto plánovače bude následující výsledek: ((120-0)+(20-10)+(30-10))/3=50. Takový plánovač se tedy stává ještě optimalnějším pro naše úkoly.
Metrika Doba odezvy (Response Time)
Jakmile známe dobu běhu úkolů a víme, že tyto úkoly používají pouze CPU, bude STCF nejlepším řešením. V dřívějších obdobích tyto algoritmy fungovaly a celkem dobře. Avšak nyní uživatel tráví většinu času u terminálu a očekává produktivní interaktivní interakci. Tak se zrodila nová metrika — doba odezvy (reakce).
Doba odezvy se počítá následujícím způsobem:
Tresponse=Tfirstrun−Tarrival
Takže pro předchozí příklad bude doba odezvy následující: A=0, B=0, C=10 (abg=3,33).
A zjistit, že algoritmus STCF vůbec není dobrý v situaci, kdy tři úkoly dorazí najednou — bude se muset počkat, dokud se malé úkoly zcela nedokončí. Tím pádem je algoritmus dobrý pro měření doby obratu, ale špatný pro měření interaktivity. Představte si, že sedíte u terminálu a snažíte se napsat znaky v editoru, ale musíte čekat více než 10 sekund, protože nějaký jiný úkol zabírá procesor. To není zrovna příjemné.
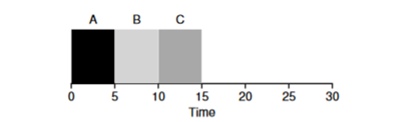
Tím pádem se setkáváme s jiným problémem — jak můžeme postavit plánovač, který by byl citlivý na dobu odezvy?
Round Robin
Pro vyřešení tohoto problému byl vyvinut algoritmus Round Robin (RR). Hlavní myšlenka je docela jednoduchá: místo běhu úkolů až do jejich úplného dokončení budeme spouštět úkol na určitý časový úsek (nazývaný časový kvant) a pak přejdeme na jiný úkol z fronty. Algoritmus opakuje svou práci, dokud všechny úkoly nejsou dokončeny. Přitom doba běhu programu by měla být násobkem doby, po které časovač přeruší proces. Například, pokud časovač přeruší proces každých x=10ms, pak velikost okna provádění procesu musí být násobkem 10 a být 10, 20 nebo x*10.
Zvažme příklad: Úkoly A, B a C dorazí současně do systému a každý z nich chce pracovat 5 sekund. Algoritmus SJF provede každý úkol do konce, než spustí jiný. Na rozdíl od toho algoritmus RR s oknem spuštění=1s projde úkoly následujícím způsobem (obr. 4.3):
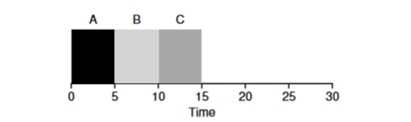
(SJF Opět (Špatné pro Čas Odezvy)
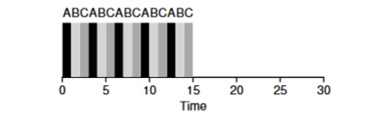
(Round Robin (Dobré pro Čas Odezvy)
Průměrná doba odezvy pro algoritmus RR (0+1+2) / 3 = 1, zatímco pro SJF (0+5+10) / 3 = 5.
Je logické předpokládat, že časové okno je pro RR velmi důležitý parametr, čím menší je, tím vyšší je doba odezvy. Avšak není možné jej také udělat příliš malým, protože čas potřebný na přepínání kontextu hraje rovněž svou roli v celkovém výkonu. Výběr doby provádění tedy určuje architekt OS a závisí na úlohách, které se v ní plánují vykonávat. Přepínání kontextu není jediná servisní operace, která spotřebovává čas — spuštěný program operuje s mnoha dalšími faktory, jako jsou různé cache, a při každém přepínání je nutné tuto prostředí uložit a obnovit, což také může vyžadovat hodně času.
RR je skvělý plánovač, pokud by šlo pouze o metriku doby odezvy. Ale jak se zachová metrika doby obratu úkolu v tomto algoritmu? Zvažme výše uvedený příklad, kdy doba práce A, B, C = 5s a přicházejí ve stejném čase. Úkol A se dokončí v 13, B v 14, C v 15s a průměrná doba obratu bude 14s. Tím pádem je RR nejhorší algoritmus pro metriku obratu.
Obecně řečeno, každý algoritmus typu RR je spravedlivý, rozděluje čas běhu na CPU rovnoměrně mezi všechny procesy. A tímto způsobem si tyto metriky neustále protiřečí.
Máme tedy několik protikladných algoritmů a stále zbývá několik předpokladů — že doba úkolu je známa a že úkol používá pouze CPU.
Smíchání s I/O
V první řadě se zbavíme předpokladu 4, že proces používá pouze CPU, což samozřejmě není pravda, procesy mohou přistupovat i k jinému hardwaru.
V okamžiku, kdy jakýkoli proces požaduje operaci vstupu-výstupu, se proces dostává do stavu blocked, čekajíc na dokončení I/O. Pokud je I/O zasíláno na pevný disk, taková operace může trvat až několik milisekund nebo déle, a procesor v tuto chvíli zůstane nečinný. V tuto chvíli může plánovač zabrat procesor jakýmkoli jiným procesem. Další rozhodnutí, které musí plánovač učinit, je, kdy proces dokončí svůj I/O. Když k tomu dojde, dojde k přerušení a OS převede proces, který spustil I/O, do stavu ready.
Pojďme se podívat na příklad několika úloh. Každá z nich potřebuje 50 ms procesorového času. První úloha se však každých 10 ms obrací na I/O (které se také vykonává po 10 ms). Proces B jednoduše používá 50 ms procesor bez I/O.
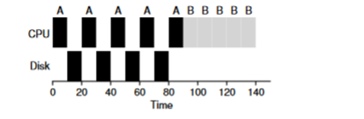
V tomto příkladu použijeme plánovač STCF. Jak se zachová plánovač, pokud na něm spustíme proces A? Postupuje následovně - nejprve zcela zpracuje proces A a poté proces B.
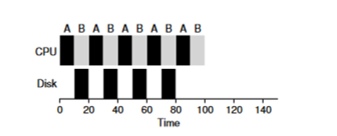
Tradiční přístup k řešení tohoto problému je interpretovat každou 10-ms podúlohu procesu A jako samostatný úkol. Tímto způsobem, při spuštění s algoritmem STJF, je výběr mezi 50-ms úlohou a 10-ms úlohou zřejmý. Poté, co se podúloha A dokončí, se spustí proces B a I/O. Po dokončení I/O se rozhodne znovu spustit 10-ms proces A místo procesu B. Takto je možné realizovat překrytí, kdy je CPU používán jiným procesem, zatímco první čeká na I/O. A jako výsledek je systém lépe využíván - v okamžiku, kdy interaktivní procesy čekají na I/O, mohou se na procesoru vykonávat i jiné procesy.
Oracle už neexistuje.
Teď se pokusíme zbavit předpokladu, že doba běhu úloh je známa. To je vcelku nejhorší a nerealistický předpoklad ze seznamu. Ve skutečnosti průměrné běžné operační systémy samotné velmi málo vědí o době vykonání úkolů, jak bychom tedy mohli vytvořit plánovač bez znalosti toho, kolik času úloha bude potřebovat? Možná bychom mohli použít některé principy RR k řešení tohoto problému?
Výsledek
Prozkoumali jsme základní myšlenky plánování úloh a zkoumali jsme 2 rodiny plánovačů. První spouští nejkratší úlohu na začátku, čímž zvyšuje doby oběhu; druhý se přerušuje mezi všemi úlohami rovnoměrně, čímž zvyšuje dobu odezvy. Oba algoritmy jsou špatné tam, kde jsou dobré algoritmy jiné rodiny. Také jsme zkoumali, jak paralelní použití CPU a I/O mohou zlepšit výkon, ale nevyřešili jsme problém s prorockým viděním OS. Na následující lekci prozkoumáme plánovač, který se dívá do blízké minulosti a snaží se předpovědět budoucnost. Nazývá se multi-level feedback queue.
Zdroj: habr.com
