

Mikroslužbová architektura, stejně jako cokoliv jiného na tomto světě, má své výhody a nevýhody. Některé procesy se s ní zjednodušují, jiné se naopak komplikuje. A ve prospěch rychlosti změn a lepší škálovatelnosti je nutné přinášet oběti. Jednou z nich je složitost analytiky. Pokud lze v monolitu veškerou operativní analytiku redukovat na SQL dotazy na analytickou replikaci, pak v multi-službové architektuře má každá služba svou databázi a zdá se, že jedním dotazem se to nezvládne (ale možná to zvládne?). Pro ty, kteří se zajímají, jak jsme vyřešili problém operativní analytiky ve naší společnosti a jak jsme se naučili žít s tímto řešením — vítejte.
Jmenuji se Pavel Sivaš, v DomClicku pracuji v týmu, který se stará o údržbu analytického datového skladu. Naše činnost lze podmíněně zařadit do oblasti datového inženýrství, ale ve skutečnosti je spektrum úkolů mnohem širší. Existují standardní úkoly pro datové inženýrství ETL/ELT, podpora a přizpůsobení nástrojů pro analýzu dat a vývoj vlastních nástrojů. Konkrétně pro operativní reportování jsme se rozhodli „předstírat“, že máme monolit a poskytnout analytikům jednu databázi, v níž budou všechna potřebná data.
Ve skutečnosti jsme zvažovali různé možnosti. Mohli jsme vybudovat plnohodnotné úložiště — dokonce jsme to zkusili, ale upřímně řečeno, nedokázali jsme sladit dost časté změny v logice s dost pomalým procesem budování úložiště a prováděním změn (pokud se to někomu podařilo, napište do komentářů, jak). Mohli jsme říct analytikům: „Chlapci, učte se Python a přejděte do analytických replik“, ale to by znamenalo další požadavek na výběr personálu, a zdálo se, že se tomu chceme vyhnout, pokud to jde. Rozhodli jsme se vyzkoušet technologii FDW (Foreign Data Wrapper): to je v podstatě standardní dblink, který existuje ve standardu SQL, ale s mnohem přívětivějším rozhraním. Na jeho základě jsme vytvořili řešení, které se nakonec uchytilo, na němž jsme se zastavili. Jeho podrobnosti jsou tématem samostatného článku, možná i několika, protože je toho spousta, co bychom chtěli říct: od synchronizace schémat databází po správu přístupů a anonymizaci osobních údajů. Také je třeba uvést, že toto řešení nenahrazuje skutečné analytické databáze a úložiště, ale řeší pouze konkrétní úkol.
Na úrovni příběhu to vypadá takto:
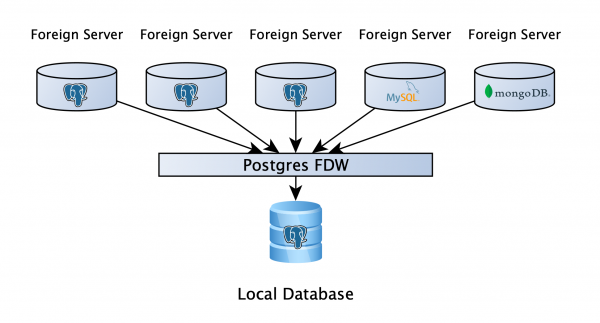
Existuje databáze PostgreSQL, kde si uživatelé mohou ukládat svá pracovní data, a co je nejdůležitější — k této databázi je prostřednictvím FDW připojeno analytické replikace všech služeb. To umožňuje napsat dotaz na několik databází, bez ohledu na to, zda jde o PostgreSQL, MySQL, MongoDB nebo něco jiného (soubor, API, pokud náhodou neexistuje vhodný wrapper, můžete napsat svůj). No, vypadá to, že je všechno super! Tak se rozejdeme?
Kdyby vše končilo tak rychle a jednoduše, pravděpodobně by tento článek ani neexistoval.
Je důležité jasně chápat, jak Postgres zpracovává dotazy na vzdálené servery. To se může zdát logické, přesto si toho lidé často nevšimnou: Postgres dělí dotaz na části, které jsou vykonávány na vzdálených serverech nezávisle, shromažďuje tato data a konečné výpočty provádí sám, takže rychlost provádění dotazu bude zásadně záviset na tom, jak je napsán. Je také třeba zdůraznit: když data přicházejí z vzdáleného serveru, již nemají indexy, nic, co by pomohlo plánovači, proto mu můžeme pomoci a poradit pouze my sami. A právě o tom bych chtěl mluvit podrobněji.
Jednoduchý dotaz a plán s ním
Abychom ukázali, jak PostgreSQL provádí dotaz na tabulku o 6 milionech řádků na vzdáleném serveru, podívejme se na jednoduchý plán.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table;

Aggregate  (cost=418383.23..418383.24 rows=1 width=8) (actual time=3857.198..3857.198 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.00..402376.14 rows=6402838 width=0) (actual time=4.874..3256.511 rows=6406868 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Remote SQL: SELECT NULL FROM fdw_schema.table
Planning time: 0.986 ms
Execution time: 3857.436 ms
Použití příkazu VERBOSE umožňuje vidět dotaz, který bude odeslán na vzdálený server, a výsledky, které obdržíme pro další zpracování (řádek RemoteSQL).
Pojďme o krok dál a přidáme do našeho dotazu několik filtrů: jeden podle boolean pole, jeden podle výskytu timestamp v intervalu a jeden podle jsonb.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active is True
AND created_dt BETWEEN CURRENT_DATE - INTERVAL '7 month'
AND CURRENT_DATE - INTERVAL '6 month'
AND meta->>'source' = 'test';

Aggregate  (cost=577487.69..577487.70 rows=1 width=8) (actual time=27473.818..25473.819 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.00..577469.21 rows=7390 width=0) (actual time=31.369..25372.466 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filter: (("table".is_active IS TRUE) AND (("table".meta ->> 'source'::text) = 'test'::text) AND ("table".created_dt >= (('now'::cstring)::date - '7 mons'::interval)) AND ("table".created_dt <= ((('now'::cstring)::date)::timestamp with time zone - '6 mons'::interval)))
        Rows Removed by Filter: 5046843
        Remote SQL: SELECT created_dt, is_active, meta FROM fdw_schema.table
Planning time: 0.665 ms
Execution time: 27474.118 ms
Právě zde se skrývá moment, na který je třeba dbát při psaní dotazů. Filtry nebyly předány na vzdálený server, což znamená, že PostgreSQL vytahuje všech 6 milionů řádků, aby je pak lokálně filtroval (řádek Filter) a provedl agregaci. Klíčem k úspěchu je napsat dotaz tak, aby filtry byly předány na vzdálený stroj a my dostali a agregovali pouze potřebné řádky.
To je nějaká booleanská blbost
S boolean poli je vše jednoduché. V původním dotazu vznikl problém kvůli operátoru is. Pokud jej nahradíme =, dostaneme následující výsledek:
vysvětlení analýzy podrobně
SELECT count(1)
FROM fdw_schema.table
WHERE is_active = True
AND created_dt BETWEEN CURRENT_DATE - INTERVAL '7 měsíců'
AND CURRENT_DATE - INTERVAL '6 měsíců'
AND meta->>'source' = 'test';

Agregace  (náklady=508010.14..508010.15 řádků=1 šířka=8) (skutečný čas=19064.314..19064.314 řádků=1 smyčky=1)
  Výstup: count(1)
  ->  Cizí skenování na fdw_schema."table"  (náklady=100.00..507988.44 řádků=8679 šířka=0) (skutečný čas=33.035..18951.278 řádků=1360025 smyčky=1)
        Výstup: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filtr: ((("table".meta ->> 'source'::text) = 'test'::text) AND ("table".created_dt >= (('now'::cstring)::date - '7 měsíců'::interval)) AND ("table".created_dt <= ((('now'::cstring)::date)::timestamp with time zone - '6 měsíců'::interval)))
        Řádky odstraněny filtrem: 3567989
        Vzdálené SQL: SELECT created_dt, meta FROM fdw_schema.table WHERE (is_active)
Čas plánování: 0.834 ms
Čas provádění: 19064.534 ms
Jak vidíte, filtr byl odeslán na vzdálený server a čas provádění se snížil z 27 na 19 sekund.
Je třeba poznamenat, že operátor is se liší od operátoru = tím, že umí pracovat s hodnotou Null. To znamená, že is not True ve filtru ponechá hodnoty False a Null, zatímco != True ponechá pouze hodnoty False. Proto při nahrazování operátoru is not je třeba ve filtr přidat dvě podmínky s operátorem OR, například, WHERE (col != True) OR (col is null).
S booleanem jsme se vyrovnali, pokračujeme dál. Zatím vrátíme filtr pro logickou hodnotu do původního stavu, abychom nezávisle prozkoumali efekt ostatních změn.
timestamptz? hz
Obecně se často musíme experimentálně snažit správně napsat dotaz, ve kterém figurují vzdálené servery, a teprve poté hledat vysvětlení, proč se to děje právě tak. Na internetu se této problematice nedá najít moc informací. V průběhu experimentů jsme zjistili, že filtr pro pevně stanovené datum bez problémů končí na vzdáleném serveru, ale když chceme nastavit datum dynamicky, například now() nebo CURRENT_DATE, neděje se to. V našem příkladu jsme přidali takový filtr, aby sloupec created_at obsahoval data přesně za 1 měsíc v minulosti (BETWEEN CURRENT_DATE - INTERVAL ‘7 měsíců’ AND CURRENT_DATE - INTERVAL ‘6 měsíců’). Co jsme tedy v tomto případě udělali?
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active is True
AND created_dt >= (SELECT CURRENT_DATE::timestamptz - INTERVAL '7 month')
AND created_dt >'source' = 'test';

Aggregate  (cost=306875.17..306875.18 rows=1 width=8) (actual time=4789.114..4789.115 rows=1 loops=1)
  Output: count(1)
  InitPlan 1 (returns $0)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.007..0.008 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '7 mons'::interval)
  InitPlan 2 (returns $1)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.002..0.002 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '6 mons'::interval)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.02..306874.86 rows=105 width=0) (actual time=23.475..4681.419 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filter: (("table".is_active IS TRUE) AND (("table".meta ->> 'source'::text) = 'test'::text))
        Rows Removed by Filter: 76934
        Remote SQL: SELECT is_active, meta FROM fdw_schema.table WHERE ((created_dt >= $1::timestamp with time zone)) AND ((created_dt < $2::timestamp with time zone))
Planning time: 0.703 ms
Execution time: 4789.379 ms
Dali jsme plánovači pokyn, aby předem vypočítal datum v poddotazu a předal již připravenou proměnnou do filtru. Tato rada nám přinesla skvělý výsledek, dotaz se zrychlil téměř šestkrát!
Opět je důležité být opatrný: datový typ v poddotazu musí být stejný jako u pole, podle kterého filtrujeme, jinak plánovač usoudí, že typy jsou různé a je potřeba nejprve vytáhnout všechna data a poté je lokalně filtrovat.
Vraťme filtr podle data na výchozí hodnotu.
Freddy vs. Jsonb
V podstatě už booleovské sloupce a data dostatečně zrychlily náš dotaz, nicméně zůstával ještě jeden datový typ. Bitva s filtrací podle něj, upřímně řečeno, dosud neskončila, i když i zde dosáhli úspěchů. Takže, takto se nám podařilo předat filtr podle jsonb pole na vzdálený server.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active is True
AND created_dt BETWEEN CURRENT_DATE - INTERVAL '7 month'
AND CURRENT_DATE - INTERVAL '6 month'
AND meta @> '{"source":"test"}'::jsonb;

Aggregate  (cost=245463.60..245463.61 rows=1 width=8) (actual time=6727.589..6727.590 rows=1 loops=1)
  Output: count(1)
  ->  Foreign Scan on fdw_schema."table"  (cost=1100.00..245459.90 rows=1478 width=0) (actual time=16.213..6634.794 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Filter: (("table".is_active IS TRUE) AND ("table".created_dt >= (('now'::cstring)::date - '7 mons'::interval)) AND ("table".created_dt  '{"source": "test"}'::jsonb))
Planning time: 0.747 ms
Execution time: 6727.815 ms
Místo operátorů filtrace je nutné použít operátor přítomnosti jednoho jsonb v jiném. 7 sekund místo původních 29. Zatím je to jediná úspěšná varianta přenosu filtrů podle jsonb na vzdálený server, ale zde je důležité vzít v úvahu jedno omezení: používáme verzi databáze 9.6, nicméně do konce dubna plánujeme dokončit poslední testy a přejít na verzi 12. Jakmile se aktualizujeme, napíšeme, jak to ovlivnilo, protože změn, na které se hodně spoléháme, je poměrně hodně: json_path, nové chování CTE, push down (existující od verze 10). Opravdu se těšíme, až to vyzkoušíme.
Dohodnojte to
Zkontrolovali jsme, jak každá změna ovlivňuje rychlost dotazu jednotlivě. Nyní se podívejme, co se stane, když budou všechny tři filtry napsány správně.
explain analyze verbose
SELECT count(1)
FROM fdw_schema.table
WHERE is_active = True
AND created_dt >= (SELECT CURRENT_DATE::timestamptz - INTERVAL '7 month')
AND created_dt  '{"source":"test"}'::jsonb;

Aggregate  (cost=322041.51..322041.52 rows=1 width=8) (actual time=2278.867..2278.867 rows=1 loops=1)
  Output: count(1)
  InitPlan 1 (returns $0)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.010..0.010 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '7 mons'::interval)
  InitPlan 2 (returns $1)
    ->  Result  (cost=0.00..0.02 rows=1 width=8) (actual time=0.003..0.003 rows=1 loops=1)
          Output: ((('now'::cstring)::date)::timestamp with time zone - '6 mons'::interval)
  ->  Foreign Scan on fdw_schema."table"  (cost=100.02..322041.41 rows=25 width=0) (actual time=8.597..2153.809 rows=1360025 loops=1)
        Output: "table".id, "table".is_active, "table".meta, "table".created_dt
        Remote SQL: SELECT NULL FROM fdw_schema.table WHERE (is_active) AND ((created_dt >= $1::timestamp with time zone)) AND ((created_dt  '{"source": "test"}'::jsonb))
Planning time: 0.820 ms
Execution time: 2279.087 ms
Ano, dotaz vypadá složitěji, je to nevyhnutelná daň, ale rychlost provedení je 2 sekundy, což je více než 10krát rychleji! A to mluvíme o jednoduchém dotazu na relativně malý soubor dat. U reálných dotazů jsme získali nárůst až několik setkrát.
Shrňme to: pokud používáte PostgreSQL s FDW, vždy zkontrolujte, zda jsou všechny filtry odesílány na vzdálený server, a budete šťastní… Minimálně dokud se nedostanete k joinům mezi tabulkami z různých servery. Ale to už je příběh na další článek.
Děkuji za pozornost! Rád uslyším otázky, komentáře a také příběhy o vašich zkušenostech v komentářích.
Zdroj: habr.com
