

Prezentace se zaměřuje na praktické otázky vývoje operátora v Kubernetes, návrhu jeho architektury a hlavní principy jeho fungování.
V první části prezentace si probereme:
- co je operátor v Kubernetes a k čemu slouží;
- jak přesně operátor zjednodušuje správu složitých systémů;
- co operátor může a co nemůže.
Dále přejdeme k diskusi o vnitřní struktuře operátora. Prostudujeme architekturu a fungování operátora krok za krokem. Podrobně se zaměříme na:
- interakci mezi operátorem a Kubernetes;
- jaké funkce operátor přebírá a co deleguje na Kubernetes.
Podíváme se na správu shardů a replik databází v Kubernetes.
Další bod, který prodiskutujeme, se týká ukládání dat:
- jak pracovat s Persistent Storage z pohledu operátora;
- úskalí používání Local Storage.
V závěrečné části prezentace se zaměříme na praktické příklady aplikace s Amazon nebo Google Cloud Service. Prezentace je postavena na příkladu vývoje a zkušeností s provozem operátora pro ClickHouse.
Video:
Jmenuji se Vladislav Klimenko. Dnes bych chtěl hovořit o naší zkušenosti s vývojem a provozem operátora, přičemž se jedná o specializovaného operátora pro správu clusterů databází. Na příkladu pro správu clusteru ClickHouse.
Proč máme možnost hovořit o operátorovi a ClickHouse?
- Zabýváme se podporou a vývojem ClickHouse.
- V současné době se snažíme postupně přispívat naší měrou k vývoji ClickHouse. A jsme druzí hned za Yandexem, pokud jde o objem provedených změn v ClickHouse.
- Snažíme se realizovat další projekty pro ekosystém ClickHouse.
O jednom z takových projektů bych chtěl hovořit. A to o ClickHouse-operator pro Kubernetes.
Ve svém příspěvku bych chtěl touchnout dvě témata:
- První téma – jak funguje náš operátor pro správu databází ClickHouse v Kubernetes.
- Druhé téma – jak funguje jakýkoli operátor, tj. jak interaguje s Kubernetes.
Tyto dvě otázky se přitom budou prolínat po celou dobu mé prezentace.
Koho by mohlo zajímat, co se snažím říct?
- Nejvíce zajímavé to bude pro ty, kdo provozují operátory.
- Nebo pro ty, kteří chtějí vytvořit svůj vlastní, aby pochopili, jak to funguje uvnitř, jak operátor interaguje s Kubernetes a jaká úskalí se mohou objevit.
Abyste lépe porozuměli tomu, co dnes budeme diskutovat, bylo by dobré mít znalosti o tom, jak funguje Kubernetes, a mít základní znalosti o cloudových technologiích.
Co je ClickHouse? Je to sloupcová databáze zaměřená na online zpracování analytických dotazů. A je zcela open source.
A je pro nás důležité vědět pouze dvě věci. Musíme vědět, že je to databáze, takže to, co budu vyprávět, bude aplikovatelné prakticky na jakoukoli databázi. A že databázový systém ClickHouse je velmi dobře škálovatelný, prakticky poskytuje lineární škálovatelnost. A proto je stav clustera pro ClickHouse přirozený. A nás nejvíce zajímá diskutovat o tom, jak spravovat cluster ClickHouse v Kubernetes.
Proč je tam potřeba? Proč nemůžeme pokračovat v jeho provozování samostatně? Odpovědi jsou částečně technické a částečně organizační.
- V praxi se stále častěji setkáváme se situací, kdy ve velkých společnostech už prakticky všechny komponenty fungují v Kubernetes. Databáze zůstávají mimo.
- A stále častěji vyvstává otázka: „Můžeme to umístit dovnitř?“ A proto se velké firmy snaží o maximální unifikaci správy, aby měly schopnost rychle spravovat svá datová úložiště.
- A zejména to pomáhá, pokud je potřeba maximální možnost zopakovat to samé na novém místě, tj. maximální přenositelnost.
Jak jednoduché nebo složité to je? To samozřejmě lze dělat ručně. Ale není to tak jednoduché, protože máme složitost správy samotného Kubernetes, ale zároveň se k tomu přidává specifika ClickHouse. A vzniká taková agregace.
A to všechno dohromady poskytuje dost velký soubor technologií, jejichž správa se stává už dost složitou, protože Kubernetes přináší své každodenní provozní otázky a ClickHouse přináší své otázky k každodennímu provozu. Zvlášť pokud máme několik instancí ClickHouse a musíme s nimi neustále něco dělat.
U ClickHouse s dynamickou konfigurací je dostatečně velké množství otázek, které vytvářejí stálé zatížení na DevOps:
- Když chceme něco změnit v ClickHouse, například přidat replikaci nebo shard, musíme provést správu konfigurace.
- Poté je potřeba změnit datovou schéma, protože ClickHouse má specifický způsob shardingu. Je nutné rozložit datovou schéma a konfigurace.
- Je třeba nastavit monitoring.
- Sbírání logů pro nové shardy a nové repliky.
- Postarat se o obnovu.
- A o restartování.
To jsou rutinní úkoly, které bychom chtěli zjednodušit v provozu.
Kubernetes dobře pomáhá při provozu, ale v základních systémových věcech.
Kubernetes dobře usnadňuje a provádí automatizaci takových věcí, jako je:
- Obnova.
- Restartování.
- Správa úložného systému.
To je dobré, je to správný směr, ale zcela nemá představu o tom, jak provozovat databázový cluster.
Chceme více, chceme, aby naše celá databáze fungovala v Kubernetes.
Chceme něco jako velké kouzelné červené tlačítko, na které stisknete a rozbalí se vám a bude udržováno po celou dobu životního cyklu cluster s každodenními úkoly, které je třeba řešit. KlikHouse cluster v Kubernetes.
A my jsme se snažili vytvořit takové řešení, které by pomohlo usnadnit práci. To je ClickHouse-operator pro Kubernetes od společnosti Altinity.
Operátor je program, jehož hlavním úkolem je řídit jiné programy, tedy funguje jako manažer.
A obsahuje vzory chování. Můžeme to nazvat kodifikovanými znalostmi o oboru.
A jeho hlavním úkolem je usnadnit život DevOps a snížit mikromanažerské úkoly, aby DevOps myslel v termínech vysoké úrovně, tedy aby se nezabýval mikromanagementem a nezapletl se do nastavení všech detailů ručně.
A právě operátor je robotický asistent, který se zabývá mikroúkoly a pomáhá DevOps.
Proč je operátor potřebný? Zachovává se zvláště dobře ve dvou otázkách:
- Když odborník, který se zabývá ClickHouse, nemá dostatek zkušeností, ale provozovat ClickHouse už je nutné, operátor usnadňuje provoz a umožňuje provozovat cluster ClickHouse s dostatečně složitou konfigurací, přičemž se příliš nezabývá detaily toho, jak to všechno funguje uvnitř. Jednoduše mu dáte úkoly na vysoké úrovni a to funguje.
- A druhý úkol, ve kterém se nejlépe projevuje, je, když je třeba automatizovat velké množství standardních úkolů. Odebírá mikroúkoly od systémových administrátorů.
To je nejvíce potřeba buď těm, kteří teprve začínají svou cestu, nebo těm, kteří se musí věnovat hodně automatizaci.
Jaký je tedy rozdíl mezi přístupem založeným na operátorech a jinými systémy? Existuje přece Helm. Ten také pomáhá nasadit ClickHouse, lze vytvořit helm charts, které dokonce nasadí celý clustery ClickHouse. Jaký je tedy rozdíl mezi operátorem a například Helm?
Hlavní fundamentální rozdíl je v tom, že Helm je správa balíčků, zatímco operátor jde dále. To je podpora celého životního cyklu. Není to pouze instalace, ale každodenní úkoly, které zahrnují škálování, shardování, tedy všechno, co je třeba provádět v průběhu životního cyklu (pokud je to nutné, tak i mazání) – to vše řeší operátor. Snaží se automatizovat a udržovat celý životní cyklus softwaru. To je jeho fundamentální rozdíl od dalších dostupných řešení.
To byla úvodní část, pojďme dál.
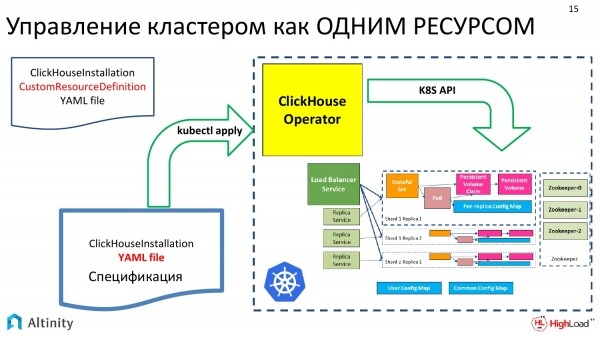
Jak budujeme svého operátora? Snažíme se přistupovat k otázce, jak spravovat cluster ClickHouse jako jeden zdroj.
Na levé straně obrazu máme vstupní data. To je YAML se specifikací clusteru, který je klasickým způsobem předáván do Kubernetes prostřednictvím kubectl. Tam náš operátor to zachytí, dělá svou magii. A na výstupu máme takovou schéma. To je implementace ClickHouse v Kubernetes.
A dále se budeme postupně dívat, jak operátor funguje, jaké standardní úkoly lze řešit. Probereme pouze standardní úkoly, protože máme omezený čas. A nebude řečeno všechno, co operátor může řešit.
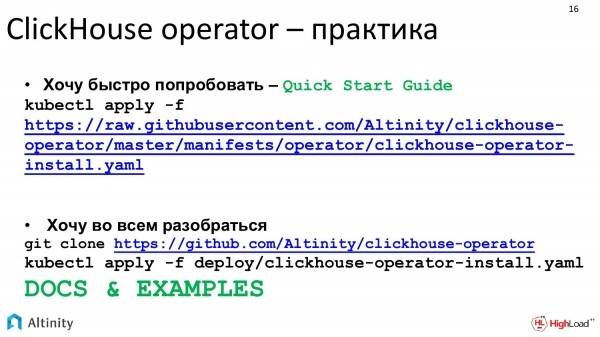
Pojďme vycházet z praxe. Náš projekt je zcela open source, takže můžete na GitHubu vidět, jak funguje. A můžete vycházet z úvah, pokud chcete jednoduše spustit, můžete začít s Quick Start Guide.
Pokud chcete podrobně rozumět, snažíme se udržovat dokumentaci v celkem přijatelné podobě.
Pojďme začít praktickým úkolem. První úkol, od kterého chceme začít, je spustit první příklad jakkoli. Jak spustit ClickHouse pomocí operátora, aniž bychom přesně věděli, jak to funguje? Píšeme manifest, protože veškerá komunikace s k8s probíhá prostřednictvím manifestů.
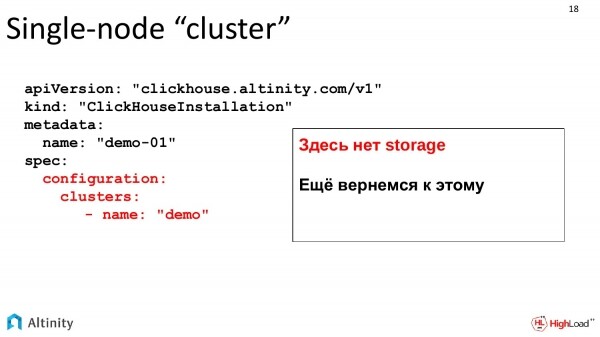
Tady je takový složitý manifest. To, co máme označeno červeně, je to, na co bychom se měli zaměřit. Požádali jsme operátora, aby vytvořil cluster s názvem demo.
Zatím jsou to základní příklady. Storage ještě není popsáno, ale k storage se vrátíme později. Zatím budeme sledovat vývoj clusteru v reálném čase.
Vytvořili jsme tento manifest. Krmíme ho našemu operátorovi. On pracoval, udělal kouzlo.
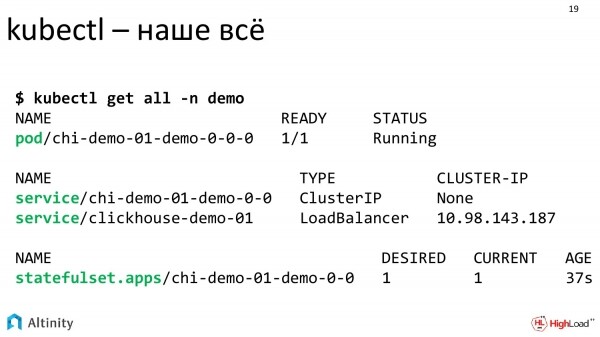
Díváme se do konzole. Zajímavé jsou tři komponenty – to jsou Pod, dva Service a StatefulSet.
Operátor provedl svou práci a můžeme vidět, co přesně vytvořil.
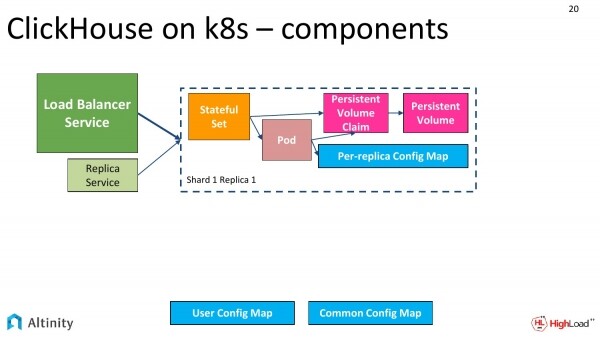
Vytváří přibližně takové schéma. Máme StatefulSet, Pod, ConfigMap pro každou repliku, ConfigMap pro celý cluster. Nezapomínejme na služby jako vstupní body do clusteru.
Služby – to je centrální Load Balancer Service a může být také pro každou repliku, pro každého shardu.
Takže náš základní cluster vypadá přibližně takto. Skládá se z jediné uzlu.
Pokračujme dál, budeme to komplikovat. Je třeba shardovat cluster.
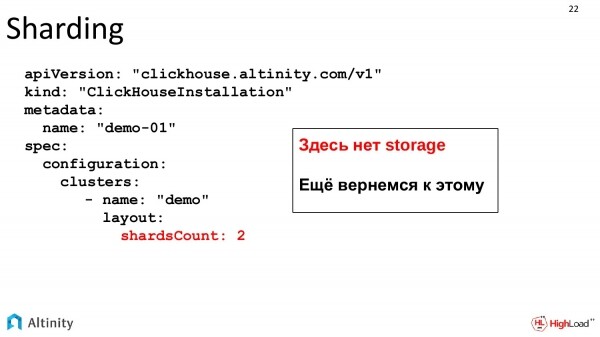
Naše úkoly rostou, začíná dynamika. Chceme přidat shard. Sledujeme vývoj. Měníme naši specifikaci. Uvádíme, že chceme dva shardy.
To je ten samý soubor, který se dynamicky vyvíjí s růstem systému. Storage není, storage bude probrán později, to je samostatné téma.
Krmíme YAML operátora a sledujeme, co se stane.
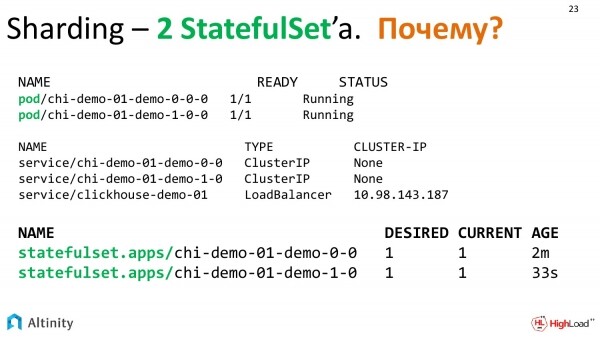
Operátor přemýšlel a vytvořil následující entity. Už máme dva Pod, tři služby a náhle 2 StatefulSety. Proč 2 StatefulSety?
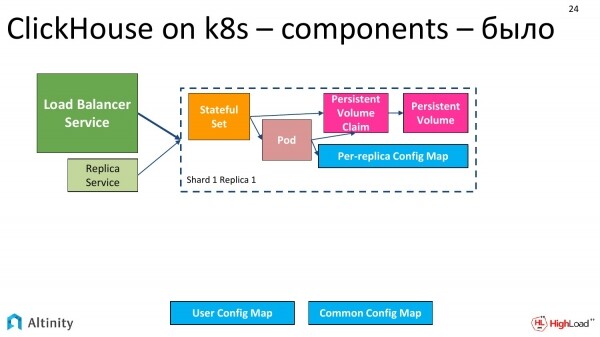
Na schématu to vypadalo takto – to je naše počáteční stav, kdy jsme měli jeden pod.
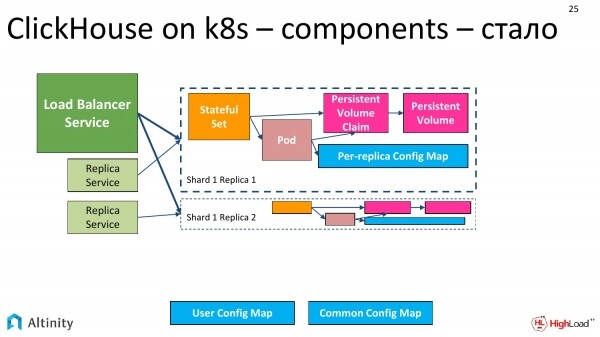
Stalo se to takto. Zatím je to jednoduché, zdvojnásobilo se to.
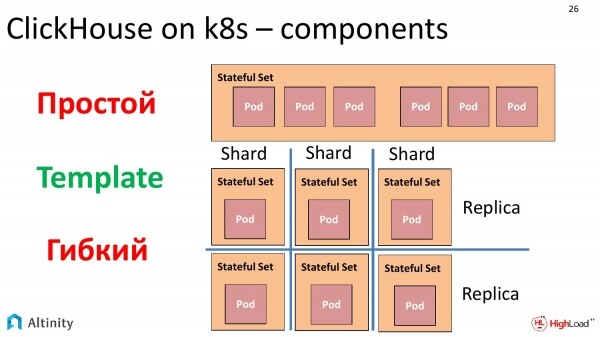
A proč se stal StatefulSet dva? Zde se musíme odklonit a prodiskutovat otázku, jak v Kubernetes probíhá řízení Podů.
Existuje objekt s názvem StatefulSet, který umožňuje vytvořit sadu Podů z šablony. Klíčový faktor zde je šablona. A v jednom StatefulSetu lze spustit podle jedné šablony mnoho Podů. A klíčová fráze zde je „podle jedné šablony mnoho Podů“.
Bylo velké pokušení udělat celý klastr, zabalený do jednoho StatefulSet. Bude to fungovat, v tom nejsou žádné problémy. Ale je tu jeden detail. Pokud chceme sestavit heterogenní klastr, tedy z několika verzí ClickHouse, začínají se objevovat otázky. Ano, StatefulSet může provést rolling update, ano, tam lze nasadit novou verzi, ale je třeba vysvětlit, že je třeba zkusit maximálně tolikto uzlů najednou.
Pokud ale extrapolujeme úkol a řekneme, že chceme vytvořit plně heterogenní klastr a nechceme přecházet ze staré verze na novou pomocí rolling update, ale chceme prostě vytvořit heterogenní klastr, jak co do různých verzí ClickHouse, tak co do různých úložišť. Například chceme některé repliky udělat na oddělených discích, na pomalých, prostě plně vybudovat heterogenní klastr. A protože StatefulSet vytváří ze jednoho šablonového standardizované řešení, není možné to udělat.
Po určitém zamyšlení bylo rozhodnuto, že to uděláme takto. Každá replika má svůj vlastní StatefulSet. Toto řešení má určité nevýhody, ale v praxi to všechno plně inkapsuluje operátor. A má to spoustu výhod. Můžeme budovat klastr přesně takový, jaký chceme, například naprosto heterogenní. Proto v klastru, kde máme dva shardové uzly s jednou replikou, budou 2 StatefulSety a 2 Pody právě proto, že jsme zvolili tento přístup z výše uvedených důvodů, abychom mohli postavit heterogenní klastr.
Vraťme se k praktickým úkolům. V našem klastru je nutné nastavit uživatele, tedy je třeba provést nějakou konfiguraci ClickHouse v Kubernetes. Operátor poskytuje všechny možnosti pro to.
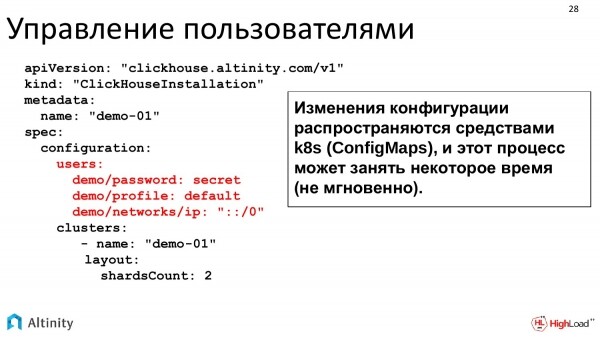
Můžeme přímo v YAML napsat to, co chceme. Všechny konfigurační možnosti se přímo mapují z tohoto YAML do konfiguračních souborů ClickHouse, které se poté rozloží po celém klastru.
Můžeme to napsat i takto. Toto je jen příklad. Heslo lze udělat zašifrované. Podporují se naprosto všechny konfigurační možnosti ClickHouse. Zde je pouze příklad.
Konfigurace v klastru se šíří jako ConfigMap. V praxi se aktualizace ConfigMap neprovádí okamžitě, takže pokud je klastr velký, proces nasazení konfigurace trvá nějaký čas. Ale vše je to velmi pohodlné na používání.
Ztěžujeme úkol. Kluster se vyvíjí. Chceme replikovat data. T. j. máme již dva shardové, po jedné replikaci, nastavené uživatele. Růsteme a chceme se zabývat replikací.
Co potřebujeme k replikaci?
Potřebujeme ZooKeeper. V ClickHouse je replikace postavena s použitím ZooKeeper. ZooKeeper je potřebný, aby různé repliky ClickHouse měly konsensus ohledně toho, které datové bloky existují na jakém ClickHouse.
Můžeme použít jakýkoli ZooKeeper. Pokud má podnik externí ZooKeeper, může ho použít. Pokud ne, můžeme nainstalovat z našeho repozitáře. Existuje instalátor, který to celé usnadňuje.
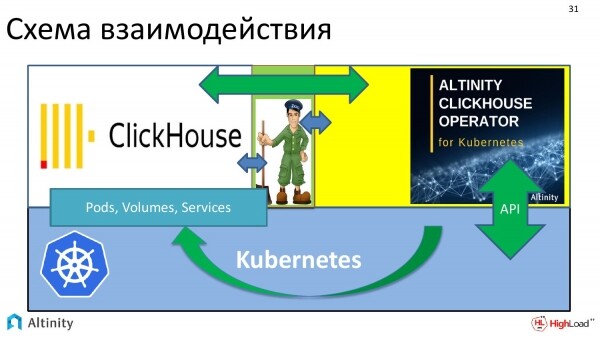
A schéma interakce celého systému vypadá takto. Máme Kubernetes jako platformu. Na něm běží operátor ClickHouse. ZooKeeper jsem znázornil zde. A operátor interaguje jak s ClickHouse, tak se ZooKeeper. T. j. vzniká interakce.
A to vše je potřeba, aby ClickHouse úspěšně replikoval data v k8s.
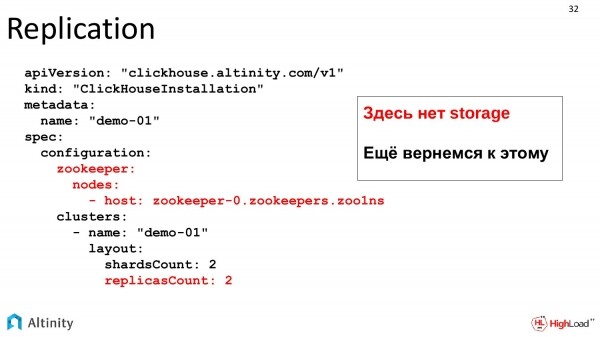
Pojďme se nyní podívat na samotný úkol, jak bude vypadat manifest pro replikaci.
K našemu manifestu přidáme dvě sekce. První – odkud vzít ZooKeeper, který může být buď uvnitř Kubernetes, nebo externí. To je prostý popis. A objednáváme repliky. T. j. chceme dvě repliky. Celkem by mělo vyjít 4 pody. Ohledně storage si pamatujeme, ten se vrátí trochu později. Storage – to je jiný příběh.
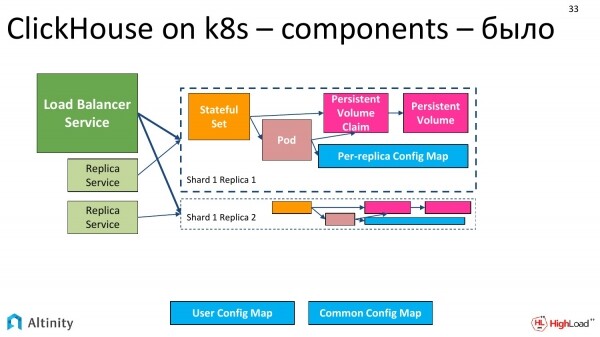
Bylo to takto.
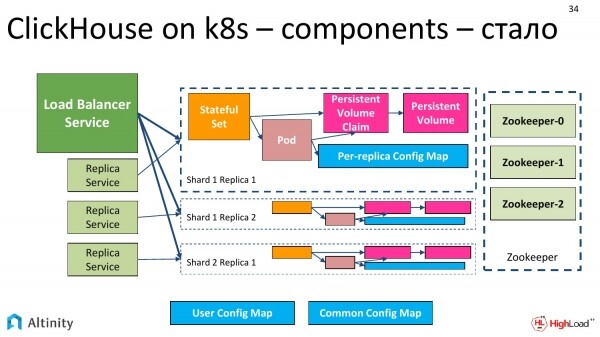
Stává se to takto. Přidávají se repliky. 4. se nevešel, věříme, že jich může být mnoho. A bokem se přidává ZooKeeper. Schémata se komplikují.
A nastal čas přidat další úkol. Budeme přidávat Persistent Storage.
 Pokud jde o Persistent Storage, máme různé varianty provedení.
V případě, že se realizujeme v cloudovém poskytovateli, například využíváním Amazonu, Googlu, existuje velké pokušení využít cloudové storage. To je velmi pohodlné, je to dobré.
A existuje druhá varianta. To je pro lokální storage, kdy máme lokální disky na každém uzlu. Tato varianta je mnohem složitější na provedení, ale zároveň je výkonnější.
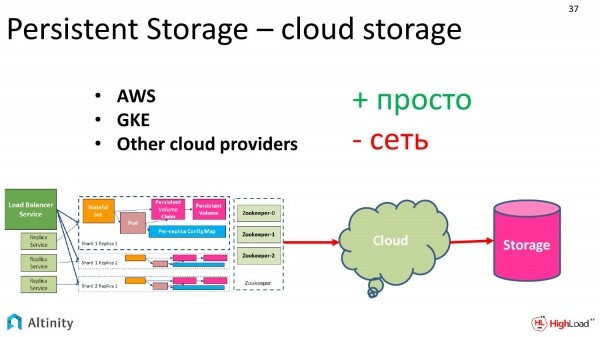
Pojďme se podívat, co máme ohledně cloud storage.
Existují výhody. Je to velmi snadné konfigurovat. Prostě si objednáme od cloudového poskytovatele, aby nám dal, prosím, storage takové kapacity, takové třídy. Třídy jsou popsány poskytovateli samostatně.
A existuje nevýhoda. Pro někoho to může být nevýznamná nevýhoda. Samozřejmě, že tam budou nějaké výkyvy výkonu. Je to velmi pohodlné pro práci, spolehlivé, ale jsou zde určité potenciální poklesy výkonu.
A protože se ClickHouse zaměřuje právě na výkon, můžeme dokonce říci, že vytahuje maximum, co se dá, proto se mnoho klientů snaží vytěžit maximum výkonu.
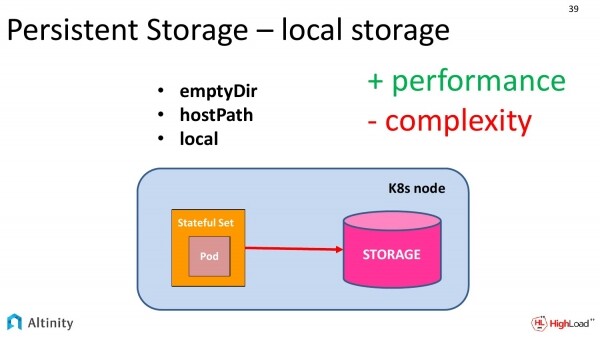
A abychom dosáhli maxima, potřebujeme lokální úložiště.
Kubernetes poskytuje tři abstrakce pro použití lokálního úložiště v Kubernetes. A to jsou:
- EmptyDir
- HostPath.
- Místní
Podívejme se, čím se liší a čím jsou si podobné.
Za prvé, ve všech třech přístupech máme úložiště – to jsou lokální disky, které se nacházejí na stejné fyzické k8s nodě. Ale mají určité rozdíly.
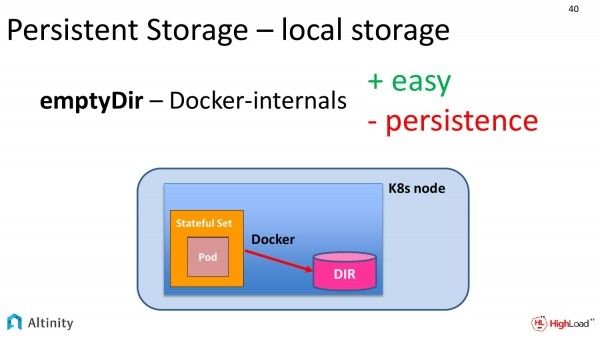
Začněme s tím nejjednodušším, t.j. s emptyDir. Co to vlastně v praxi je? Oslovujeme naši specifikaci o to, aby nám systém kontejnerizace (nejčastěji je to Docker) poskytl přístup k adresáři na lokálním disku.
V praxi Docker někde tam uvnitř po svých vlastních cestách vytváří dočasnou složku, nazve ji dlouhým hashovacím kódem a poskytne rozhraní pro přístup k ní.
Jak to bude fungovat z hlediska výkonu? Bude to fungovat rychlostí lokálního disku, tedy to je úplný přístup k vlastnímu disku.
Ale tato metoda má svou nevýhodu. Trvalost v tomto ohledu je dost pochybně. Při prvním pohybu Dockeru se kontejnery trvalost ztrácí. Pokud by Kubernetes chtěl z nějakého důvodu přesunout tento Pod na jiný disk, data by se ztratila.
Tento přístup je dobrý pro testy, protože ukazuje již normální rychlost, ale pro něco vážného tento variant nevyhovuje.
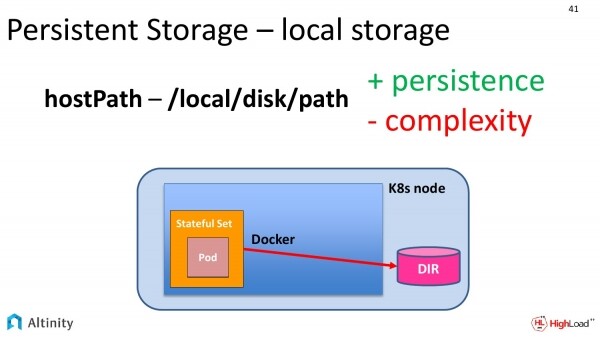
Proto existuje druhý přístup. To je hostPath. Pokud se podíváme na předchozí snímek a tento, můžeme vidět jen jedno jediné rozdílné místo. Naše složka se přesunula z Dockeru přímo na Kubernetes nodu. Tady je to o něco jednodušší. Přímo píšeme cestu v lokálním souborovém systému, kde bychom chtěli ukládat své data.
Tento způsob má své výhody. To už je skutečný Persistent, a to klasický. Na disku budou data uložena na nějaké adrese.
Existují i nevýhody. Je to složitost správy. Náš Kubernetes může chtít přesunout Pod na jiný fyzický uzel. A zde přichází na řadu DevOps. Musí správně vysvětlit celému systému, že tyto pod’ y mohou být přesunuty pouze na takové uzly, na kterých máš připojené něco přes tyto cesty, a ne více než na jeden uzel najednou. To je dost složité.
Speciálně pro tyto potřeby jsme u nás v operátorovi vytvořili šablony, abychom celou tuto složitost skryli. A bylo by možné jednoduše říct: „Chci mít jeden instance ClickHouse na každý fyzický uzel a na takovémto cestě.“
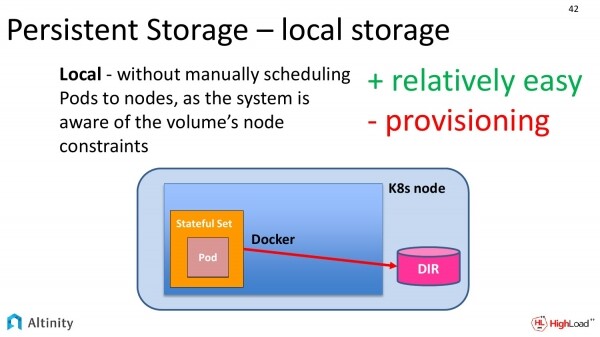
Ale tato potřeba není jen naše, proto pánové z Kubernetese také chápou, že lidé chtějí mít přístup k fyzickým diskům, a proto poskytují třetí úroveň.
Ta se nazývá local. Rozdíl od předchozího slidu v podstatě žádný. Dříve bylo třeba ručně provádět to, že tyto pod’ y nelze přesunovat mezi uzly, protože musí být připojeny k lokálnímu fyzickému disku přes takovou cestu, a nyní jsou veškeré tyto znalosti enkapsulovány v samotném Kubernetes. A konfigurace se tak stává mnohem jednodušší.
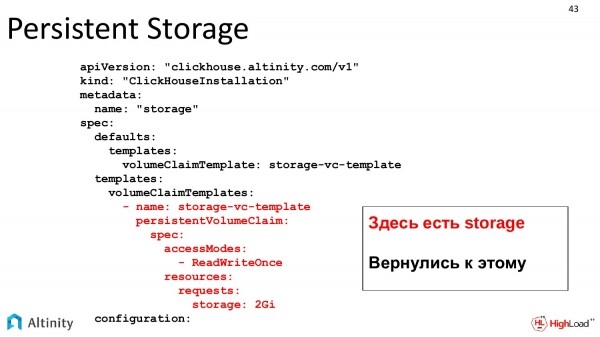
Vrátíme se k naší praktické úloze. Vrátíme se k šabloně YAML. Tady máme skutečné úložiště. Vrátili jsme se k tomu. Definujeme klasickou šablonu VolumeClaim, jak je v k8s. A popisujeme, jaké úložiště chceme.
Po tom k8s požádá o úložiště. Přidělí nám ho ve StatefulSet. A nakonec to bude k dispozici ClickHouse.
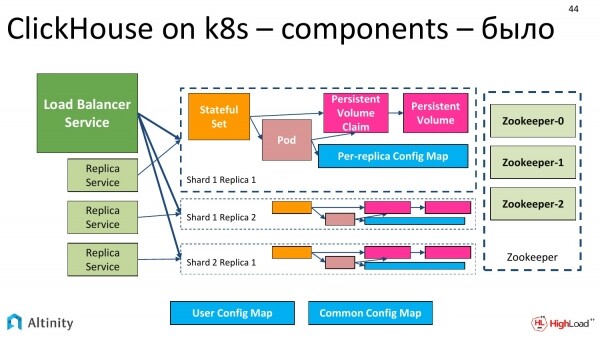
Měli jsme takovou schému. Náš Trvalý Storage byl červený, což jakoby naznačovalo, že by ho bylo třeba udělat.
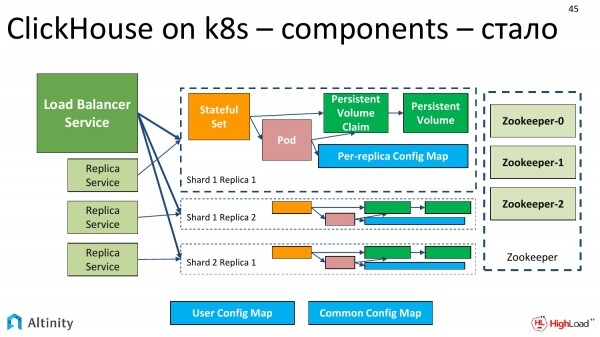
A nyní se stává zeleným. Schéma clusteru ClickHouse na k8s je nyní plně finalizováno. Máme shardování, repliky, ZooKeeper, máme skutečný Persistent, který je realizován různými způsoby. Schéma je již plně funkční.
Pokračujeme dál. Náš cluster se vyvíjí. A Alexej se snaží a vydává novou verzi ClickHouse.
Objevuje se praktický úkol – otestovat novou verzi ClickHouse na našem clusteru. Samozřejmě, že se nám nechce ji nasazovat úplně, chceme někde v odlehlém rohu nasadit novou verzi do jedné repliky, nebo možná ne jednu novou verzi, ale hned dvě, protože vycházejí často.
Co k tomu můžeme říci?
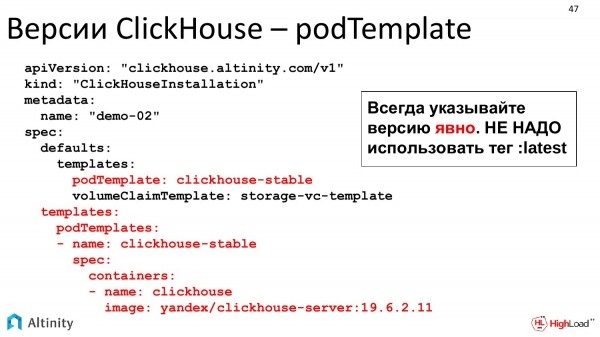
Tady máme možnost využít šablony podů. Naše aplikace umožňuje plně konfigurovat heterogenní klastr. To znamená, že můžeme nastavit vše od různých replik až po konkrétní repliku s verzí ClickHouse a verzí úložiště, kterou chceme. Můžeme plně nakonfigurovat klastr podle našich potřeb.
Teď se postupně ponoříme hlouběji. Předtím jsme diskutovali, jak ClickHouse-operator funguje v kontextu ClickHouse.
Dovolte mi nyní říct pár slov o tom, jak funguje jakýkoli operator a jak interaguje s K8s.
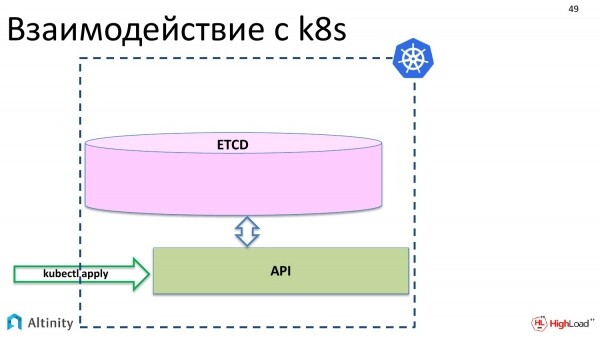
Nejprve se podíváme na interakci s K8s. Co se děje, když provedeme kubectl apply? Naše objekty se přes API objeví v etcd.
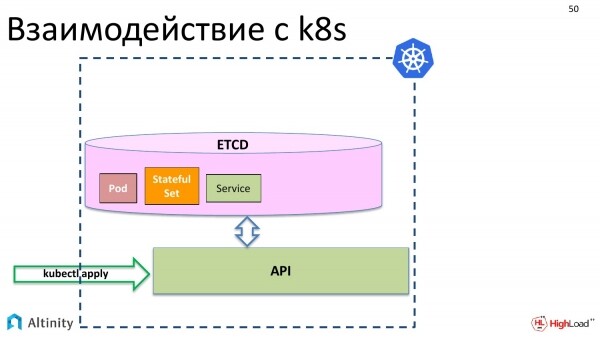
Například základní objekty Kubernetes: pod, StatefulSet, služba a tak dále.
Zatím se nic fyzického neděje. Tyto objekty je třeba materializovat v klastru.
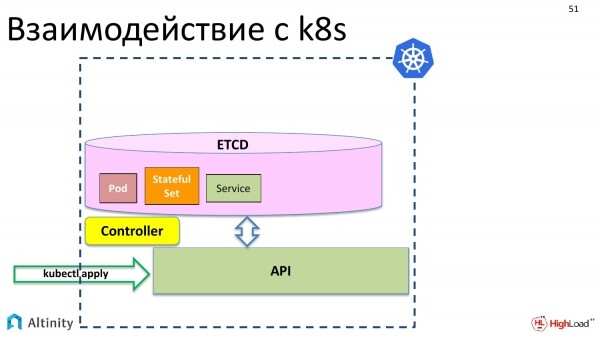
Na to přichází kontroler. Kontroler je speciální komponenta K8s, která umí materializovat tyto popisy. Ví, jak a co je třeba udělat fyzicky. Ví, jak spouštět kontejnery a co nastavit, aby server fungoval.
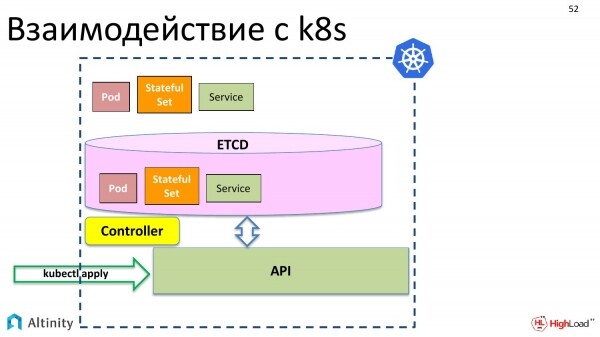
A materializuje naše objekty v K8s.
Ale chceme operovat nejen s pody a StatefulSety, ale také vytvořit ClickHouseInstallation, tedy objekt typu ClickHouse, abychom s ním mohli manipulovat jako s celkem. Zatím taková možnost není.
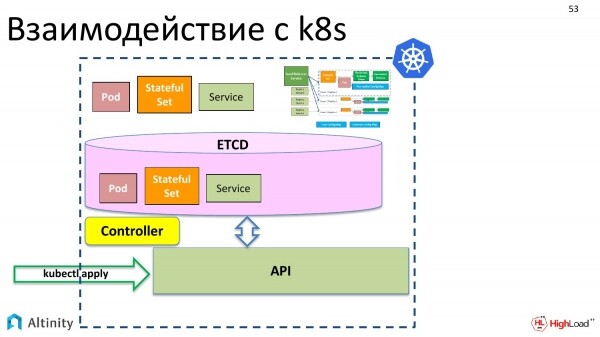
Ale K8s má další příjemnou vlastnost. Chceme, aby vznikla složitá entita, která by byla složená z podů a StatefulSetů našeho klastru.
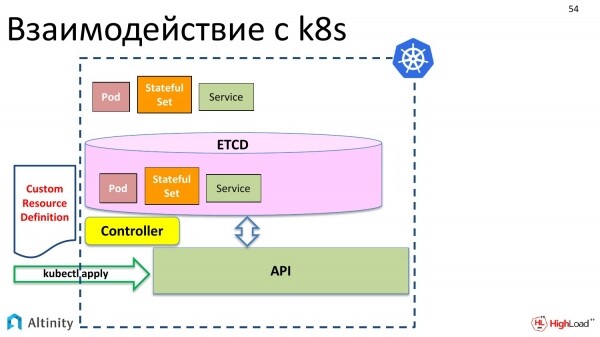
Co tedy musíme udělat? Za prvé přichází na scénu Custom Resource Definition. Co to je? Je to popis pro K8s, že bude mít další typ dat, že k podu a StatefulSetu chceme přidat vlastní zdroj, který bude složitější uvnitř. Je to popis struktury dat.
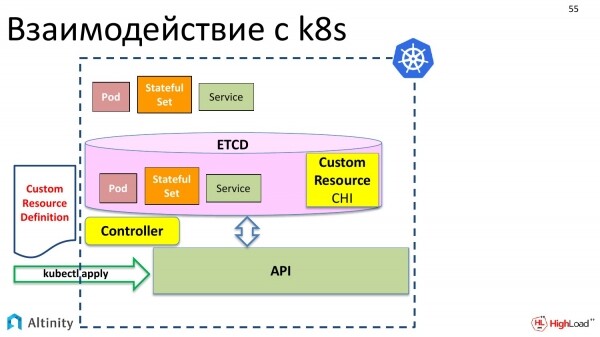
Tento popis také posíláme pomocí kubectl apply. Kubernetes ho s radostí převzal.
A nyní máme ve skladě, u objektu v etcd, možnost zapsat vlastní zdroj s názvem ClickHouseInstallation.
Ale zatím se nic dál nestane. T. j. pokud nyní vytvoříme YAML soubor, který jsme zvažovali s popisem shardů, replik a řekneme 'kubectl apply', Kubernetes ho přijme, uloží do etcd a řekne: 'Skvěle, ale nevím, co s ním dělat. Jak spravovat ClickHouseInstallation nevím.'
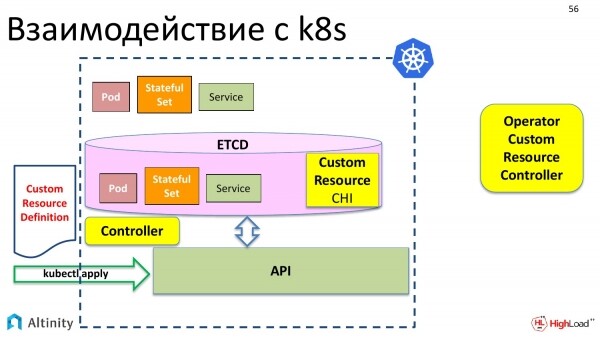
Proto potřebujeme někoho, kdo pomůže Kubernetes spravovat nový typ dat. Na levé straně máme nativní kontroler Kubernetes, který pracuje s nativními typy dat. A na pravé straně by se měl objevit vlastní kontroler, který umí pracovat s vlastními typy dat.
A jinak se nazývá operátor. Vytáhl jsem ho zde mimo Kubernetes, protože může běžet i mimo K8s. Nejčastěji samozřejmě všechny operátory běží v Kubernetes, ale nic mu nebrání stát venku, proto je zde speciálně vyveden ven.
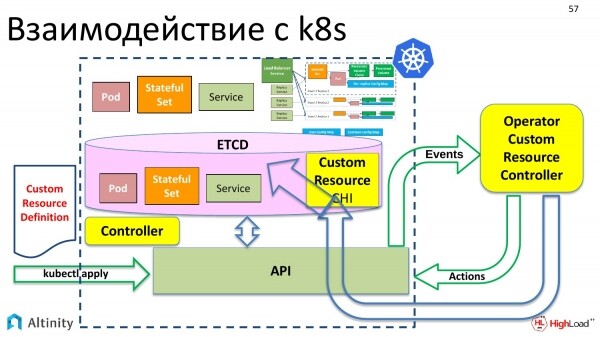
A už vlastní kontroler, tj. operátor, interaguje s Kubernetes přes API. Už umí spolupracovat s API. A už ví, jak z vlastního zdroje zmaterializovat složitou strukturu, kterou chceme vytvořit. Přesně tím se zabývá operátor.
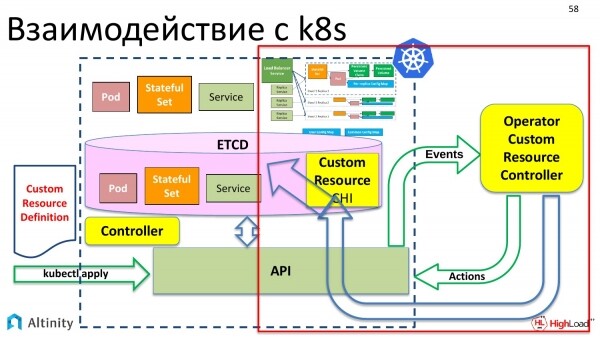
Jak funguje operátor? Podívejme se na pravou část, abychom zjistili, jak to dělá. Zjistíme, jak operátor vše zmaterializuje a jak dále probíhá interakce s K8s.
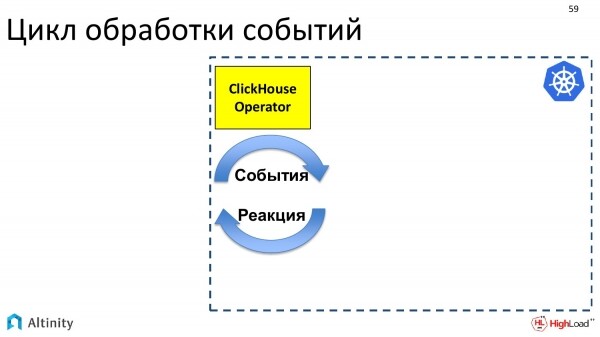
Operátor je program. Je orientovaný na události. Operátor se pomocí Kubernetes API přihlásí k událostem. V Kubernetes API jsou vstupní body, na kterých se lze přihlásit k událostem. A pokud se něco v K8s změní, Kubernetes pošle události všem, kdo mají zájem, tedy kdo se na tento bod API přihlásil, ten bude dostávat oznámení.
Operátor se přihlásí k událostem a měl by na ně reagovat. Jeho úkolem je reagovat na vzniklé události.
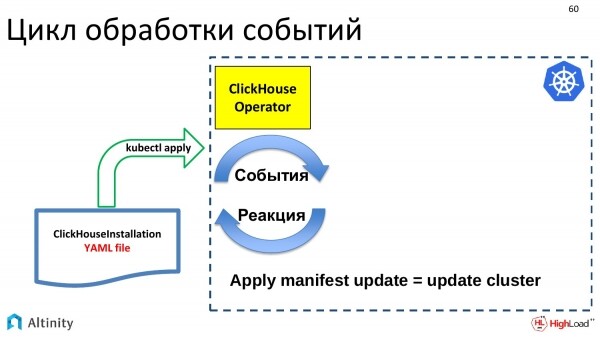
Události jsou generovány určitými aktualizacemi. Přichází náš YAML soubor s popisem ClickHouseInstallation. Přišel přes kubectl apply do etcd. Tam se spustila událost, která následně přišla k ClickHouse-operatorovi. Operátor obdržel tento popis. A měl by něco udělat. Pokud přišla aktualizace na objekt ClickHouseInstallation, je třeba aktualizovat cluster. Úkolem operátora je aktualizovat cluster.
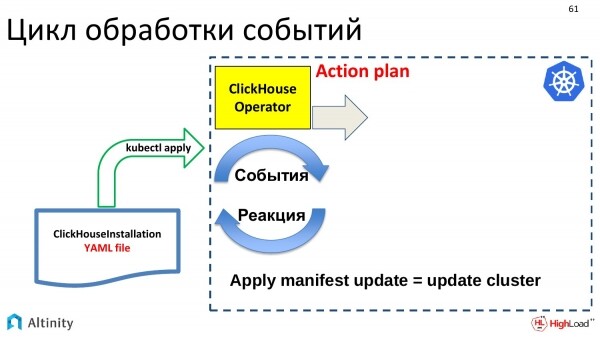
Co dělá? Především je třeba sestavit akční plán, co s touto aktualizací uděláme. Aktualizace mohou být velmi malé, tj. malé ve vykonání YAML, ale mohou mít za následek velké změny v klastru. Proto operátor vytváří plán a poté se ho drží.
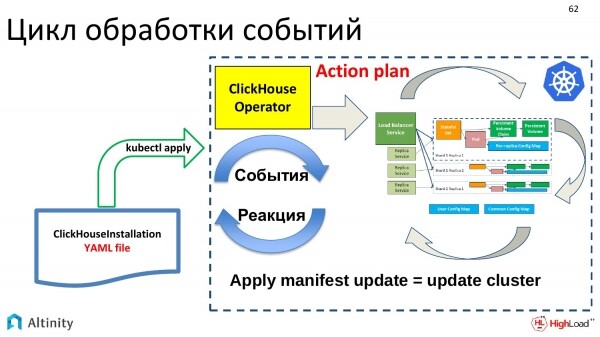
Podle tohoto plánu začíná připravovat tuto strukturu dovnitř, aby se zhmotnily pod'y, služby, tj. dělá to, co je jeho hlavní úkol. Je to jako stavět klastr ClickHouse v Kubernetes.
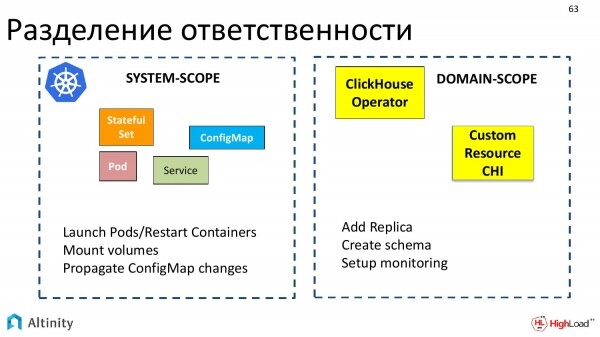
Teď se dotkněme jedné zajímavé věci. To je rozdělení odpovědností mezi Kubernetes a operátorem, tj. co dělá Kubernetes, co dělá operátor a jak spolu interagují.
Kubernetes odpovídá za systémové záležitosti, tj. za základní sadu objektů, kterou lze interpretovat jako system-scope. Kubernetes ví, jak spouštět pod'y, jak restartovat kontejnery, jak vytvářet volume mount, jak pracovat s ConfigMap, tj. všechno, co lze nazvat systémem.
Operátoři operují v oborových oblastech. Každý operátor je určen pro svou oborovou oblast. My jsme vytvořili operátora pro ClickHouse.
A operátor interaguje právě v termínech oborové oblasti, jako je přidání repliky, vytvoření schématu, nastavení monitorování. Dochází k takovému rozdělení.
Podívejme se na praktický příklad, jak k tomuto rozdělení odpovědností dochází, když provádíme akci přidat repliku.
Operátor dostane úkol – přidat repliku. Co operátor dělá? Operátor vypočítá, že je potřeba vytvořit nový StatefulSet, ve kterém je třeba popsat určité šablony, volume claim.
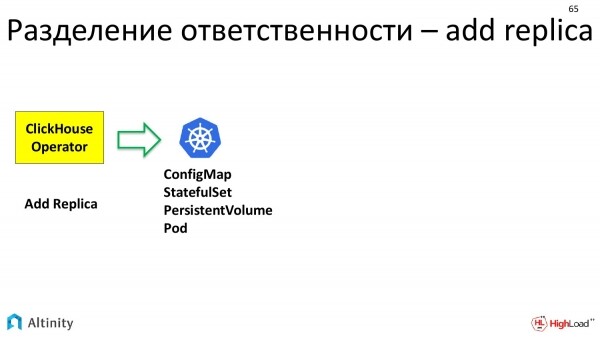
Všechno to připraví a předává dál do K8s. Říká, že potřebuje ConfigMap, StatefulSet, Volume. Kubernetes to zpracovává. Nahrává základní jednotky, se kterými operuje.
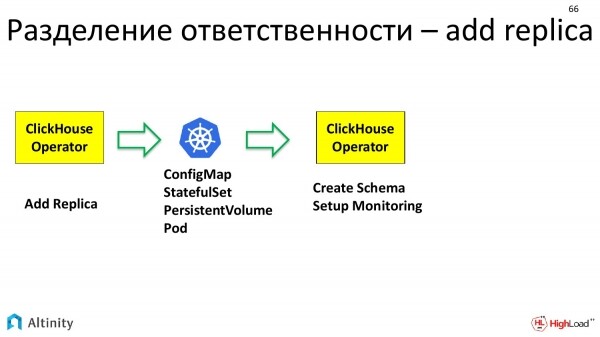
A znovu přichází do hry ClickHouse-operator. Už má fyzický pod, na kterém lze něco dělat. A ClickHouse-operator znovu pracuje v termínech oborové oblasti. Tj. konkrétně ClickHouse, protože pro zahrnutí repliky do klastru je třeba nejprve nastavit datové schéma, které v tomto klastru existuje. A za druhé, tuto repliku je třeba zahrnout do monitorování, aby byla dobře sledována. To vše operátor nastavuje.
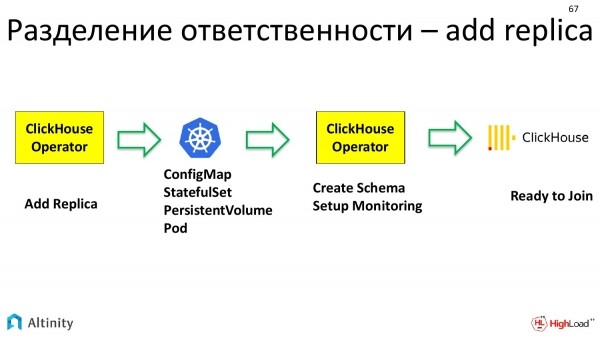
A teprve poté do hry vstupuje samotný ClickHouse, tedy další vysoce úrovňový prvek. To už je databáze. Má svůj instance, další nakonfigurovanou replikaci, která je připravena připojit se do clusteru.
Vyplývá z toho, že řetězec vykonávání a rozdělení odpovědnosti při přidávání repliky je dost dlouhý.
Pokračujeme v našich praktických úlohách. Pokud již cluster existuje, je možné provést migraci konfigurace.
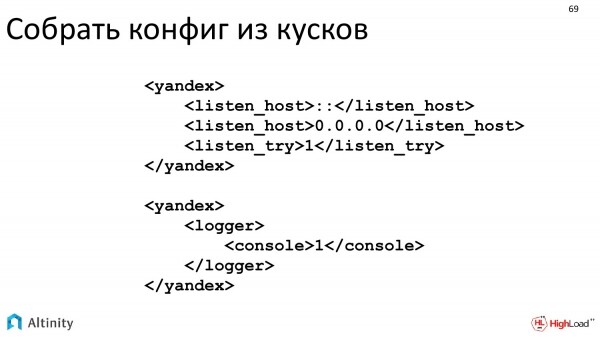
Upravili jsme to tak, aby do existujícího xml, které ClickHouse chápe, bylo možné propustit skrz.
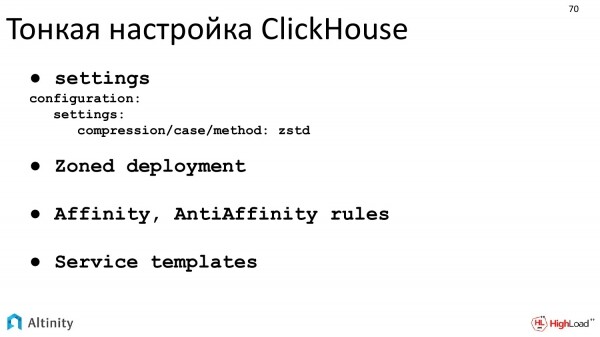
Je možné provést jemné ladění ClickHouse. Právě zoned deployment – to je to, o čem jsem hovořil při vysvětlování hostPath, místního úložiště. Toto je správný způsob, jak provést zoned deployment.
Další praktická úloha – to je monitoring.
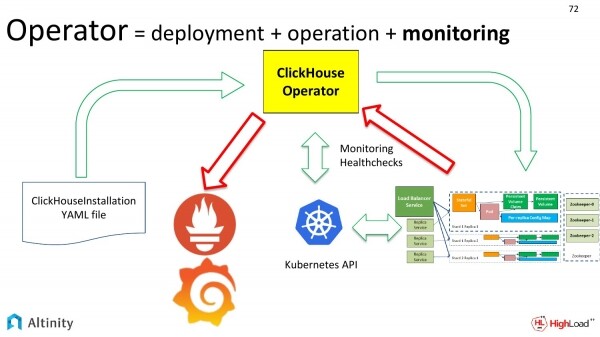
Pokud se náš cluster mění, musíme pravidelně nastavovat monitoring.
Podívejme se na schéma. Zelené šipky jsme již probrali. Nyní se podívejme na červené šipky. To je to, jak chceme monitorovat náš cluster. Jak metriky z clustru ClickHouse přicházejí do Prometheus a poté do Grafana.
Jaká je obtížnost spojená s monitoringem? Proč se to prezentuje jako nějaký úspěch? Obtížnost spočívá právě v dynamice. Když máme jeden statický cluster, můžeme monitoring nastavit jednou a víc se tím nezabývat.
Ale pokud máme mnoho clusterů, nebo se neustále něco mění, proces je dynamický. A neustálé přenastavování monitoringu je plýtváním zdroji a časem, tedy i prostou leností. To je třeba automatizovat. Obtížnost spočívá právě v dynamice procesu. A operátor to velmi dobře automatizuje.
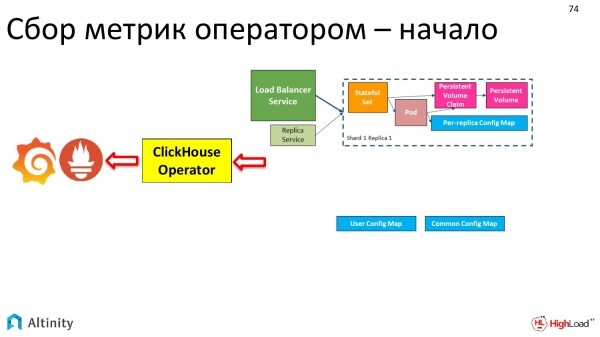
Jak se náš cluster vyvíjel? Zpočátku vypadal takto.
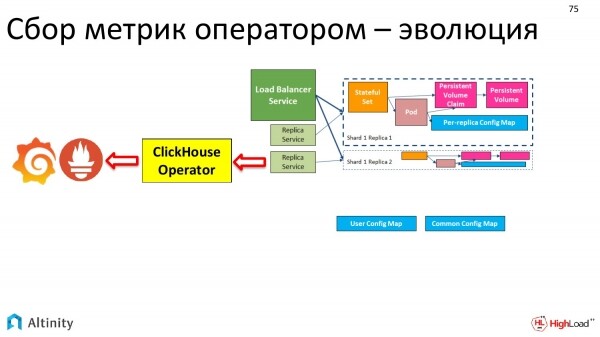
Pak vypadal takto.
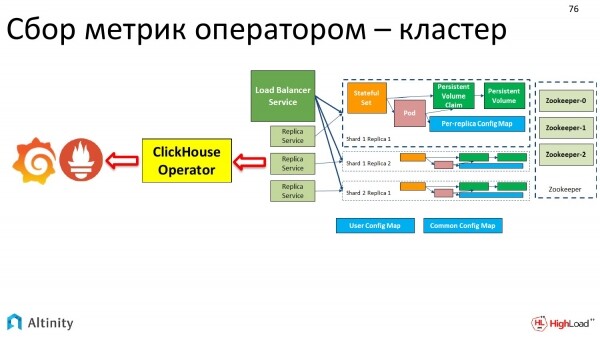
Nakonec se stal takovýmto.
A monitoring se provádí automaticky operátorem. Jediný vstup.
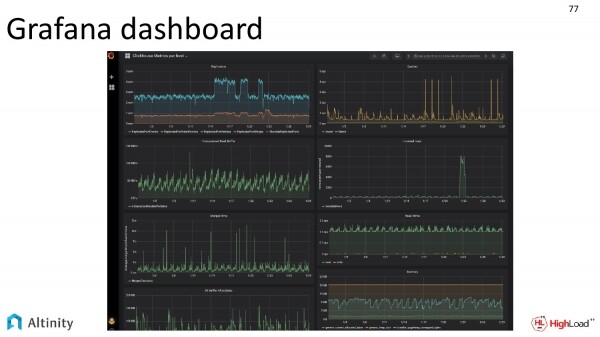
A my jen na výstupu sledujeme v Grafana dashboardu, jak uvnitř našich clusterů pulzuje život.
Mimochodem, Grafana dashboard také přichází s naším operátorem přímo ve zdrojových kódech. Můžete se připojit a používat to. Tento snímek obrazovky mi naši DevOps poskytli.
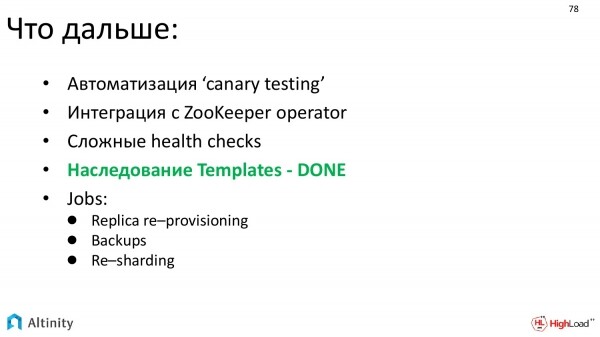
Kam bychom chtěli směřovat dál? To je:
- Rozvíjet automatizaci testování. Hlavním cílem je automatizované testování nových verzí.
- Také velmi chceme automatizovat integraci se ZooKeeperem. A máme v plánu integrovat se s ZooKeeper-operator. Tedy, pro ZooKeeper byl napsán operator a bylo by logické, aby se dva operátoři začali integrovat pro vytvoření pohodlnějšího řešení.
- Chceme provést složitější kontroly životaschopnosti.
- Zelenou jsem vyznačil to, co máme na dosah, dědění Templates – hotovo, t.j. s dalším vydáním operátora už budeme mít dědění šablon. To je mocný nástroj, který umožňuje vytvářet složité konfigurace z kousků.
- A chceme automatizaci složitých úloh. Hlavní z nich je Re-sharding.
Pojďme provést mezisoučet.
Co dostáváme na výstupu? A má to smysl nebo nemá? Měli bychom vůbec zkoušet dostat databázi do Kubernetes a aplikovat operátora jako celek a Alitnity-operátora konkrétně?
Na výstupu dostáváme:
- Významné zjednodušení a automatizaci konfigurace, nasazení a také údržby.
- Okamžitě integrované monitorování.
- A hotové k použití kodifikované šablony pro složité situace. Už není potřeba ručně přidávat repliky. To dělá operator.
Zůstala jen poslední otázka. Už máme databázi v Kubernetes, virtualizaci. Jaká je výkonnost takového řešení, zejména vzhledem k tomu, že ClickHouse je optimalizován na výkon?
Odpověď – všechno je v pořádku! Nebudu se podrobně rozepisovat, to je téma samostatné přednášky.
Ale existuje takový projekt, jako je TSBS. Jaký je jeho hlavní úkol? Je to testování databází na výkon. Je to pokus porovnat teplé s teplým, měkké s měkkým.
Jak to funguje? Generuje se jeden soubor dat. Pak se tento soubor dat na stejném souboru testů zkouší na různých databázích. A každá databáze řeší jeden úkol tak, jak umí. A pak lze výsledky porovnávat.
Už podporuje velké množství databází. Vybral jsem tři hlavní. To jsou:
- TimescaleDB.
- InfluxDB.
- ClickHouse.
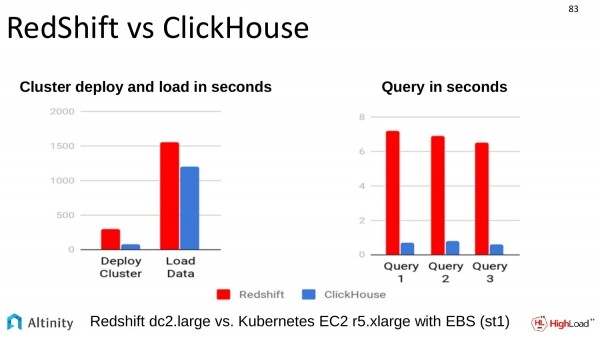
Bylo také provedeno srovnání s jiným podobným řešením. Srovnání s RedShift. Srovnání proběhlo na Amazonu. ClickHouse také všechny v této otázce dobře překonává.
Jaké závěry lze učinit z toho, co jsem řekl?
- DB v Kubernetes je možné. Pravděpodobně je možné jakékoli, ale celkově to vypadá, že to jde. ClickHouse v Kubernetes určitě funguje prostřednictvím našeho operátora.
- Operator pomáhá automatizovat procesy a skutečně usnadňuje život.
- Výkon je normální.
- A, jak se domníváme, to lze a je třeba použít.
Open source – připojte se!
Jak už jsem řekl, operátor je plně open source produkt, takže by bylo skvělé, kdyby co nejvíce lidí jej využilo. Připojte se! Čekáme na vás všechny!
Děkuji všem!
Otázky
Děkuji za přednášku! Jmenuji se Anton. Jsem z firmy SEMrush. Zajímá mě, co se týče logování. O monitorování se slyší, ale o logování nic, pokud mluvíme o celém klastru. U nás například máme klastr na hardware. A používáme centralizované logování, sbíráme standardními prostředky do jedné hromady. A potom z toho vytahujeme zajímavá data.
Dobrá otázka, tzn. logování je v seznamu úkolů. Náš operátor to zatím automatizuje. Je to stále ve vývoji, projekt je stále docela mladý. Uvědomujeme si potřebu logování. Je to také velmi důležité téma. A je to snad stejně důležité jako monitorování. Ale jako první na realizaci bylo monitorování. Logování bude. Snažíme se automatizovat všechny aspekty fungování klastru. Proto odpověď – aktuálně operátor to bohužel neumí, ale je to v plánu, budeme to dělat. Pokud máte zájem se připojit, tak prosím pull request.
Dobrý den! Děkuji za přednášku! Mám standardní otázku spojenou s Persistent Volumes. Když vytváříme konfiguraci tímto operátorem, jak operátor určuje, na které nódě máme připojený nějaký disk nebo složku? Musíme mu předem vysvětlit, že, prosím, umístěte náš ClickHouse právě na těch nódách, kde je disk?
Pokud se nepletu, tato otázka je pokračováním local storage, zejména části týkající se hostPath. Je to jako vysvětlit celému systému, že pod má být spuštěn právě na takové nódě, na kterou máme fyzicky připojený disk, který je namontován na takovémto cestě. To je celá sekce, kterou jsem se dotkl velmi povrchně, protože odpověď je dost velká.
Ve zkratce to vypadá takto. Musíme samozřejmě provést provisioning těchto objemů. V současné době v místním úložišti není dynamický provisioning, takže DevOps musí sami upravit disky, tyto objemy. A musí vysvětlit Kubernetes provisioning, že budou mít Persistent volumes určité třídy, které se nacházejí na určitých uzlech. Pak bude potřeba vysvětlit Kubernetes, že pody, které vyžadují určitou třídu místního úložiště, musí být podle štítků plánovány pouze na určité uzly. K tomu má operator možnost přiřadit nějaký štítek a jeden na instanci hostitele. A stane se, že pody budou Kubernetesem směrovány k spuštění pouze na uzlích, které splňují požadavky, štítky, jednoduše řečeno. Administrátoři přiřazují štítky, provádějí provisioning disků ručně. A pak to škáluje.
A právě třetí varianta místního úložiště pomáhá to trochu usnadnit. Jak jsem již zdůraznil, jde o pečlivou práci na nastavení, která na výstupu pomáhá dosáhnout maximální výkon.
Mám ještě jednu otázku, která s tím souvisí. Kubernetes byl navržen tak, že nás nezajímá, zda ztratíme uzel. Co v tomto případě dělat, pokud jsme ztratili uzel, na kterém máme shard?
Ano, Kubernetes byl původně koncipován tak, že naše vztahy k našim podům jsou jako k dobytku, a nyní každý disk se stává něčím jako domácím mazlíčkem. Existuje problém, že je nemůžeme jen tak vyhodit. A vývoj Kubernetes směřuje k tomu, že není možné na to pohlížet filozoficky, jako na plně vyhazovatelné zdroje.
Nyní praktická otázka. Co dělat, pokud jste ztratili uzel, na kterém byl disk? Tady se problém řeší na vyšší úrovni. V případě ClickHouse máme repliky, které fungují na úrovni nad tím, tj. na úrovni ClickHouse.
Jaká je tedy dispozice? Za to, aby se neztratila data, odpovídá DevOps. Musí správně nastavit replikaci a musí sledovat, aby se replikace prováděla. V repliku na úrovni ClickHouse by měly být data zdvojeny. To není úkol, který řeší operator. A není to úkol, který řeší samotný Kubernetes. Je to na úrovni ClickHouse.
Co dělat, pokud se vám odpojí železný uzel? A musíte nainstalovat druhý, správně na něm zprovoznit disk, aplikovat štítky. A poté splní požadavky, aby mohl Kubernetes spustit instanci podu. Kubernetes jej spustí. Vždyť máte méně podů, než je zapotřebí. Projde cyklem, který jsem ukazoval. A na nejvyšší úrovni ClickHouse pochopí, že k nám přišla replikace, ještě je prázdná a na ni je potřeba začít nalévat data. Tedy tento proces je ještě špatně automatizovaný.
Děkuji za přednášku! Když se dějí různé potíže, selže operátor a restartuje se, a v tuto chvíli přicházejí události, nějak je zpracováváte?
Co se stane, když operátor selže a restartuje se, že?
Ano. A v ten moment přicházely události.
Úkol, co dělat v tomto případě, je částečně rozdělen mezi operátora a Kubernetes. Kubernetes má možnost přehrají události, které se staly. Přehraje je. A úkol operátora je zajistit, aby, když došlo k replay logu událostí, tyto události byly idempotentní. Aby opakované přijetí stejné události neporušilo náš systém. A náš operátor s tímto úkolem obstojí.
Dobrý den! Děkuji za přednášku! Dmitrij Zavyalov, společnost Smedova. Plánuje se přidání do operátora možností nastavení s haproxy? Zajímá nás nějaký jiný vyrovnávač zatížení kromě standardního, který by byl inteligentní a chápal, že je tam skutečně ClickHouse.
Mluvíte o Ingress?
Ano, Ingress nahradit za haproxy. V haproxy můžete uvést topologii clusteru, kde má repliky.
Zatím jsme o tom nepřemýšleli. Pokud je to pro vás důležité a můžete vysvětlit, proč to potřebujete, mohli bychom to realizovat, zejména pokud byste chtěli participovat. Rychlá odpověď – ne, v současnosti tuto funkčnost nemáme. Děkujeme za podnět, podíváme se na to. A pokud ještě vysvětlíte use case a proč je to potřeba v praxi, například vytvoříte issues na GitHubu, bude to výborné.
Už existují.
Dobře. Jsme otevřeni všem návrhům. A haproxy je na seznamu úkolů. Seznam úkolů roste, a neubývá zatím. Ale to je dobré, to znamená, že produkt je žádaný.
Zdroj: habr.com
