

Pozn. přek.: V tomto článku společnost Banzai Cloud sdílí příklad použití svých speciálních nástrojů pro usnadnění správy Kafka v rámci Kubernetes. Uvedené pokyny ilustrují, jak lze určit optimální velikost infrastruktury a nastavit samotnou Kafka pro dosažení požadované propustnosti.
Apache Kafka je distribuovaná streamovací platforma pro vytváření spolehlivých, škálovatelných a vysoce výkonných systémů zpracování reálného času. Její úžasné možnosti lze rozšířit pomocí Kubernetes. K tomu jsme vyvinuli a nástroj s názvem . Tyto nástroje umožňují spouštět Kafka v Kubernetes a využívat její různé funkce, jako je jemné ladění konfigurace brokera, škálování na základě metrik s přerozdělením, rack awareness (vědomí o hardwarových zdrojích), "pohodlné" (graceful) nasazení aktualizací atd.
Vyzkoušejte Supertubes ve svém klastru:
curl https://getsupertubes.sh | sh a supertubes install -a --no-democluster --kubeconfigNebo se obraťte na . Také si můžete přečíst o některých funkcích Kafka, jejichž použití je automatizováno pomocí Supertubes a Kafka operátora. O těchto funkcích jsme již psali v blogu:
- ;
- ;
- ;
- ;
- ;
- ;
- .
Pokud se rozhodnete nasadit klastr Kafka v Kubernetes, pravděpodobně se setkáte s problémem určení optimální velikosti základní infrastruktury a nutností jemně ladit konfiguraci Kafka tak, aby vyhovovala požadavkům na propustnost. Maximální výkon každého brokera je určen výkonem komponentů infrastruktury, které ho tvoří, jako je paměť, procesor, rychlost disku, šířka pásma sítě atd.
Ideálně by měla být konfigurace brokera nastavena tak, aby všechny prvky infrastruktury pracovaly na maximální výkon. Ve skutečnosti je však takové nastavení velmi složité. Je pravděpodobnější, že uživatelé budou konfigurovat brokery tak, aby maximalizovali využití jednoho nebo dvou komponent (disku, paměti nebo procesoru). Obecně platí, že broker dosahuje maximálního výkonu, když jeho konfigurace umožňuje využití nejpomalejšího komponentu "naplno". Tak můžeme získat představu o zátěži, se kterou si jeden broker dokáže poradit.
Teoreticky můžeme také odhadnout počet brokerů potřebných pro práci se stanovenou zátěží. V praxi je však možností nastavení na různých úrovních tolik, že je velmi obtížné (pokud ne nemožné) posoudit potenciální výkon určité konfigurace. Jinými slovy, je velmi složité naplánovat konfiguraci na základě stanoveného výkonu.
Pro uživatele Supertubes obvykle uplatňujeme následující postup: začínáme s určitou konfigurací (infrastruktura + nastavení), poté měříme její výkon, korigujeme nastavení brokera a proces opakujeme. Toto se děje, dokud není plně využit potenciál nejpomalejšího komponentu infrastruktury.
Tímto způsobem získáváme jasnější představu o tom, kolik brokerů je potřebných pro cluster, aby si poradil s určitou zátěží (počet brokerů také závisí na dalších faktorech, jako je minimální počet replik zpráv pro zajištění odolnosti, počet leaderů partition atd.). Kromě toho získáváme představu o tom, pro který infrastrukturní komponent je žádoucí vertikální škálování.
V tomto článku se budeme věnovat krokům, které podnikáme, abychom „vytěžili maximum“ z nejpomalejších komponent v počátečních konfiguracích a změřili propustnost clusteru Kafka. Vysoce odolná konfigurace vyžaduje alespoň tři fungující brokery (min.insync.replicas=3), rozložených do tří různých zón dostupnosti. K nastavení, škálování a monitorování infrastruktury Kubernetes používáme naši vlastní platformu pro správu kontejnerů pro hybridní cloudy — . Podporuje on-premise (bare metal, VMware) a pět typů cloudů (Alibaba, AWS, Azure, Google, Oracle), jakož i libovolné jejich kombinace.
Myšlenky na infrastrukturu a konfiguraci klastru Kafka
Pro níže uvedené příklady jsme vybrali AWS jako poskytovatele cloudových služeb a EKS jako distribuci Kubernetes. Podobnou konfiguraci lze realizovat pomocí — distribuce Kubernetes od Banzai Cloud, certifikovaná CNCF.
Disk
Amazon nabízí různé . Základem gp2 a io1 jsou SSD disky, avšak pro zajištění vysoké propustnosti gp2 spotřebovává nasbírané kredity I/O credits, proto jsme preferovali typ io1, který nabízí stabilní vysokou propustnost.
Typy instancí
Výkon Kafka silně závisí na stránkovém cache operačního systému, proto potřebujeme instance se dostatečným množstvím paměti pro brokery (JVM) a stránkový cache. Instance c5.2xlarge je dobrým začátkem, neboť má 16 GB paměti a Její nevýhodou je, že dokáže poskytovat maximální výkon pouze po dobu 30 minut každých 24 hodin. Pokud pracovní zátěž vyžaduje maximální výkon po delší dobu, je třeba se poohlédnout po jiných typech instancí. To jsme tak učinili, a zastavili se na c5.4xlarge.Zajišťuje maximální propustnost ve 593,75 MB/s.Maximální propustnost svazku EBS io1 je vyšší než u instance c5.4xlarge., proto je nejpomalejším prvkem infrastruktury propustnost I/O tohoto typu instance (což by měly také potvrdit výsledky našich zátěžových testů).
Síť
Propustnost sítě by měla být dostatečně vysoká ve srovnání s výkonem instance VM a disku, jinak se síť stává úzkým místem. V našem případě síťové rozhraní c5.4xlarge. podporuje rychlost až 10 Gb/s, což je výrazně vyšší než propustnost I/O instance VM.
Nasazení brokerů
Brokeři by měli být nasazeni (plánováni v Kubernetes) na dedikované uzly, aby se vyhnuli soutěžení s jinými procesy o zdroje CPU, paměti, sítě a disku.
Verze Java
Logickou volbou je Java 11, protože je kompatibilní s Dockerem, což znamená, že JVM správně identifikuje dostupné procesory a paměť pro kontejner, ve kterém broker běží. S vědomím, že limity CPU jsou důležité, JVM interně a transparentně nastavuje počet GC a JIT-kompilátorových vláken. Použili jsme obraz Kafka banzaicloud/kafka:2.13-2.4.0, který zahrnuje verzi Kafka 2.4.0 (Scala 2.13) na Java 11.
Pokud se chcete dozvědět více o Java/JVM na Kubernetes, podívejte se na naše následující publikace:
- ;
- .
Nastavení paměti brokera
Existují dva klíčové aspekty při nastavování paměti brokera: nastavení pro JVM a pro Kubernetes pod. Limit paměti stanovený pro pod musí být větší než maximální velikost heap, aby měl JVM místo pro metaprostor Java, který je ve vlastní paměti, a pro stránkovou cache operačního systému, kterou Kafka aktivně využívá. V našich testech jsme spouštěli brokery Kafka s parametry -Xmx4G -Xms2G, zatímco limit paměti pro pod činil 10 Gi. Vezměte prosím na vědomí, že nastavení paměti pro JVM lze automaticky získat pomocí -XX:MaxRAMPercentage a -X:MinRAMPercentage, vycházející z limitu paměti pro pod.
Nastavení CPU brokera
Obecně lze zvýšit výkon zvyšováním paralelismu pomocí zvyšování počtu vláken, které Kafka používá. Čím více procesorů je pro Kafka k dispozici, tím lépe. V našem testu jsme začali s limitem 6 procesorů a postupně (iteracemi) jsme zvyšovali jejich počet na 15. Kromě toho jsme nastavili num.network.threads=12 v nastavení brokera, abychom zvýšili počet vláken, které přijímají data ze sítě a posílají je. Hned jsme zjistili, že následnické brokery nedokážou rychle získávat repliky, a tak jsme zvýšili num.replica.fetchers na 4, abychom zvýšili rychlost, s jakou následnické brokery replicovaly zprávy od leaderů.
Nástroj pro generování zátěže
Je třeba zajistit, aby potenciál vybraného zátěžového generátoru nevyprchal dříve, než dosáhne klastr Kafka (jehož benchmark se provádí) maximální zátěže. Jinými slovy, je nutné provést předběžnou hodnocení možností nástroje pro generování zátěže a vybrat pro něj typy instance s dostatečným počtem procesorů a paměti. V tomto případě náš nástroj vygeneruje více zátěže, než je schopen zpracovat klastr Kafka. Po mnoha experimentech jsme se rozhodli pro tři instance c5.4xlarge., na každé z nich byl spuštěn generátor.
Benchmarking
Měření výkonnosti je iterativní proces zahrnující následující fáze:
- nastavení infrastruktury (klastr EKS, klastr Kafka, nástroj pro generování zátěže a také Prometheus a Grafana);
- generování zátěže po určité období pro filtrování náhodných odchylek ve shromážděných výkonnostních ukazatelích;
- doladění infrastruktury a konfigurace brokera na základě pozorovaných výkonnostních ukazatelů;
- opakování procesu, dokud není dosaženo požadované úrovně propustnosti klastru Kafka. Ta by měla být stabilně reprodukovatelná a vykazovat minimální variace propustnosti.
V následující části jsou popsány kroky, které byly provedeny během benchmarku testovacího klastru.
Nástroje
Pro rychlé uvedení do provozu základní konfigurace, generování zátěže a měření výkonnosti byly použity následující nástroje:
- pro organizaci klastru EKS od Amazonu s (pro sběr metrik Kafka a infrastruktury) a (pro vizualizaci těchto metrik). Využili jsme integrované v služby, které zajišťují federativní monitorování, centralizované shromažďování logů, skenování zranitelností, obnovení po havárii, podnikové zabezpečení a mnoho dalšího.
- — nástroj pro zátěžové testování klastru Kafka.
- Panely Grafana pro vizualizaci metrik Kafka a infrastruktury: , .
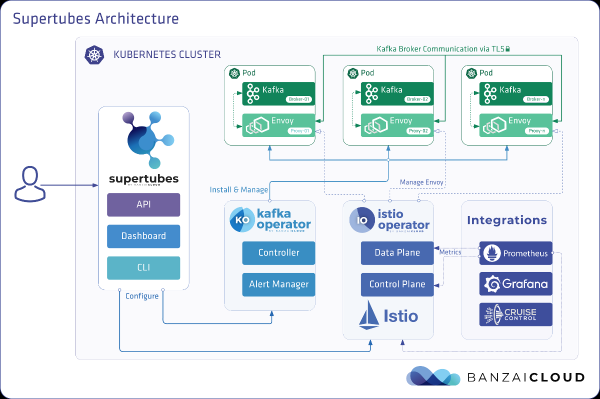
- Supertubes CLI pro maximálně jednoduché nastavení klastry Kafka v Kubernetes. Zookeeper, Kafka operator, Envoy a mnoho dalších komponent je nainstalováno a správně nakonfigurováno pro spuštění produkční klastry Kafka v Kubernetes.
- Pro instalaci supertubes CLI využijte pokyny uvedené .
Klastr EKS
Připravte klastr EKS s dedikovanými pracovními uzly c5.4xlarge. v různých zónách dostupnosti pro pod'y s brokerem Kafka, stejně jako vyhrazené uzly pro generátor zátěže a monitorovací infrastrukturu.
banzai cluster create -f https://raw.githubusercontent.com/banzaicloud/kafka-operator/master/docs/benchmarks/infrastructure/cluster_eks_202001.jsonJakmile klastr EKS začne fungovat, zapněte jeho integrovanou — ta nasadí Prometheus a Grafana do klastru.
Systémové komponenty Kafka
Nainstalujte systémové komponenty Kafka (Zookeeper, kafka-operator) v EKS pomocí supertubes CLI:
supertubes install -a --no-democluster --kubeconfigKlastr Kafka
Ve výchozím nastavení se v EKS používají svazky EBS typu gp2, proto je nutné vytvořit samostatnou třídu úložiště založenou na svazcích io1 pro klastr Kafka:
kubectl create -f - <<EOF
apiVersion: storage.k8s.io/v1
kind: StorageClass
metadata:
  name: fast-ssd
provisioner: kubernetes.io/aws-ebs
parameters:
  type: io1
  iopsPerGB: "50"
  fsType: ext4
volumeBindingMode: WaitForFirstConsumer
EOF
Nastavte pro brokery parametr min.insync.replicas=3 a nasadte pod'y brokerů na uzlech ve třech různých zónách dostupnosti:
supertubes cluster create -n kafka --kubeconfig -f https://raw.githubusercontent.com/banzaicloud/kafka-operator/master/docs/benchmarks/infrastructure/kafka_202001_3brokers.yaml --wait --timeout 600Témata
Současně jsme spouštěli tři instance generátoru zátěže. Každá z nich zapisuje do svého tématu, což znamená, že potřebujeme celkem tři témata:
supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
  name: perftest1
spec:
  name: perftest1
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF

supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
    name: perftest2
spec:
  name: perftest2
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF

supertubes cluster topic create -n kafka --kubeconfig  -f -<<EOF
apiVersion: kafka.banzaicloud.io/v1alpha1
kind: KafkaTopic
metadata:
  name: perftest3
spec:
  name: perftest3
  partitions: 12
  replicationFactor: 3
  retention.ms: '28800000'
  cleanup.policy: delete
EOF
Pro každé téma je faktor replikace 3 — minimálně doporučovaná hodnota pro vysoce dostupné produkční systémy.
Nástroj pro generování zátěže
Spustili jsme tři instance zátěžového generátoru (každá zapisovala do samostatného tématu). Pro podů generátoru zátěže je nutné nastavit affinita uzlu, aby byly plánovány pouze na vyhrazené uzly:
apiVersion: extensions/v1beta1
kind: Deployment
metadata:
  labels:
    app: loadtest
  name: perf-load1
  namespace: kafka
spec:
  progressDeadlineSeconds: 600
  replicas: 1
  revisionHistoryLimit: 10
  selector:
    matchLabels:
      app: loadtest
  strategy:
    rollingUpdate:
      maxSurge: 25%
      maxUnavailable: 25%
    type: RollingUpdate
  template:
    metadata:
      creationTimestamp: null
      labels:
        app: loadtest
    spec:
      affinity:
        nodeAffinity:
          requiredDuringSchedulingIgnoredDuringExecution:
            nodeSelectorTerms:
            - matchExpressions:
              - key: nodepool.banzaicloud.io/name
                operator: In
                values:
                - loadgen
      containers:
      - args:
        - -brokers=kafka-0:29092,kafka-1:29092,kafka-2:29092,kafka-3:29092
        - -topic=perftest1
        - -required-acks=all
        - -message-size=512
        - -workers=20
        image: banzaicloud/perfload:0.1.0-blog
        imagePullPolicy: Always
        name: sangrenel
        resources:
          limits:
            cpu: 2
            memory: 1Gi
          requests:
            cpu: 2
            memory: 1Gi
        terminationMessagePath: /dev/termination-log
        terminationMessagePolicy: File
      dnsPolicy: ClusterFirst
      restartPolicy: Always
      schedulerName: default-scheduler
      securityContext: {}
      terminationGracePeriodSeconds: 30
Několik bodů, na které je třeba dávat pozor:
- Zátěžový generátor vytváří zprávy o velikosti 512 bajtů a publikuje je v Kafka po dávkách po 500 zprávách.
- Pomocí argumentu
-required-acks=allje publikace považována za úspěšnou, když všechny synchronizované repliky zprávy byly přijaty a potvrzeny brokery Kafka. To znamená, že v benchmarku měříme nejen rychlost práce leadů, kteří přijímají zprávy, ale i jejich následovníků, kteří replikují zprávy. Úkol této testu neobsahuje hodnocení rychlosti čtení spotřebiteli (consumers) nedávno přijatých zpráv, které zatím zůstávají v paměťové cache OS, a její srovnání s rychlostí čtení zpráv uložených na disku. - Zátěžový generátor současně spouští 20 workerů (
-workers=20). Každý worker obsahuje 5 producerů, kteří společně využívají připojení workera k clusteru Kafka. V důsledku toho má každý generátor 100 producentů, kteří odesílají zprávy do clusteru Kafka.
Sledování stavu clusteru
Během zátěžového testování klastru Kafka jsme také sledovali jeho stav, abychom se ujistili, že nedochází k restartování podů, nesynchronizovaným replikám a maximální propustnosti s minimálními výkyvy:
- Generátor zátěže zapisuje standardní statistiky o počtu publikovaných zpráv a úrovni chyb. Procento chyb by mělo zůstat na hodnotě
0,00%. - , implementovaný pomocí kafka-operatora, poskytuje monitorovací panel, na kterém můžeme také sledovat stav klastru. Pro zobrazení tohoto panelu zadejte:
supertubes cluster cruisecontrol show -n kafka --kubeconfig - Úroveň ISR (počet replik „in-sync“) shrink a expansion je 0.
Výsledky měření
3 brokery, velikost zprávy — 512 bytů
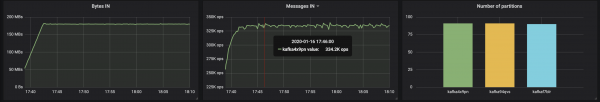
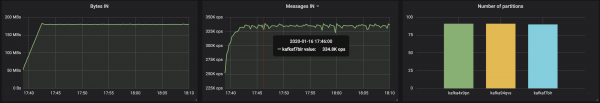
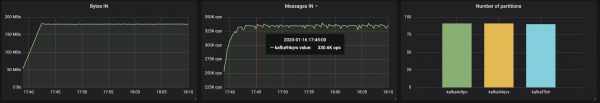
S partitiony, které jsou rovnoměrně rozloženy na třech brokerech, jsme dosáhli výkonu ~500 Mb/s (přibližně 990 tisíc zpráv za sekundu):
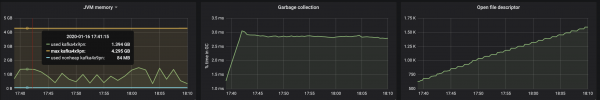
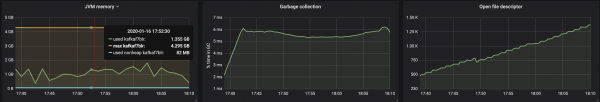
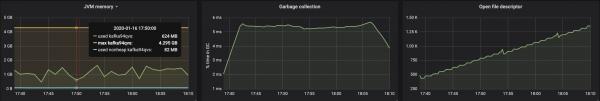
Spotřeba paměti virtuálním strojem JVM nepřekročila 2 Gb:
Propustnost disku dosáhla maximální propustnosti I/O uzlu na všech třech instancích, na kterých pracovaly brokery:
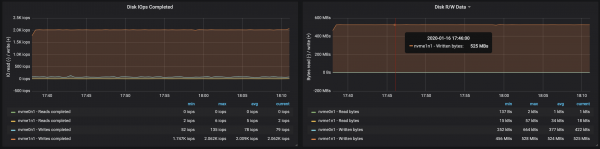
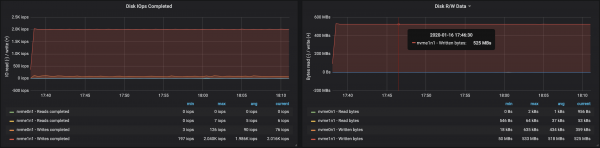
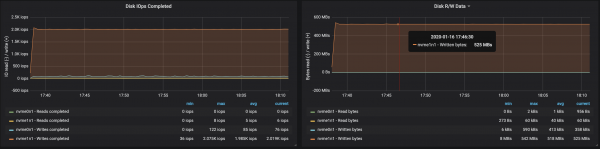
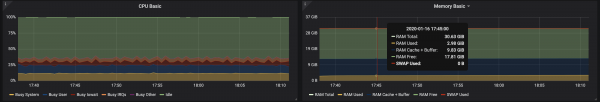
Z dat o využití paměti uzly vyplývá, že systémové vyrovnávání a cachování zabralo ~10-15 Gb:
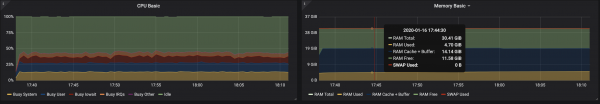
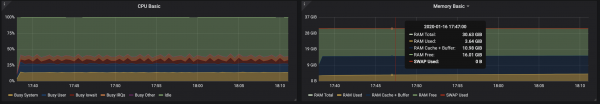
3 brokery, velikost zprávy — 100 bytů
Se snížením velikosti zpráv propustnost klesá přibližně o 15-20%: projevuje se čas strávený zpracováním každé zprávy. Dále se zatížení procesoru téměř zdvojnásobilo.
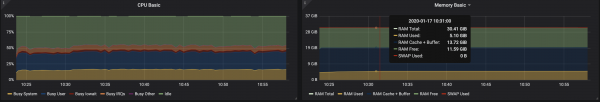
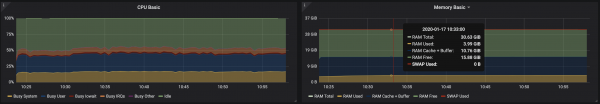
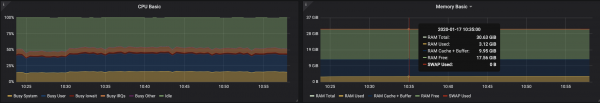
Protože na uzlech brokerů stále existují nevyužitá jádra, lze výkon zvýšit změnou konfigurace Kafka. To je složitý úkol, proto je lepší pro zvýšení propustnosti pracovat s většími zprávami.
4 brokery, velikost zprávy — 512 bytů
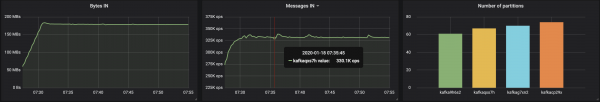
Výkon klastru Kafka lze snadno zvýšit jednoduše přidáním nových brokerů a zachováním rovnováhy partitionů (to zajišťuje rovnoměrné rozložení zátěže mezi brokery). V našem případě po přidání brokera vzrostla propustnost klastru na ~580 Mb/s (~1,1 milionu zpráv za sekundu). Růst byl menší, než se očekávalo: převážně to vysvětluje nerovnováha partitionů (ne všechny brokery pracují na svých maximálních možnostech).
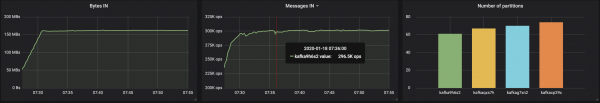
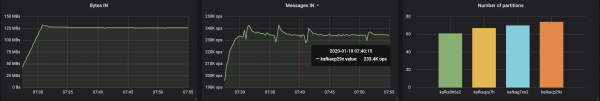
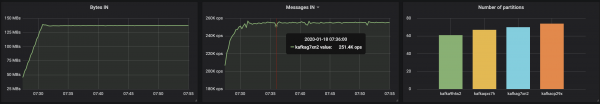
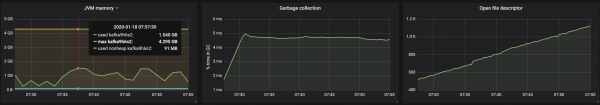
Spotřeba paměti strojům JVM zůstala pod 2 GB:
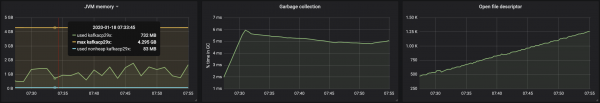
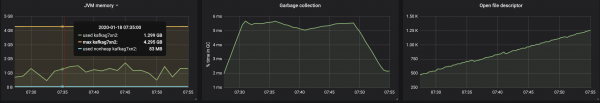
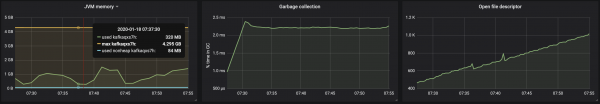
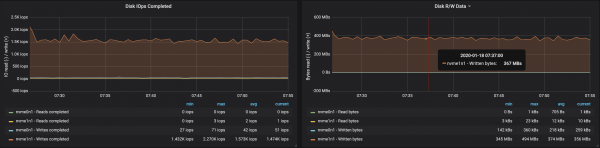
Práci brokerů se skladovacími prvky ovlivnil disbalanc partitionů:
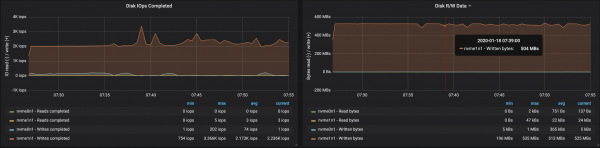
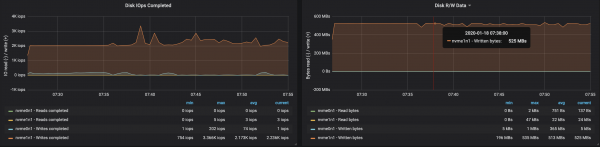
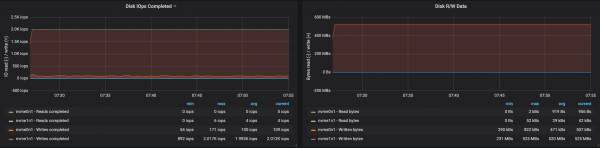
Závěry
Výše uvedený iterativní přístup může být rozšířen, aby pokryl složitější scénáře, zahrnující stovky consumerů, repartitioning, hotfixy a restartování podů atd. To vše nám umožňuje vyhodnotit limity schopností clusteru Kafka v různých podmínkách, odhalit úzká místa v jeho činnosti a najít způsoby, jak s nimi bojovat.
Vyvinuli jsme Supertubes pro rychlé a snadné nasazení clusteru, jeho konfiguraci, přidávání/odebírání brokerů a témat, reakci na upozornění a zajištění správného fungování Kafka v Kubernetes jako celku. Naším cílem je pomoci soustředit se na hlavní úkol ('generovat' a 'spotřebovávat' zprávy Kafka), zatímco veškerou těžkou práci přenecháme Supertubes a Kafka operatorovi.
Pokud vás zajímají technologie a projekty Open Source Banzai Cloud, sledujte naši společnost na , nebo .
P.S. od překladatele
Přečtěte si také náš blog:
- «»;
- «»;
- «».
Zdroj: habr.com
