

Ahoj, Habr! Jmenuji se Maxim Vasiljev, pracuji jako analytik a projektový manažer ve FINCH. Dnes bych rád pověděl, jak jsme pomocí ElasticSearch dokázali zpracovat 15 milionů dotazů za 6 minut a optimalizovat každodenní zátěž na webu jednoho z našich klientů. Bohužel se musíme obejít bez jmen, protože máme NDA, doufáme, že obsah článku tím nebude poškozen. Pojďme začít.
Jak je projekt strukturován
Na našem backendu vytváříme služby, které zajišťují funkčnost webových stránek a mobilní aplikace našeho klienta. Celkovou strukturu lze vidět na schématu:
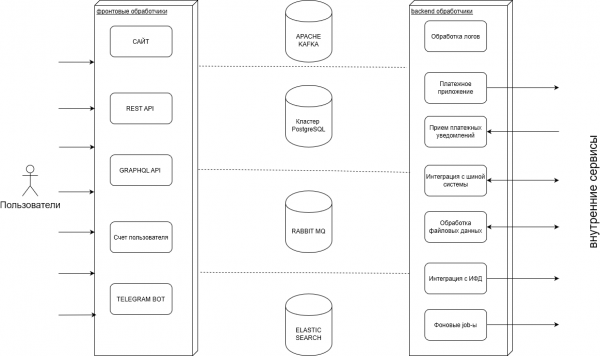
Během práce zpracováváme velké množství transakcí: nákupů, výplat, operací s uživatelskými zůstatky, pro které uchováváme mnoho logů, a také tyto údaje naimportujeme a exportujeme do externích systémů.
Probíhají také opačné procesy, kdy získáváme údaje od klienta a předáváme je uživatelům. Kromě toho existují ještě procesy související s platbami a bonusovými programy.
Krátký úvod
Původně jsme jako jediné úložiště dat používali PostgreSQL. Jeho standardní výhody pro DBMS: existence transakcí, vyspělý jazyk pro dotazy, široký nástroj pro integraci; v kombinaci s dobrou výkonností dlouho uspokojovaly naše potřeby.
Uchovávali jsme v Postgresu naprosto všechna data: od transakcí až po novinky. Ale počet uživatelů rostl a s ním i počet dotazů.
Pro představu, roční počet relací v roce 2017 pouze na desktopové verzi webu — 131 milionů. V roce 2018 — 125 milionů. V roce 2019 opět 130 milionů. Přidejte k tomu ještě 100-200 milionů z mobilní verze webu a mobilní aplikace a dostanete kolosální množství dotazů.
S růstem projektu přestal Postgres zvládat zátěž, měli jsme zpoždění — objevilo se velké množství rozmanitých dotazů, pro které jsme nedokázali vytvořit dostatek indexů.
Chápali jsme, že existuje potřeba jiných úložišť dat, která by splnila naše potřeby a uvolnila zátěž z PostgreSQL. Jako možné varianty jsme zvažovali Elasticsearch a MongoDB. Druhá možnost prohrávala v následujících bodech:
- Pomalejší rychlost indexace s rostoucím objemem dat v indexech. U Elastic rychlost nezávisí na objemu dat.
- Není zde plnotextové vyhledávání.
Tak jsme si vybrali Elastic a připravili se na přechod.
Přechod na Elastic.
1. Začali jsme přechod s vyhledávací službou pro prodejní místa. Náš klient má celkem přibližně 70 000 prodejních míst a zároveň jsou potřeba různé typy vyhledávání na webu a v aplikaci:
- Textové vyhledávání podle názvu obce.
- Geopočítání v daném rádiu od určitého bodu. Například pokud chce uživatel vidět, která prodejní místa jsou nejblíže jeho domu.
- Vyhledávání v určeném pásmu – uživatel označí obdélník na mapě a zobrazí se mu všechna místa v tomto radiusu.
- Vyhledávání podle dalších filtrů. Prodejní místa se liší sortimentem.
Pokud hovoříme o organizaci, máme v Postgresu zdroj dat jak podle mapy, tak podle novinek, a v Elastic se dělají snapshoty z originálních dat. Fakt je ten, že původně Postgres nezvládal vyhledávání podle všech kritérií. Nejen, že bylo hodně indexů, ale ty mohly také překrývat, takže plánovač Postgresu se ztrácel a nevěděl, který index použít.
2. Dalším na řadě byla sekce novinek. Na webu každý den vycházejí publikace, aby se uživatel neztratil v toku informací, je třeba data před vydáváním řadit. K tomu je potřeba hledání: na webu lze hledat dle textových shod a zároveň zapojit další filtry, které také běží přes Elastic.
3. Poté jsme přenesli zpracování transakcí. Uživatelé mohou na webu kupovat určité zboží a účastnit se soutěží. Po takových nákupech zpracováváme velké množství dat, zejména o víkendech a svátcích. Pro srovnání, pokud v běžné dny počet nákupů činí přibližně 1,5–2 miliony, během svátků může číslo dosáhnout 53 milionů.
Přitom je třeba data zpracovat co nejrychleji — uživatelé neradi čekají několik dní na výsledek. Přes Postgres takových lhůt jen těžko dosáhnete — často jsme dostávali zablokování a zatímco jsme zpracovávali všechny požadavky, uživatelé nemohli zkontrolovat, zda vyhráli nebo ne. To není pro podnikání příjemné, a proto jsme zpracování převedli na Elasticsearch.
Periodicita
Aktuálně jsou aktualizace nastaveny událostně, podle následujících podmínek:
- Prodejní místa. Jakmile k nám přicházejí data z externího zdroje, okamžitě spouštíme aktualizaci.
- Novinky. Jakmile je na webu upravena nějaká novinka, automaticky se odesílá do Elastic.
Zde je ještě jednou třeba zmínit výhody Elastic. V Postgres při odeslání dotazu musíte čekat, až jsou všechny záznamy poctivě zpracovány. V Elastic můžete odeslat 10 tisíc záznamů a okamžitě začít pracovat, aniž byste museli čekat, až se záznamy rozptýlí po všech Shards. Samozřejmě nějaký Shard nebo Replica nemusí vidět data okamžitě, ale velmi brzy budou všechna k dispozici.
Způsoby integrace
Existují 2 způsoby integrace s Elastic:
- Přes nativního klienta po TCP. Nativní ovladač postupně vychází z módy: přestávají jej podporovat a má velmi nepraktickou syntaxi. Proto jej prakticky nepoužíváme a snažíme se od něj zcela vzdát.
- Přes HTTP rozhraní, ve kterém lze používat jak JSON dotazy, tak syntaxi Lucene. To poslední je textový engine, který používá Elastic. V této variantě získáváme možnost Batch přes JSON dotazy po HTTP. Tento variant se snažíme využívat.
Díky HTTP rozhraní můžeme používat knihovny, které poskytují asynchronní implementaci HTTP klienta. Můžeme využít výhody Batch a asynchronního API, což v konečném důsledku dává vysoký výkon, který velmi pomohl v dnech velké akce (o tom níže)
Trochu čísel pro srovnání:
- Uložení uživatelů, kteří získali ceny v Postgres ve 20 vláknech bez seskupení: 460713 záznamů za 42 sekund
- Elastic + reaktivní klient na 10 vláknem + batch na 1000 prvků: 596749 záznamů za 11 sekund
- Elastic + reaktivní klient na 10 vláknem + batch na 1000 prvků: 23801684 záznamů za 4 minuty
Nyní jsme napsali manažer dotazů přes HTTP, který staví JSON, jako Batch/ne Batch a odesílá přes jakýkoli HTTP klient bez ohledu na knihovnu. Také lze vybrat, zda odesílat dotazy synchronně nebo asynchronně.
V některých integracích stále používáme oficiální transportní klient, ale to je jen otázka blízké refaktorizace. Přitom použijeme vlastní klient, postavený na základě Spring WebClient.
Velká akce
Jednou za rok se na projektu koná velká akce pro uživatele — to je ten pravý Highload, protože v tuto dobu pracujeme s desítkami milionů uživatelů současně.
Obvykle dochází k vrcholům zatížení během svátků, ale tato akce je na úplně jiné úrovni. Před dvěma lety jsme v den akce prodali 27 580 890 kusů zboží. Data byla zpracovávána více než půl hodiny, což způsobilo nepříjemnosti uživatelům. Uživatelé získali ceny za účast, ale bylo jasné, že proces je třeba zrychlit.
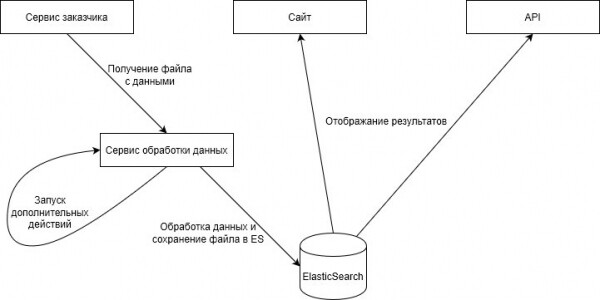
Na začátku roku 2019 jsme se rozhodli, že potřebujeme ElasticSearch. Celý rok jsme organizovali zpracování získaných dat v Elastic a jejich výstup do API mobilní aplikace a webové stránky. Nakonec jsme v dalším roce během akce zpracovali 15 131 783 záznamů za 6 minut.
Protože máme mnoho zájemců o nákup zboží a účast v soutěžích během akcí, je to dočasné opatření. Nyní posíláme aktuální informace do Elastic, ale do budoucna plánujeme archivní informace za minulými měsíci převést do Postgresu jako trvalé úložiště. Abychom nezaplavili index Elastic, který také má své limity.
Závěr / vývody
V současnosti jsme převedli do Elastic všechny služby, které jsme plánovali, a na tom jsme zatím udělali přestávku. Nyní nad hlavním trvalým úložištěm v Postgresu budujeme index v Elastic, který přebírá uživatelské zatížení.
Do budoucna plánujeme přenášet služby, pokud budeme chápat, že dotazy na data se stávají příliš rozmanitými a hledají se v neomezeném počtu sloupců. To už je úkol, který není pro Postgres.
Pokud budeme potřebovat fulltextové vyhledávání v funkcionalitě nebo pokud se objeví mnoho různorodých kritérií vyhledávání, víme už, že to je třeba převest do Elastic.
⌘⌘⌘
Děkujeme, že jste si přečetli. Pokud ve vaší společnosti také používají ElasticSearch a mají vlastní implementace, dejte nám vědět. Bude zajímavé se dozvědět, jak to dělají ostatní 🙂
Zdroj: habr.com
