

Analytická SGBD ClickHouse zpracovává mnoho různých řetězců a spotřebovává při tom zdroje. Aby se zrychlila práce systému, neustále se přidávají nová vylepšení. Vývojář ClickHouse Nikolaj Kočetov hovoří o řetězcovém datovém typu, včetně nového typu, LowCardinality, a vysvětluje, jak lze zrychlit práci s řetězci.
— Nejprve si ujasněme, jak můžeme uchovávat řetězce.
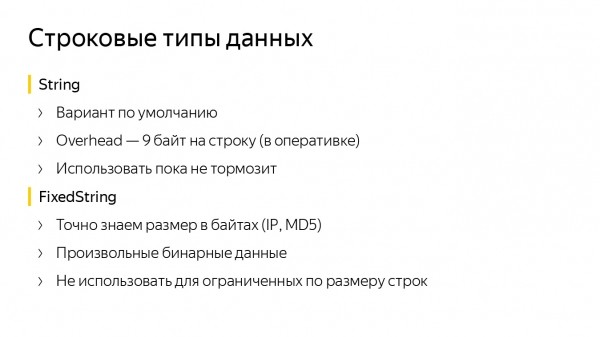
Máme řetězcové datové typy. String je ve výchozím nastavení velmi vhodný a měl by se používat téměř vždy. Má malý overhead — 9 bajtů na jeden řetězec. Pokud chceme, aby velikost řetězců byla pevně daná a známá předem, je lepší použít FixedString. U něj si můžeme nastavit potřebný počet bajtů, je vhodný pro data jako jsou IP adresy nebo hash funkce.
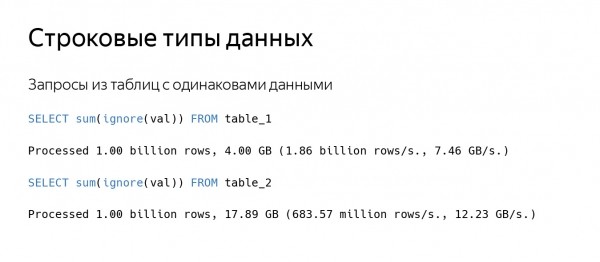
Samozřejmě, někdy něco zpomaluje. Představte si, že provádíte dotaz na tabulku. ClickHouse čte poměrně velké množství dat, řekněme rychlostí 100 GB/s, přičemž zpracovává málo řetězců. Máme dvě tabulky, které uchovávají téměř stejné údaje. Z druhé tabulky ClickHouse čte data rychleji, ale počet řetězců za sekundu je třikrát nižší.
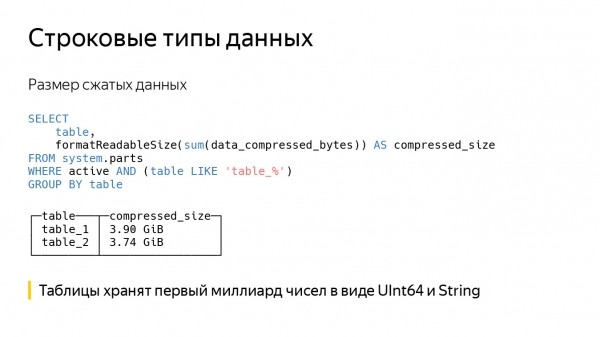
Pokud se podíváme na velikost komprimovaných dat, zjistíme, že je téměř stejná. Ve skutečnosti jsou v tabulkách zapsána stejná data — první miliarda čísel — pouze v prvním sloupci je uložena jako UInt64, zatímco ve druhém jako String. Protože tak druhý dotaz trvá déle, čte data z disku a dekomprimuje je.
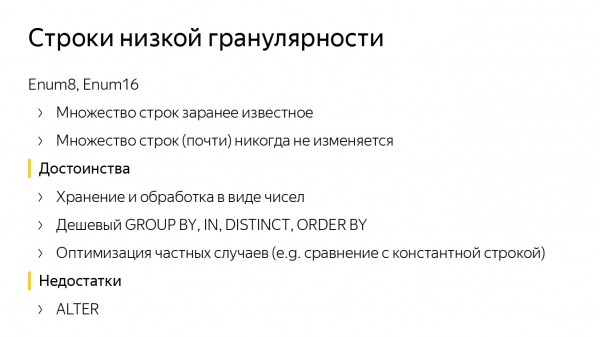
Zde je další příklad. Představme si, že existuje předem známá množina řetězců, která je omezena konstantou 1000 nebo 10 000 a téměř nikdy se nemění. Pro tuto situaci se hodí typ dat Enum, v ClickHouse existují dva — Enum8 a Enum16. Díky ukládání v Enum rychle zpracováváme dotazy.
V ClickHouse existují zrychlení pro GROUP BY, IN, DISTINCT a optimalizace pro některé funkce, například pro porovnání s konstantním řetězcem. Samozřejmě, že čísla v řetězci se nepřetypovávají, ale naopak se konstantní řetězec převádí na hodnotu Enum. Poté se to rychle porovnává.
Ale jsou tu i nevýhody. I když známe přesnou množinu řetězců, někdy se musí doplňovat. Přišla nová řetězec — musíme provést ALTER.
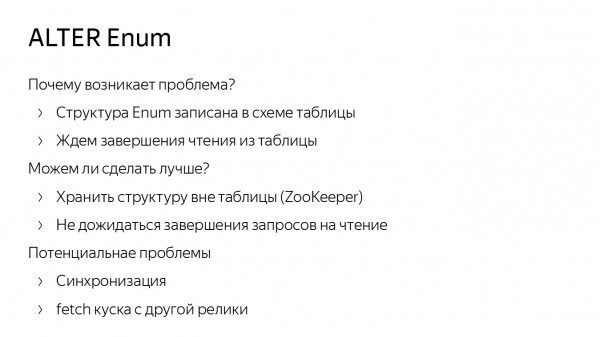
ALTER pro Enum v ClickHouse je realizován optimálně. Nepřepisujeme data na disku, ale ALTER mohou zpomalovat kvůli tomu, že struktury Enum jsou uchovávány ve schématu tabulky samotné. Proto musíme počkat na dotazy na čtení z tabulky, například.
Vznáší se otázka, zda lze to udělat lépe? Pravděpodobně ano. Můžeme uchovávat strukturu Enum nikoliv ve schématu tabulky, ale v ZooKeeperu. Mohou však nastat problémy se synchronizací. Například jedna replikace dostala data a jiná ne, a pokud má starý Enum, něco se rozbije. (V ClickHouse jsme téměř dokončili neblokující ALTER dotazy. Jakmile je dokončíme, nebude nutné čekat na dotazy na čtení.)
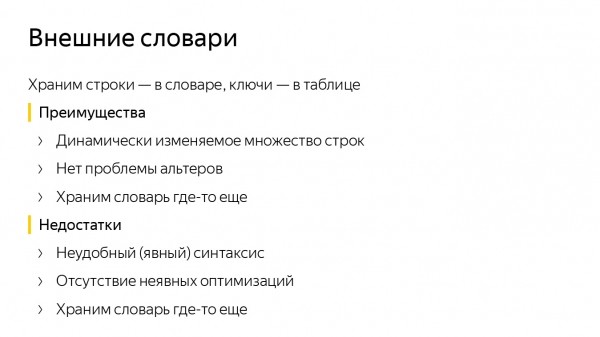
Abychom se nemuseli zabývat ALTER Enum, můžeme využít externí slovníky ClickHouse. Připomínám, že to je struktura dat ve formátu key-value uvnitř ClickHouse, pomocí které můžeme získávat data z externích zdrojů, například z tabulek MySQL.
Ve slovníku ClickHouse uchováváme mnoho různých řetězců a v tabulce jejich identifikátory ve formě čísel. Pokud potřebujeme získat řetězec, voláme funkci dictGet a pracujeme s ním. Poté nemusíme provádět ALTER. Chceme-li něco přidat do Enum, vložíme to do stejné tabulky MySQL.
Ale zde vyvstávají jiné problémy. Za prvé, nepohodlná syntaxe. Pokud chceme získat řetězec, musíme volat dictGet. Za druhé, chybí některá optimalizace. Porovnání s konstantním řetězcem pro slovníky tak rychle neuděláme.
Další mohou být problémy s aktualizací. Předpokládejme, že jsme požádali o řetězec v cache-slovníku, ale v cache se nedostal. Pak musíme čekat, až se načtou data z externího zdroje.
Celkový nedostatek obou metod spočívá v tom, že uchováváme všechny klíče na jednom místě a synchronizujeme je. Proč tedy neschovávat slovníky lokálně? Bez synchronizace — bez problémů. Můžeme uchovávat slovník lokálně v bloku na disku. To znamená, že jsme udělali Insert, zapsali slovník. Pokud pracujeme s daty v paměti, můžeme slovník zapsat buď do bloku dat, nebo do kousku sloupce, nebo do nějakého cache, abychom urychlili výpočty.
Slovním kódováním řetězců
Tak jsme přišli ke vzniku nového typu dat v ClickHouse — LowCardinality. To je formát uchovávání dat: jak se zapisují na disk a jak se čtou, jak jsou prezentována v paměti a schéma jejich zpracování.
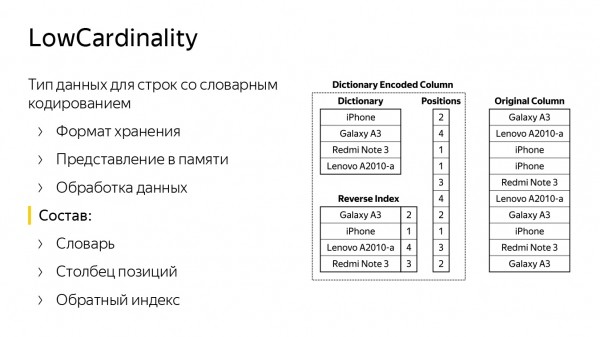
Na snímku jsou dvě sloupce. Vpravo jsou řádky standardně uloženy jako typ String. Je jasné, že se jedná o nějaké modely mobilních telefonů. Vlevo je přesně stejný sloupec, pouze s typem LowCardinality. Skládá se ze slovníku s mnoha různými řetězci (řetězce z pravého sloupce) a seznamu pozic (čísla řádků).
S pomocí těchto dvou struktur je možné obnovit původní sloupec. Existuje také inverzní index — hashovací tabulka, která pomáhá najít podle řetězce pozici ve slovníku. Ta je potřebná pro zrychlení některých dotazů. Například pokud chceme porovnat, vyhledat řetězec v našem sloupci nebo je sloučit.
LowCardinality je parametrický typ dat. Může to být buď číslo, nebo něco, co je uloženo jako číslo, nebo řetězec, nebo Nullable z nich.
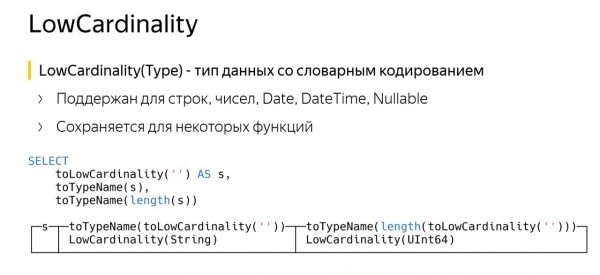
Specifikum LowCardinality je v tom, že může být ukládán pro některé funkce. Na snímku je vidět příklad dotazu. V prvním řádku jsem vytvořil sloupec typu LowCardinality ze String, nazval jsem ho S. Poté jsem se zeptal na jeho název — ClickHouse řekl, že je to LowCardinality z String. To je správně.
Třetí řádek je téměř stejný, pouze jsme zavolali funkci length. V ClickHouse funkce length vrací datový typ UInt64. Ale dostali jsme LowCardinality z UInt64. V čem je smysl?
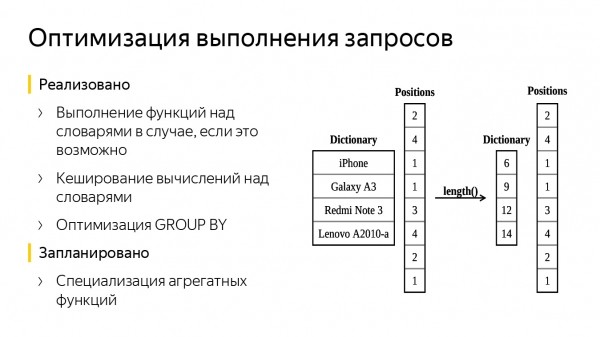
Ve slovníku byly názvy mobilních telefonů, použili jsme funkci length. Nyní máme podobný slovník tvořený pouze čísly — to jsou délky řetězců. Sloupec s pozicemi se nezměnil. Nakonec jsme zpracovali méně dat a ušetřili čas dotazu.
Mohou existovat i další optimalizace, například přidání jednoduché cache. Při výpočtu hodnoty funkce si ji můžeme zapamatovat a vytvořit stejnou, aniž bychom ji museli znovu počítat.
Dále může být optimalizován GROUP BY, protože náš sloupec se slovníkem je již částečně agregován — můžeme rychleji vypočítat hodnoty hash funkcí a přibližně najít bucket, do kterého umístit další řádek. Také můžeme specializovat některé agregační funkce, například uniq, protože do ní lze poslat pouze slovník, zatímco pozice zůstanou nedotčeny — tím vše poběží rychleji. První dvě optimalizace jsme již přidali do ClickHouse.
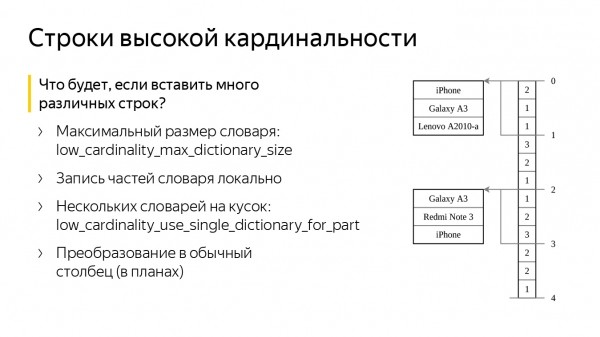
A co když vytvoříme sloupec s naším typem dat a vložíme do něj hodně špatných různých řetězců? Nepřeteče nám paměť? Ne, pro to má ClickHouse dvě speciální nastavení. První je low_cardinality_max_dictionary_size. To je maximální velikost slovníku, který může být zapsán na disk. Vkládání probíhá následujícím způsobem: když vkládáme data, přichází k nám proud řetězců, z nichž tvoříme velký společný slovník. Pokud slovník přesáhne hodnotu nastavení, zapíšeme aktuální slovník na disk a ostatní řetězce umístíme „někde vedle“, blízko indexů. Důsledkem je, že nikdy nepřepočítáme velký slovník a nevzniknou problémy s pamětí.
Druhé nastavení se nazývá low_cardinality_use_single_dictionary_for_part. Představte si, že v předchozím schématu, když jsme vkládali data, náš slovník přeteče a zapíšeme ho na disk. Objevuje se otázka, proč teď nevytvořit ještě jeden stejný slovník?
Když přeteče, znovu ho zapíšeme na disk a začneme vytvářet třetí. Toto nastavení právě tuto možnost ve výchozím nastavení deaktivuje.
Ve skutečnosti může být mnoho slovníků užitečných, pokud chceme vložit nějakou množinu řetězců, ale náhodou jsme vložili „odpad“. Řekněme, že jsme nejprve vložili špatné řetězce a pak dobré. Pak se slovník rozdělí na mnoho malých slovníků. Některé z nich budou s „odpadem“, ale ty poslední budou s dobrými řetězci. A pokud přečteme, řekněme, pouze poslední granuli, pak vše bude fungovat rychle.
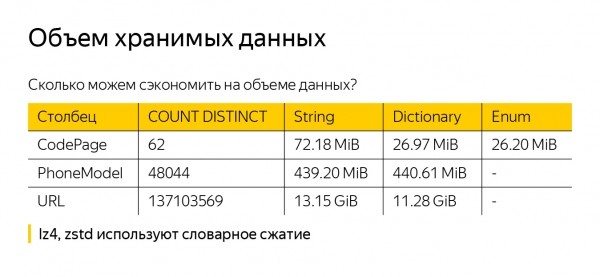
Než začnu mluvit o výhodách LowCardinality, hned řeknu, že pravděpodobně nedosáhneme snížení dat na disku (ačkoliv se to může stát), protože ClickHouse komprimuje data. Existuje výchozí varianta — LZ4. Můžete také použít kompresi pomocí ZSTD. Ale oba algoritmy již implementují slovníkové komprese, takže náš externí slovník ClickHouse nebude příliš nápomocný.
Abych nebyl neopodstatněný, vzal jsem některá data z metriky — String, LowCardinality(String) a Enum — a uložil je do různých typů dat. Vznikly tři sloupce, kde je záznam jednoho miliardy řádků. V prvním sloupci, CodePage, je pouze 62 hodnot. A je vidět, že v LowCardinality(String) nám je stlačili lépe. String je o něco horší, ale to pravděpodobně z důvodu, že řetězce jsou krátké, uchováváme jejich délky, a ty zabírají hodně místa, špatně se stlačují.
Pokud vezmeme PhoneModel, je jich 48 tisíc — už víc, a rozdíly mezi String a LowCardinality(String) jsou téměř žádné. Pro URL jsme také ušetřili jen 2 GB — myslím, že se na to nedá spoléhat.
Hodnocení rychlosti práce
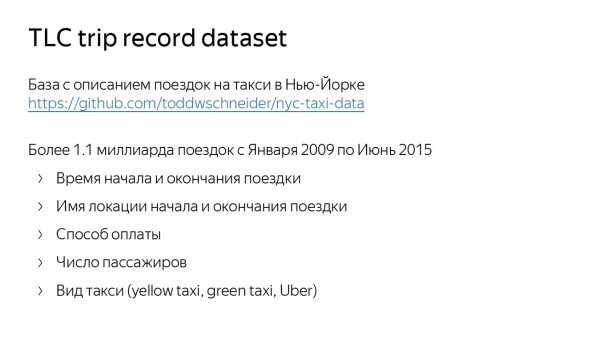
Nyní ohodnoťme rychlost práce. K jejímu hodnocení jsem použil dataset s popisem jízd taxi v New Yorku. Ten najdete na GitHubu. Obsahuje něco málo přes miliardu jízd. Zaznamenává zde lokaci, čas začátku a konce jízdy, způsob platby, počet pasažérů a dokonce typ taxi — zelené, žluté a Uber.
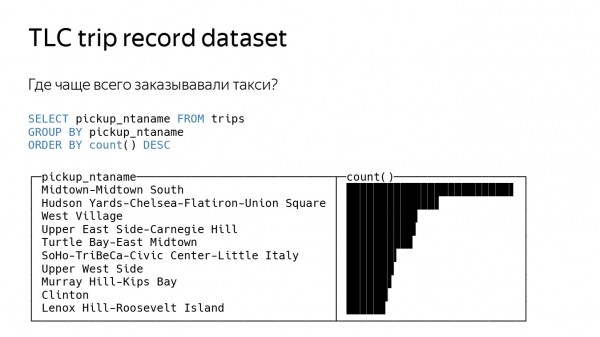
První dotaz jsem udělal poměrně jednoduchý — zeptal jsem se, odkud je taxi nejčastěji objednáváno. K tomu je třeba vzít lokaci, odkud byly objednávky, provést GROUP BY podle ní a spočítat funkci count. Tady ClickHouse něco vydává.
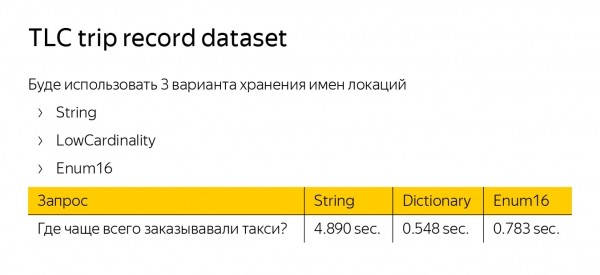
Abych změřil rychlost zpracování dotazu, vytvořil jsem tři tabulky se stejnými daty, ale pro naši výchozí lokaci jsem použil tři různé typy dat — String, LowCardinality a Enum. LowCardinality a Enum byly pětkrát rychlejší než String. Enum je rychlejší, protože pracuje s čísly. LowCardinality — protože je implementována optimalizace GROUP BY.
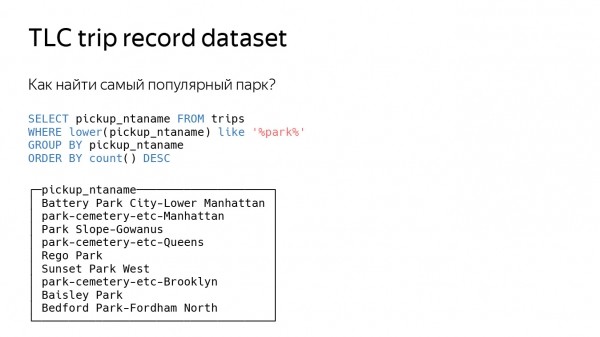
Pojďme ještě ztížit dotaz — zeptejte se, kde se nachází nejpopulárnější park v New Yorku. Opět to budeme měřit podle toho, kde se nejčastěji objednávají taxi, ale zároveň filtrujeme pouze ty lokace, kde je slovo "park". Přidáme také funkci like.
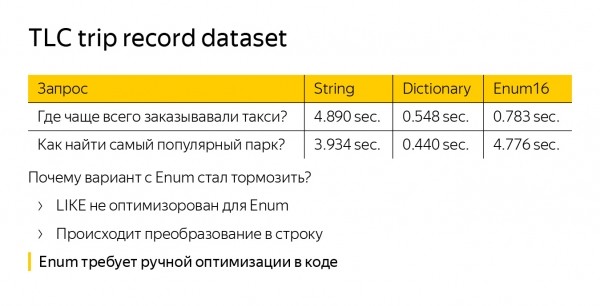
Díváme se na čas — vidíme, že Enum najednou začal zpomalovat. A funguje ještě pomaleji než standardní typ dat String. To se děje, protože funkce like není vůbec optimalizována pro Enum. Musíme převádět naše řetězce z Enum na obyčejné řetězce — děláme víc práce. LowCardinality(String) také není implicitně optimalizován, ale tam like pracuje s slovníkem, takže se dotaz zrychluje ve srovnání se String.
Při práci s Enum existuje globálnější problém. Pokud ho chceme optimalizovat, musíme to udělat na každém místě v kódu. Předpokládejme, že jsme napsali novou funkci — je nezbytné vymyslet optimalizaci pro Enum. A v LowCardinality je vše optimalizováno automaticky.
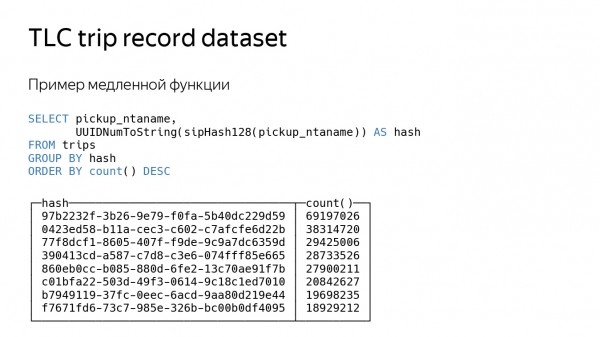
Podívejme se na poslední dotaz, který je umělejší. Jednoduše spočítáme hash funkci naší lokace. Hash funkce je poměrně pomalý dotaz, trvá dlouho, tedy se to všechno zpomalí zhruba třikrát.
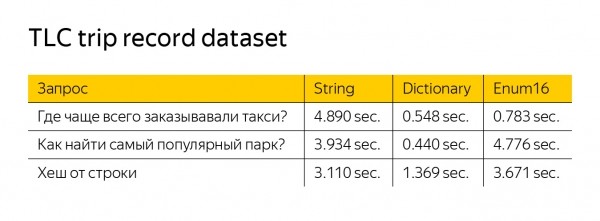
LowCardinality stále funguje rychleji, i když zde není filtrování. Děje se to, protože naše funkce pracují pouze se slovníkem. Funkce pro výpočet hash má jeden argument — může zpracovávat méně dat a také může vrátit LowCardinality.
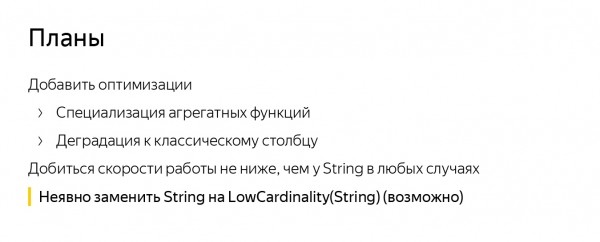
Naším globálním cílem je dosáhnout rychlosti, která nebude nižší než u String v jakýchkoliv případech, a zachovat zrychlení. A možná jednoho dne vyměním String za LowCardinality, vy aktualizujete ClickHouse a všechno bude o něco rychlejší.
Zdroj: habr.com

 Russian
 Italian
 German
 Polish
 Estonian
 Albanian
 Bulgarian
 Croatian
 Czech
 Danish
 Dutch
 English
 French
 Hungarian
 Latvian
 Norwegian
 Portuguese
 Romanian
 Slovak
 Slovenian
 Spanish
 Swedish