

Každý velký projekt začínal s několika servery. Nejprve byl jeden DB server, pak mu přibyli slave servery, aby se rozšířilo čtení. A teď – pozor! Mistr je jeden, ale slavy jsou mnohé; pokud jeden ze slavy odejde, bude to v pořádku, ale pokud odejde mistr – bude to špatné: downtime, administrátoři v chaosu znovu zapínají server. Co dělat? Rezervovat mistra. Můj kolega Pavel o tom už psal, , nebudu to opakovat. Místo toho vám řeknu, proč nutně potřebujete Orchestrator pro MySQL!
Začněme hlavní otázkou: „Jak přepneme kód na nový stroj při odchodu mistra?“
- Schéma s VIP (virtuální IP) se mi líbí nejvíce, o ní si povíme níže. Je nejsnažší a nejvíc zřejmá, i když má jedno jasné omezení: mistr, kterého budeme rezervovat, musí být v L2 segmentu s novým strojem, tedy na druhé datacentrum můžete zapomenout. A také, pokud dodržíme pravidlo, že velký L2 je zlo, protože L2 je pouze na stojce, a mezi stojkami je L3, takové schéma má ještě větší omezení.
- Můžete v kódu zapsat DNS jméno a resolvovat ho přes /etc/hosts. Ve skutečnosti se ale resolvací nevytvoří. Výhodou schématu: není omezení, jaké je charakteristické pro první způsob, tedy je možné organizovat i cross-Datacentorum. Ale pak vzniká zřejmá otázka, jak rychle pomocí Puppet-Ansible přivezeme změnu do /etc/hosts.
- Druhý způsob lze trochu upravit: na všechny webové servery nainstalujeme cache DNS, přes který bude kód chodit k mistru databáze. Můžete nastavit TTL 60 pro tento záznam v DNS. Vypadá to, že při správné implementaci je to dobrý způsob.
- Schéma se službou discovery, které zahrnuje použití Consul a etcd.
- Zajímavá varianta s . Je třeba veškerý traffic na MySQL přesměrovat přes ProxySQL, ProxySQL umí určovat, kdo je právě mistr. Mimochodem, o jednom z použití tohoto produktu si můžete přečíst v mém .
Autor Orchestrator, pracující na GitHubu, nejprve realizoval první schéma s VIP, a pak přešel na schéma s consul.
Typické schéma infrastruktury:
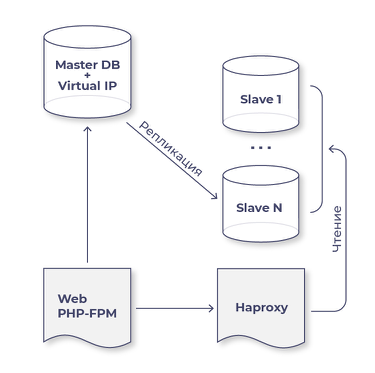
Hned popíšu zřejmé situace, které je potřeba vzít v úvahu:
- VIP adresa by neměla být zapsána v konfiguraci na žádném serveru. Představme si situaci: mistr se restartoval, a zatímco se načítá, Orchestrator přešel do režimu failover a udělal z jednoho ze slavy mistra; poté se spustil starý mistr, a teď je VIP na dvou strojích. To je špatně.
- Pro orchestrátor bude třeba napsat skript pro komunikaci se starým a novým mistrem. Na starém se musí provést ifdown, zatímco na novém mistrovi se provede ifup vip. Bylo by také dobré do tohoto skriptu zahrnout, že v případě selhání se port na switchi starého mistra jednoduše vypne, aby se předešlo jakémukoli rozdělení brainů.
- Jakmile orchestrátor zavolá váš skript, aby nejprve odebral VIP a/nebo vypnul port na switchi, a poté na novém mistrovi spustil skript pro zprovoznění VIP, nezapomeňte příkazem arping říct všem, že nový VIP je nyní zde.
- Na všech slavech by mělo být read_only=1, a jakmile povýšíte slave na mistra, mělo by být read_only=0.
- Nezapomínejte, že mistrem se může stát kterýkoli slave, který jsme vybrali pro tuto situaci (orchestrátor má celý mechanismus preferencí, který slave je prvním kandidátem na nového mistra, který na druhém místě, a který slave by v žádném případě neměl být zvolen mistrem). Pokud se slave stane mistrem, zůstane na něm zátěž slava a přidá se zátěž mistra, což je třeba zohlednit.
Proč tedy potřebujete Orchestrator, pokud ho nemáte?
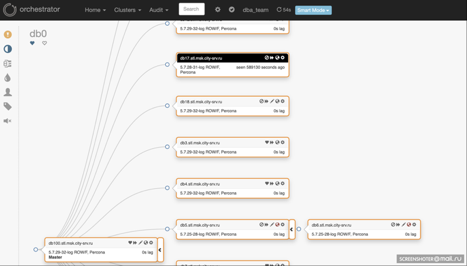
- Orchestrator má velmi uživatelsky přívětivé grafické rozhraní, které zobrazuje celou topologii (viz snímek obrazovky níže).
- Orchestrator může sledovat, které slaves zaostávají, a kde došlo dokonce k poruše replikace (máme k Orchestratoru připojené skripty pro zasílání SMS).
- Orchestrator vám říká, na kterých slaves je chyba GTID errant.
Rozhraní Orchestratoru:
Co je to GTID errant?
Existují dvě základní požadavky pro fungování Orchestratoru:
- Je třeba, aby na všech strojích MySQL clusteru bylo povoleno pseudo GTID, máme povolený GTID.
- Je třeba, aby všude byl jeden typ binlogů, může to být statement. Měli jsme takovou konfiguraci, kdy na mistrovi a většině slaves byl Row a na dvou historicky zůstal režim Mixed. Výsledkem bylo, že Orchestrator se jednoduše nechtěl připojit k těmto slaves jako k novému mistrovi.
Pamatujte, že nejdůležitější věcí u production-slave je jeho konzistence s mistrem! Pokud máte na mistrovi i na slave zapnutý Global Transaction ID (GTID), můžete pomocí funkce gtid_subset zjistit, zda na těchto strojích byly skutečně provedeny stejné požadavky na změnu dat. Více o tom můžete přečíst zde. .
Orchestrator vám tedy ukazuje prostřednictvím chyby GTID errant, že na slave jsou transakce, které nejsou na masteru. Proč k tomu dochází?
- Na slave není povoleno read_only=1, někdo se připojil a provedl dotaz na změnu dat.
- Na slave není povoleno super_read_only=1, takže se admin, zmatený serverem, připojil a provedl tam dotaz.
- Pokud jste zohlednili oba předchozí body, je tu ještě jeden trik: v MySQL také dotaz na flush binlogy končí v binlogu, takže při prvním flush na masteru a na všech slavech se objeví GTID errant. Jak se tomu vyhnout? V perona-5.7.25-28 se objevila možnost binlog_skip_flush_commands=1, která zakazuje zapisovat flush do binlogů. Na webu mysql.com je to evidováno. .
Shrňuji vše výše uvedené. Pokud zatím nechcete používat Orchestrator v režimu failover, nastavte jej do režimu sledování. Pak budete vždy mít před sebou mapu interakce MySQL strojů a přehledné informace o tom, jaký typ replikace je na každém stroji, zda slave zpožďují, a co je nejdůležitější – jak moc jsou konzistentní s masterem!
Odpověď na zřejmou otázku: «Jak by měl Orchestrator fungovat?». Měl by vybrat nový master z aktuálních slave a poté k němu znovu připojit všechny slave (to je důvod, proč je potřebný GTID; pokud by se používal starý mechanismus s binlog_name a binlog_pos, pak by přepnutí slave z aktuálního masteru na nový prostě nebylo možné!). Dříve, než jsme měli Orchestrator, musel jsem to jednou udělat ručně. Starý master zamrzal kvůli chybovému ovladači Adaptec, měl kolem 10 slave. Musel jsem přenést VIP z masteru na jeden ze slave a znovu připojit všechny ostatní slave. Kolik konzolí jsem musel otevřít, kolik současných příkazů zadat… Musel jsem čekat až do 3 hodin ráno, uvolnit zatížení ze všech slave kromě dvou, udělat první stroj z dvou masterem, ihned k němu připojit druhý stroj, poté připojit všechny ostatní slave k novému masteru a vrátit zatížení. Zkrátka, hrůza…
Jak Orchestrator funguje, když přechází do režimu failover? Nejlépe to ukázat na příkladu situace, kdy chceme udělat masterem výkonnější, modernější stroj než ten, který máme nyní.
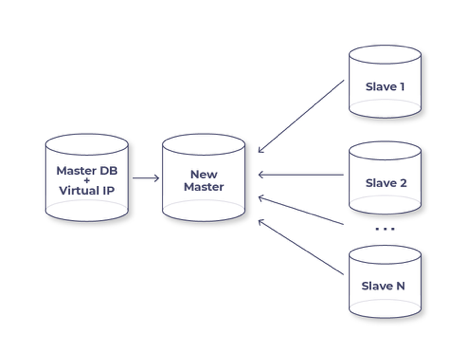
Na obrázku je znázorněn střed procesu. Co bylo uděláno před tímto momentem? Řekli jsme, že chceme udělat nějakého slava novým mistrem, Orchestrátor začal jednoduše přeconnectovat k němu všechny ostatní slavy, přičemž nový mistr plní roli tranzitního stroje. Při takovém schématu nedochází k žádným chybám, všechny slavy fungují, Orchestrátor odstraňuje VIP ze starého mistra, přenáší na nový, nastavuje read_only=0 a zapomíná na starého mistra. To je vše! Downtime naší služby – to je doba přenosu VIP, což jsou 2-3 sekundy.
Na dnes vše, všem děkuji. Brzy bude druhý článek o Orchestrátorovi. V známém sovětském filmu „Garáž“ jeden hrdina řekl: „S ním bych nešel na průzkum!“ Tak tedy, Orchestrátore, šel bych s tebou na průzkum!
Zdroj: habr.com
