

Doporučuji se seznámit s výkladem přednášky Alexeje Lesovského z Data Egret "Základy monitorování PostgreSQL".
V této přednášce Alexej Lesovský představí klíčové aspekty statistiky PostgreSQL, co znamenají a proč by měly být součástí monitoringu; jaké grafy by měly být v monitoringu, jak je přidat a jak je interpretovat. Přednáška bude užitečná pro administrátory databází, systémové administrátory a vývojáře, kteří se zajímají o troubleshooting PostgreSQL.
Jmenuji se Alexej Lesovský a zastupuji společnost Data Egret.
Něco málo o sobě. Začínal jsem kdysi dávno jako systémový administrátor.
Administrativně jsem se věnoval různým distribucím Linuxu, pracoval jsem na různých věcech spojených s Linuxem, tedy virtualizací, monitorováním, pracoval jsem s proxy atd. Ale v určitém okamžiku jsem se začal více soustředit na databáze, konkrétně na PostgreSQL. Velmi se mi líbil, a postupně jsem začal věnovat většinu svého pracovního času PostgreSQL. Tak jsem se postupně stal DBA PostgreSQL.
A po celou svou kariéru mě vždy zajímala témata statistiky, monitorování a sběru telemetrie. Když jsem byl systémovým administrátorem, intenzivně jsem se zabýval Zabbixem a napsal jsem malý soubor skriptů jako . Ten byl v té době docela populární. Umožňoval monitorovat různé důležité věci, nejen Linux, ale i další komponenty.
V současnosti se již věnuji PostgreSQL. Píšu něco jiného, co umožňuje pracovat se statistikou PostgreSQL. Nazývá se (článek na Habru — ).
Krátký úvod. Jaké situace se objevují u našich zákazníků? Dochází k nějaké havárii související s databází. A když je databáze obnovena, přijde vedoucí oddělení nebo vedoucí vývoje a říká: „Přátelé, měli bychom monitorovat databázi, protože se stalo něco špatného a je potřeba, aby se to v budoucnu neopakovalo“. A zde začíná zajímavý proces výběru monitorovacího systému nebo přizpůsobení stávajícího monitorovacího systému tak, aby bylo možné monitorovat svou databázi – PostgreSQL, MySQL nebo jiné. A kolegové začínají navrhovat: „Slyšel jsem, že existuje taková databáze. Pojďme ji použít“. Kolegové spolu začnou spory. A nakonec se zjistí, že vybíráme nějakou databázi, ale monitoring PostgreSQL v ní je zastoupen poměrně slabě a vždy je třeba něco dodělávat. Brát nějaké repozitáře z GitHubu, klonovat je, přizpůsobovat skripty, nějak je doladit. A nakonec to vyústí v určitou ruční práci.
Proto se v této zprávě pokusím poskytnout vám určité znalosti o tom, jak vybírat monitoring nejen pro PostgreSQL, ale také pro databáze obecně. A poskytnout znalosti, které vám umožní dotáhnout váš monitoring tak, abyste z něj měli nějaký užitek, mohli monitorovat svou databázi efektivně, aby bylo možné včas varovat před jakýmikoliv nadcházejícími havarijními situacemi, které by mohly vzniknout.
A tyto myšlenky, které budou v této zprávě, lze přímo přizpůsobit jakékoli databázi, ať už jde o RDBMS nebo noSQL. Proto zde není pouze PostgreSQL, ale bude zde mnoho receptů, jak to udělat v PostgreSQL. Budou zde příklady dotazů, příklady entit, které existují v PostgreSQL pro monitoring. A pokud vaše RDBMS má podobné věci, které umožňují je vložit do monitoringu, můžete je také přizpůsobit, přidat a bude to dobré.
 V této zprávě nebudu
vyprávět o tom, jak dodávat a uchovávat metriky. Nebudu říkat nic o post-processingu dat a jejich poskytování uživatelům. A nebudu nic říkat o alertingu.
V průběhu vyprávění budu ukazovat různé screenshoty existujících monitorovacích nástrojů a občas je kritizovat. Nicméně se pokusím nezmiňovat značky, abych nevytvářel reklamu nebo proti-reklamu těmto produktům. Takže veškerá shoda je náhodná a zůstává na vaší fantazii.
Nejprve si objasníme, co monitorování vlastně je. Monitorování je velmi důležitá věc, kterou je třeba mít. To chápe každý. Nicméně monitorování nepatří mezi business produkty a přímo nemá vliv na zisk společnosti, proto se mu vždy věnuje čas až na posledním místě. Pokud máme čas, zabýváme se monitorováním, pokud ne, tak OK, dáme to na backlog a někdy se k těmto úkolům vrátíme.
Proto z naší praxe, když přicházíme k klientům, je monitorování často nedostatečně vyvinuto a postrádá zajímavé prvky, které by nám pomohly lépe pracovat s databázemi. A proto je monitorování vždy třeba dokončit.
Databáze jsou složité věci, které je také třeba monitorovat, protože databáze jsou úložištěm informací. A informace jsou pro firmu velmi důležité, nesmí se ztrácet. Nicméně databáze jsou také velmi složité kusy softwaru. Skládají se z mnoha komponentů. A mnohé z těchto komponentů je třeba monitorovat.
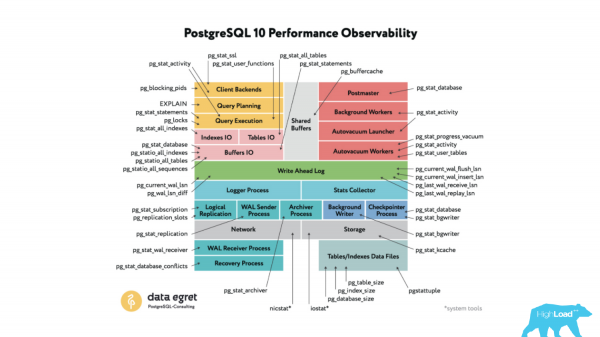 Pokud mluvíme konkrétně o PostgreSQL, můžeme jej představit jako schéma, které se skládá z mnoha komponentů. Tyto komponenty si vzájemně interagují. A zároveň v PostgreSQL existuje takzvaný systém Stats Collector, který umožňuje shromažďovat statistiky o práci těchto subsystémů a poskytovat jakýsi rozhraní administrátorovi nebo uživateli, aby mohl tyto statistiky procházet.
Tyto statistiky jsou prezentovány jako určitá sada funkcí a pohledů (views). Můžeme je také nazvat tabulkami. Tedy pomocí běžného klienta psql se můžete připojit k databázi, provést select na těchto funkcích a pohledech a získat konkrétní čísla o činnosti subsystémů PostgreSQL.
Můžete tato čísla přidat do vašeho oblíbeného monitorovacího systému, vytvořit grafy, přidat funkce a získat analytiku v dlouhodobé perspektivě.
Ale v této zprávě nebudu zvažovat všechny tyto funkce, protože by to mohlo zabrat celý den. Zaměřím se na doslova dvě až čtyři věci a budu říkat, jak pomáhají zlepšit monitoring.
A pokud mluvíme o monitoringu databáze, co je třeba sledovat? V první řadě je třeba sledovat dostupnost, protože databáze je služba, která poskytuje přístup k datům klientům, a musíme sledovat její dostupnost a také některé kvalitativní a kvantitativní charakteristiky.
Také je třeba monitorovat klienty, kteří se připojují k naší databázi, protože mohou být jako normální klienti, tak i škodliví klienti, kteří mohou databázi poškodit. Je také nutné je monitorovat a sledovat jejich činnost.
Když se klienti připojí k databázi, je zřejmé, že začínají pracovat s našimi daty, proto musíme sledovat také to, jak klienti pracují s daty: s jakými tabulkami, a v menší míře s jakými indexy. Tedy musíme posoudit zátěž (workload), kterou naši klienti vytvářejí.
Náklady na zátěž se samozřejmě skládají také z dotazů. Aplikace se připojují k databázi a získávají data prostřednictvím dotazů, a proto je důležité hodnotit, jaké dotazy máme v databázi, sledovat jejich adekvátnost, že nejsou napsány chybně, že některé možnosti je potřeba přepsat a zajistit, aby pracovaly rychleji a s lepšími výkony.
A když mluvíme o databázi, databáze vždy zahrnuje procesy na pozadí. Procesy na pozadí umožňují udržovat výkonnost databáze na dobré úrovni, takže pro jejich práci vyžadují určité množství zdrojů. A zároveň se mohou překrývat se zdroji klientských dotazů, takže náročná práce procesů na pozadí může přímo ovlivnit výkonnost klientských dotazů. Proto je také třeba je monitorovat a sledovat, aby nedocházelo k žádným nerovnostem v oblasti procesů na pozadí.
A to vše ohledně monitorování databáze zůstává v systémové metrice. Ale s ohledem na to, že většina naší infrastruktury se přesouvá do cloudu, systémové metriky jednotlivého hostitele vždy ustupují do pozadí. V databázích jsou však stále aktuální a sledování systémových metrik samozřejmě také není zbytečné.
Se systémovými metrikami je to více méně v pořádku, všechny moderní monitorovací systémy již tyto metriky podporují, ale celkově některé komponenty stále chybí a je potřeba přidávat některé věci. O těchto poznámkách se také zmíním, několik slidů bude o nich.
První bod plánu – dostupnost. Co je to dostupnost? Dostupnost v mém chápání je schopnost databáze obsluhovat připojení, tj. databáze je spuštěná a jako služba přijímá připojení od klientů. A tuto dostupnost lze hodnotit některými charakteristikami. Tyto charakteristiky je velmi pohodlné umístit na dashboardy.
Všichni vědí, co je to dashboard. Je to, když se jedním pohledem podíváte na obrazovku, na které jsou soustředěny potřebné informace. A vy už můžete okamžitě určit – je v databázi problém, nebo není.
Odpovídajícím způsobem je dostupnost databáze a další klíčové charakteristiky vždy nutné umístit na dashboardy, aby tyto informace byly po ruce, byly vždy blízko vás. Nějaké dodatečné detaily, které již pomáhají při vyšetřování incidentů, při analýze nějakých havarijních situací, je potřeba umístit na sekundární dashboardy, nebo skrýt do drilldown odkazů, které vedou k externím monitorovacím systémům.
Příklad jednoho známého monitorovacího systému. Je to velmi skvělý monitorovací systém. Shromažďuje velké množství dat, ale z mého pohledu má divné pojetí dashboardů. Je tam odkaz „vytvořit dashboard“. Ale když vytvoříte dashboard, vytvoříte jakýsi seznam skládající se ze dvou sloupců, jakýsi seznam grafů. A když potřebujete něco zobrazit, začnete kliknout myší, listovat, hledat potřebný graf. A to zabere čas, tj. jako takové dashboardy neexistují. Jsou zde pouze seznamy grafů.
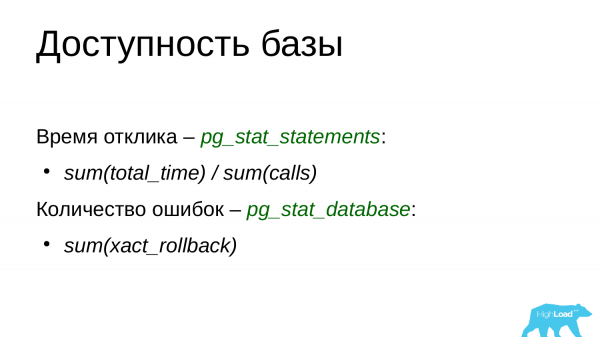
Co je potřeba přidat na tyto dashboardy? Můžete začít s takovou charakteristikou, jako je doba odezvy. V PostgreSQL existuje pohled pg_stat_statements. Ve výchozím nastavení je vypnutý, ale je to jeden z důležitých systémových pohledů, který je vždy nutné zapnout a používat. Uchovává informace o všech prováděných dotazech, které byly vykonány v databázi.
Odpovídajícím způsobem se můžeme odrazit od toho, že můžeme vzít souhrnnou dobu trvání všech dotazů a podělit ji počtem dotazů pomocí výše uvedených polí. Ale to je taková průměrná teplota na klinice. Můžeme se odrazit od jiných polí – minimální doba trvání dotazů, maximální a medián. A dokonce můžeme sestavovat percentily, v PostgreSQL existují pro to odpovídající funkce. Můžeme získat některá čísla, která charakterizují dobu odezvy naší databáze na již vykonané dotazy, tedy neprovádíme falešný dotaz 'select 1' a sledujeme dobu odezvy, ale analyzujeme časy odpovědí na již vykonané dotazy a vykreslujeme je buď jako samostatné číslo, nebo podle nich sestavíme graf.
Je také důležité sledovat počet chyb, které systém v daném okamžiku generuje. A pro to můžeme použít pohled pg_stat_database. Orientujeme se na pole xact_rollback. Toto pole ukazuje nejen počet rollbacků, které se v databázi uskutečnily, ale také zohledňuje počet chyb. Řekněme, že tuto číslo můžeme zobrazit na našem dashboardu a sledovat, kolik máme v danou chvíli chyb. Pokud je chyb mnoho, je to už dobrý důvod podívat se do logů a zjistit, co to jsou za chyby a proč se vyskytují, a pak již vyšetřovat a řešit je.
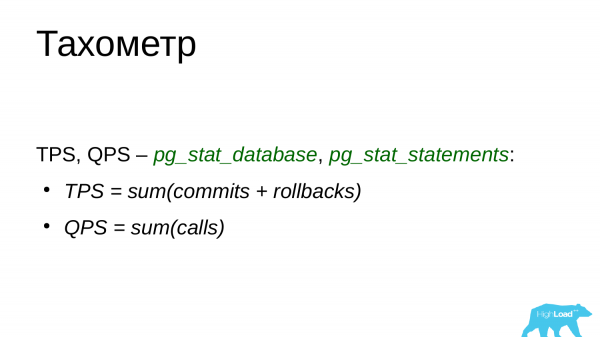
Můžete přidat takovou věc, jako je Tachometr. To je počet transakcí za sekundu a počet dotazů za sekundu. Řekněme, že můžete tyto čísla použít jako aktuální výkon vaší databáze a sledovat, zda jsou vrcholy dotazů, vrcholy transakcí, nebo naopak, je база nedostatečně zatížená, protože nějaký backend selhal. Tato číslo je důležité vždy sledovat a pamatovat si, že pro náš projekt je takový výkon normální, a hodnoty nad i pod tím jsou už problémové a nejasné, což znamená, že je potřeba zjistit, proč taková čísla vznikají.
Pro hodnocení počtu transakcí se můžeme opět obrátit na pohled pg_stat_database. Můžeme sečíst počet commitů a počet rollbacků a získat tak počet transakcí za sekundu.
Všichni chápou, že do jedné transakce se může vejít několik dotazů? Proto se TPS a QPS trochu liší.
Počet dotazů za sekundu můžeme získat z pg_stat_statements a jednoduše spočítat součet všech provedených dotazů. Je jasné, že porovnáváme aktuální hodnotu s předchozí, odečítáme a získáváme změnu, tedy počet.
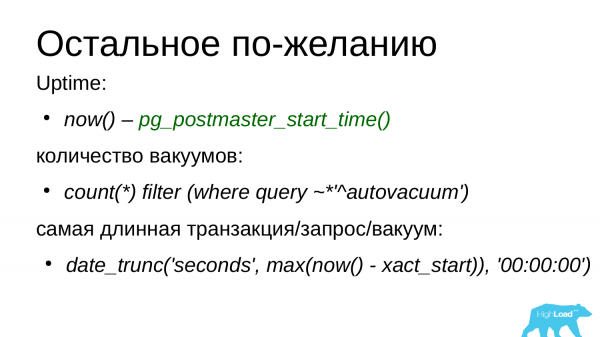
Můžeme přidat další metriky podle potřeby, které také pomáhají hodnotit dostupnost naší databáze a sledovat, zda nedošlo k nějakému výpadku.
Jednou z těchto metrik je uptime. Ale uptime v PostgreSQL je trochu složitá věc. Vysvětlím, proč. Když PostgreSQL spustí, začne se počítat uptime. Ale pokud v nějakém okamžiku, například v noci, probíhala nějaká úloha a OOM-killer násilně ukončil podproces PostgreSQL, pak v tomto případě PostgreSQL ukončí připojení všech klientů, resetuje oblast shardované paměti a začne obnovu z posledního kontrolního bodu. A během této obnovy z kontrolního bodu databáze nepřijímá připojení, tedy tuto situaci je možné hodnotit jako výpadek. Ale přitom se čítač uptime nevynuluje, protože počítá čas od spuštění postmastera od samotného začátku. Proto si takové situace můžeme přehlédnout.
Také je třeba monitorovat počet pracovních procesů vacuum. Všichni vědí, co je to autovacuum v PostgreSQL? To je zajímavá podsystém v PostgreSQL. O něm bylo napsáno mnoho článků, byla uspořádána spousta prezentací. Spousta diskuzí o vacuum a o tom, jak by měl fungovat. Mnozí ho považují za nevyhnutelné zlo. Ale je to tak. Je to jakýsi ekvivalent sběrače odpadu, který čistí zastaralé verze řádků, které nejsou potřebné žádné z transakcí a uvolňuje místo v tabulkách, indexech pro nové řádky.
Proč je třeba ho monitorovat? Protože vacuum někdy způsobuje velké problémy. Spotřebovává velké množství zdrojů a klientské dotazy tím začínají trpět.
Monitorovat by se mělo přes zobrazení pg_stat_activity, o kterém budu hovořit v následující části. Toto zobrazení ukazuje aktuální aktivitu v databázi. A přes tuto aktivitu můžeme sledovat počet vakuování, které probíhají právě teď. Můžeme sledovat vakuování a vidět, že pokud překročíme limit, je to důvod podívat se do nastavení PostgreSQL a nějak optimalizovat práci vakuování.
Další zvláštností PostgreSQL je to, že PostgreSQL velmi trpí dlouhými transakcemi. Zejména od transakcí, které dlouho visí a nic nedělají. Tyto se nazývají stat idle-in-transaction. Taková transakce zadržuje zámky, brání vakuování v práci. A jako důsledek – tabulky se zvětšují, zvyšují se na velikosti. A dotazy, které pracují s těmito tabulkami, začínají fungovat pomaleji, protože je třeba procházet všechny staré verze řádků z paměti na disk a zpět. Proto je také nutné monitorovat čas, trvání nejdelších transakcí a nejdelších dotazů na vakuování. A pokud vidíme nějaké procesy, které již pracují velmi dlouho, přes 10-20-30 minut pro OLTP zátěž, je třeba na ně již věnovat pozornost a ukončit je násilně nebo optimalizovat aplikaci, aby se nevytvářely a nevisely tak dlouho. Pro analytickou zátěž 10-20-30 minut je to normální, někdy bývají ještě delší.
Dále máme možnost s připojenými klienty. Když jsme již vytvořili panel, umístili na něj klíčové metriky dostupnosti, můžeme také přidat další informace o připojených klientech.
Informace o připojených klientech jsou důležité, protože z pohledu PostgreSQL jsou klienti různí. Jsou dobří klienti, jsou špatní klienti.
Jednoduchý příklad. Pod klientem rozumím aplikaci. Aplikace se připojila k databázi a okamžitě začala posílat své dotazy, databáze je zpracovává a vykonává, výsledky vrací klientovi. To jsou dobří a správní klienti.
Jsou situace, kdy se klient připojil, zadržuje spojení, ale nic nedělá. Nachází se ve stavu idle.
Ale existují špatní klienti. Například, ten samý klient se připojil, otevřel transakci, něco provedl v databázi a pak odešel do kódu, řekněme, aby se obrátil na externí zdroj nebo aby provedl zpracování získaných dat. Ale přitom nezavřel transakci. A transakce visí v databázi a zadržuje blokaci na řádku. To je špatný stav. A pokud se náhodou aplikace někde uvnitř zhroutí pomocí výjimky (Exception), může zůstat transakce otevřená velmi dlouhou dobu. A to přímo ovlivňuje výkon PostgreSQL. PostgreSQL bude pracovat pomaleji. Proto je důležité tyto klienty sledovat a včas ukončit jejich činnost. A je nutné optimalizovat svou aplikaci, aby se takové situace nevyskytovaly.
Dalšími špatnými klienty jsou čekající klienti. Ti se stávají špatnými kvůli okolnostem. Například jednoduchá visící transakce: může otevřít transakci, vzít blokace na určité řádky, a pak někde v kódu zkolabuje, zůstane visící transakce. Přijde jiný klient, požádá o stejné údaje, ale narazí na blokaci, protože ta visící transakce již zadržuje blokace na některé potřebné řádky. A druhá transakce bude viset v čekání, až první transakce skončí nebo ji správce násilně uzavře. Tímto způsobem se čekající transakce mohou hromadit a překročit limit připojení k databázi. A když je limit překročen, aplikace už nemůže pracovat s databází. To je už havarijní situace pro projekt. Proto je třeba špatné klienty sledovat a včas na ně reagovat.
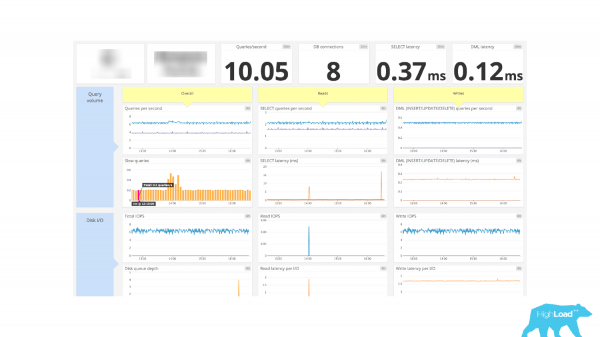
Další příklad monitorování. A zde již máme slušný dashboard. Zde jsou informace o připojeních nahoře. DB connection – 8 kusů. A to je vše. Nemáme informace o tom, kteří klienti jsou aktivní, kteří klienti jen nečinně čekají, nic nedělají. Není zde informace o visících transakcích a čekajících připojeních, tj. to je číslo, které ukazuje počet připojení a to je všechno. A pak hádejte sami.
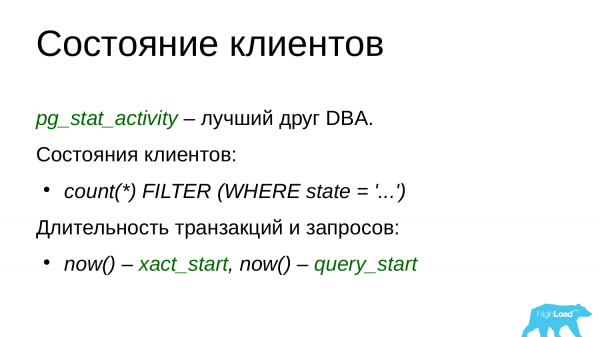
Aby tuto informaci přidali do monitorování, je třeba se obrátit na systémový pohled pg_stat_activity. Pokud trávíte hodně času v PostgreSQL, je to velmi užitečný pohled, který by se měl stát vaším přítelem, protože zobrazuje aktuální aktivitu v PostgreSQL, tj. co se v něm děje. Každý proces má svůj vlastní řádek, který ukazuje informace o tomto procesu: z jakého hosta bylo připojení navázáno, pod jakým uživatelským jménem, jaké bylo jméno pro připojení, kdy byla transakce spuštěna, jaký dotaz je aktuálně vykonáván a jaký dotaz byl vykonán naposledy. A samozřejmě, stav klienta můžeme posuzovat na základě pole stat. Můžeme provést seskupení podle tohoto pole a získat ty stats, které aktuálně existují v databázi a počet připojení, které mají tento stat v databázi. A již získaná čísla můžeme zaslat do našeho monitorování a vykreslit podle nich grafy.
Je také důležité posuzovat trvání transakce. Již jsem zmiňoval, že je důležité posuzovat trvání vakuových procesů, ale transakce se posuzují naprosto stejně. Existují pole xact_start a query_start. Ta v zásadě ukazují čas startu transakce a čas startu dotazu. Bereme funkci now(), která ukazuje aktuální časovou značku, a odečítáme timestamp transakce a dotazu. A získáme trvání transakce, trvání dotazu.
Pokud vidíme dlouhé transakce, měli bychom je již ukončit. Pro OLTP zatížení jsou dlouhé transakce takové, které trvají více než 1-2-3 minuty.. Pro OLAP zatížení jsou dlouhé transakce normální, ale pokud trvají déle než dvě hodiny, je to také známka toho, že někde nastal problém.
Když se klienti připojí k databázi, začnou pracovat s našimi daty. Obracejí se na tabulky, obracejí se na indexy, aby získali data z tabulky. A je důležité posuzovat, jak klienti s těmito daty pracují.
To assess our workload and understand which tables are the most 'active'. For example, this is useful in situations where we want to place 'hot' tables on a fast SSD storage. For instance, some archival tables that we haven't used for a long time can be moved to a 'cold' archive on SATA disks, allowing them to reside there, and access will occur as needed.
It is also useful for detecting anomalies after releases and deployments. For example, when a project rolls out a new feature, like adding new functionality for database work. If we build usage graphs for the tables, we can easily spot these anomalies on those graphs, such as spikes in updates or deletions. This will be very noticeable.
Anomalies in 'drifted' statistics can also be detected. What does this mean? PostgreSQL has a very strong and effective query planner, and developers devote a lot of time to its development. How does it work? To create good plans, PostgreSQL collects statistics on data distribution in tables at certain intervals. This includes the most frequent values: the number of unique values, information about NULLs in the table, and a lot of other information.
Based on this statistics, the planner builds multiple query plans, selects the most optimal one, and uses this query plan to execute the query and return the data.
Sometimes, the statistics can 'drift'. The quality and quantity of data in a table may change, but the statistics might not be updated. Consequently, the generated plans may turn out to be suboptimal. If our plans are suboptimal based on the gathered monitoring data, we will be able to see these anomalies. For instance, if the data quality significantly changed and the index is replaced by a sequential scan through the table, meaning that if the query only needs to return 100 rows (with a limit of 100), a full scan will be performed, which always negatively impacts performance.
A můžeme to vidět v monitorování. Můžeme se podívat na tento dotaz, provést pro něj explain, shromáždit statistiky a vytvořit nový dodatečný index. A už pak reagovat na tento problém. Proto je to důležité.
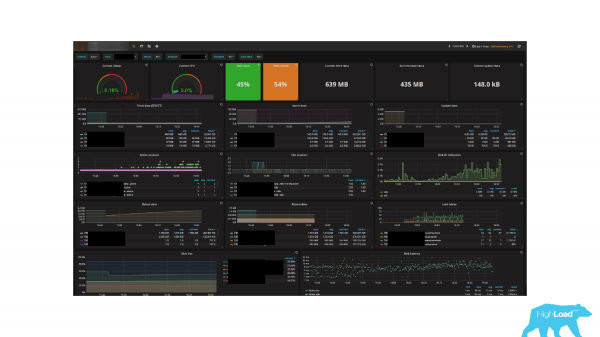
Další příklad monitorování. Myslím, že mnozí z vás ho poznali, protože je velmi populární. Kdo ho používá ve svých projektech? ? А кто использует этот продукт совместно с Prometheus? Дело в том, что в стандартном репозитории этого мониторинга есть дашборд для работы с PostgreSQL – Prometheus. Ale zde je jeden špatný detail.
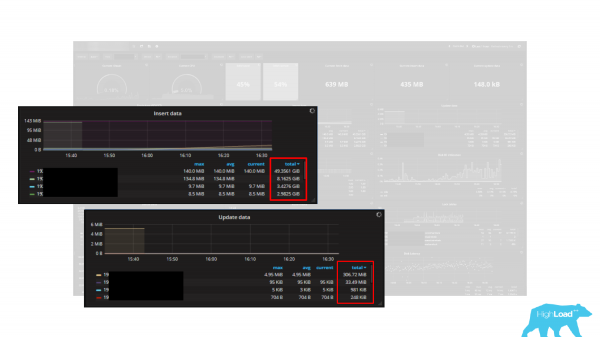
Existuje několik grafů. A jako jednotka jsou uvedeny bajty, tedy máme 5 grafů. To jsou Insert data, Update data, Delete data, Fetch data a Return data. Jako jednotka měření jsou uvedeny bajty. Ale problém je v tom, že statistiky v PostgreSQL vracejí data v tuplech (řádcích). A tedy tyto grafy jsou velmi dobrý způsob, jak snížit vaši zátěž několikrát, až desítkykrát, protože tuple není bajt, tuple je řádek, to je mnoho bajtů a má vždy proměnlivou délku. Tedy spočítat zátěž v bajtech pomocí tupelů je nereálný úkol nebo velmi složitý. Proto, když používáte dashboard nebo integrované monitorování, vždy je důležité rozumět tomu, že funguje správně a vrací vám správně ohodnocené údaje.
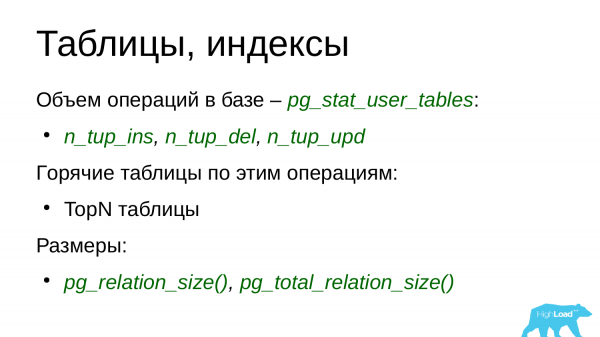
Jak získat statistiky z těchto tabulek? K tomu má PostgreSQL určitou skupinu pohledů. A hlavní pohled je . User_tables – to znamená, že tabulky byly vytvořeny za uživatele. Na rozdíl od toho existují systémové pohledy, které používá sám PostgreSQL. A existuje souhrnná tabulka Alltables, která zahrnuje jak systémové, tak uživatelské. Můžete se odvolat na jakoukoli z nich, která se vám nejvíce líbí.
Podle výše uvedených polí lze hodnotit počet insertů, update a delete. Ten příklad dashboardu, který jsem použil, právě používá tato pole pro hodnocení charakteristik zátěže. Proto se můžeme také od nich odvíjet. Ale je třeba mít na paměti, že to jsou tuply, nikoli bajty, takže nemůžeme vzít a udělat to v bajtech.
Na základě těchto údajů můžeme vytvářet takzvané TopN-tabulek. Například Top-5, Top-10. A můžeme sledovat ty „horké“ tabulky, které se využívají více než ostatní. Například 5 „horkých“ tabulek pro vkládání. A podle těchto TopN-tabulek hodnotíme naši zátěž a můžeme předpovědět výkyvy zátěže po různých releasech, aktualizacích a nasazeních.
Je také důležité posoudit velikost tabulky, protože někdy vývojáři uvedou novou funkci a naše tabulky začnou růst na svých velkých rozměrech, protože se rozhodli přidat další objem dat, ale nepředpověděli, jak to ovlivní velikost databáze. Takové případy pro nás také bývají překvapením.
A nyní pro vás mám malou otázku. Jaká otázka vás napadne, když si všimnete zatížení na serveru s databází? Jaká další otázka vás napadne?
Ale ve skutečnosti vyvstává následující otázka. Jaké dotazy způsobují zatížení? Tedy není zajímavé sledovat procesy, které způsobují zatížení. Je jasné, že pokud hostitel má databázi, tak tam běží databáze a je jasné, že pouze databáze tam bude využívat prostředky. Pokud otevřeme Top, uvidíme tam seznam procesů v PostgreSQL, které něco dělají. Z Top nebude jasné, co dělají.
Proto je potřeba zjistit ty dotazy, které způsobují největší zátěž, protože ladění dotazů obvykle přináší větší prospěch než ladění konfigurace PostgreSQL nebo operačního systému, nebo dokonce ladění hardwaru. Podle mého odhadu je to přibližně 80-85-90 %. A to lze udělat mnohem rychleji. Rychleji opravíte dotaz, než upravíte konfiguraci, naplánujete restart, zejména pokud nelze restartovat databázi, nebo přidat hardware. Snadněji se někde přepíše dotaz nebo přidá index, aby se dosáhlo lepšího výsledku z tohoto dotazu.
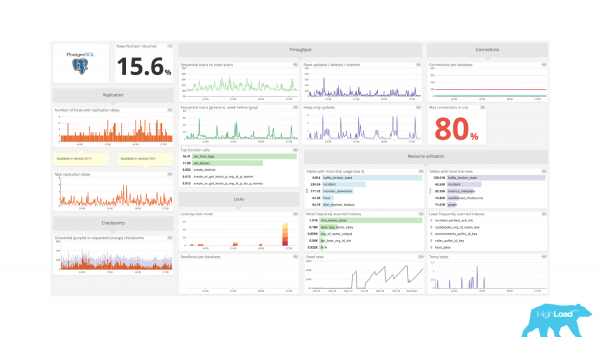
Proto je potřeba monitorovat dotazy a jejich adekvátnost. Vezměme si jiný příklad monitorování. A zde také vypadá skvělé monitorování. Je zde informace o replikaci, informace o propustnosti, blokacích, využití zdrojů. Všechno je skvělé, ale chybí informace o dotazech. Není jasné, jaké dotazy jsou prováděny v naší databázi, jak dlouho trvají, kolik těchto dotazů je. V monitorování musíme vždy mít tyto informace.
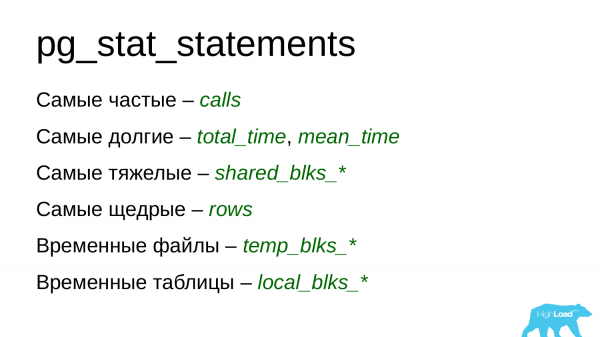
A pro získání těchto informací můžeme použít modul pg_stat_statements. Na jeho základě lze vytvářet nejrůznější grafy. Například můžeme získávat informace o nejčastějších dotazech, tedy o těch, které se vykonávají nejčastěji. Ano, po deployích je také velmi užitečné se na něj podívat a zjistit, zda nedošlo k nějakému výkyvu v dotazech.
Můžeme monitorovat nejdelší dotazy, tedy ty, které trvají nejdéle. Tyto dotazy zatěžují procesor a spotřebovávají vstup-výstup. To můžeme také hodnotit pomoci polí total_time, mean_time, blk_write_time a blk_read_time.
Můžeme hodnotit a monitorovat nejtěžší dotazy z hlediska využití zdrojů, ty, které čtou z disku nebo které pracují s pamětí, nebo naopak vytvářejí nějaké zápisové zatížení.
Můžeme posoudit i nejštědřejší dotazy. Jsou to ty dotazy, které vracejí velké množství řádků. Například by to mohl být nějaký dotaz, kde zapomněli nastavit limit. A on prostě vrací cel obsah tabulky nebo dotazu v požadovaných tabulkách.
A také můžeme monitorovat dotazy, které používají dočasné soubory nebo dočasné tabulky.
A zůstaly nám pozadí procesy. Pozadí procesy jsou především kontrolní body, nebo také nazývané checkpointy, autovacuum a replikace.
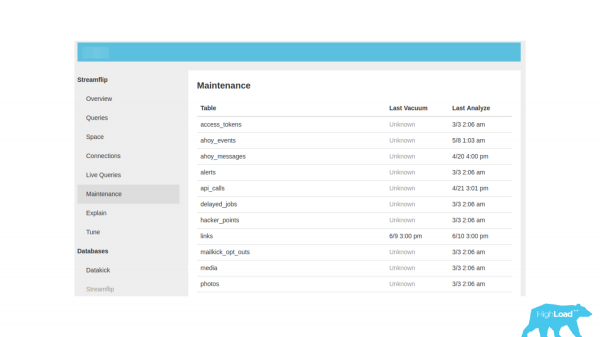
Další příklad monitorování. Na levé straně je karta Údržba, přejdeme na ni a doufáme, že uvidíme něco užitečného. Ale tady je jen doba běhu vakuování a shromažďování statistik, nic víc. To je velmi chudé informace, proto je vždy důležité mít informace o tom, jak fungují pozadí procesy v naší databázi a zda neexistují problémy s jejich provozem.
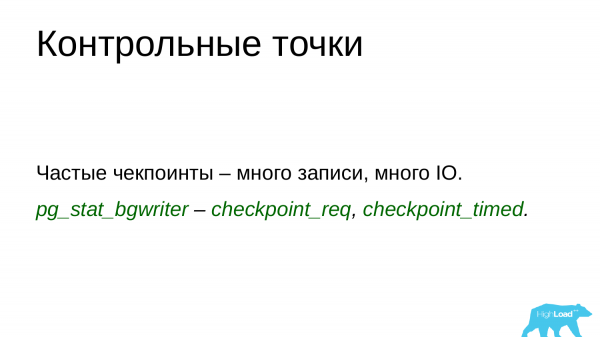
Když se díváme na kontrolní body, je třeba mít na paměti, že kontrolní body uvolňují "špinavé" stránky z oblasti sdílené paměti na disk, poté vytvářejí kontrolní bod. A tento kontrolní bod lze dále použít jako určité místo při obnově, pokud by PostgreSQL bylo neočekávaně ukončeno.
Aby se všechny "špinavé" stránky zapsaly na disk, je nutné provést určité množství zápisu. A jak je obvyklé, na systémech s velkým objemem paměti to znamená velmi mnoho. Pokud se checkpointy vytvářejí velmi často v krátkém intervalu, disková výkonost bude výrazně klesat. Klientské požadavky budou trpět nedostatkem zdrojů. Budou se přetahovat o zdroje a bude jim chybět výkon.
Pomocí pg_stat_bgwriter podle uvedených polí můžeme sledovat počet vznikajících checkpointů. A pokud za nějakou dobu (10-15-20 minut, půl hodiny) dojde k velkému počtu checkpointů, například 3-4-5, může to již představovat problém. A je potřeba se podívat do databáze, zkontrolovat konfiguraci, co způsobuje takové množství checkpointů. Možná probíhá nějaký velký zápis. Na základě workloadu můžeme již posoudit, protože grafy workloadu máme již přidané. Můžeme upravit parametry checkpointů tak, aby příliš neovlivňovaly výkon dotazů.
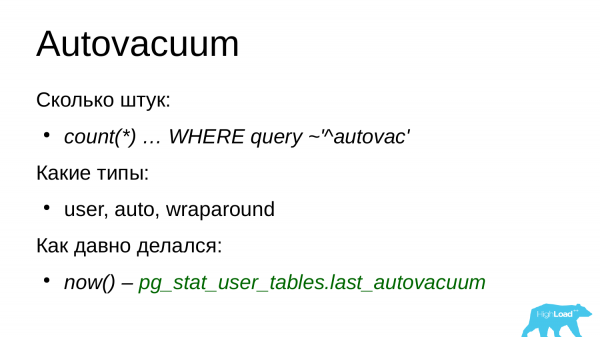
Znovu se vracím k autovacuum, protože to je věc, která jak jsem již zmínil, může snadno ovlivnit výkon jak disků, tak dotazů, proto je vždy důležité hodnotit počet autovacuum.
Počet autovacuum workerů v databázi je omezen. Ve výchozím nastavení jsou tři, takže pokud u nás neustále pracují tři workery v databázi, znamená to, že autovacuum není dostatečně nastaveno, je třeba zvýšit limity, přehodnotit nastavení autovacuum a zabývat se konfigurací.
Je důležité hodnotit, kteří workerové vacuumu nám běží. Buďto je to spuštěno uživatelem, DBA přišel a ručně spustil nějaký vacuum, což vytvořilo zátěž. Nebo je to počet vacuumů, které posouvají čítač transakcí. Pro některé verze PostgreSQL jsou to velmi náročné vacuums. A mohou snadno ovlivnit výkon, protože čtou celou tabulku a procházejí všechny bloky v této tabulce.
A samozřejmě trvání vakuových procesů. Pokud máme dlouhé vakuové procesy, které trvají velice dlouho, znamená to, že bychom se měli znovu podívat na konfiguraci vakuového procesu a možná přehodnotit jeho nastavení. Může se totiž objevit situace, kdy vakuum pracuje na tabulce dlouhou dobu (3-4 hodiny), ale během této doby se v tabulce opět nashromáždil velký objem mrtvých řádků. A jakmile se vakuový proces dokončí, musí tabulku znovu vakuovat. Dostáváme se tak do situace – nekonečného vakuování. A v tomto případě vakuum nezvládá svou úlohu a tabulky začínají postupně nabývat na velikosti, přičemž objem užitečných dat zůstává nezměněn. Proto při dlouhých vakuových procesech vždy zkoumáme konfiguraci a snažíme se ji optimalizovat, ale přitom tak, aby netrpěla výkonnost klientských dotazů.
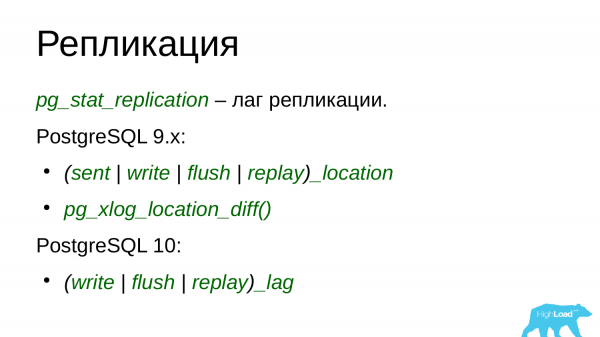
V současnosti prakticky neexistuje instalace PostgreSQL, která by neměla streamovou replikaci. Replikace je proces přenosu dat z masteru na repliku.
Replikace v PostgreSQL funguje prostřednictvím protokolu transakcí. Master generuje protokol transakcí. Protokol transakcí je přenášen na repliku po síťovém spojení, kde je na replice přehráván. Je to velmi jednoduché.
Pro sledování zpoždění replikace se používá pohled pg_stat_replication. S ním to však není tak jednoduché. V verzi 10 došlo k několika změnám. Za prvé, část polí byla přejmenována. A část polí byla přidána. V desáté verzi se objevila pole, která umožňují hodnotit zpoždění replikace v sekundách. To je velmi pohodlné. Před verzí 10 bylo možné hodnotit zpoždění replikace v bajtech. Tato možnost zůstala i v desáté verzi, to znamená, že si můžete vybrat, co vám vyhovuje více – hodnotit zpoždění v bajtech nebo v sekundách. Mnoho lidí dělá obojí.
Ale přesto, abychom mohli hodnotit zpoždění replikace, musíme znát pozici protokolu v transakci. A tyto pozice protokolu transakcí jsou právě ve výhledu pg_stat_replication. Řekněme, že pomocí funkce pg_xlog_location_diff() můžeme vzít dvě body v protokolu transakcí. Spočítat mezi nimi rozdíl a získat zpoždění replikace v bajtech. Je to velmi pohodlné a jednoduché.
V 10. verzi byla tato funkce přejmenována na pg_wal_lsn_diff(). Všechny funkce, pohledy a nástroje, kde se objevovalo slovo „xlog“, byly nahrazeny hodnotou „wal“. Tohle je novinka jak u pohledů, tak u funkcí.
Navíc v 10. verzi přibyly řádky, které konkrétně ukazují zpoždění. To jsou write lag, flush lag, replay lag. To znamená, že tyto věci je důležité monitorovat. Pokud vidíme, že máme zpoždění replikace, je nutné prozkoumat, proč se objevilo, odkud přišlo a odstranit problém.
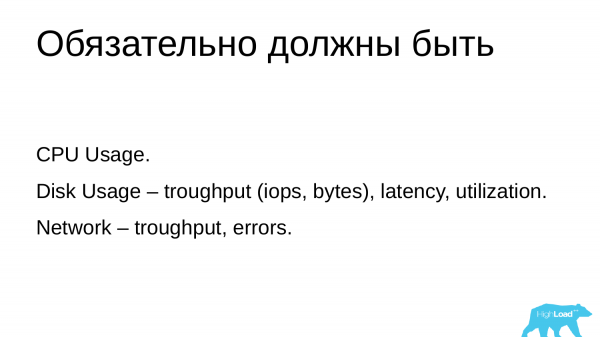
Se systémovými metrikami je prakticky všechno v pořádku. Když začíná jakékoli monitorování, začíná se se systémovými metrikami. To je využití procesorů, paměti, swapu, sítě a disku. Nicméně mnohé parametry tam nejsou ve výchozím nastavení.
Pokud je s využitím procesoru vše v pořádku, pak jsou s využitím disku problémy. Obvykle vývojáři monitorovacích nástrojů přidávají informace o průchodnosti. Ta může být v iops nebo bajtech. Ale zapomínají na latenci a využití diskových zařízení. To jsou důležitější parametry, které umožňují posoudit, jak jsou disky zatíženy a jak zpomalují. Pokud máme vysokou latenci, znamená to, že jsou nějaké problémy s disky. Pokud máme vysoké využití, znamená to, že disky nezvládají. To jsou kvalitnější charakteristiky než průchodnost.
I když tuto statistiku lze také získat z файловой системы /proc, jako se to dělá pro využití procesorů. Proč tuto informaci nepřidávají do monitorovacích nástrojů, nevím. Nicméně je důležité mít toto ve svém monitorování.
Stejné to je i ohledně síťových rozhraní. Existují informace o průchodnosti sítě v paketech, v bajtech, ale stále není žádná informace o latenci a není žádná informace o využití, což je také užitečná informace.
Jakékoli monitorovací nástroje mají nedostatky. A jakýkoli monitorovací nástroj si vezmete, vždy bude v nějakých kritériích nedostatečný. Nicméně se vyvíjejí, přidávají se nové funkce, nové věci, proto si vyberte něco a vylepšujte to.
A k tomu, abyste mohli vylepšovat, musíte mít vždy představu o tom, co znamená předávaná statistika a jak s její pomocí řešit problémy.
A několik klíčových momentů:
- Je vždy nutné sledovat dostupnost, mít přehledové panely, abyste mohli rychle posoudit, zda je databáze v pořádku.
- Je vždy nezbytné mít přehled o tom, kteří zákazníci pracují s vaší databází, abyste mohli filtrovat problematické klienty a eliminovat je.
- Je důležité vyhodnocovat, jak tito zákazníci pracují s daty. Musíte mít přehled o své zátěži.
- Je důležité posoudit, jak tato zátěž vzniká, jaké dotazy se používají. Můžete posuzovat, optimalizovat, refaktorovat dotazy a vytvářet pro ně indexy. To je velmi důležité.
- Pozadí procesy mohou negativně ovlivňovat dotazy klientů, proto je důležité sledovat, aby nepoužívaly příliš mnoho zdrojů.
- Systémové metriky vám umožňují plánovat škálování a zvyšování kapacity vašich serverů, proto je také důležité je sledovat a vyhodnocovat.
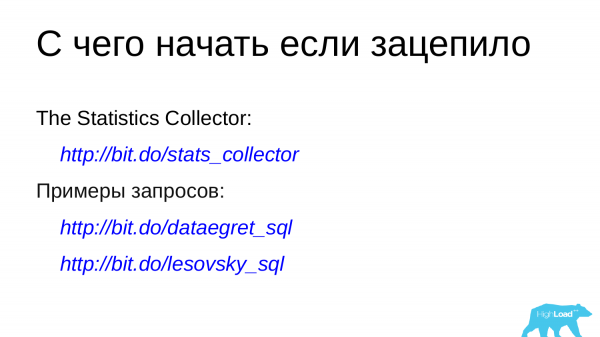
Pokud vás toto téma zaujalo, můžete se podívat na tyto odkazy.
— to je oficiální dokumentace se sběrateli statistik. Obsahuje popis všech statistických pohledů a všech polí. Můžete si je přečíst, pochopit a analyzovat. A na základě nich vytvořit své grafy, přidávat je do svých monitorovacích nástrojů.
Příklady dotazů:
To je náš firemní repozitář a můj vlastní. Obsahuje příklady dotazů. Neexistují tam dotazy typu select* from něco. Jsou tam již hotové dotazy s joiny, používající zajímavé funkce, které umožňují převést surová čísla na čitelná a užitečná data, tj. bajty, čas. Můžete je zkoumat, analyzovat, přidávat do svých monitorovacích nástrojů a na jejich základě budovat vlastní monitorování.
Otázky
Otázka: Řekl jste, že nebudete propagovat značky, ale přesto mě zajímá - jaké přehledové panely používáte ve svých projektech?
Odpověď: Různě. Někdy přijdeme k zákazníkovi a on již má svůj monitoring. A my konzultujeme, co je potřeba přidat do jeho monitoringu. Nejhůře je to se Zabbixem. Protože nemá možnost vytvářet TopN grafy. My sami používáme , protože jsme poradili těm klukům ohledně monitorování. Dělali monitoring PostgreSQL na základě našich specifikací. Píšu svůj pet-project, který sbírá data přes Prometheus a zobrazuje je v . Mám úkol vytvořit svůj exporter v Prometheus a poté to zobrazit v Grafaně.
Otázka: Existují nějaké alternativy k AWR reportům nebo ... agregacím? Víš o něčem takovém?
Odpověď: Ano, vím, co je AWR, je to skvělá věc. V současnosti existuje různé implementace, které realizují přibližně následující model. S určitým časovým intervalem se zapisují nějaké baselines buď do PostgreSQL, nebo do samostatného úložiště. Můžeš je najít na internetu, jsou k dispozici. Jeden z vývojářů takové záležitosti je na fóru sql.ru ve vláknu PostgreSQL. Můžeš ho tam oslovit. Ano, takové věci existují, dají se používat. Kromě toho já také píšu něco, co umožňuje to samé. P.S.1 Pokud používáš postgres_exporter, jaký dashboard používáš? Je jich tam několik. Ty jsou už zastaralé. Možná by komunita mohla vytvořit aktualizovanou šablonu?
P.S.2 Odstranil jsem pganalyze, protože je to proprietární SaaS nabídka, která se zaměřuje na sledování výkonu a automatizovaná doporučení pro ladění.
Jaký self-hosted monitoring PostgreSQL (s dashboardem) považuješ za nejlepší?
Pouze registrovaní uživatelé se mohou účastnit ankety. , prosím.
Zabbix + doplňky od Alexeje Lesovského nebo zabbix 4.4 nebo libzbxpgsql + zabbix libzbxpgsql + zabbix3
30,0%pganalyze je proprietární SaaS — nemůžu odstranit1
0,0%https://github.com/lesovsky/pgcenter0
0,0%https://github.com/pg-monz/pg_monz0
20,0%https://github.com/cybertec-postgresql/pgwatch22
20,0%https://github.com/postgrespro/mamonsu2
0,0%https://www.percona.com/doc/percona-monitoring-and-management/conf-postgres.html0
10,0%Hlasovalo 10 uživatelů. Zdrželo se 26 uživatelů.
10,0%https://github.com/powa-team/powa1
0,0%https://github.com/darold/pgbadger0
0,0%https://github.com/darold/pgcluu0
0,0%https://github.com/zalando/PGObserver0
10,0%https://github.com/spotify/postgresql-metrics1
Doporučuji se seznámit s výkladem zprávy Alexeje Lesovského z Data Egret "Základy monitorování PostgreSQL" V této zprávě Alexej Lesovský poví o klíčových aspektech PostgreSQL.
Zdroj: habr.com
