

Úvod
 „Musíte běžet ze všech sil, abyste se udrželi na místě,
a abyste se někam dostali, musíte běžet alespoň dvakrát rychleji!“
(c) Alice v říši divů
Před časem mě požádali, abych přednesl přednášku analytikům naší společnosti na téma návrhu datových modelů, protože když trávíme dlouhou dobu na projektech (někdy i několik let), ztrácíme zřetel na to, co se kolem nás děje ve světě IT technologií. V naší společnosti (tak se stalo) se na mnoha projektech nepoužívají NoSQL databáze (alespoň zatím), a proto jsem ve své přednášce věnoval určitou pozornost jejich příkladu HBase a snažil se zaměřit výklad materiálu na ty, kteří s nimi nikdy nepracovali. V konkrétním případě jsem ilustroval některé aspekty návrhu datového modelu na příkladu, který jsem před několika lety četl . Při analýze příkladů jsem mezi sebou porovnával několik variant řešení stejného problému, abych lépe předal posluchačům základní myšlenky.
Nedávno, „z nudy“, jsem si položil otázku (dlouhé májové volno v karanténě k tomu zvlášť vybízí), jak moc budou teoretické úvahy odpovídat praxi? V podstatě tak vznikla myšlenka tohoto článku. Vývojář, který už nějakou dobu pracuje s NoSQL, možná z toho nic nového nevyčte (a proto může hned přeskočit půl článku). Ale pro analytiky, kteří ještě úzce nepracovali s NoSQL, si myslím, že to bude užitečné pro získání základních představ o zvláštnostech návrhu datových modelů pro HBase.
Analýza příkladu
Podle mého názoru je před začátkem používání databází NoSQL důležité dobře zvážit „pro“ a „proti“. Úkoly lze často vyřešit i pomocí tradičních relačních databázových systémů. Proto je lepší se vyhnout použití NoSQL bez vážného důvodu. Pokud však bylo rozhodnuto použít databázi NoSQL, je třeba mít na paměti, že přístupy k návrhu se zde trochu liší. Některé z nich mohou být obzvlášť nezvyklé pro ty, kteří měli doposud zkušenosti pouze s relačními databázemi (podle mých pozorování). V „relačním“ světě obvykle začínáme modelováním doménové oblasti a až poté případně provádíme denormalizaci modelu. V NoSQL však musíme ihned zohlednit předpokládané scénáře práce s daty a původně denormalizovat data. Kromě toho existuje řada dalších rozdílů, o kterých bude níže psáno.
Zvažme následující „syntetický“ úkol, se kterým budeme dále pracovat:
Je nutné navrhnout strukturu pro ukládání seznamu přátel uživatelů určité abstraktní sociální sítě. Pro zjednodušení předpokládejme, že všechny vazby jsou u nás směrové (jak na Instagramu, nikoli na LinkedInu). Struktura by měla účinně umožnit:
- Odpovědět na otázku, zda uživatel A sleduje uživatele B (profil čtení)
- Umožnit přidávat/odstraňovat vazby v případě, že se uživatel A přihlásí/odhlásí od uživatele B (profil změny dat)
Samozřejmě, existuje mnoho variant řešení úkolu. V běžné relační databázi bychom pravděpodobně vytvořili tabulku vazeb (možná typizovanou, pokud je například nutné uchovávat uživatelskou skupinu: rodina, práce atd., do které daný „přítel“ patří), a pro optimalizaci rychlosti přístupu bychom přidali indexy/particionování. Pravděpodobně by konečná tabulka vypadala přibližně takto:
user_id
friend_id
Václav
Petr
Václav
Olga
zde a dále pro přehlednost a lepší pochopení budu místo ID uvádět jména
V případě HBase víme, že:
- efektivní vyhledávání, které nevede k full table scan, je možné výhradně podle klíče
- Protože psát běžné SQL dotazy pro podobné databáze je špatný nápad; technicky vzato, můžete poslat SQL dotaz s JOIN a další logikou do HBase z Impala, ale jak efektivní to bude…
Proto musíme použít ID uživatele jako klíč. První myšlenka na téma „kde a jak uchovávat ID přátel?“ může být nápad je uložit do sloupců. Tento nejvíce očividný a „naivní“ příklad bude vypadat přibližně takto (nazveme ho Varianta 1 (výchozí), abychom se na něj mohli dále odkázat):
RowKey
Sloupce
Václav
1: Péťa
2: Olya
3: Dasha
Petr
1: Máša
2: Váša
Zde každý řádek odpovídá jednomu uživateli sítě. Sloupce mají názvy: 1, 2, … — podle počtu přátel, a v sloupcích jsou uložena ID přátel. Je důležité poznamenat, že každý řádek bude mít různé množství sloupců. V příkladu na obrázku výše má jeden řádek tři sloupce (1, 2 a 3), zatímco druhý má pouze dva (1 a 2) – zde jsme využili dvou vlastností HBase, které nemají relační DB:
- možnost dynamicky měnit složení sloupců (přidáme přítele -> přidáme sloupec, odstraníme přítele -> odstraníme sloupec)
- různé řádky mohou mít různá složení sloupců
Ověříme naši strukturu na shodu s požadavky úkolu:
- Čtení dat: abychom pochopili, zda je Váša přítelem Oly, musíme přečíst celý řádek s klíčem RowKey = „Váša“ a procházet hodnoty sloupců, dokud nenarazíme na Oly. Nebo projít hodnoty všech sloupců, nenajít Oly a vrátit odpověď Nepravda;
- Změna dat: přidání přítele: pro podobný úkol potřebujeme také přečíst celý řádek s klíčem RowKey = „Váša“, abychom zjistili celkový počet jeho přátel. Tento celkový počet přátel potřebujeme k určení čísla sloupce, do kterého je třeba zapsat ID nového přítele.
- Změna dat: odstranění přítele:
- Musíme přečíst celý řádek s klíčem RowKey = „Váša“ a procházet sloupce, abychom našli ten, ve kterém je zapsán odstraňovaný přítel;
- Dále po odstranění přítele musíme „posunout“ všechna data o jeden sloupec, abychom se vyhnuli „mezerám“ v jejich číslování.
Nyní oceníme, jak efektivní budou algoritmy, které budeme potřebovat implementovat na straně „fiktivní aplikace“, Označíme velikost naší hypotetické sociální sítě jako n. Maximální počet přátel jednoho uživatele může být (n-1). Tato (-1) pro naše účely může být zanedbána, protože v rámci používání O-symboliky je nevýznamná.
- Čtení dat: je nutné přečíst celý řádek a prozkoumat všechny jeho sloupce v rámci mezí. Takže horní odhad nákladů bude přibližně O(n)
- Změna dat: přidání přítele: pro určení počtu přátel je třeba prozkoumat všechny sloupce řádku, po němž vložíme nový sloupec => O(n)
- Změna dat: odstranění přítele:
- Podobně jako při přidání – je třeba prozkoumat všechny sloupce => O(n)
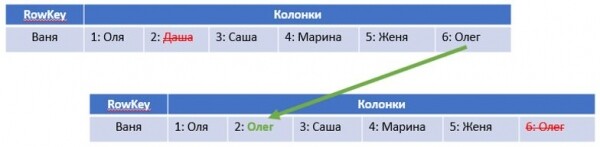
- Po odstranění sloupců je třeba je "posunout". Pokud bychom to realizovali doslovně, trvalo by to nakonec až (n-1) operací. Ale zde a v budoucnosti v praktické části použijeme jiný přístup, který provede "pseudo-posun" za pevný počet operací – tedy tento proces bude trvat konstantní čas bez ohledu na n. Tento konstantní čas (pokud to vezmeme přesně, O(2)) lze ve srovnání s O(n) zanedbat. Přístup je ilustrován na následujícím obrázku: jednoduše kopírujeme data z "posledního" sloupce do toho, ze kterého je třeba data odstranit, poté odstraníme poslední sloupec:

Celkově jsme ve všech scénářích získali asymptotickou výpočetní složitost O(n).
Možná jste si už všimli, že téměř vždy musíme načíst celý řádek z databáze, a to v dvou třetinách případů pouze proto, abychom prozkoumali všechny sloupce a spočítali celkový počet přátel. Proto jako pokus o optimalizaci můžeme přidat sloupec „count“, ve kterém bude uložen celkový počet přátel každého uživatele sítě. V tomto případě nemusíme načítat celý řádek pro spočítání celkového počtu přátel, ale pouze přečteme jeden sloupec „count“. Hlavní je nezapomínat aktualizovat „count“ při manipulaci s daty. Takto získáváme vylepšený Varianta 2 (count):
RowKey
Sloupce
Václav
1: Péťa
2: Olya
3: Dasha
count: 3
Petr
1: Máša
2: Váša
count: 2
Ve srovnání s první variantou:
- Čtení dat: pro zodpovězení otázky „Čte Olya Vasya?“ se nic nezměnilo => O(n)
- Změna dat: přidání přítele: Zjednodušili jsme vložení nového přítele, protože nyní nemusíme kontrolovat celý řádek a procházet jeho sloupce, ale můžeme získat pouze hodnotu sloupce „count“ a tím okamžitě určit číslo sloupce pro vložení nového přítele. To snižuje výpočetní složitost na O(1)
- Změna dat: odstranění přítele: Při odstraňování přítele můžeme také využít tento sloupec, abychom snížili počet vstupně-výstupních operací při „posunutí“ dat o jednu buňku vlevo. Ale potřeba procházet sloupce za účelem nalezení toho, který je třeba odstranit, zůstává, proto => O(n)
- Na druhou stranu, nyní musíme při aktualizaci dat každý čas aktualizovat také sloupec „count“, ale to zabere konstantní čas, kterým se v rámci O-notation dá přehlížet
Celkově se varianta 2 jeví o něco optimalizovanější, ale je to spíše „evoluce místo revoluce“. Pro provedení „revoluce“ budeme potřebovat Varianta 3 (col).
Otočíme vše „na hlavu“: přiřadíme jménu sloupce identifikátor uživatele! Co bude zapsáno v samotném sloupci – pro nás už není důležité, ať je tam číslo 1 (ve skutečnosti, z užitečného tam lze uchovávat například skupinu „rodina/přátelé/atd.“). Tento přístup může překvapit nepřipraveného „obyčejného“ člověka, který předtím neměl žádné zkušenosti s NoSQL databázemi, ale právě on umožňuje využít potenciál HBase v této úloze mnohem efektivněji:
RowKey
Sloupce
Václav
Petr: 1
Olga: 1
Dasha: 1
Petr
Maša: 1
Vasya: 1
Zde získáváme hned několik výhod. Abychom je pochopili, analyzujeme novou strukturu a vyhodnotíme výpočetní složitost:
- Čtení dat: abychom odpověděli na otázku, zda je Vasya přihlášen k Ole, stačí přečíst jeden sloupec „Ola“: pokud je, odpověď je True, pokud ne – False => O(1)
- Změna dat: přidání přítele: Přidání přítele: stačí jednoduše přidat nový sloupec „ID přítele“ => O(1)
- Změna dat: odstranění přítele: stačí jednoduše odstranit sloupec „ID přítele“ => O(1)
Jak vidíme, podstatnou výhodou tohoto modelu ukládání je, že ve všech potřebných scénářích operujeme pouze s jedním sloupcem, vyhneme se čtení celé řady z databáze a tím spíše procházení všech sloupců tohoto řádku. Na tom bychom mohli skončit, ale…
Můžete se zabývat a jít ještě o krok dál na cestě optimalizace výkonu a snížení vstupně-výstupních operací při přístupu k databázi. Co kdybychom uchovávali veškeré informace o vztahu přímo v klíči řádku? To znamená vytvořit klíč typu userID.friendID? V takovém případě bychom nemuseli vůbec číst sloupce řádku.Varianta 4(row)):
RowKey
Sloupce
Václav.Petr
Petr: 1
Václav.Ola
Olga: 1
Václav.Dáša
Dasha: 1
Petr.Maria
Maša: 1
Petr.Václav
Vasya: 1
Je zřejmé, že hodnocení všech scénářů manipulace s daty v této struktuře bude stejné jako v předchozí variantě, tedy O(1). Rozdíl ve srovnání s variantou 3 bude pouze v efektivitě vstupně-výstupních operací v databázi.
A poslední „mašlička“. Je snadné si všimnout, že ve variantě 4 bude klíč řádku mít proměnlivou délku, což může ovlivnit výkon (tady si připomínáme, že HBase ukládá data jako sadu bajtů a řádky v tabulkách jsou seřazeny podle klíče). Navíc máme oddělovač, který v některých scénářích může být nutné zpracovat. Abychom vyloučili tento vliv, můžeme použít hashe od userID a friendID, a protože oba hash budou mít konstantní délku, můžeme je prostě zřetězit bez oddělovače. Data v tabulce pak budou vypadat takto:Varianta 5(hash)):
RowKey
Sloupce
dc084ef00e94aef49be885f9b01f51c01918fa783851db0dc1f72f83d33a5994
Petr: 1
dc084ef00e94aef49be885f9b01f51c0f06b7714b5ba522c3cf51328b66fe28a
Olga: 1
dc084ef00e94aef49be885f9b01f51c00d2c2e5d69df6b238754f650d56c896a
Dasha: 1
1918fa783851db0dc1f72f83d33a59949ee3309645bd2c0775899fca14f311e1
Maša: 1
1918fa783851db0dc1f72f83d33a5994dc084ef00e94aef49be885f9b01f51c0
Vasya: 1
Je zřejmé, že algoritmická složitost práce s touto strukturou ve scénářích, které zvažujeme, bude stejná jako u varianty 4 – tedy O(1).
Celkově shrňme všechny naše odhady výpočetní složitosti do jedné tabulky:
Přidání přítele
Kontrola přítele
Smazání přítele
Varianta 1 (výchozí)
O(n)
O(n)
O(n)
Varianta 2 (count)
O(1)
O(n)
O(n)
Varianta 3 (column)
O(1)
O(1)
O(1)
Varianta 4 (row)
O(1)
O(1)
O(1)
Varianta 5 (hash)
O(1)
O(1)
O(1)
Jak je patrné, možnosti 3–5 vypadají jako nejpreferovanější a teoreticky zajišťují splnění všech potřebných scénářů manipulace s daty v konstantním čase. V podmínkách našeho úkolu není explicitní požadavek na získání seznamu všech přátel uživatele, ale v reálné projektové činnosti bychom jako dobří analytici měli ocenit, že může vzniknout takový úkol a „připravit se na něj“. Proto jsem na straně varianty 3. Je však velmi pravděpodobné, že v reálném projektu mohl být tento dotaz vyřešen jinými prostředky, proto bez celkového pohledu na celou úlohu bychom neměli dělat definitivní závěry.
Příprava experimentu
Výše uvedené teoretické úvahy bychom chtěli ověřit v praxi – to bylo cílem nápadu, který se zrodil během dlouhých víkendů. K tomu je třeba posoudit rychlost práce našeho „podmíněného aplikace“ ve všech popsaných scénářích použití databáze, stejně jako nárůst této doby se zvyšující se velikostí sociální sítě (n). Cílovým parametrem, který nás zajímá a který budeme měřit během experimentu, je čas, který „podmíněná aplikace“ vynaloží na provedení jedné „obchodní operace“. Pod „obchodní operací“ chápeme jednu z následujících:
- Přidání jednoho nového přítele
- Ověření, zda je uživatel A přítelem uživatele B
- Smazání jednoho přítele
Takže, vezmeme-li v úvahu vymezené požadavky v původním zadání, scénář ověření se kreslí následovně:
- Zápis dat. Generovat náhodně počáteční síť o velikosti n. Pro větší přiblížení k „reálnému světu“ je počet přátel každého uživatele také náhodná veličina. Změřit čas, za který naše „podmíněná aplikace“ zapíše do HBase všechna vygenerovaná data. Poté získaný čas vydělit celkovým počtem přidaných přátel – tak získáme průměrný čas na jednu „obchodní operaci“.
- Čtení datPro každého uživatele vytvořte seznam „identit“, pro které je třeba zjistit, zda je uživatel sleduje, či nikoliv. Délka seznamu = přibližně počet přátel uživatele, přičemž u poloviny kontrolovaných přátel by mělo být odpovědí „Ano“ a u druhé poloviny „Ne“. Kontrola probíhá tak, aby se odpovědi „Ano“ a „Ne“ střídaly (to znamená, že v každém druhém případě budeme muset procházet všechny sloupce řádku pro varianty 1 a 2). Celkový čas kontroly se poté vydělí počtem kontrolovaných přátel, aby se získal průměrný čas na kontrolu jedné položky.
- Odstranění datOdstranit všechny přátele uživatele. Přičemž pořadí odstranění je náhodné (to znamená „zamícháme“ původní seznam, který byl použit pro zápis dat). Celkový čas kontroly se poté vydělí počtem odstraňovaných přátel, aby se získal průměrný čas na jednu kontrolu.
Skripty je třeba spustit pro každou z 5 variant datových modelů a pro různé velikosti sociální sítě, abychom zjistili, jak se mění čas s jejím růstem. V rámci jednoho n musí být spojení v síti a seznam uživatelů pro kontrolu, samozřejmě, shodné pro všech 5 variant.
Pro lepší pochopení níže uvádím příklad generovaných dat pro n= 5. Napsaný „generátor“ poskytuje na výstupu tři slovníky ID:
- první – pro vložení
- druhý – pro kontrolu
- třetí – pro odstranění
{0: [1], 1: [4, 5, 3, 2, 1], 2: [1, 2], 3: [2, 4, 1, 5, 3], 4: [2, 1]} # celkem 15 přátel

{0: [1, 10800], 1: [5, 10800, 2, 10801, 4, 10802], 2: [1, 10800], 3: [3, 10800, 1, 10801, 5, 10802], 4: [2, 10800]} # celkem 18 kontrolovaných subjektů

{0: [1], 1: [1, 3, 2, 5, 4], 2: [1, 2], 3: [4, 1, 2, 3, 5], 4: [1, 2]} # celkem 15 přátel
Jak lze vidět, všechny ID větší než 10 000 ve slovníku pro kontrolu jsou přesně ty, které s jistotou vrátí odpověď False. Vkládání, kontrola a odstraňování „přátel“ se provádějí právě v uvedeném pořadí ve slovníku.
Experiment byl prováděn na notebooku s operačním systémem Windows 10, kde byla v jednom kontejneru Docker spuštěna databáze HBase a v druhém – Python s Jupyter Notebook. Dockeru byly přiděleny 2 jádra CPU a 2 GB operační paměti. Celá logika, jak emulace práce „podmínkové aplikace“, tak i „obezlička“ pro generování testovacích dat a měření času, byla napsána v Pythonu. Pro práci s HBase byla použita knihovna , pro výpočet hashů (MD5) pro variantu 5 – hashlib
S ohledem na výpočetní výkon konkrétního notebooku byl experimentálně zvolen běh pro n = 10, 30, …. 170 – když celkový čas trvání úplného testovacího cyklu (všechny scénáře pro všechny varianty pro všechna n) byl ještě více méně rozumný a vešel se do doby jedné čajové pauzy (v průměru 15 minut).
Je třeba učinit poznámku, že v tomto experimentu primárně nehodnotíme absolutní čísla výkonu. I relativní srovnání dvou různých variant nemusí být úplně správné. Nyní nás zajímá právě charakter změny času v závislosti na n, protože s ohledem na výše uvedenou konfiguraci „testovacího stanoviště“ je velmi obtížné získat časové odhady, „vyčištěné“ od vlivu náhodných a dalších faktorů (a takový úkol ani nebyl stanoven).
Výsledek experimentu
První test – jak se mění čas potřebný k vyplnění seznamu přátel. Výsledek – na grafu níže.
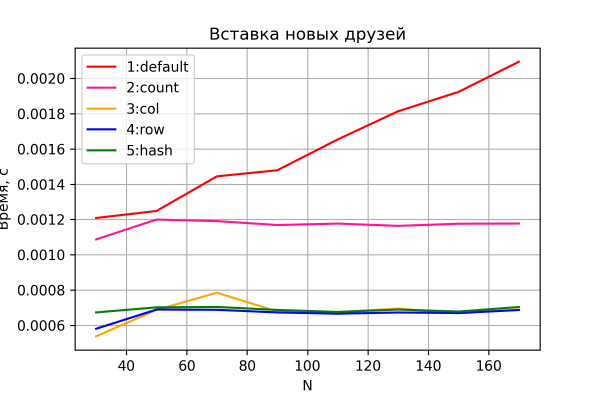
Varianty 3-5 očekávaně ukazují prakticky konstantní čas „obchodní operace“, který nezávisí na růstu velikosti sítě, a nerozlišitelný rozdíl v výkonu.
Varianta 2 také ukazuje konstantní, ale o něco horší výkon, přičemž je prakticky dvakrát horší ve srovnání s variantami 3-5. A to nás nemůže netěšit, protože se to shoduje s teorií – v této variantě je množství vstupně-výstupních operací do/z HBase právě dvakrát větší. To může sloužit jako nepřímý důkaz, že naše testovací stanoviště v zásadě poskytuje dobrou přesnost.
Varianta 1 se také očekávaně ukazuje jako nejpomalejší a vykazuje lineární růst času potřebného k přidání jednoho přítele v závislosti na velikosti sítě.
Podívejme se nyní na výsledky druhého testu.
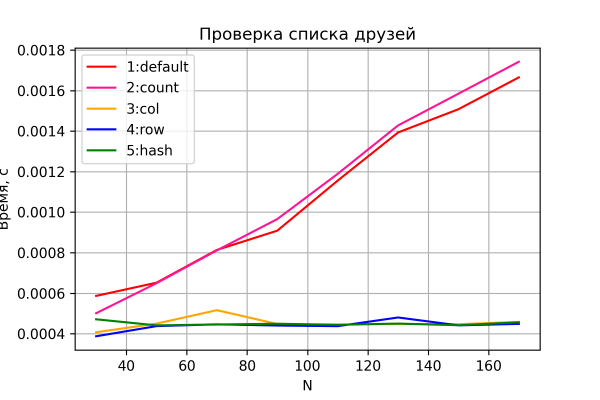
Varianty 3-5 se opět chovají očekávaně – konstantní čas, nezávislý na velikosti sítě. Varianty 1 a 2 vykazují lineární nárůst času s rostoucí velikostí sítě a podobný výkon. Přičemž varianta 2 se ukazuje jako o něco pomalejší – zřejmě kvůli nutnosti číst a zpracovávat dodatečný sloupec „count“, což se při nárůstu n stává výrazně znatelným. Přesto se však zdržím jakýchkoliv závěrů, protože přesnost tohoto srovnání je relativně nízká. Navíc, tyto poměry (která varianta, 1 nebo 2, je rychlejší) se měnily od spuštění k spuštění (při tom si zachovávají charakter závislosti a "jdou hrdlo v hrdlo").
A konečně poslední graf – výsledek testování mazání.
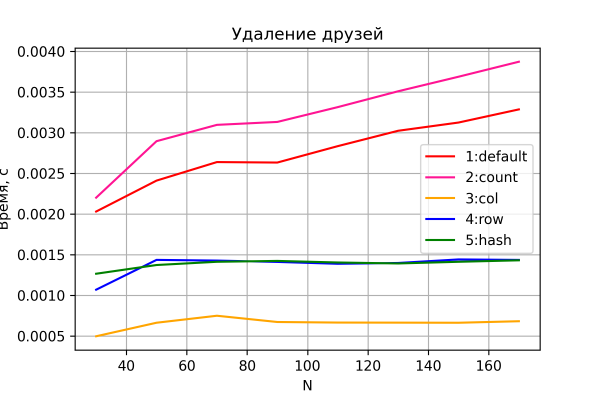
Zde opět bez překvapení. Varianty 3-5 provádějí mazání za konstantní čas.
Což je zajímavé, varianty 4 a 5, na rozdíl od předchozích scénářů, vykazují znatelně horší výkon než varianta 3. Je patrné, že operace mazání řádku je nákladnější než operace mazání sloupce, což je vcelku logické.
Varianty 1 a 2, jak se dalo očekávat, ukazují lineární nárůst času. Přičemž varianta 2 je stabilně pomalejší než varianta 1 – kvůli dodatečné operaci vstupu-výstupu na "údržbu" sloupce count.
Obecné závěry experimentu:
- Varianty 3-5 vykazují větší efektivitu, protože využívají výhody HBase; přičemž jejich výkon se od sebe liší o konstantu a nezávisí na velikosti sítě.
- Rozdíl mezi variantami 4 a 5 nebyl zaznamenán. To však neznamená, že varianta 5 by neměla být používána. Je velmi pravděpodobné, že použitý scénář experimentu s ohledem na technické charakteristiky testovacího stánu neumožnil tuto odchylku odhalit.
- Charakter růstu času potřebného k provádění "obchodních operací" s daty vcelku potvrdil dříve získané teoretické úvahy pro všechny varianty.
Epilog
Prováděné hrubé experimenty nelze brát jako absolutní pravdu. Existuje mnoho faktorů, které nebyly zohledněny a které zkreslují výsledky (zejména jsou tyto fluktuace dobře viditelné na grafech při malém počtu uzlů). Například rychlost práce thrift, kterou používá happybase, objem a způsob implementace logiky, kterou jsem měl napsanou v Pythonu (netvrdím, že kód byl napsán optimálně a efektivně využíval všechny možnosti komponent), možné zvláštnosti cacheování HBase, pozadí aktivity Windows 10 na mém notebooku atd. Celkově lze říci, že všechny teoretické závěry experimentálně prokázaly svou životaschopnost. Nebo alespoň je nebylo možné vyvrátit takovým „náskokem do čela“.
Na závěr – doporučení pro všechny, kteří právě začínají navrhovat datové modely v HBase: abstrahujte od předchozí zkušenosti s relačními databázemi a pamatujte na „přikázání“:
- Při navrhování vycházejte z úkolu a šablon pro manipulaci s daty, nikoliv z modelu předmětné oblasti.
- Efektivní přístup (bez plného skenování tabulky) – pouze podle klíče.
- Denormalizace.
- Různé řádky mohou obsahovat různé sloupce.
- Dynamické složení sloupců.
Zdroj: habr.com
