

Pokračujícím zkoumáním technologií pro zrychlení operací vstupu/výstupu v kontextu úložných systémů, které byly zahájeny v , nelze nezmínit velmi populární možnost, jako je tiering (Auto Tiering). I když je ideologie fungování této funkce velmi podobná u různých výrobců úložných systémů, podíváme se na rysy implementace tieringu na příkladu .
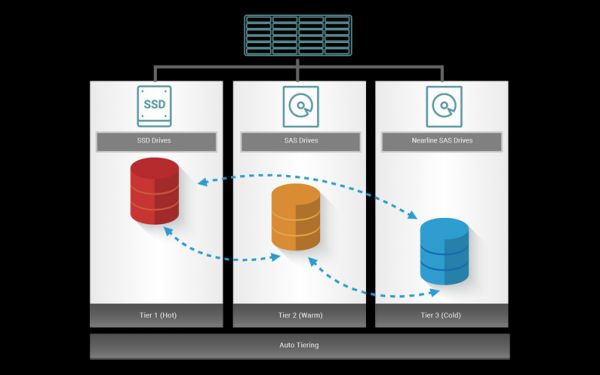
Přes rozmanitost dat uložených na úložném systému lze tato data rozdělit do několika skupin podle jejich poptávky (frekvence používání). Pro nejpopulárnější („horká“) data je nesmírně důležité uspořádat maximálně rychlý přístup, zatímco zpracování méně žádaných („studených“) dat lze provádět s nižší prioritou.
K organizaci takového schématu se právě používá funkce tieringu. Sada dat v tomto případě není složena pouze z homogenních disků, ale z několika skupin úložných zařízení, které vytvářejí různé úrovně (tier) skladování. Pomocí speciálního algoritmu se data automaticky přesouvají mezi úrovněmi s cílem zajistit maximální konečný výkon.
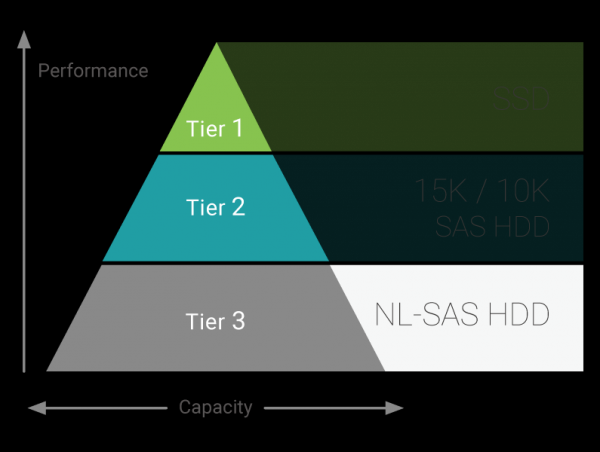
Úložiště dat podporují až tři úrovně skládání:
- Tier 1: SSD, maximální výkon
- Tier 2: HDD SAS 10K/15K, vysoký výkon
- Tier 3: HDD NL-SAS 7.2K, maximální kapacita
Auto Tiering pool může obsahovat jak všechny tři úrovně, tak pouze dvě v různých kombinacích. Uvnitř každého Tieru jsou disky spojeny do obvyklých RAID skupin. Pro maximální flexibilitu může být úroveň RAID v každém Tieru jiná. Tedy například, nic nebrání organizaci struktury jako 4x SSD RAID10 + 6x HDD 10K RAID5 + 12 HDD 7.2K RAID6.
Po vytvoření objemů (virtuálních disků) na poolu začíná na něm pozadí sběr statistik o všech operacích vstupu/výstupu. K tomu je prostor „rozdělen“ na bloky o velikosti 1GB (takzvané sub LUN). Při každém přístupu k takovému bloku mu je přiřazen koeficient 1. Poté, s ubíhajícím časem, se tento koeficient snižuje. Po 24 hodinách, při absenci požadavků na vstup/výstup k tomuto bloku, již bude rovnat 0.5 a bude pokračovat v poklesu každou následnou hodinu.
V určitém čase (ve výchozím nastavení každý den o půlnoci) dochází k hodnocení shromážděných výsledků podle aktivity sub LUN na základě jejich koeficientů. Na základě toho se rozhoduje, které bloky přesunout a kterým směrem. Následně pak dochází k relokaci dat mezi úrovněmi.
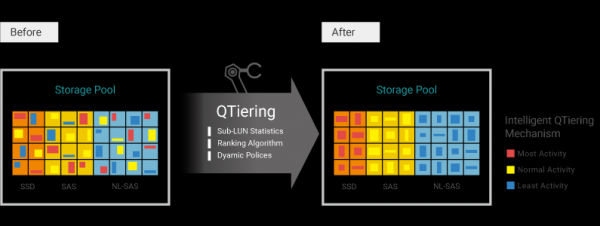
V úložišti Qsan je skvěle realizována správa procesu tieringu pomocí mnoha parametrů, což umožňuje velmi flexibilně nastavit výsledný výkon pole.
Pro určení počáteční polohy dat a preferovaného směru jejich přesunu se používají politiky, které jsou nastavovány jednotlivě pro každý svazek:
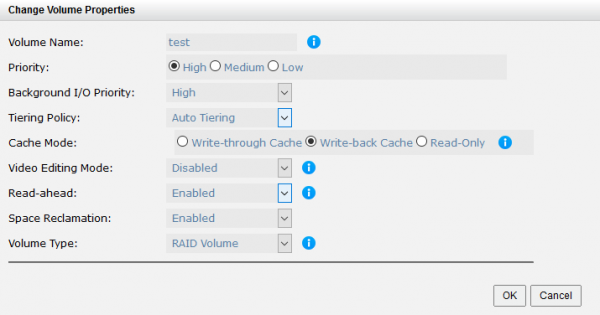
- Auto Tiering – výchozí politika, počáteční umístění a směr přesunů jsou určovány automaticky, tj. "živá" data se snaží dostat na nejvyšší úroveň, zatímco "chladná" data se posouvají dolů. Počáteční umístění se vybírá na základě dostupného místa na každé z úrovní. Je však třeba mít na paměti, že systém se primárně snaží maximálně využívat nejrychlejší úložiště. Proto, pokud je k dispozici volné místo, budou data umístěna na vyšších úrovních. Tato politika je vhodná pro většinu scénářů, kdy není možné předem předpovědět poptávku po datech.
- Začít s vysokou úrovní a poté provést Auto Tiering – od předchozí se liší pouze počátečním umístěním dat (na nejrychlejší úrovni)
- Maximálně vysoká úroveň – data se vždy snaží obsadit nejrychlejší úroveň. Pokud jsou během provozu posunuta dolů, při první příležitosti se přesouří zpět. Tato politika je vhodná pro data, ke kterým je potřeba maximálně rychlý přístup.
- Minimální úroveň – data se vždy snaží obsadit nejnižší úroveň. Tato politika je skvělá pro zřídka používaná data (např. archivy).
- Bez přesunu – systém automaticky určuje počáteční polohu dat a neprovádí jejich přesun. Statistiky se však nadále shromažďují pro případ, že by později bylo potřeba jejich relokace.
Je třeba poznamenat, že i když se politiky určují při vytváření každého svazku, mohou se opakovaně měnit "za chodu" během životního cyklu systému.
Kromě politik pro mechanismus tieringu lze nastavit také frekvenci a tempo přesunu dat mezi úrovněmi. Lze určit konkrétní čas přesunu: denně nebo v určité dny v týdnu, a také zkrátit interval sběru statistik na několik hodin (minimální frekvence – 2 hodiny). Pokud je třeba omezit čas provádění operace přesunu dat, lze nastavit časové rámce (okno pro přesun). Kromě toho se také uvádí rychlost relokace – 3 režimy: rychlý, střední, pomalý.
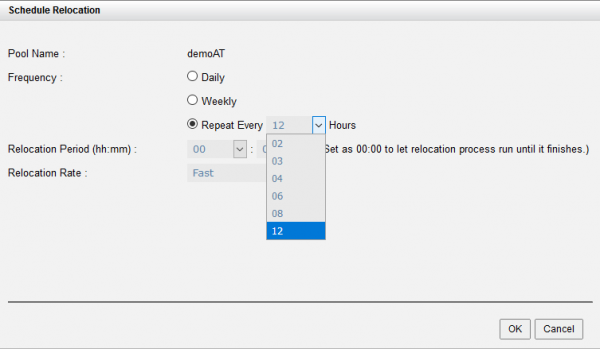
V případě potřeby okamžité relokace dat je možné ji provést v ručním režimu kdykoli na příkaz administrátora.
Je jasné, že čím častěji a rychleji bude přesun dat mezi úrovněmi prováděn, tím flexibilněji se úložiště přizpůsobí aktuálním podmínkám provozu. Je však také důležité si uvědomit, že přesun znamená dodatečnou zátěž (zejména pro disky), a proto není vhodné „nahánět“ data bez vážné potřeby. Lépe je naplánovat přesun na době minimálního zatížení. Pokud však provoz úložiště stálé vyžaduje vysoký výkon v režimu 24/7, je dobré snížit tempo relokace na minimum.
Obyčejně rozšířené možnosti configurace tieringu bez pochyb potěší pokročilé uživatele. Pro ty, kteří se s takovou technologií setkávají poprvé, však není třeba se bát. Je možné důvěřovat výchozím nastavením (politika Auto Tiering, přesun maximální rychlostí jednou za noc) a s rostoucími statistikami upravovat jednotlivé parametry k dosažení požadovaných výsledků.
Při srovnání tieringu s tak populární technologií zvyšování výkonu, jako je , je třeba mít na paměti rozdílné principy fungování jejich algoritmů.
SSD caching
Auto Tiering
Rychlost nástupu efektu
Téměř okamžitě. Viditelný efekt však nastává až po "prohřátí" cache (minuty-hodiny)
Po shromáždění statistik (od 2 hodin, ideálně – 24 hodin) plus čas na přesun dat
Délka efektu
Dokud budou data vytlačena novou porcí (minuty-hodiny)
Pokud je poptávka po datech aktuální (24 hodin a více)
Indikace pro použití
Okamžité zvýšení výkonu na krátkou dobu (databáze, virtuální prostředí)
Dlouhodobé zvýšení výkonu (soubory, webové, poštovní servery)
Jednou z výhod tieringu je jeho využití nejen pro scénáře typu „SSD + HDD“, ale také pro „rychlé HDD + pomalé HDD“ nebo dokonce všechny tři úrovně, což je v případě použití SSD cache principielně nemožné.
Testování
Pro testování účinnosti algoritmů tieringu jsme provedli jednoduchý test. Byla vytvořena skupina ze dvou úrovní SSD (RAID 1) + HDD 7.2K (RAID 1), na níž byl umístěn svazek s politikou „minimální úroveň“. Tj. data by měla být vždy umístěna na pomalých discích.
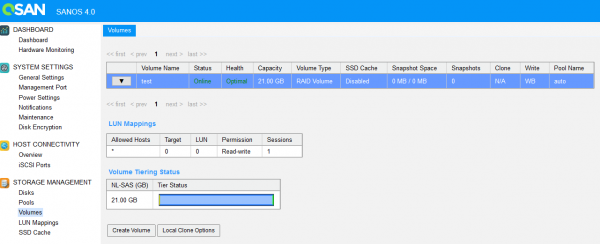
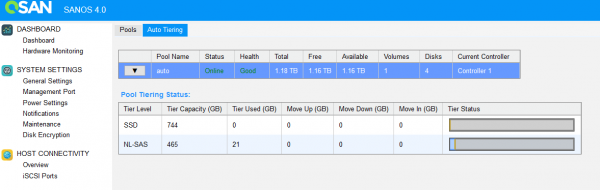
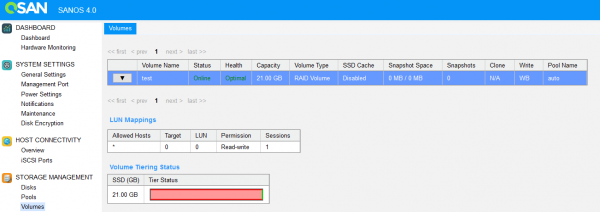
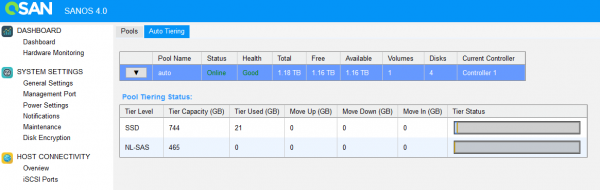
Řídicí rozhraní přehledně ukazuje umístění dat mezi úrovněmi.
Po naplnění svazku daty jsme změnili politiku umístění na Auto Tiering a spustili test IOmeter.
Po několika hodinách testování, kdy systém shromáždil statistiky, začal proces relokace.
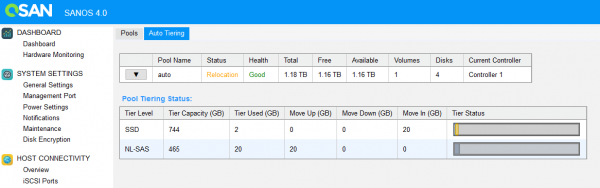
Po dokončení přesunu dat se náš testovací svazek zcela „přesunul“ na vrcholovou úroveň (SSD).
Verdikt
Auto Tiering – skvělá technologie, která umožňuje zvýšit výkon systému úložiště s minimálním materiálním a časovým úsilím díky intenzivnějšímu využití rychlých zařízení. Pokud jde o jediné investice – to je licence, která se kupuje jednou a navždy bez omezení na objem/počet disků/políc/atd. Tato funkce je vybavena velmi bohatými nastaveními, které dokážou uspokojit prakticky jakékoli potřeby podnikání. A vizualizace procesů v rozhraní umožní efektivně spravovat zařízení.
Zdroj: habr.com
