

V Linuxu existuje mnoho nástrojů pro ladění jádra a aplikací. Většina z nich negativně ovlivňuje výkon aplikací a nemůže být použita v produkci.
Před několika lety byl — eBPF. Umožňuje sledovat jádro a uživatelské aplikace s nízkou režijní zátěží a bez nutnosti překompilace programů a načítání externích modulů do jádra.
Dnes již existuje mnoho aplikací, které využívají eBPF, a v tomto článku se podíváme na to, jak napsat vlastní profilovací utilitu založenou na knihovně . Článek je založen na skutečných událostech. Projdeme si cestu od vzniku problému po jeho vyřešení, abychom ukázali, jak mohou být využity již existující utility v konkrétních situacích.
Ceph je pomalý
Do clusteru Ceph byl přidán nový hostitel. Po migraci části dat na něj jsme si všimli, že rychlost zpracování zápisových požadavků je mnohem nižší než na jiných serverech.
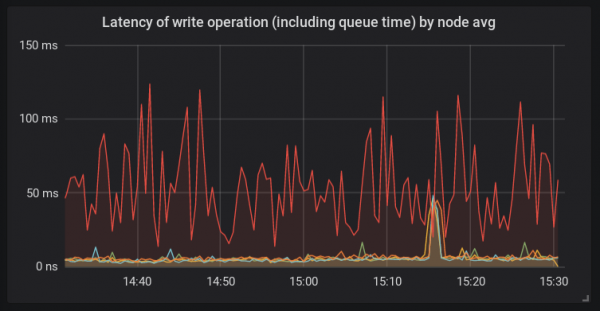
Na rozdíl od jiných platforem byl na tomto hostiteli použit bcache a nové jádro linux 4.15. Hostitel této konfigurace byl používán zde poprvé. A v tu chvíli bylo jasné, že příčinou problému mohlo být teoreticky cokoliv.
Zkoumání hostitele
Začneme tím, že se podíváme na to, co se děje uvnitř procesu ceph-osd. K tomu využijeme a (o kterém si můžete přečíst více ):
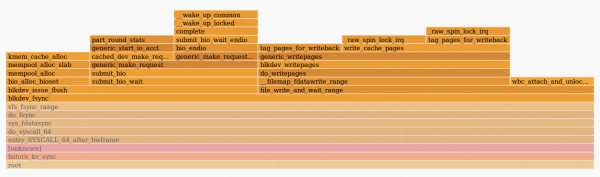
Obrázek nám říká, že funkce fdatasync() strávila hodně času při odeslání žádosti ve funkci generic_make_request(). To znamená, že příčina problémů se pravděpodobně nachází někde mimo samotného démona osd. Může to být buď jádro, nebo disky. Výstup iostat ukazoval vysokou latenci zpracování požadavků bcache-disky.
Při kontrole hostitele jsme zjistili, že démon systemd-udevd spotřebovává velké množství času CPU — přibližně 20% na několika jádrech. Toto podivné chování, je třeba zjistit jeho příčinu. Protože Systemd-udevd pracuje s ueventy, rozhodli jsme se na ně podívat přes udevadm monitor. Ukázalo se, že se generovalo velké množství change událostí pro každé blokové zařízení v systému. To je docela neobvyklé, a tak bude třeba zjistit, co generuje všechny tyto události.
Použití nástroje BCC
Jak jsme již zjistili, jádro (a démon ceph při systémovém volání) tráví spoustu času v generic_make_request(). Pokusíme se změřit rychlost práce této funkce. V již existuje skvělá utilita — funclatency. Budeme sledovat démon podle jeho PID s intervalem mezi výstupy informací 1 sekundu a výstupem výsledků v milisekundách.
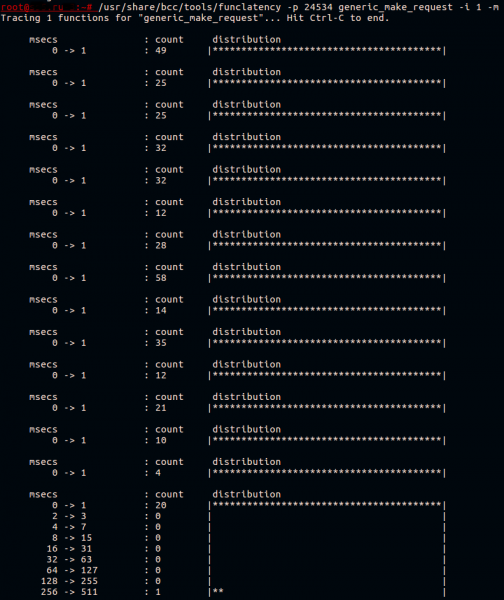
Obvykle tato funkce funguje rychle. Vše, co dělá, je předání požadavku do fronty ovladače zařízení.
Bcache je složité zařízení, které se vlastně skládá ze tří disků:
- backing device (cacheovaný disk), v tomto případě je to pomalý HDD;
- caching device (cacheující disk), zde je to jeden oddíl NVMe zařízení;
- virtuální zařízení bcache, se kterým aplikace pracuje.
Víme, že předání požadavku zpomaluje, ale u kterého z těchto zařízení? Na to se podíváme později.
Teď víme, že ueventy pravděpodobně způsobují problémy. Není tak snadné najít, co přesně je vyvolává. Předpokládejme, že je to nějaký software, který se spouští periodicky. Podíváme se, jaký software se spouští v systému pomocí skriptu execsnoop ze stejné . Spustíme ho a nasměrujeme výstup do souboru.
Například takto:
/usr/share/bcc/tools/execsnoop | tee ./execdump
Nebudeme zde uvádět úplný výstup execsnoop, ale jedna zajímavá řádka vypadala takto:
sh 1764905 5802 0 sudo arcconf getconfig 1 AD | grep Temperature | awk -F '[:\/]' '{print $2}' | sed 's\/^ ([0-9]*) C.*\/1\/'
Třetí sloupec je PPID (parent PID) procesu. Proces s PID 5802 byl jedním z vláken našeho monitorovacího systému. Při kontrole konfigurace monitorovacího systému byly nalezeny chybně nastavené parametry. Teplota HBA adaptéru byla snímána každých 30 sekund, což bylo mnohem častěji, než je potřeba. Po změně intervalu kontroly na delší jsme zjistili, že zpoždění zpracování požadavků na tomto hostiteli přestalo být patrné v porovnání s ostatními hostiteli.
Ale stále není jasné, proč bcache zařízení tak zpomalovalo. Připravili jsme testovací platformu se stejnou konfigurací a pokusili se problém reprodukovat spuštěním fio na bcache a periodickým spouštěním udevadm trigger pro generování uevents.
Psání nástrojů založených na BCC
Zkusíme napsat jednoduchou utilitu pro sledování a výstup na obrazovku nejpomalejších volání generic_make_request(). Také nás zajímá název disku, pro který byla tato funkce volána.
Plán je jednoduchý:
- Registrováno kprobe na generic_make_request():
- Uložíme do paměti název disku dostupný přes argument funkce;
- Uložíme časové razítko.
- Registrováno kretprobe při návratu z generic_make_request():
- Získáme aktuální časové razítko;
- Hledáme uložené časové razítko a porovnáváme s aktuálním;
- Pokud je výsledek větší než zadaná hodnota, najdeme uložené jméno disku a zobrazíme ho na terminálu.
Kprobes a kretprobes využívají mechanismus bodů zastavení k dynamické změně kódu funkcí. Můžete si přečíst a článek na toto téma. Pokud se podíváme na kód různých nástrojů v , můžeme si všimnout, že mají identickou strukturu. Takže v tomto článku vynecháme parsování argumentů skriptu a přejdeme k samotnému programu BPF.
Text eBPF uvnitř python skriptu vypadá následovně:
bpf_text = """ # Zde bude kód bpf programu """
Pro výměnu dat mezi funkcemi používají eBPF programy . Uděláme to také. Jako klíč budeme používat PID procesu a jako hodnotu definujeme strukturu:
struct data_t {
	u64 pid;
	u64 ts;
	char comm[TASK_COMM_LEN];
	u64 lat;
	char disk[DISK_NAME_LEN];
};

BPF_HASH(p, u64, struct data_t);
BPF_PERF_OUTPUT(events);
Zde registrujeme hash tabulku, která se nazývá p, s klíčem typu u64 a hodnotou typu struct data_t. Tabulka bude dostupná v kontextu našeho BPF programu. Makro BPF_PERF_OUTPUT registruje další tabulku, nazvanou events, která se používá pro do uživatelského prostoru.
Při měření latencí mezi voláním funkce a návratem z ní, nebo mezi voláními různých funkcí, je nutné mít na paměti, že získaná data by měla patřit do jednoho kontextu. Jinými slovy, je třeba mít na paměti možný paralelní běh funkcí. Máme možnost měřit latenci mezi voláním funkce v kontextu jednoho procesu a návratem z této funkce v kontextu jiného procesu, ale to může být v praxi bezcenné. Dobrou ukázkou je , kde je jako klíč hash tabulky zadán ukazatel na struct request, který reprezentuje jeden diskový požadavek.
Nyní potřebujeme napsat kód, který bude spuštěn při volání zkoumané funkce:
void start(struct pt_regs *ctx, struct bio *bio) {
	u64 pid = bpf_get_current_pid_tgid();
	struct data_t data = {};
	u64 ts = bpf_ktime_get_ns();
	data.pid = pid;
	data.ts = ts;
	bpf_probe_read_str(&data.disk, sizeof(data.disk), (void*)bio->bi_disk->disk_name);
	p.update(&pid, &data);
}
Jako druhý argument bude použit první argument volané funkce . Poté získáme PID procesu, v jehož kontextu pracujeme, a aktuální časovou značku v nanosekundách. Všechny tyto informace zapíšeme do nově alokované struct data_t data. Jméno disku získáme ze struktury bio, která se předává při volání generic_make_request(), a uchováváme ji ve stejné struktuře data. Posledním krokem je přidání záznamu do hash tabulky, o které bylo řečeno dříve.
Následující funkce bude volána při návratu z generic_make_request():
void stop(struct pt_regs *ctx) {
    u64 pid = bpf_get_current_pid_tgid();
    u64 ts = bpf_ktime_get_ns();
    struct data_t* data = p.lookup(&pid);
    if (data != 0 && data->ts > 0) {
        bpf_get_current_comm(&data->comm, sizeof(data->comm));
        data->lat = (ts - data->ts)/1000;
        if (data->lat > MIN_US) {
            FACTOR
            data->pid >>= 32;
            events.perf_submit(ctx, data, sizeof(struct data_t));
        }
        p.delete(&pid);
    }
}
Tato funkce je podobná předchozí: zjistíme PID procesu a časovou značku, ale nevyčleňujeme paměť pro novou strukturu data. Místo toho hledáme v hash tabulce již existující strukturu podle klíče == aktuální PID. Pokud byla struktura nalezena, zjistíme jméno spuštěného procesu a přidáme ho do ní.
Binární posun, který zde používáme, je potřebný k získání GID vlákna, tj. PID hlavního procesu, který spustil vlákno, v kontextu, ve kterém pracujeme. Voláme funkci vrací jak GID vlákna, tak jeho PID v jedné 64bitové hodnotě.
Při výstupu do terminálu nás teď nezajímá vlákno, ale hlavní proces. Po porovnání získané latence se stanoveným prahem předáváme naši strukturu data do uživatelského prostoru prostřednictvím tabulky events, poté vymažeme záznam z p.
V python skriptu, který tento kód načte, bude třeba nahradit MIN_US a FACTOR prahovými hodnotami latence a časovými jednotkami, které předáme jako argumenty:
bpf_text = bpf_text.replace('MIN_US',str(min_usec))
if args.milliseconds:
	bpf_text = bpf_text.replace('FACTOR','data->lat /= 1000;')
	label = "msec"
else:
	bpf_text = bpf_text.replace('FACTOR','')
	label = "usec"
Nyní musíme připravit BPF program prostřednictvím a zaregistrovat záznamy:
b = BPF(text=bpf_text)
b.attach_kprobe(event="generic_make_request",fn_name="start")
b.attach_kretprobe(event="generic_make_request",fn_name="stop")
Také budeme muset definovat struct data_t v našem skriptu, jinak nebude možné nic přečíst:
TASK_COMM_LEN = 16	# linux/sched.h
DISK_NAME_LEN = 32	# linux/genhd.h
class Data(ct.Structure):
	_fields_ = [("pid", ct.c_ulonglong),
            	("ts", ct.c_ulonglong),
            	("comm", ct.c_char * TASK_COMM_LEN),
            	("lat", ct.c_ulonglong),
            	("disk",ct.c_char * DISK_NAME_LEN)]
Posledním krokem je výstup dat na terminál:
def print_event(cpu, data, size):
    global start
    event = ct.cast(data, ct.POINTER(Data)).contents
    if start == 0:
        start = event.ts
    time_s = (float(event.ts - start)) / 1000000000
    print("%-18.9f %-16s %-6d   %-1s %s   %s" % (time_s, event.comm, event.pid, event.lat, label, event.disk))

b["events"].open_perf_buffer(print_event)
# formát výstupu
start = 0
while 1:
    try:
        b.perf_buffer_poll()
    except KeyboardInterrupt:
        exit()
Skript je k dispozici na . Zkusíme ho spustit na testovací platformě, kde běží fio, zapisující na bcache, a spustíme udevadm monitor:
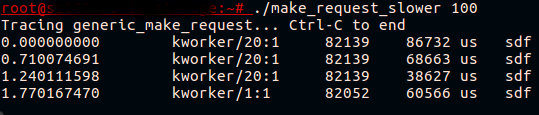
Konečně! Nyní vidíme, že to, co vypadalo jako zpomalení zařízení bcache, je ve skutečnosti zpomalený volání generic_make_request() pro disk s mezipamětí.
Zjistěte více o Kernelu
Co přesně zpomaluje při odesílání požadavku? Vidíme, že zpoždění nastává ještě před tím, než začíná účtování požadavku, tj. sledování konkrétního požadavku pro další vykázání statistik ( /proc/diskstats nebo iostat) ještě nezačalo. To lze snadno zkontrolovat spuštěním iostat během reprodukce problému, nebo , který se zakládá na začátku a konci účtování požadavků. Žádný z těchto nástrojů neukáže problémy s požadavky na disk s mezipamětí.
Pokud se podíváme na funkci generic_make_request(), uvidíme, že před začátkem účtování požadavku jsou volány ještě dvě funkce. První — generic_make_request_checks(), provádí kontroly platnosti požadavku vzhledem k nastavení disku. Druhá — , ve které je zajímavé volání :
ret = wait_event_interruptible(q->mq_freeze_wq,
	(atomic_read(&q->mq_freeze_depth) == 0 &&
	(preempt || !blk_queue_preempt_only(q))) ||
	blk_queue_dying(q));
V něm jádro čeká na odblokování fronty. Změříme zpoždění blk_queue_enter():
~# /usr/share/bcc/tools/funclatency blk_queue_enter -i 1 -m
Sledování 1 funkcí pro "blk_queue_enter"... Stiskněte Ctrl-C pro ukončení.

 	msecs           	: počet 	distribution
     	0 -> 1      	: 341  	|****************************************|

 	msecs           	: počet 	distribution
     	0 -> 1      	: 316  	|****************************************|

 	msecs           	: počet 	distribution
     	0 -> 1      	: 255  	|****************************************|
     	2 -> 3      	: 0    	|                                    	|
     	4 -> 7      	: 0    	|                                    	|
     	8 -> 15     	: 1    	|                                    	|
Vypadá to, že jsme blízko rozluštění. Funkce používané pro "zmražení/odmražení" fronty jsou a . Používají se, když je třeba změnit nastavení fronty požadavků, které mohou být nebezpečné pro požadavky, které se nacházejí v této frontě. Při volání blk_mq_freeze_queue() funkcí se zvyšuje čítač q->mq_freeze_depth. Po tomto jádro čeká na vyprázdnění fronty v .
Doba čekání na vyprázdnění této fronty je ekvivalentní zpoždění disku, protože jádro čeká na dokončení všech operací zařazených do fronty. Jakmile je fronta prázdná, použijí se změny nastavení. Poté se volá , která dekrementuje čítač freeze_depth.
Nyní víme dost na to, abychom situaci napravili. Příkaz udevadm trigger pak vede k aplikaci nastavení pro blokové zařízení. Tato nastavení jsou popsána v pravidlech udev. Můžeme zjistit, která konkrétní nastavení 'zamrazují' frontu, když se pokusíme je změnit přes sysfs nebo se podíváme na zdrojový kód jádra. Můžeme také vyzkoušet nástroj BCC, , který zobrazí na terminálu stopy zásobníku jádra a uživatelského prostoru pro každý volání blk_freeze_queue, například:
~# /usr/share/bcc/tools/trace blk_freeze_queue -K -U
PID 	TID 	COMM        	FUNC
3809642 3809642 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [kernel]
    	elevator_switch+0x29 [kernel]
    	elv_iosched_store+0x197 [kernel]
    	queue_attr_store+0x5c [kernel]
    	sysfs_kf_write+0x3c [kernel]
    	kernfs_fop_write+0x125 [kernel]
    	__vfs_write+0x1b [kernel]
    	vfs_write+0xb8 [kernel]
    	sys_write+0x55 [kernel]
    	do_syscall_64+0x73 [kernel]
    	entry_SYSCALL_64_after_hwframe+0x3d [kernel]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[unknown]

3809631 3809631 systemd-udevd   blk_freeze_queue
    	blk_freeze_queue+0x1 [kernel]
    	queue_requests_store+0xb6 [kernel]
    	queue_attr_store+0x5c [kernel]
    	sysfs_kf_write+0x3c [kernel]
    	kernfs_fop_write+0x125 [kernel]
    	__vfs_write+0x1b [kernel]
    	vfs_write+0xb8 [kernel]
    	sys_write+0x55 [kernel]
    	do_syscall_64+0x73 [kernel]
    	entry_SYSCALL_64_after_hwframe+0x3d [kernel]
    	__write_nocancel+0x7 [libc-2.23.so]
    	[unknown]
Pravidla udev se mění poměrně zřídka a obvykle to probíhá pod kontrolou. Takže vidíme, že i použití již zadaných hodnot způsobuje nárůst zpoždění přenosu požadavku od aplikace k disku. Samozřejmě generovat události udev, když nedochází k žádným změnám v konfiguraci disků (například když se zařízení nepřipojuje/odpojuje), není příliš dobrou praxí. Nicméně můžeme pomoci jádru, aby nedělalo zbytečnou práci a nezamrzlo frontu požadavků, pokud to není nutné. napravují situaci.
Závěr
eBPF je velmi flexibilní a mocný nástroj. V článku jsme prozkoumali jeden praktický případ a demonstrovali malou část toho, co je možné udělat. Pokud vás zajímá vývoj nástrojů BCC, stojí za to podívat se na , který dobře popisuje základy práce.
Existují také další zajímavé nástroje pro ladění a profilování, založené na eBPF. Jeden z nich je , který umožňuje psát mocné jednorázové skripty a malé programy v jazyce podobném awk. Dále je tu , který umožňuje shromažďovat nízkoúrovňové metriky s vysokým rozlišením přímo na váš server Prometheus, s možností následně získat krásnou vizualizaci a dokonce i upozornění.
Zdroj: habr.com
