

Pokud vaše IT infrastruktura roste příliš rychle, dříve či později se setkáte s volbou – buď lineárně zvyšovat lidské zdroje na její podporu, nebo začít automatizovat. Do určitého okamžiku jsme žili v první paradigmy, a pak začala dlouhá cesta k Infrastructure-as-Code.
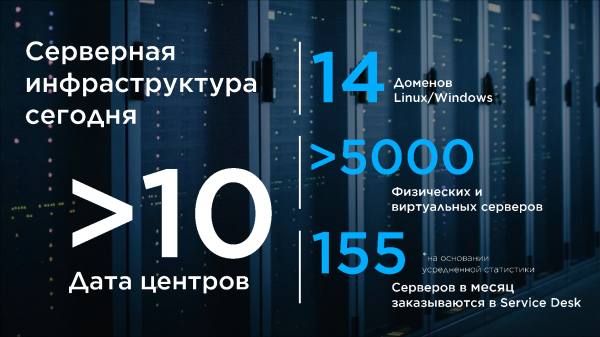
Samozřejmě, NSPK není startup, ale taková atmosféra panovala ve společnosti v prvních letech její existence, a to byly velmi zajímavé roky. Jmenuji se , více než 10 let udržuji infrastrukturu Linux s vysokými požadavky na dostupnost. K týmu NSPK jsem se připojil v lednu 2016 a bohužel jsem nezažil samotný začátek existence společnosti, ale přišel jsem ve fázi velkých změn.
Celkově lze říci, že náš tým dodává společnosti dva produkty. První – to je infrastruktura. Pošta musí fungovat, DNS musí pracovat, a řadiče domény – musí vás pustit na servery, které nesmí padat. IT krajina společnosti je obrovská! Jsou to business & mission critical systémy, požadavky na dostupnost některých z nich – 99,999. Druhý produkt – to jsou samotné servery, fyzické i virtuální. O existující je třeba se starat a nové pravidelně dodávat zákazníkům z mnoha oddělení. V tomto článku chci zdůraznit, jak jsme vyvíjeli infrastrukturu, která odpovídá za životní cyklus servery.
Začátek cesty
Na začátku naší cesty náš technologický stack vypadal takto:
OS CentOS 7
Řadiče domény FreeIPA
Automatizace – Ansible(+Tower), Cobbler
Všechno to bylo umístěno ve 3 doménách, rozprostřených na několika datových centrech. V jednom datovém centru byly kancelářské systémy a testovací plochy, v ostatních PROD.
Vytváření serverů v určitém okamžiku vypadalo takto:
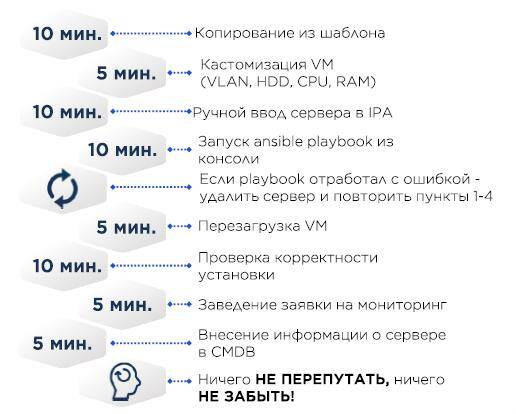
Ve šabloně VM CentOS minimal a potřebné minimum jako správné /etc/resolv.conf, zbytek přichází přes Ansible.
CMDB – Excel.
Pokud je server fyzický, místo kopírování virtuálního stroje se na něj instaloval OS s pomocí Cobbler – do konfigurace Cobbler se přidávají MAC adresy cílového serveru, server získává IP adresu přes DHCP, a pak se nahrává OS.
Zpočátku jsme se dokonce pokoušeli o nějakou správu konfigurací v Cobbler. Ale s časem to začalo přinášet problémy s přenositelností konfigurací jak do jiných datových center, tak do Ansible kódu pro přípravu VM.
Mnozí z nás v té době vnímali Ansible jako pohodlné rozšíření Bash a nešetřili konstrukcemi využívajícími shell nebo sed. Ve zkratce, Bashsible. To nakonec vedlo k tomu, že pokud playbook z nějakého důvodu nefungoval na serveru, bylo snazší server smazat, opravit playbook a znovu ho spustit. V podstatě neexistovalo žádné verzování skriptů ani přenositelnost konfigurací.
Například jsme chtěli změnit nějaký konfigurační soubor na všech serverech:
- Měníme konfiguraci na existujících serverech v logickém segmentu/datovém centru. Někdy to netrvá jen jeden den — požadavky na dostupnost a zákon velkých čísel neumožňují provádět všechny změny najednou. A některé změny jsou potenciálně destruktivní a vyžadují restart něčeho — od služeb až po samotný operační systém.
- Opravy v Ansible
- Opravy v Cobbler
- Opakujeme Nkrát pro každý logický segment/datové centrum
Aby všechny změny proběhly hladce, bylo nutné zohlednit řadu faktorů a změny se neustále objevují.
- Refaktoring ansible kódu, konfiguračních souborů
- Změna interních best practices
- Změny na základě analýzy incidentů/nehod
- Změna bezpečnostních standardů, jak interních, tak externích. Například PCI DSS se každý rok doplňuje o nové požadavky
Růst infrastruktury a začátek cesty
Počet serverů/logických domén/datových center rostl, a s ním i množství chyb v konfiguracích. V určitém okamžiku jsme došli k třem směrům, směrem k nimž je třeba rozvíjet správu konfigurací:
- Automatizace. Jak je to možné, je třeba se vyhnout lidskému faktoru v opakujících se operacích.
- Opakovatelnost. Spravovat infrastrukturu je mnohem jednodušší, když je předvídatelná. Konfigurace serverů a nástrojů k jejich přípravě by měly být všude stejné. To je také důležité pro produktové týmy – aplikace by měla po testování zaručeně přejít do produkčního prostředí, které je nastaveno obdobně jako testovací.
- Jednoduchost a transparentnost změn v managementu konfigurací.
Zůstává přidat pár nástrojů.
Jako úložiště kódu jsme vybrali GitLab CE, nejen kvůli přítomnosti integrovaných modulů CI/CD.
Úložiště tajemství — Hashicorp Vault, také díky skvělému API.
Testování konfigurací a ansible rolí – Molecule+Testinfra. Testy probíhají mnohem rychleji, pokud připojíte k ansible mitogen. Paralelně jsme začali psát vlastní CMDB a orchestrátor pro automatické nasazení (na obrázku nad Cobbler), ale to už je docela jiný příběh, o kterém v budoucnu promluví můj kolega a hlavní vývojář těchto systémů.
Naše volba:
Molecule + Testinfra
Ansible + Tower + AWX
Svět serverů + DITNET (vlastní vývoj)
Cobbler
Gitlab + GitLab runner
Hashicorp Vault
Mimochodem o ansible rolích. Nejdříve byla jedna, po několika refaktorizacích jich vzniklo 17. Důrazně doporučuji rozdělit monolit na idempotentní role, které lze spouštět samostatně a navíc lze přidat tagy. My jsme role rozčlenili podle funkcionality – síť, logování, balíčky, hardware, molekuly atd. A vlastně jsme se řídili níže uvedenou strategií. Netvrdím, že to je pravda v jediné instanci, ale nám to fungovalo.
- Kopírování serverů z „zlatého obrazu“ – zlo!Mezi hlavní nevýhody – přesně nevíte, v jakém stavu jsou obrazy nyní, a že všechna změna se promítne do všech obrazů ve všech farmách virtualizace.
- Používejte výchozí konfigurační soubory co nejméně a dohodněte se s ostatními odděleními, že za hlavní systémové soubory odpovídáte vy., například:
- Nechte /etc/sysctl.conf prázdný, nastavení by mělo být pouze v /etc/sysctl.d/. Váš výchozí v jednom souboru, vlastní pro aplikaci v jiném.
- Používejte přepisovací soubory pro úpravu systemd jednotek.
- Šablonizujte všechny konfigurace a vkládejte je celé, pokud možno žádné sed a jeho analogy v playbookách.
- Při refaktorizaci kódu systému správy konfigurací:
- Rozdělte úkoly na logické entity a přepište monolit na role.
- Používejte lintry! Ansible-lint, yaml-lint atd.
- Změňte přístup! Žádné bashsible. Je třeba popisovat stav systému.
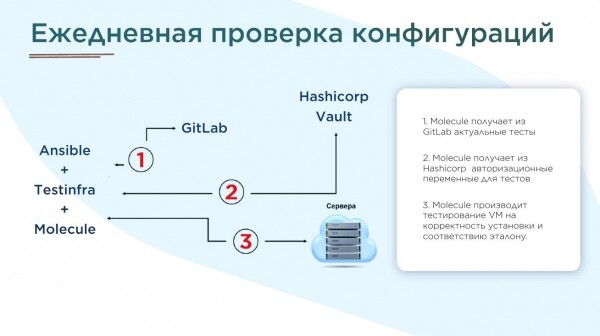
- Pro všechny Ansible role je třeba napsat testy v molekule a každý den generovat zprávy.
- V našem případě, po přípravě testů (kterých je více než 100), jsme našli přibližně 70000 chyb. Opravy trvaly několik měsíců.

Naše implementace
Takže, Ansible role byly připraveny, šablonizovány a zkontrolovány lintry. A dokonce byly všude zvednuty gity. Ale otázka spolehlivé dodávky kódu do různých segmentů zůstala otevřená. Rozhodli jsme se synchronizovat skripty. Vypadá to takto:
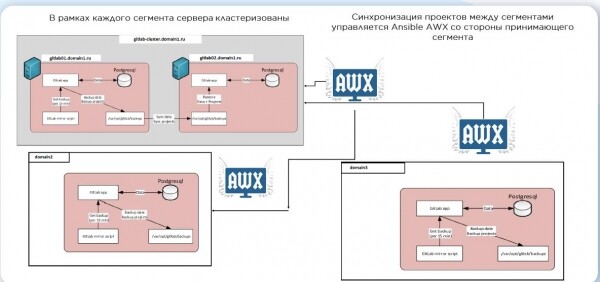
Po příjezdu změny se spouští CI, vytváří se testovací server, aplikují se role, testují se pomocí Molecule. Pokud je vše v pořádku, kód se posílá do produkční větve. Ale nový kód automaticky nepouštíme na stávající servery. Je to jakýsi zátaras, který je nezbytný pro vysokou dostupnost našich systémů. A když se infrastruktura stává obrovskou, hraje zde roli také zákon velkých čísel – i když si jste jisti, že změna je neškodná, může to vést k tragickým následkům.
Možností, jak vytvářet servery, je také mnoho. Nakonec jsme zvolili vlastní skripty v Pythonu. A pro CI Ansible:
- name: create1.yml - Vytvořit VM z šablony
  vmware_guest:
    hostname: "{{datacenter}}".domain.ru
    username: "{{ username_vc }}"
    password: "{{ password_vc }}"
    validate_certs: no
    cluster: "{{cluster}}"
    datacenter: "{{datacenter}}"
    name: "{{ name }}"
    state: poweredon
    folder: "\/{{folder}}"
    template: "{{template}}"
    customization:
      hostname: "{{ name }}"
      domain: domain.ru
      dns_servers:
        - "{{ ipa1_dns }}"
        - "{{ ipa2_dns }}"
    networks:
      - name: "{{ network }}"
        type: static
        ip: "{{ip}}"
        netmask: "{{netmask}}"
        gateway: "{{gateway}}"
        wake_on_lan: True
        start_connected: True
        allow_guest_control: True
    wait_for_ip_address: yes
    disk:
      - size_gb: 1
        type: thin
        datastore: "{{datastore}}"
      - size_gb: 20
        type: thin
        datastore: "{{datastore}}"
Tady jsme se dostali, systém pokračuje v životě a rozvoji.
- 17 ansible-rolí pro nastavení serveru. Každá z rolí je určena pro vyřešení určité logické úlohy (logování, audit, autorizace uživatelů, monitorování atd.).
- Testování rolí. Molecule + TestInfra.
- Vlastní vývoj: CMDB + Orchestrátor.
- Doba vytvoření serveru ~30 minut, automatizováno a prakticky nezávislé na pořadí úloh.
- Stejný stav/pojmenování infrastruktury ve všech segmentech – playbooky, repozitáře, prvky virtualizace.
- Denní kontrola stavu serverů s generováním zpráv o odchylkách od etalonu.
Doufám, že můj příběh bude užitečný těm, kdo jsou na začátku cesty. Jaký automatizační stack používáte vy?
Zdroj: habr.com
