

V článku popíšu, jak jsme přistoupili k otázce odolnosti PostgreSQL, proč se to stalo důležité a co jsme nakonec dosáhli.
Máme vysoce zatěžovaný servis: 2,5 milionu uživatelů po celém světě, přes 50 000 aktivních uživatelů každý den. Servery se nachází na Amazone v jednom regionu Irska: v provozu je nepřetržitě 100 a více různých serverů, z nichž téměř 50 je s databázemi.
Celý backend je velká monolitická stateful aplikace napsaná v Javě, která udržuje trvalé websocketové spojení s klientem. Při současné práci několika uživatelů na jednom panelu všichni vidí změny v reálném čase, protože každou změnu zapisujeme do databáze. Máme asi 10 000 dotazů za sekundu na naše databáze. V době nejvyšší zátěže v Redis zapisujeme 80-100 tisíc dotazů za sekundu.
Proč jsme přešli z Redis na PostgreSQL
Zpočátku náš servis pracoval s Redis, key-value úložištěm, které uchovává všechna data v operační paměti. serveru.
Výhody Redis:
- Vysoká rychlost odezvy, protože všechno je uloženo v paměti;
- Pohodlné zálohování a replikace.
Nevýhody Redis pro nás:
- Chybí skutečné transakce. Pokoušeli jsme se je simulovat na úrovni naší aplikace. Bohužel to ne vždy fungovalo dobře a vyžadovalo to psaní velmi složitého kódu.
- Objem dat je omezen množstvím paměti. Při zvyšování objemu dat paměť roste a nakonec se dostaneme na charakteristiky vybraného instance, což v AWS vyžaduje zastavení našeho servisu pro změnu typu instance.
- Je nutné neustále udržovat nízkou latenci, protože máme velmi vysoký počet dotazů. Optimální úroveň zpoždění pro nás je 17-20 ms. Při úrovni 30-40 ms dostáváme dlouhé odpovědi na dotazy naší aplikace a degradaci servisu. Bohužel se to stalo v září 2018, kdy jeden z instance s Redis nějakým důvodem získal latenci dvakrát větší než obvykle. Pro řešení problému jsme zastavili servis uprostřed pracovního dne kvůli neplánované údržbě a vyměnili problémový instance Redis.
- Snadno se může vyskytnout nekonzistentnost dat i při drobných chybách v kódu a poté strávíme hodně času psaním kódu pro opravu těchto dat.
Zohlednili jsme nedostatky a uvědomili si, že potřebujeme přejít na něco pohodlnějšího, s normálními transakcemi a menší závislostí na latenci. Provedli jsme výzkum, analyzovali jsme mnoho možností a vybrali PostgreSQL.
Na novou databázi přecházíme již 1,5 roku a přenesli jsme pouze malou část dat, proto nyní pracujeme současně s Redis a PostgreSQL. Podrobnosti o fázích přechodu a přepínání dat mezi databázemi jsou uvedeny v článku mého kolegy..
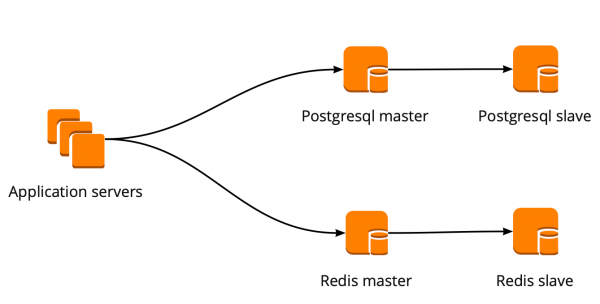
Když jsme začínali s přechodem, naše aplikace komunikovala přímo s databází a spojovala se s masterem Redis a PostgreSQL. Klaster PostgreSQL se skládal z masteru a repliky s asynchronní replikací. Takto vypadala schéma práce s databázemi:
Nasazení PgBouncer.
Během našeho přechodu se také produkt vyvíjel: zvyšoval se počet uživatelů a počet serverů, které pracovaly s PostgreSQL, a nám začalo chybět spojení. PostgreSQL na každé připojení vytváří samostatný proces a spotřebovává zdroje. Zvyšovat počet spojení lze do určité míry, jinak hrozí, že databáze bude fungovat suboptimálně. Ideálním řešením v takové situaci by bylo zvolit manažera připojení, který se postaví před databázi.
Měli jsme dvě možnosti pro manažera připojení: Pgpool a PgBouncer. Ale první nepodporuje transakční režim práce s databází, proto jsme zvolili PgBouncer.
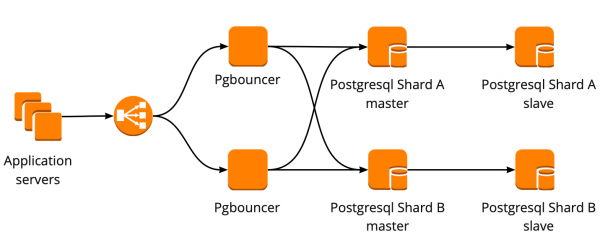
Nastavili jsme následující schéma práce: naše aplikace se připojuje k jednomu PgBounceru, za kterým se nacházejí masters PostgreSQL, a za každým masterem je jedna replikace s asynchronní replikací.
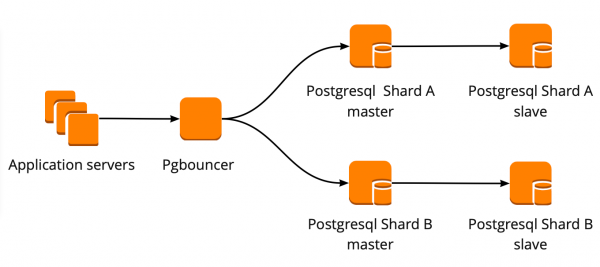
Přitom jsme nemohli uchovávat celý objem dat v PostgreSQL a pro nás byla důležitá rychlost práce s databází, proto jsme začali shardovat PostgreSQL na aplikační úrovni. Výše popsané schéma je pro to relativně pohodlné: při přidání nového shardu stačí aktualizovat konfiguraci PgBounceru a aplikace může okamžitě pracovat s novým shardem.
Odolnost PgBounceru.
Tento systém fungoval, dokud jediný instance PgBouncer nezkolaboval. Nacházíme se v AWS, kde všechny instance běží na hardwaru, který občas vypovídá službu. V takových případech se instance jednoduše přesune na nový hardware a znovu začne fungovat. Stejně to bylo i s PgBouncer, avšak stal se nedostupným. Výsledkem tohoto pádu byla nedostupnost naší služby po dobu 25 minut. AWS pro takové situace doporučuje používat redundanci na straně uživatele, což jsme v tu dobu neměli implementováno.
Po tom jsme se vážně zamysleli nad odolností PgBouncer a klastrů PostgreSQL, protože podobná situace se mohla opakovat s jakoukoli instancí v našem AWS účtu.
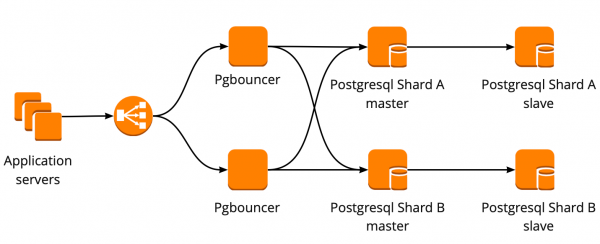
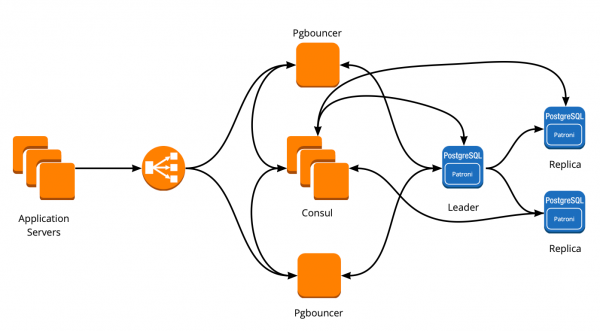
Schéma odolnosti PgBouncer jsme navrhli následovně: všechny aplikační servery se obracejí na Network Load Balancer, za kterým stojí dva PgBouncer. Každý PgBouncer se dívá na stejné master PostgreSQL každého shardu. V případě opakování situace s pádem instance AWS je veškerý provoz přesměrován přes jiný PgBouncer. Odolnost Network Load Balancer zabezpečuje AWS.
Takové schéma umožňuje bez problémů přidávat nové servery PgBouncer.
Vytvoření odolného klastru PostgreSQL
Při řešení tohoto úkolu jsme zvažovali různé varianty: vlastní failover, repmgr, AWS RDS, Patroni.
Vlastní skripty
Mohou monitorovat činnost mastera a v případě jeho selhání povýšit repliku na mastera a aktualizovat konfiguraci PgBouncer.
Výhody tohoto přístupu spočívají v maximální jednoduchosti, protože skripty píšete sami a přesně víte, jak fungují.
Nevýhody:
- Master mohl nezkolabovat, místo toho mohlo dojít k výpadku sítě. Failover, nevěda o tom, povyšuje repliku na mastera, zatímco starý master stále pracuje. V důsledku toho máme dva servery v roli master a nebudeme vědět, na kterém z nich jsou poslední aktuální data. Taková situace se nazývá také split-brain.
- Zůstali jsme bez repliky. V naší konfiguraci je master a jedna replika, po přepnutí je replika povyšována na mastera a nemáme více replik, což znamená, že musíme ručně přidat novou repliku.
- Potřebujeme další monitorování práce failoveru, přičemž máme 12 shardů PostgreSQL, což znamená, že musíme monitorovat 12 klastrů. Při zvyšování počtu shardů nesmíme zapomenout aktualizovat failover.
Napsaný failover vypadá velmi složitě a vyžaduje netriviální podporu. S jedním PostgreSQL кластерem to bude nejjednodušší varianta, ale není škálovatelný, takže pro nás se nehodí.
Repmgr
Replication Manager pro PostgreSQL клаustry, který umí spravovat práci PostgreSQL кластера. Přitom v něm není automatický failover "z krabice", takže pro správnou funkci je potřeba napsat vlastní "obal" nad hotovým řešením. Takže vše může být dokonce složitější než s napsanými skripty, proto jsme Repmgr ani nezkoušeli.
AWS RDS
Podporuje vše potřebné pro nás, umí dělat zálohy a podporuje pool připojení. Má automatické přepínání: při smrti masteru se replikace stane novým masterem a AWS změní DNS záznam na nového mastera, přičemž repliky mohou být v různých AZ.
Mezi nevýhody lze počítat absenci jemného nastavení. Jako příklad jemného nastavení: na našich instancích jsou nastaveny omezení pro TCP připojení, což bohužel nelze udělat v RDS:
net.ipv4.tcp_keepalive_time=10
net.ipv4.tcp_keepalive_intvl=1
net.ipv4.tcp_keepalive_probes=5
net.ipv4.tcp_retries2=3
Kromě toho je cena AWS RDS téměř dvakrát vyšší než běžná cena instance, což se stalo hlavním důvodem odmítnutí tohoto řešení.
Patroni
To je šablona na python pro řízení PostgreSQL s dobrou dokumentací, automatickým failoverem a zdrojovým kódem na githubu.
Výhody Patroni:
- Každý konfigurační parametr je podrobně popsán, jasně je uvedeno, jak co funguje;
- Automatický failover funguje z krabice;
- Napsán v pythonu, a protože my sami hodně píšeme v pythonu, bude pro nás snazší řešit problémy a možná dokonce pomoci s rozvojem projektu;
- Úplně spravuje PostgreSQL, umožňuje měnit konfiguraci okamžitě na všech uzlech кла스터u, a pokud pro použití nové konfigurace je potřeba restartovat кластер, lze to opět udělat pomocí Patroni.
Nevýhody:
- Z dokumentace není jasné, jak správně pracovat s PgBouncer. Ačkoli to není snadné nazvat nevýhodou, protože úkolem Patroni je spravovat PostgreSQL, a jak budou probíhat připojení k Patroni — to už je náš problém;
- Malo příkladů zavedení Patroni na velkých objemech, zatímco existuje mnoho příkladů zavedení od nuly.
Nakonec jsme pro vytvoření odolného кластру zvolili právě Patroni.
Proces zavedení Patroni
Před zavedením Patroni jsme měli 12 shardů PostgreSQL v konfiguraci jeden master a jedna replikace s asynchronní replikací. Aplikační servery komunikovaly s databázemi přes Network Load Balancer, za kterým byly dva instance s PgBouncer, a za nimi se nacházely všechny servery PostgreSQL.
Pro zavedení Patroni jsme museli vybrat distribuované úložiště konfigurace clustera. Patroni pracuje s distribuovanými systémy úložiště konfigurací, jako jsou etcd, Zookeeper, Consul. Na našem produkčním prostředí máme plně funkční cluster Consul, který pracuje ve spojení s Vault a jinak ho nepoužíváme. Skvělá příležitost začít používat Consul podle jeho účelu.
Jak funguje Patroni s Consul
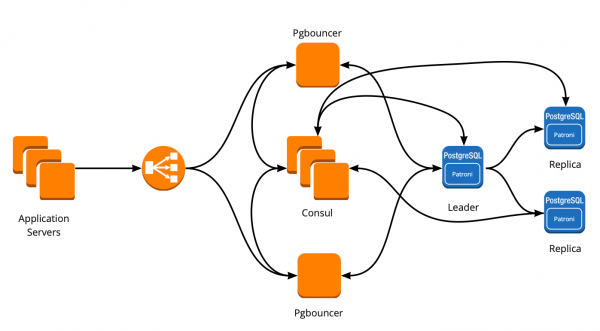
Máme cluster Consul, který se skládá ze tří uzlů a cluster Patroni, který se skládá z lídra a repliky (v Patroni je master nazýván lídrem clustera a slaves — replikami). Každý instance clustera Patroni neustále posílá do Consul informace o stavu clustera. Proto ze Consul vždy můžete zjistit aktuální konfiguraci clustera Patroni a kdo je právě lídrem.
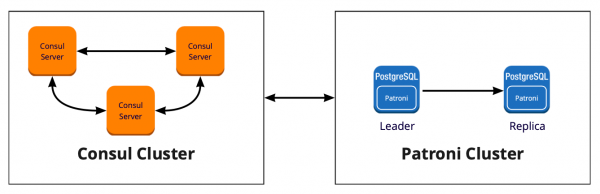
Pro připojení Patroni k Consul stačí prostudovat oficiální dokumentaci, kde je uvedeno, že je třeba uvést hostitele ve tvaru http nebo https v závislosti na tom, jak pracujeme s Consul, a schéma připojení, volitelně:
host: host:port pro endpoint Consul, ve formátu: http(s)://host:port
scheme: (volitelné) http nebo https, výchozí je http
Vypadá to jednoduše, ale zde začínají úskalí. S Consul pracujeme přes zabezpečené spojení přes https a naše konfigurační nastavení bude vypadat následovně:
consul:
  host: https://server.production.consul:8080
  verify: true
  cacert: {{ consul_cacert }}
  cert: {{ consul_cert }}
  key: {{ consul_key }}
Ale takto to nefunguje. Při spuštění Patroni se nemůže připojit k Consul, protože se pokouší i tak jít přes http.
Pomohl vyřešit problém zdrojový kód Patroni. Naštěstí je napsán v pythonu. Ukazuje se, že parametr host se nijak nezpracovává, a protokol je třeba uvést ve schématu. Takhle vypadá funkční blok konfigurace pro práci s Consul u nás:
consul:
  host: server.production.consul:8080
  scheme: https
  verify: true
  cacert: {{ consul_cacert }}
  cert: {{ consul_cert }}
  key: {{ consul_key }}
Consul-template
Takže jsme vybrali úložiště pro konfiguraci. Nyní musíme pochopit, jak PgBouncer přepne svou konfiguraci při změně lídra v clusteru Patroni. V dokumentaci na tuto otázku odpověď není, protože tam není obecně popsána práce s PgBouncer.
Hledáním řešení jsme našli článek (název bohužel nevím), kde bylo uvedeno, že Consul-template velmi pomohl ve spojení PgBouncer a Patroni. To nás povzbudilo k prozkoumání práce Consul-template.
Ukázalo se, že Consul-template neustále monitoruje konfiguraci clusteru PostgreSQL v Consulu. Při změně lídra aktualizuje konfiguraci PgBouncer a posílá příkaz k jejímu restartování.
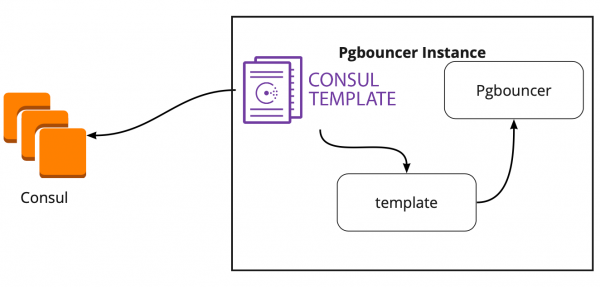
Velkou výhodou template je, že je uchováván ve formě kódu, takže při přidávání nového shardu stačí udělat nový commit a automaticky aktualizovat template, čímž se zachovává princip Infrastructure as code.
Nová architektura s Patroni
Výsledkem jsme získali takovou schéma práce:
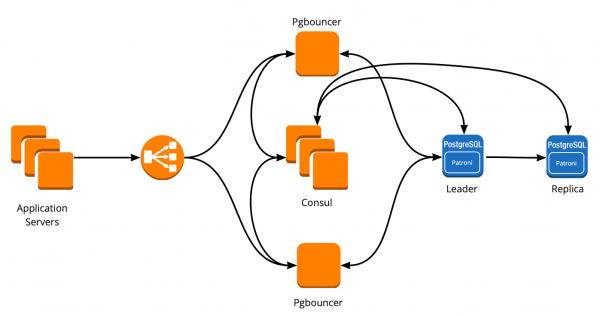
Všechny servery aplikace se obracejí na vyrovnávač zátěže → za ním stojí dva instance PgBouncer → na každém instance běží Consul-template, který monitoruje stav každého clusteru Patroni a sleduje aktuálnost konfigurace PgBouncer, který směřuje dotazy na aktuálního lídra každého clusteru.
Manuální testování
Tuto schéma jsme před uvedením do produkce spustili na malé testovací prostředí a ověřili fungování automatického přepínání. Otevřeli jsme nástěnku, posunuli nálepku a v tu chvíli jsme "zabili" lídra clusteru. V AWS je k tomu dostatečné vypnout instance přes konzoli.
Nálepka se během 10-20 sekund vrátila zpět, a pak opět začala normálně fungovat. Znamená to, že cluster Patroni fungoval správně: změnil lídra, poslal informace do Consulu, a Consul-template okamžitě převzal tyto informace, nahradil konfiguraci PgBouncer a poslal příkaz k reload.
Jak přežít pod vysokým zatížením a zachovat minimální prostoje?
Všechno funguje skvěle! Ale objevují se nové otázky: Jak to bude fungovat pod vysokým zatížením? Jak rychle a bezpečně nasadit vše na produkci?
Na prvou otázku nám pomáhá testovací prostředí, na kterém provádíme zátěžové testování. Je plně identické s produkčním z hlediska architektury a má generovaná testovací data, která objemově přibližně odpovídají produkci. Jednoduše se rozhodneme "zabít" jednoho z masterů PostgreSQL během testu a podívat se, co se stane. Ale před tím je důležité zkontrolovat automatickou instalaci, protože v tomto prostředí máme několik shardů PostgreSQL, takže získáme skvělé testování konfiguračních skriptů před produkcí.
Oba úkoly vypadají ambiciózně, ale máme PostgreSQL 9.6. Možná se rovnou aktualizujeme na 11.2?
Rozhodli jsme se to udělat ve dvou krocích: nejprve aktualizovat verzi na 11.2, pak spustit Patroni.
Aktualizace PostgreSQL
Pro rychlou aktualizaci verze PostgreSQL je nutné použít možnost -k, která vytváří hard linky na disku a není nutné kopírovat vaše data. Na databázích o velikosti 300-400 GB aktualizace trvá 1 sekundu.
Máme mnoho shardů, takže aktualizace musí proběhnout automaticky. K tomu jsme napsali Ansible playbook, který provádí celý proces aktualizace za nás:
/usr/lib/postgresql/11/bin/pg_upgrade
<b>--odkaz </b>
--stará-datadir='' --nová-datadir=''
 --stará-bindir=''  --nová-bindir=''
 --stará-options=' -c config_file='
 --nové-options=' -c config_file='
Je důležité poznamenat, že před spuštěním upgradu je nutné jej provést s parametrem —check, abychom si byli jistí možností upgradu. Také náš skript dělá výměnu konfigurací na dobu upgradu. Skript se nám provedl za 30 sekund, což je vynikající výsledek.
Spuštění Patroni
Pro vyřešení druhého problému stačí pohlédnout na konfiguraci Patroni. V oficiálním repozitáři je příklad konfigurace s initdb, která odpovídá za inicializaci nové databáze při prvním spuštění Patroni. Ale protože máme již hotovou databázi, jednoduše jsme tuto část z konfigurace odstranili.
Když jsme začali instalovat Patroni na již hotový cluster PostgreSQL a spouštět ho, narazili jsme na nový problém: oba servery se spouštěly jako leader. Patroni nic neví o předchozím stavu clusteru a pokouší se spustit oba servery jako dva samostatné clustery se stejným názvem. Pro vyřešení tohoto problému je nutné smazat adresář s daty na slave:
rm -rf /var/lib/postgresql/To je nutné udělat pouze na slave!
Při připojení čisté repliky Patroni dělá basebackup leadera a obnovuje ho na repliku, a pak dohání aktuální stav podle wal-logů.
Další problém, se kterým jsme se potýkali, je, že všechny PostgreSQL clustery jsou ve výchozím nastavení pojmenovány main. Když každý cluster neví nic o ostatních, je to v pořádku. Ale když chcete používat Patroni, musí mít všechny clustery unikátní jméno. Řešením je změnit název clusteru v konfiguraci PostgreSQL.
Zátěžový test
Spustili jsme test, který simuluje práci uživatelů na fórech. Když zatížení dosáhlo našeho průměrného denního výkonu, zopakovali jsme přesně stejný test, vypnuli jsme jeden instance s leaderem PostgreSQL. Automatický failover fungoval tak, jak jsme očekávali: Patroni změnil lídra, Consul-template aktualizoval konfiguraci PgBouncer a poslal příkaz k reloadu. Na našich grafech v Grafaně bylo vidět, že došlo k prodlevám 20-30 sekund a k malému objemu chyb ze serverů spojených s připojením k databázi. To je normální situace, takové hodnoty jsou přípustné pro náš failover a určitě lepší než downtime služby.
Nasazení Patroni na produkci
Nakonec jsme dostali následující plán:
- Nasazení Consul-template na servery PgBouncer a spuštění;
- Aktualizace PostgreSQL na verzi 11.2;
- Změna názvu clusteru;
- Spuštění clusteru Patroni.
Naše schéma nám však umožňuje provést první bod prakticky kdykoli, můžeme postupně odstranit každý PgBouncer z provozu a spustit na něm nasazení a spuštění consul-template. Tak jsme také udělali.
Pro rychlé nasazení jsme použili Ansible, protože jsme všechny playbooky již otestovali v testovacím prostředí a doba provedení celého scénáře byla od 1,5 do 2 minut pro každou shardu. Měli jsme možnost vše nasadit postupně na každý shard bez zastavení naší služby, ale museli bychom na několik minut vypnout každý PostgreSQL. V tomto případě by uživatelé, jejichž data se nacházejí na tomto shardu, nemohli v tu dobu plně pracovat, což je pro nás nepřijatelné.
Řešením této situace byla plánovaná údržba, která probíhá každé 3 měsíce. Toto je okno pro plánované práce, kdy zcela vypneme naši službu a aktualizujeme instance databází. Do dalšího okna zbýval jeden týden, a tak jsme se rozhodli jednoduše počkat a další se připravit. Během doby čekání jsme udělali několik pojistných kroků: pro každé sharding PostgreSQL jsme zvedli záložní repliky pro případ neúspěchu, abychom uchovali nejnovější data, a přidali novou instanci pro každé sharding, která by měla stát novou replikou v clusteru Patroni, abychom neměli provádět příkaz pro odstranění dat. To vše pomohlo maximálně snížit riziko chyby.
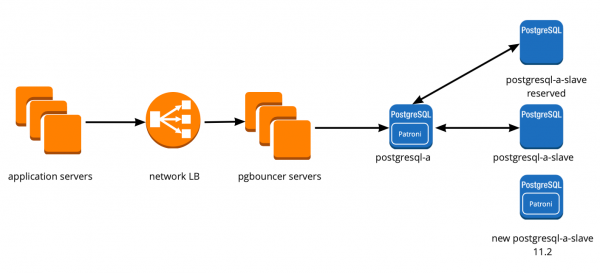
Restartovali jsme naši službu, všechno fungovalo jak mělo, uživatelé pokračovali v práci, ale na grafech jsme zaznamenali abnormálně vysokou zátěž na serverech Consul.
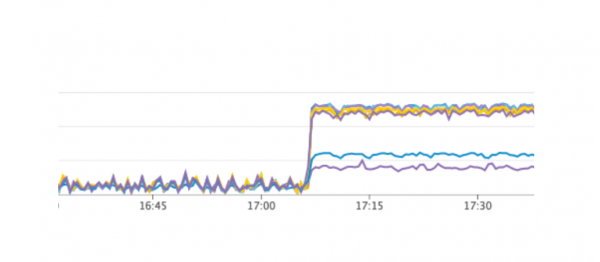
Proč jsme to neviděli v testovacím prostředí? Tento problém velmi dobře ilustruje, že je třeba se řídit principem Infrastructure as code a vylepšit celou infrastrukturu, počínaje testovacími prostředími a konče produkcí. Jinak je velmi snadné dostat se k takovému problému, jaký jsme měli my. Co se stalo? Consul nejprve vznikl na produkci a poté na testovacích prostředích, takže na testovacích prostředích byla verze Consul vyšší než na produkci. Přesně v jednom z releaseů byla vyřešena únik CPU při práci s consul-template. Takže jsme jednoduše aktualizovali Consul a tímto způsobem vyřešili problém.
Restartovat cluster Patroni
Nicméně jsme dostali nový problém, o kterém jsme ani nepředpokládali. Při aktualizaci Consulu jednoduše odstraníme uzel Consul z clustru pomocí příkazu consul leave → Patroni se připojí k jinému serveru Consul → vše funguje. Ale když jsme se dostali k poslední instanci clustru Consul a poslali mu příkaz consul leave, všechny clustry Patroni se prostě restartovaly, a v logu jsme viděli následující chybu:
CHYBA: get_cluster
Sledování (poslední volání naposledy):
...
RetryFailedError: 'Překročena doba pokusu'
CHYBA: Chyba při komunikaci s DCS
<b>LOG: systém databází byl vypnut</b>
Cluster Patroni nebyl schopen získat informace o svém clusteru a restartoval se.
Pro hledání řešení jsme se obrátili na autory Patroni prostřednictvím issue na githubu. Navrhli vylepšení našich konfiguračních souborů:
consul:
 consul.checks: []
bootstrap:
 dcs:
   retry_timeout: 8
Podařilo se nám problém opakovat v testovacím prostředí a otestovali jsme tam tyto parametry, ale bohužel nefungovaly.
Problém stále zůstává nevyřešený. Plánujeme vyzkoušet následující možnosti řešení:
- Použít agent Consul na každém instance clusteru Patroni;
- Opravit problém v kódu.
Chápeme místo vzniku chyby: pravděpodobně je problém v použití výchozího časového limitu, který není předefinován v konfiguračním souboru. Při odstranění posledního serveru Consul z clusteru dojde k zamrznutí celého clusteru Consul, které trvá déle než sekundu, kvůli čemuž Patroni nemůže získat stav clusteru a kompletně restartuje celý cluster.
Naštěstí jsme se nesetkali s žádnými dalšími chybami.
Shrnutí použití Patroni
Po úspěšném spuštění Patroni jsme přidali po jedné další replikaci do každého clusteru. Nyní má každý cluster podobu kvóra: jeden vůdce a dvě repliky, - pro zajištění v případě split-brain při přepínání.
Na produkci Patroni funguje více než tři měsíce. Během této doby nás už několikrát zachránil. Nedávno v AWS selhal vůdce jednoho z clusterů, automatický failover se spustil a uživatelé pokračovali v práci. Patroni splnil svůj hlavní úkol.
Krátké shrnutí použití Patroni:
- Pohodlí při změně konfigurace. Stačí změnit konfiguraci na jednom instance a ta se automaticky použije na celý cluster. Pokud je třeba restartovat, aby se nová konfigurace projevila, Patroni o tom informuje. Patroni může restartovat celý cluster jediným příkazem, což je také velmi pohodlné.
- Automatický failover funguje a už nás několikrát zachránil.
- Aktualizace PostgreSQL bez výpadku aplikace. Nejprve je nutné aktualizovat repliky na novou verzi, poté změnit vůdce v clusteru Patroni a aktualizovat starého vůdce. Při tom se provádí nezbytné testování automatického failoveru.
Zdroj: habr.com
