

Moje hlavní práce spočívá převážně v nasazení softwarových systémů, tedy trávím spoustu času snažíc se odpovědět na otázky jako jsou tyto:
- U vývojáře tento software funguje, ale u mě ne. Proč?
- Včera tento software fungoval, ale dnes ne. Proč?
To je takový druh ladění, které se mírně liší od běžného ladění softwaru. Běžné ladění se týká logiky kódu, zatímco ladění nasazení se zaměřuje na interakci kódu a prostředí. I když je jádro problému logická chyba, fakt, že na jednom stroji vše funguje, zatímco na jiném ne, naznačuje, že nějakým způsobem jde o prostředí.
Proto místo běžných ladicích nástrojů jako gdb mám jinou sadu nástrojů pro ladění nasazení. A můj oblíbený nástroj pro řešení problému typu „Proč mi tento software nefunguje?“ se nazývá strace.
Co je to strace?
— to je nástroj pro „trasování systémových volání“. Původně byl vytvořen pro Linux, ale stejné ladicí triky lze provádět i s nástroji pro jiné systémy ( nebo ).
Hlavní použití je velmi jednoduché. Stačí spustit strace s jakýmkoliv příkazem a on zašle do dumpu všechna systémová volání (pravda, nejprve asi bude potřeba nainstalovat samotný strace):
$ strace echo Ahoj
...Oříznuto spoustou dalších informací...
write(1, "Ahoj", 5)                  = 5
close(1)                                = 0
close(2)                                = 0
exit_group(0)                           = ?
+++ ukončeno s 0 +++
Jaká jsou to systémová volání? Je to něco jako API pro jádro operačního systému. Dávno tomu měl software přímý přístup k „hardwaru“, na kterém běžel. Například, pokud bylo potřeba něco zobrazit na obrazovce, manipuloval s porty nebo registrováním pro video zařízení v paměti. Když se staly populární víceúlohové počítačové systémy, nastal chaos, protože různé aplikace se praly o „hardware“. Chyby v jedné aplikaci mohly zhroucit práci dalších, pokud ne celého systému. Tehdy se v CPU objevily privilegované režimy (nebo „ochrana ve dvojicích“). Nejprivilegovanějším se stalo jádro: mělo plný přístup k „hardwaru“, vytvářející méně privilegované aplikace, které už musely požadovat přístup od jádra pro interakci s „hardwarem“ — prostřednictvím systémových volání.
Na binární úrovni se systémový call mírně liší od prostého volání funkce, většina programů však používá obal ve standardní knihovně. Tedy standardní knihovna POSIX C obsahuje volání funkce write(), která obsahuje veškerý kód závislý na architektuře pro systémový call write.
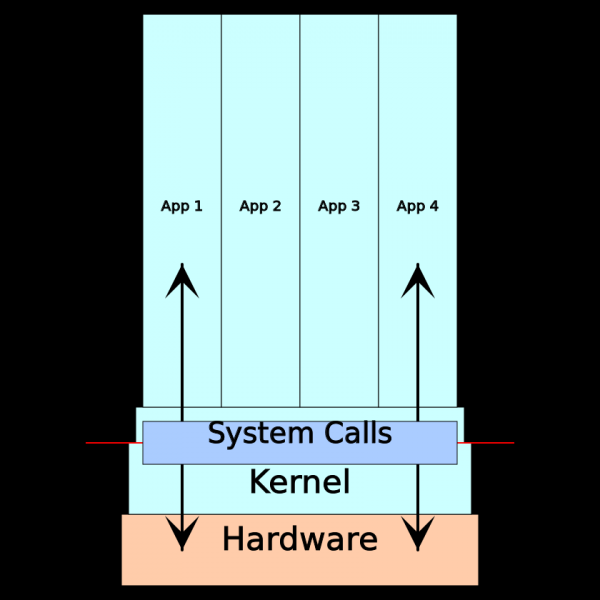
Pokud to shrneme, tak veškerá interakce aplikace s jejím prostředím (počítačovými systémy) se provádí prostřednictvím systémových volání. Proto, když software na jednom stroji funguje a na druhém nikoli, je dobré nahlédnout do výsledků sledování systémových volání. A pokud budeme konkrétnější, zde je seznam typických věcí, které lze analyzovat pomocí sledování systémového volání:
- Konzolový vstup-výstup
- Síťový vstup-výstup
- Přístup k souborovému systému a souborový vstup-výstup
- Správa životnosti procesu/vlákna
- Nízkourovňové řízení paměti
- Přístup k ovladačům specializovaných zařízení
Kdy použít strace?
Teoreticky strace se používá s jakýmikoli programy v uživatelském prostoru, protože jakýkoli program v uživatelském prostoru musí vykonávat systémové volání. Efektivněji funguje s kompilovanými, nízkourovňovými programy, ale také funguje s vysoce úrovňovými jazyky jako Python, pokud se podaří projít dalším šumem z prostředí a interpretru.
V celé své parádě strace se projevuje při ladění softwaru, který dobře funguje na jednom stroji, ale na jiném najednou přestává fungovat a vyhazuje nejasné zprávy o souborech, právech nebo neúspěšných pokusech vykonat nějaké příkazy a podobně... Je škoda, že se s vysoce úrovňovými problémy jako chyba ověření certifikátu špatně kombinuje. Obvykle zde vyžaduje kombinaci strace, někdy a nástrojů vyšší úrovně (jako je nástroj příkazového řádku openssl pro ladění certifikátu).
Například vezmeme práci na izolovaném serveru, ale sledování systémových volání lze často provést i na složitějších platformách nasazení. Stačí vybrat vhodný nástroj.
Příklad jednoduchého ladění
Řekněme, že chcete spustit úžasnou serverovou aplikaci foo, a dostáváte toto:
$ foo
Chyba při otevírání konfiguračního souboru: Soubor nebo adresář neexistuje
Je zřejmé, že se mu nepodařilo najít konfigurační soubor, který jste napsali. K tomu dochází, protože někdy, když správci balíčků kompilují aplikaci, přepíší očekávané umístění souborů. A pokud následujete instalační příručku pro jedno distro, naleznete v jiném soubory úplně jinde, než byste očekávali. Tento problém by se dal vyřešit za pár sekund, kdyby chybová zpráva uvedla, kde by se měl konfigurační soubor hledat, ale nic takového se nestalo. Kde tedy hledat?
Pokud máte přístup k zdrojovému kódu, můžete ho přečíst a vše zjistit. Dobrá záložní varianta, ale ne nejrychlejší řešení. Můžete použít krokový ladicí nástroj jako gdb a podívat se, co program dělá, ale mnohem efektivnější je použít nástroj, který je speciálně navržen pro zobrazení interakce s prostředím: strace.
Výstup strace se může zdát nadbytečný, ale dobrá zpráva je, že většinu z jeho části lze s klidem ignorovat. Často je užitečné použít přepínač -o, aby se výsledky sledování uložily do samostatného souboru:
$ strace -o /tmp/trace foo
Chyba při otevírání konfiguračního souboru: Soubor nebo adresář neexistuje
$ cat /tmp/trace
execve("foo", ["foo"], 0x7ffce98dc010 /* 16 proměnných */) = 0
brk(NULL)                               = 0x56363b3fb000
access("/etc/ld.so.preload", R_OK)      = -1 ENOENT (Soubor nebo adresář neexistuje)
openat(AT_FDCWD, "/etc/ld.so.cache", O_RDONLY|O_CLOEXEC) = 3
fstat(3, {st_mode=S_IFREG|0644, st_size=25186, ...}) = 0
mmap(NULL, 25186, PROT_READ, MAP_PRIVATE, 3, 0) = 0x7f2f12cf1000
close(3)                                = 0
openat(AT_FDCWD, "/lib/x86_64-linux-gnu/libc.so.6", O_RDONLY|O_CLOEXEC) = 3
read(3, "177ELF2113 3 > 1 260A2 "..., 832) = 832
fstat(3, {st_mode=S_IFREG|0755, st_size=1824496, ...}) = 0
mmap(NULL, 8192, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_ANONYMOUS, -1, 0) = 0x7f2f12cef000
mmap(NULL, 1837056, PROT_READ, MAP_PRIVATE|MAP_DENYWRITE, 3, 0) = 0x7f2f12b2e000
mprotect(0x7f2f12b50000, 1658880, PROT_NONE) = 0
mmap(0x7f2f12b50000, 1343488, PROT_READ|PROT_EXEC, MAP_PRIVATE|MAP_FIXED|MAP_DENYWRITE, 3, 0x22000) = 0x7f2f12b50000
mmap(0x7f2f12c98000, 311296, PROT_READ, MAP_PRIVATE|MAP_FIXED|MAP_DENYWRITE, 3, 0x16a000) = 0x7f2f12c98000
mmap(0x7f2f12ce5000, 24576, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_FIXED|MAP_DENYWRITE, 3, 0x1b6000) = 0x7f2f12ce5000
mmap(0x7f2f12ceb000, 14336, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_FIXED|MAP_ANONYMOUS, -1, 0) = 0x7f2f12ceb000
close(3)                                = 0
arch_prctl(ARCH_SET_FS, 0x7f2f12cf0500) = 0
mprotect(0x7f2f12ce5000, 16384, PROT_READ) = 0
mprotect(0x56363b08b000, 4096, PROT_READ) = 0
mprotect(0x7f2f12d1f000, 4096, PROT_READ) = 0
munmap(0x7f2f12cf1000, 25186)           = 0
openat(AT_FDCWD, "/etc/foo/config.json", O_RDONLY) = -1 ENOENT (Soubor nebo adresář neexistuje)
dup(2)                                  = 3
fcntl(3, F_GETFL)                       = 0x2 (flags O_RDWR)
brk(NULL)                               = 0x56363b3fb000
brk(0x56363b41c000)                     = 0x56363b41c000
fstat(3, {st_mode=S_IFCHR|0620, st_rdev=makedev(0x88, 0x8), ...}) = 0
write(3, "Chyba při otevírání konfiguračního souboru"..., 60) = 60
close(3)                                = 0
exit_group(1)                           = ?
+++ opuštěno s 1 +++
Téměř celá první stránka výstupu strace — to je obvykle nízkoúrovňová příprava na spuštění. (Spousta volání mmap, mprotect, brk pro věci jako detekce nízkoúrovňové paměti a mapování dynamických knihoven.) Obecně platí, že výstupy strace je lepší číst od konce. Na konci bude volání write, které vypíše chybové hlášení. Podívejme se výše a vidíme první chybné systémové volání — volání openat, které vyhazuje chybu ENOENT („soubor nebo adresář nebyly nalezeny“), pokoušející se otevřít /etc/foo/config.json. Tady by měl být konfigurační soubor.
To byl jenom příklad, ale řekl bych, že 90 % času, když používám strace, nic komplikovanějšího než tohle dělat nemusím. Následuje kompletní krok za krokem průvodce laděním:
- Rozrušit se kvůli nejasnému chybovému hlášení od programu
- Znovu spustit program s strace
- Najít v trasovacích výstupech chybové hlášení
- Jít výš, dokud nenarazíte na první neúspěšné systémové volání
Je velmi pravděpodobné, že systémové volání ve 4. kroku ukáže, co se pokazilo.
Nápovědy
Než ukážu složitější ladění, prozradím vám několik triků pro efektivní použití strace:
man — váš přítel
Na mnoha *nix systémech lze získat úplný seznam systémových volání jádra spuštěním man syscalls. Uvidíte věci jako brk(2), a proto lze získat více informací spuštěním man 2 brk.
Malé záludnosti: man 2 fork mi ukazuje stránku pro shell fork() v GNU libc, který se, jak se zdá, realizuje pomocí volání clone(). Semantika volání fork zůstává stejná, pokud napíšu program využívající fork(), a spustím sledování — nenajdu volání fork, místo toho se objeví clone(). Takové záludnosti jen matou, pokud začnete porovnávat zdrojový kód s výstupem strace.
Použijte -o pro uložení výstupu do souboru
strace může generovat rozsáhlý výstup, proto je často užitečné uchovávat výsledky sledování v samostatných souborech (jak je uvedeno v předchozím příkladu). Navíc to pomáhá nezaměňovat výstup programu s výstupem strace v konzoli.
Použijte -s pro zobrazení více dat argumentu
Určitě jste si všimli, že druhá polovina zprávy o chybě nebyla v předchozím příkladu sledování zobrazena. Je to proto, že strace výchozí nastavení zobrazuje jen prvních 32 bytů argumentového řetězce. Pokud chcete vidět víc, přidejte něco jako -s 128 k volání strace.
-u usnadňuje sledování souborů, socketů a podobně.
Všechno je soubor znamená, že *nix systémy provádějí celý vstupne-výstup pomocí souborových deskriptorů, ať už se to vztahuje na soubor nebo síť, nebo meziprocesové kanály. To je výhodné pro programování, ale ztěžuje sledování toho, co se vlastně děje, když vidíte obecné read a write v výsledcích sledování systémového volání.
Přidáním přepínače -u, donutilé byste strace anotovat každý souborový deskriptor ve výstupu s poznámkou, na co ukazuje.
Připojte se k již běžícímu procesu s -p**
Jak bude vidět z níže uvedeného příkladu, občas je třeba sledovat program, který již běží. Pokud víte, že je spuštěn jako proces 1337 (řekněme, z výstupů ps), můžete jej sledovat takto:
$ strace -p 1337
...výstup sledování systémového volání...
Možná budete potřebovat práva root.
Použijte -f pro sledování podřízených procesů
strace Ve výchozím nastavení se sleduje pouze jeden proces. Pokud tento proces vytváří podřízené procesy, můžete vidět systémové volání pro vytvoření podřízeného procesu, ale systémová volání podřízeného procesu se nezobrazí.
Pokud si myslíte, že chyba je v podřízeném procesu, použijte operátor -f, ten aktivuje jeho sledování. Nevýhodou je, že výstup vás ještě více zmátne. Když strace sleduje jeden proces nebo jednu větev, ukazuje jednotný tok událostí volání. Když sleduje více procesů najednou, možná uvidíte začátek volání přerušený zprávou <unfinished …>, poté se zobrazuje skupina volání pro jiné vykonávací větve, a až pak končí první s <… foocall resumed>. Nebo rozdělte všechny výsledky sledování do různých souborů, také pomocí operátoru -ff (podrobnosti v o strace).
Filtrujte sledování pomocí -e
Jak vidíte, výstup ze sledování je skutečná hromada všech možných systémových volání. Pomocí příznaku -e můžete sledování filtrovat (viz. o strace). Hlavní výhodou je, že spouštět sledování s filtrováním je rychlejší, než provádět úplné sledování a poté grep`át. Pokud mám být upřímný, téměř vždy mi to je jedno.
Ne všechny chyby jsou špatné
Jednoduchý a běžný příklad je program, který hledá soubor na několika místech, jako například shell, který hledá, ve kterém koši je uložen spustitelný soubor:
$ strace sh -c uname
...
stat("/home/user/bin/uname", 0x7ffceb817820) = -1 ENOENT (No such file or directory)
stat("/usr/local/bin/uname", 0x7ffceb817820) = -1 ENOENT (No such file or directory)
stat("/usr/bin/uname", {st_mode=S_IFREG|0755, st_size=39584, ...}) = 0
...
Heuristika typu „poslední neúspěšný pokus před zprávou o chybě“ je dobrá pro hledání relevantních chyb. Ať už to je jak chce, logické je začít od konce.
Porozumět systémovým voláním dobře pomáhají příručky pro programování v jazyce C.
Standardní volání knihoven C nejsou systémová volání, ale pouze tenký povrchový plášť. Takže, pokud alespoň trochu rozumíte, jak a co dělat v C, bude pro vás snazší se vyznat ve výsledcích sledování systémového volání. Například, máte-li problém s laděním volání na síťových systémech, podívejte se na klasické .
Příklad složitějšího ladění
Už jsem říkal, že příklad jednoduchého ladění je příkladem toho, s čím se většinou setkávám v práci se strace. Nicméně občas je potřeba skutečná detektivka, takže tady máte skutečný příklad složitějšího ladění.
— plánovač úloh, další implementace démonu *nix cron.. Je nainstalován na serveru, ale když se někdo pokusí upravit rozvrh, stane se následující:
# crontab -e -u logs
bcrontab: Fatal: Could not create temporary file
Dobře, tedy bcron se pokusil zapsat nějaký soubor, ale nepodařilo se mu to a nechce přiznat proč. Odpovídáme strace:
# strace -o /tmp/trace crontab -e -u logs
bcrontab: Fatal: Could not create temporary file
# cat /tmp/trace
...
openat(AT_FDCWD, "bcrontab.14779.1573691864.847933", O_RDONLY) = 3
mmap(NULL, 8192, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_ANONYMOUS, -1, 0) = 0x7f82049b4000
read(3, "#Ansible: logsaggn20 14 * * * lo"..., 8192) = 150
read(3, "", 8192)                       = 0
munmap(0x7f82049b4000, 8192)            = 0
close(3)                                = 0
socket(AF_UNIX, SOCK_STREAM, 0)         = 3
connect(3, {sa_family=AF_UNIX, sun_path="/var/run/bcron-spool"}, 110) = 0
mmap(NULL, 8192, PROT_READ|PROT_WRITE, MAP_PRIVATE|MAP_ANONYMOUS, -1, 0) = 0x7f82049b4000
write(3, "156:Slogs #Ansible: logsaggn20 1"..., 161) = 161
read(3, "32:ZCould not create temporary f"..., 8192) = 36
munmap(0x7f82049b4000, 8192)            = 0
close(3)                                = 0
write(2, "bcrontab: Fatal: Could not creat"..., 49) = 49
unlink("bcrontab.14779.1573691864.847933") = 0
exit_group(111)                         = ?
+++ exited with 111 +++
Na konci je chybová zpráva write, ale tentokrát je něco jinak. Za prvé, chybí relevantní chyba systémového volání, která obvykle před tímto následuje. Za druhé, je vidět, že někdo už někde četl chybovou zprávu. Zdá se, že skutečný problém je někde jinde, a bcrontab pouze reprodukuje zprávu.
Když se podíváte na man 2 read, můžete vidět, že prvním argumentem (3) je deskriptor souboru, který *nix používá pro všechny operace vstupu a výstupu. Jak zjistit, co deskriptor souboru 3 představuje? V tomto konkrétním případě můžete spustit strace s operátorem -u (viz výše), a on automaticky poví, ale abyste počítali podobné věci, je užitečné vědět, jak číst a analyzovat výsledky trasování.
Zdroj deskriptoru souboru může být jeden z mnoha systémových volání (vše závisí na tom, k čemu je deskriptor určen — pro konzoli, síťový soket, samotný soubor nebo něco jiného), ale ať už je to jakkoliv, hledáme volání, které vrací 3 (t.j. hledáme „= 3“ ve výsledcích trasování). V tomto výsledku jsou 2: openat na samém vrcholu a socket uprostřed. openat otevírá soubor, ale close(3) pak ukáže, že se znovu zavírá. (Past: deskriptory souborů mohou být znovu použity, když se otevírají a zavírají). Volání socket() je vhodné, protože je poslední před read(), a zdá se, že bcrontab pracuje s něčím přes soket. Další řádek ukazuje, že deskriptor souboru je spojen s unix domain socket na cestě /var/run/bcron-spool.
Takže je třeba najít proces, který je přiřazen k unix socket na druhé straně. K tomu je několik elegantních triků, a oba budou užitečné pro ladění serverových nasazení. První je použít netstat nebo novější ss (stav socketu). Obě příkazy ukazují aktivní síťová spojení systému a berou operátor -l pro popis naslouchajících socketů, stejně jako operátor -p pro zobrazení programů, které se k socketu připojují jako klienti. (Užitečných možností je mnohem více, ale pro tento úkol stačí i tyto dvě.)
# ss -pl | grep /var/run/bcron-spool
u_str LISTEN 0   128   /var/run/bcron-spool 1466637   * 0   users:(("unixserver",pid=20629,fd=3))
To znamená, že naslouchající je příkaz inixserver, pracující s ID procesu 20629. (A náhodou používá deskriptor souboru 3 jako socket.)
Druhý skutečně užitečný nástroj pro nalezení stejné informace se nazývá lsof. Ten vypisuje všechny otevřené soubory (nebo deskriptory souborů) v systému. Nebo můžete získat informace o jednom konkrétním souboru:
# lsof /var/run/bcron-spool
COMMAND   PID   USER  FD  TYPE  DEVICE              SIZE/OFF  NODE    NAME
unixserve 20629 cron  3u  unix  0x000000005ac4bd83  0t0       1466637 /var/run/bcron-spool type=STREAM
Proces 20629 je dlouho běžící server, takže se k němu lze připojit strace pomocí něčeho jako strace -o /tmp/trace -p 20629. Pokud upravíte úlohu cron v jiném terminálu, získáte výstup výsledků trasování s chybou. A tady je výsledek:
accept(3, NULL, NULL)                   = 4
clone(child_stack=NULL, flags=CLONE_CHILD_CLEARTID|CLONE_CHILD_SETTID|SIGCHLD, child_tidptr=0x7faa47c44810) = 21181
close(4)                                = 0
accept(3, NULL, NULL)                   = ? ERESTARTSYS (Bude restartováno, pokud je SA_RESTART nastaveno)
--- SIGCHLD {si_signo=SIGCHLD, si_code=CLD_EXITED, si_pid=21181, si_uid=998, si_status=0, si_utime=0, si_stime=0} ---
wait4(0, [{WIFEXITED(s) && WEXITSTATUS(s) == 0}], WNOHANG|WSTOPPED, NULL) = 21181
wait4(0, 0x7ffe6bc36764, WNOHANG|WSTOPPED, NULL) = -1 ECHILD (Žádné procesy potomků)
rt_sigaction(SIGCHLD, {sa_handler=0x55d244bdb690, sa_mask=[CHLD], sa_flags=SA_RESTORER|SA_RESTART, sa_restorer=0x7faa47ab9840}, {sa_handler=0x55d244bdb690, sa_mask=[CHLD], sa_flags=SA_RESTORER|SA_RESTART, sa_restorer=0x7faa47ab9840}, 8) = 0
rt_sigreturn({mask=[]})                 = 43
accept(3, NULL, NULL)                   = 4
clone(child_stack=NULL, flags=CLONE_CHILD_CLEARTID|CLONE_CHILD_SETTID|SIGCHLD, child_tidptr=0x7faa47c44810) = 21200
close(4)                                = 0
accept(3, NULL, NULL)                   = ? ERESTARTSYS (Bude restartováno, pokud je SA_RESTART nastaveno)
--- SIGCHLD {si_signo=SIGCHLD, si_code=CLD_EXITED, si_pid=21200, si_uid=998, si_status=111, si_utime=0, si_stime=0} ---
wait4(0, [{WIFEXITED(s) && WEXITSTATUS(s) == 111}], WNOHANG|WSTOPPED, NULL) = 21200
wait4(0, 0x7ffe6bc36764, WNOHANG|WSTOPPED, NULL) = -1 ECHILD (Žádné procesy potomků)
rt_sigaction(SIGCHLD, {sa_handler=0x55d244bdb690, sa_mask=[CHLD], sa_flags=SA_RESTORER|SA_RESTART, sa_restorer=0x7faa47ab9840}, {sa_handler=0x55d244bdb690, sa_mask=[CHLD], sa_flags=SA_RESTORER|SA_RESTART, sa_restorer=0x7faa47ab9840}, 8) = 0
rt_sigreturn({mask=[]})                 = 43
accept(3, NULL, NULL
(Poslední accept() nebude dokončeno při trasování.) A opět, jak je mi líto, ale tento výsledek neobsahuje chybu, kterou hledáme. Nevidíme žádnou zprávu, kterou by bcrontag posílal socketu nebo přijímal od něj. Místo toho se jedná jen o správu procesu (clone, wait4, SIGCHLD a tak dále.) Tento proces vytváří podproces, který, jak to už může být jasné, vykonává skutečnou práci. A pokud je potřeba sledovat jeho stopu, přidejte k volání strace -f. Toto je to, co najdeme, když hledáme chybovou zprávu v novém výsledku pomocí strace -f -o /tmp/trace -p 20629:
21470 openat(AT_FDCWD, "tmp/spool.21470.1573692319.854640", O_RDWR|O_CREAT|O_EXCL, 0600) = -1 EACCES (Přístup odepřen)
21470 write(1, "32:ZNelze vytvořit dočasný f"..., 36) = 36
21470 write(2, "bcron-spool[21470]: Fatální: logs:"..., 84) = 84
21470 unlink("tmp/spool.21470.1573692319.854640") = -1 ENOENT (Žádný takový soubor nebo adresář)
21470 exit_group(111)                   = ?
21470 +++ exited with 111 +++
Toto už je něco. Proces 21470 má chybu „přístup odepřen“ při pokusu o vytvoření souboru na cestě tmp/spool.21470.1573692319.854640 (týkající se aktuálního pracovního adresáře). Kdybychom pouze věděli aktuální pracovní adresář, znali bychom celé cesty a mohli bychom zjistit, proč proces nemůže vytvořit svůj dočasný soubor. Bohužel, proces už skončil, takže nebude možné jednoduše použít lsof -p 21470 k tomu, abychom našli aktuální adresář, ale můžeme pracovat zpětně – prozkoumat systémové volání PID 21470, které mění adresář. (Pokud taková nejsou, PID 21470 je možná zdědil od rodiče, a to už přes lsof -p nelze zjistit.) Toto systémové volání – chdir (což lze snadno zjistit pomocí moderních vyhledávačů). A tady je výsledek zpětného vyhledávání podle výsledků sledování, až k samotnému serveru PID 20629:
20629 clone(child_stack=NULL, flags=CLONE_CHILD_CLEARTID|CLONE_CHILD_SETTID|SIGCHLD, child_tidptr=0x7faa47c44810) = 21470
...
21470 execve("/usr/sbin/bcron-spool", ["bcron-spool"], 0x55d2460807e0 /* 27 vars */) = 0
...
21470 chdir("/var/spool/cron")          = 0
...
21470 openat(AT_FDCWD, "tmp/spool.21470.1573692319.854640", O_RDWR|O_CREAT|O_EXCL, 0600) = -1 EACCES (Přístup odepřen)
21470 write(1, "32:ZNelze vytvořit dočasný f"..., 36) = 36
21470 write(2, "bcron-spool[21470]: Fatální: logs:"..., 84) = 84
21470 unlink("tmp/spool.21470.1573692319.854640") = -1 ENOENT (Žádný takový soubor nebo adresář)
21470 exit_group(111)                   = ?
21470 +++ exited with 111 +++
(Pokud se ztratíte, možná byste si měli přečíst můj předchozí příspěvek .) Takže server PID 20629 neměl povolení vytvořit soubor na cestě /var/spool/cron/tmp/spool.21470.1573692319.854640. Pravděpodobně je příčinou klasická nastavení oprávnění souborového systému. Ověřme to:
# ls -ld /var/spool/cron/tmp/
drwxr-xr-x 2 root root 4096 Nov  6 05:33 /var/spool/cron/tmp/
# ps u -p 20629
USER       PID %CPU %MEM    VSZ   RSS TTY      STAT START   TIME COMMAND
cron     20629  0.0  0.0   2276   752 ?        Ss   Nov14   0:00 unixserver -U /var/run/bcron-spool -- bcron-spool
Tady je problém! Server běží jako uživatelský cron, ale pouze root má povolení zapisovat do adresáře /var/spool/cron/tmp/. Jednoduchý příkaz chown cron /var/spool/cron/tmp/ to vyřeší bcron fungovat správně. (Pokud problém nebyl v tom, dalším nejpravděpodobnějším podezřelým je bezpečnostní modul jádra typu SELinux nebo AppArmor, takže bych zkontroloval protokol hlášení jádra pomocí dmesg.)
Celkem
Začátečníci mohou být zahlceni výsledky trasování systémových volání, ale doufám, že jsem ukázal, že jsou to rychlé způsoby ladění celého spektra běžných problémů s nasazením. Představte si, jak se snažíte ladit vícetečný bcron, pomocí krokového ladicího programu.
Analýza výsledků trasování zpětně podél řetězce systémových volání vyžaduje dovednosti, ale jak už jsem řekl, téměř vždy, pokud použiji strace, prostě získám výsledek trasování a hledám chyby, počínaje koncem. V každém případě, strace pomáhá mi ušetřit spoustu času na ladění. Doufám, že vám také bude užitečný.
Zdroj: habr.com
