

Čím složitější je systém, tím více se obklopuje různými upozorněními. A objevuje se potřeba na tato upozornění reagovat, agregovat je a vizualizovat. Myslím, že situace je známá mnohým až do nervového tikání.
Řešení, o kterém bude řeč, není nejpřekvapivější, ale plnohodnotný článek na toto téma se nedaří najít.
Proto jsem se rozhodl podělit o zkušenosti společnosti FunCorp a povědět o tom, jak je nastaven proces pohotovosti, kdo volá, proč a jak se na to vše dá dívat.
Co je to PagerDuty?
Abychom vyřešili všechny tyto úkoly, začali jsme hledat pohodlný nástroj. Po krátkém hledání jsme se rozhodli pro PagerDuty. PD se nám zdál být dostatečně úplným a přehledným řešením s velkým množstvím integrací a nastavení. Co to vlastně představuje?
Stručně řečeno, PagerDuty je platforma pro zpracování incidentů, která umí zpracovávat příchozí incidenty přes různé integrace, nastavovat pořadí pohotovosti a dále provádět alerting pohotovostnímu inženýru podle úrovně incidentu (při vysoké úrovni — telefonát, při nízké — push z aplikace/sms).
Kdo je to pohotovostní inženýr?
Asi to je první, čím je třeba začít nastavení PD.
Ve FunCorp, stejně jako v jiných společnostech, existuje čestná pozice pohotovostního inženýra. Ta se přenáší od inženýra k inženýrovi jednou za den. Existuje takzvaná první a druhá linie reakce na upozornění od PagerDuty. Představme si, že přijde high-priority alert, a pokud po 10 minutách od hovoru na pohotovostního inženýra z první linie není žádná reakce (tj. není převeden do stavu acknowledged nebo resolved), hovor přechází k druhému pohotovostnímu inženýrovi. To se nastavuje přímo v PagerDuty prostřednictvím Escalation Policies.
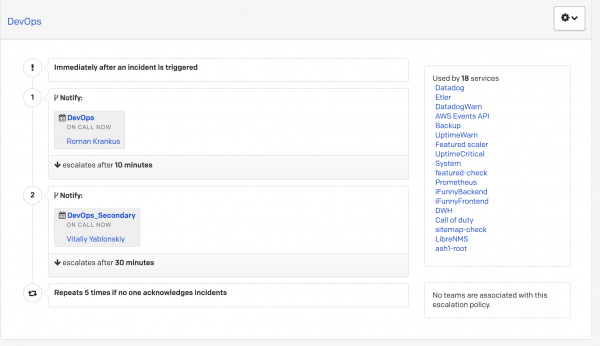
Pokud ani druhý pohotovostní inženýr neodpovídá, upozornění se vrací zpět k hlavnímu pohotovostnímu inženýrovi.
Tímto způsobem žádné příchozí high-priority upozornění nemůže zůstat nezpracované.
Teď se podívejme, odkud mohou incidenty přicházet.
Jaké integrace používáme?
Do PD spadá mnoho různorodých incidentů z různých služeb. V současnosti máme kolem 25 takových služeb a pro jejich zpracování používáme některé hotové integrace.
- Prometheus
Hlavním systémem pro sběr metrik je Prometheus. O něm už bylo mnohé napsáno na Habr, já jen řeknu, že máme několik instancí pro různé prostředí: jedna sbírá metriky z virtuálních strojů a dockerů, druhá - ze služeb Amazonu, třetí - z "železných strojů". Jako exportér metrik se většinou používá Telegraf.
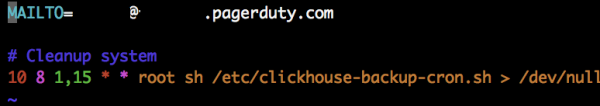
Tady také, myslím, je vše jasné z názvu. Tato integrace se používá k odesílání oznámení z některých skriptů vykonávaných podle plánu. PD vám poskytne určitou adresu, na kterou odesíláte e-maily. Při vytváření služby s touto integrací si můžete nastavit priority, v jakém pořadí budou zpracovány příchozí incidenty, jak konkrétně vytvářet alert (při každém příchozím e-mailu, při příchozím e-mailu + nějaké pravidlo atd.).
- Slack
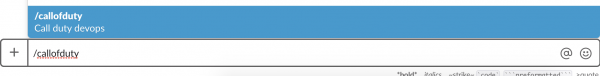
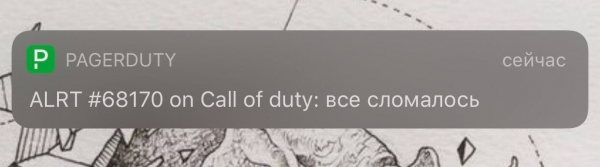
Podle mého názoru je to velmi zajímavá integrace. Existují případy, kdy se něco stane, ale nezahrnuje to incidenty. Proto jsme přidali integraci se Slackem pro vytváření incidentu. T. j. do firemního Slacku můžete napsat /callofduty все тормозит и скоро сломается a PD to zpracuje a pošle incident na pohotovostního technika.
Děláme:
Vidíme:
- API
Integrace přes HTTP. Tady není nic zvláštního, jen POST žádost s tělem v JSON formátu. Například, z zajímavého: používáme ji pro externí monitoring pomocí . Tato služba kontroluje dostupnost našich stránek z různých míst na světě. V případě, kdy obdržíme nepřijatelný kód odpovědi (například 502), je vytvořen incident a dál to pokračuje podle řetězce, popsaného výše. V samotném StatusCake je možnost monitorování interních URL, expirace SSL certifikátu nebo domény.
- LibreNMS
To je další monitorovací systém, podrobněji o něm si můžete přečíst na jejich webu . S jeho pomocí provádíme monitoring síťových rozhraní a iDRAC ze serverů.
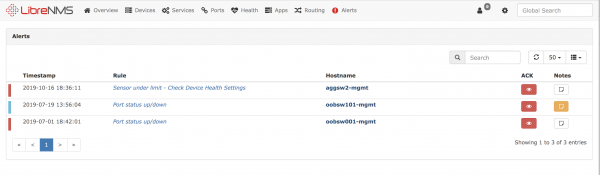
Byly i další integrace, jako Datadog, CloudWatch. Podrobnosti o tom, co s nimi bylo, si můžete prohlédnout .
Vizualizace
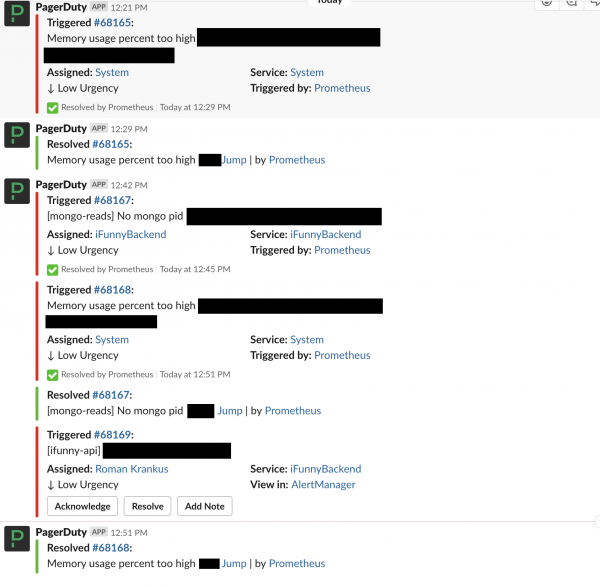
Hlavním systémem pro informování o incidentech je Slack. Do speciálního chatu se zapisují všechny příchozí incidenty do PD, a pokud se změní jejich stav, je to také zobrazeno v chatu.
Když se objevila možnost zobrazit užitečné údaje na monitorech visících ze stropu, náhle jsme si uvědomili, že v našem (devops) oddělení nemáme, co na ně zobrazovat. Existuje skvělá Grafana, ale ta nezahrnuje všechno, navíc zaměstnanci reagují na upozornění, nikoli na grafy.
Po pečlivém, ale neúspěšném hledání na GitHubu stručného a informativního 'boardu' pro PD, jsme se rozhodli napsat si svůj — pouze s tím, co potřebujeme. I když prvně byla myšlenka zobrazit na obrazovce samotné rozhraní PD, to vypadalo ještě nepohodlněji.
K tomu, abychom ji napsali, stačí získat klíč k PD s právy pouze pro čtení.
A tady je, co jsme vytvořili:
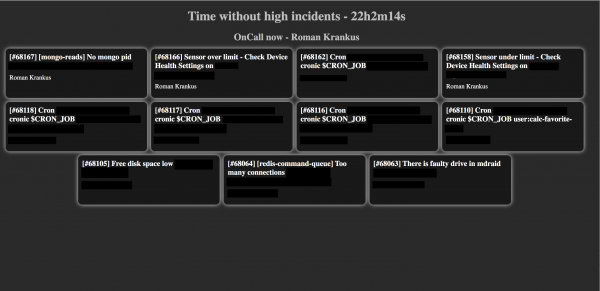
Na obrazovce se zobrazují aktuální otevřené incidenty, jméno aktuálního pohotovostního inženýra z vybraného rozvrhu a čas bez vysokoprioritního incidentu (panel s vysokoprioritním incidentem bude zvýrazněn červenou barvou).
.
Nakonec jsme získali pohodlný dashboard pro přehled všech našich incidentů. Budu rád, pokud náš zkušenost někomu z vás pomůže.
Zdroj: habr.com
