

Jak číst tento článek: omlouvám se, že text je tak dlouhý a chaotický. Abych ušetřil váš čas, začínám každou kapitolu úvodem „Co jsem se naučil“, kde ve dvou až třech větách shrnu podstatu kapitoly.
„Jednoduše ukaž řešení!“ Pokud chcete vidět pouze výsledek, přejděte k kapitole „Stávám se vynalézavějším“, ale myslím, že je zajímavější a užitečnější si přečíst o neúspěších.
Nedávno mi bylo zadáno nastavit proces zpracování velkého objemu sekvencí DNA (technicky jde o SNP čip). Potřebovali jsme rychle získat data o určitém genetickém místě (které se nazývá SNP) pro následné modelování a další úkoly. Pomocí R a AWK se mi podařilo data přirozeným způsobem vyčistit a uspořádat, což výrazně zrychlilo zpracování dotazů. Nebylo to pro mě snadné a vyžadovalo to řadu iterací. Tento článek vám pomůže vyhnout se některým mým chybám a ukáže, co jsem nakonec dosáhl.
Na začátek pár úvodních vysvětlení.
Údaje
Náš univerzitní centrum pro zpracování genetických informací nám poskytlo data ve formátu TSV o velikosti 25 TB. Dostaly se mi v pěti balíčcích, komprimovaných pomocí Gzip, z nichž každý obsahoval přibližně 240 čtyřgigabajtových souborů. Každý řádek obsahoval data pro jeden SNP jedné osoby. Celkem byly poskytnuty údaje o přibližně 2,5 milionu SNP a 60 tisíc lidí. Kromě SNP informací obsahovaly soubory četné sloupce s čísly, které odrážely různé vlastnosti, jako je intenzita čtení, frekvence různých alel atd. Celkově bylo asi 30 sloupců s unikátními hodnotami.
Cíl
Jako v jakémkoli projektu řízení dat bylo nejdůležitější určit, jak budou data využívána. V tomto případě většinou budeme vybírat modely a pracovní postupy pro SNP na základě SNP. To znamená, že potřebujeme data pouze pro jeden SNP. Musel jsem se naučit, jak co nejjednodušeji, nejrychleji a nejlevněji extrahovat všechny záznamy, které se vztahují k jednomu z 2,5 milionu SNP.
Jak to nedělat
Cituji vhodné klišé:
Neselhal jsem tisíckrát, jen jsem objevil tisíc způsobů, jak nezpracovat spoustu dat ve formátu vhodném pro dotazy.
První pokus
Co jsem se naučil: neexistuje levný způsob, jak parsovat 25 TB najednou.
Po absolvování předmětu "Pokročilé metody zpracování velkých dat" na Vanderbiltově univerzitě jsem byl přesvědčen, že mám vše pod kontrolou. Možná hodina či dvě budou potřeba na nastavení Hive serveru, abych mohl projít všechna data a podat zprávu o výsledku. Protože naše data jsou uložena v AWS S3, využil jsem službu , která umožňuje aplikovat Hive SQL dotazy na data v S3. Není potřeba nastavovat/uvádět Hive cluster, a platíte pouze za ta data, která hledáte.
Poté, co jsem ukázal Atheně svá data a jejich formát, spustil jsem několik testů se podobnými dotazy:
select * from intensityData limit 10;A rychle jsem obdržel dobře strukturované výsledky. Hotovo.
Dokud jsme nezkusili použít data v praxi…
Byl jsem požádán, abych vytáhl všechny informace o SNP pro testování modelu. Spustil jsem dotaz:
select * from intensityData
where snp = 'rs123456';
…a začal čekat. Po osmi minutách a více než 4 TB požadovaných dat jsem obdržel výsledek. Athena účtuje podle objemu nalezených dat, 5 $ za terabajt. Takže tento jediný dotaz mě stál 20 $ a osm minut čekání. Abych mohl model projít přes všechna data, musel bych čekat 38 let a zaplatit 50 milionů $. Je zřejmé, že toto pro nás nebylo přijatelné.
Bylo třeba použít Parquet…
Co jsem se naučil: buďte opatrní s velikostí vašich Parquet souborů a jejich organizací.
Nejdříve jsem se pokusil situaci napravit převedením všech TSV do . Jsou vhodné pro práci s velkými datovými sadami, protože informace v nich jsou ukládány ve sloupcovém formátu: každý sloupec leží v samostatném segmentu paměti/disku, na rozdíl od textových souborů, kde řádky obsahují prvky každého sloupce. A když něco potřebujete najít, stačí přečíst potřebný sloupec. Navíc v každém souboru je ve sloupci uložen rozsah hodnot, takže pokud hledaná hodnota chybí v rozsahu sloupce, Spark nebude plýtvat časem skenováním celého souboru.
Spustil jsem jednoduchý úkol Provedeme převod našich TSV souborů do Parquet a nahráli nové soubory do služby Athena. Trvalo to přibližně 5 hodin. Ale když jsem spustil dotaz, trvalo jeho vykonání také zhruba stejnou dobu a stálo to o něco méně peněz. Důvod je ten, že Spark, když se snažil optimalizovat úkol, prostě rozbalil jeden TSV chunk a uložil ho do vlastního Parquet chunku. A protože každý chunk byl dost velký a obsahoval úplné záznamy mnoha lidí, měl Spark za úkol otevřít všechny soubory, aby získal potřebné informace.
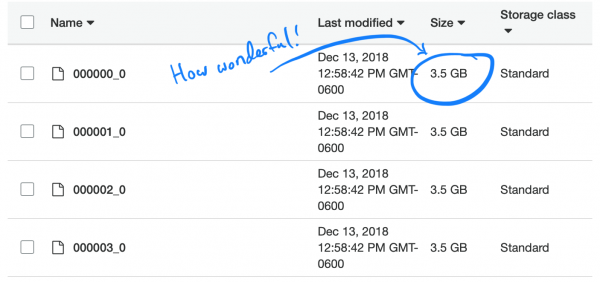
Zajímavé je, že výchozí (a doporučený) typ komprese v Parquet — snappy — není sdílený (splitable). Proto každý vykonavatel (executor) stagnoval na úkolu rozbalování a načítání kompletní datové sady o velikosti 3,5 GB.
Pojďme se podívat na problém
Co jsem se naučil: třídění je obtížné, obzvlášť pokud jsou data distribuována.
Myslel jsem, že nyní rozumím podstatě problému. Potřeboval jsem pouze seřadit data podle sloupce SNP, nikoli podle lidí. Pak by v samostatném chunku dat bylo uloženo několik SNP a funkce Parquet „otevřít pouze pokud je hodnota v tomto rozmezí“ by se plně projevila. Bohužel řazení miliard řádků rozptýlených po clusteru se ukázalo jako složitý úkol.
Já na hodině algoritmů na vysoké škole: „Ugh, nikoho nezajímá výpočetní složitost všech těchto třídicích algoritmů“
Já, když se snažím seřadit sloupec ve 20TB tabulka: „Proč to trvá tak dlouho?“ problémy.
— Nick Strayer (@NicholasStrayer)
AWS rozhodně nechce vracet peníze z důvodu „Jsem roztržitý student“. Poté, co jsem spustil řazení na Amazon Glue, běželo to 2 dny a skončilo to chybou.
Co takhle partitioning?
Co jsem se naučil: partitiony ve Sparku musí být vyvážené.
Pak mě napadlo rozdělit data podle chromozomů. Je jich 23 (a ještě několik, pokud započítáme mitochondriální DNA a neanalyzované oblasti).
To umožní rozdělit data do menších porcí. Pokud do Spark funkce exportu ve skriptu Glue přidáme pouze jeden řádek partition_by = "chr", pak by data měla být rozdělena do bucketů.
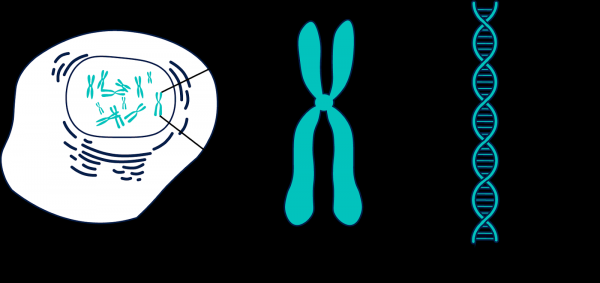
Genom se skládá z mnoha fragmentů, které se nazývají chromozomy.
Bohužel to nefungovalo. Chromozomy mají různé velikosti, a tedy i různý objem informací. To znamená, že úlohy, které Spark odesílal pracovníkům, nebyly vyvážené a vykonávaly se pomalu, protože některé uzly se dokončily dříve a čekaly. Nicméně úlohy byly splněny. Avšak při dotazu na jeden SNP nevyváženost opět způsobila problémy. Náklady na zpracování SNP ve větších chromozomech (tedy odtud, odkud chceme získat data) se snížily pouze asi 10krát. Hodně, ale nestačí.
A co když rozdělíme na ještě menší partitiony?
Co jsem se naučil: vůbec se nesnažte udělat 2,5 milionu partitionů.
Rozhodl jsem se jít all-in a partitionoval každý SNP. To zaručilo stejnou velikost partitionů. TO BYLA ŠPATNÁ MYŠLENKA. Použil jsem Glue a přidal nevinný řádek partition_by = 'snp'. Úloha se spustila a začala se vykonávat. O den později jsem zkontroloval a zjistil, že v S3 stále není nic zapsáno, takže jsem úlohu zrušil. Vypadá to, že Glue zapisoval mezipaměťové soubory na skryté místo v S3, a bylo tam mnoho souborů, možná několik milionů. V důsledku toho má chyba stála více než tisíc dolarů a nepotěšila mého mentora.
Partitionování + třídění
Co jsem se naučil: stále je obtížné třídit, stejně jako nastavovat Spark.
Můj poslední pokus o partitionování spočíval v tom, že jsem partitionoval chromozomy a poté třídil každou partition. V teorii to mělo urychlit každý dotaz, protože požadovaná data o SNP by měla být v několika Parquet blocích v rámci daného rozsahu. Bohužel třídění dokonce partitionovaných dat se ukázalo jako obtížný úkol. Nakonec jsem přešel na EMR pro vlastní cluster a použil osm výkonných instancí (C5.4xl) a Sparklyr pro vytvoření flexibilnějšího pracovního postupu...
# Sparklyr snippet to partition by chr and sort w/in partition
# Join the raw data with the snp bins
raw_data
  group_by(chr) %>%
  arrange(Position) %>%
  Spark_write_Parquet(
    path = DUMP_LOC,
    mode = 'overwrite',
    partition_by = c('chr')
  )
…nicméně úloha stejně nebyla dokončena. Zkoušel jsem to různě: zvyšoval paměť přidělenou každému vykonávajícímu, používal uzly s větším objemem paměti, aplikoval broadcasting variable, ale pokaždé to byly jen polovičaté řešení a postupně začali vykonávající selhávat, dokud to všechno nezastavilo.
Aktualizace: tak to začíná.
— Nick Strayer (@NicholasStrayer)
Stávám se vynalézavějším
Co jsem se naučil: někdy zvláštní data vyžadují zvláštní řešení.
Každý SNP má hodnotu pozice. Toto číslo odpovídá počtu základů, které leží podél jeho chromozomu. To je dobrý a přirozený způsob organizace našich dat. Původně jsem chtěl rozdělovat podle oblastí každého chromozomu. Například, pozice 1 — 2000, 2001 — 4000 atd. Ale problém je, že SNP jsou rozloženy po chromozomech nerovnoměrně, takže velikosti skupin se budou značně lišit.
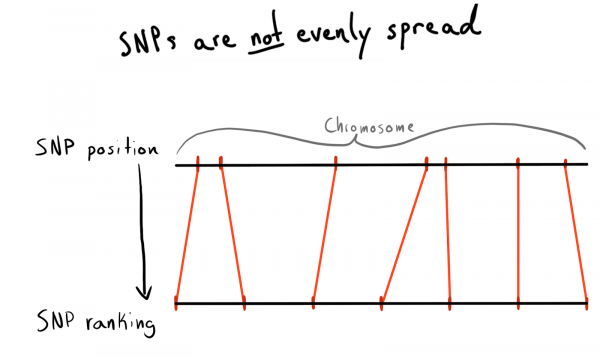
Nakonec jsem se dostal k rozdělení podle kategorií (rank) pozic. Na základě již načtených dat jsem provedl dotaz na získání seznamu unikátních SNP, jejich pozic a chromozomů. Poté jsem seřadil data uvnitř každého chromozomu a shromáždil SNP do skupin (bin) stanovené velikosti. Řekněme, po 1000 SNP. To mi dalo vazbu SNP na skupinu-v-chromozomu.
Nakonec jsem udělal skupiny (bin) po 75 SNP, důvod vysvětlím níže.
snp_to_bin %
  group_by(chr) %>%
  arrange(position) %>%
  mutate(
    rank = 1:n()
    bin = floor(rank/snps_per_bin)
  ) %>%
  ungroup()
První pokus se Sparkem
Co jsem se naučil: slučování ve Sparku funguje rychle, ale partitioning stále vychází draho.
Chtěl jsem přečíst tento malý (2,5 milionu řádků) datový rámec do Sparku, spojit ho s nezpracovanými daty a poté rozdělit podle nově přidaného sloupce. bin.
# Join the raw data with the snp bins
data_w_bin <- raw_data %>%
  left_join(sdf_broadcast(snp_to_bin), by ='snp_name') %>%
  group_by(chr_bin) %>%
  arrange(Position) %>%
  Spark_write_Parquet(
    path = DUMP_LOC,
    mode = 'overwrite',
    partition_by = c('chr_bin')
  )
Použil jsem sdf_broadcast(), takže Spark ví, že má poslat datový rámec na všechny uzly. To je užitečné, pokud jsou data malé velikosti a jsou potřebná pro všechny úkoly. Jinak se Spark snaží být chytrý a distribuuje data podle potřeby, což může způsobit zpoždění.
A znovu můj plán nefungoval: úkoly nějakou dobu pracovaly, dokončily slučování a pak, jako spuštění executory pro partitioning, začaly selhávat.
Přidávám AWK
Co jsem se naučil: neusínejte, když se učíte základy. Určitě někdo už vyřešil váš problém už v 80. letech.
Až do této chvíle byla příčinou všech mých neúspěchů se Sparkem promíchanost dat v klastru. Možná by situaci bylo možné zlepšit pomocí předzpracování. Rozhodl jsem se zkusit rozdělit nezpracovaná textová data na sloupce chromozomů, tak jsem doufal, že poskytnu Sparku „předzpracovaná“ data.
Hledal jsem na StackOverflow, jak rozdělit podle hodnot sloupců, a našel Pomocí AWK můžete rozdělit textový soubor podle hodnot sloupců tím, že zapíšete skript, místo abyste posílali výsledky do stdout.
Pro zkoušku jsem napsal Bash skript. Stáhl jsem jeden z archivovaných TSV, poté jsem ho rozbalil pomocí . Verze ICU jsou – bezvýznamné. a poslal do awk.
gzip -dc path/to/chunk/file.gz |
awk -F 't'
'{print $1",..."$30">"chunked/"$chr"_chr"$15".csv"}'
To fungovalo!
Vyplnění jader
Co jsem se naučil: gnu parallel — to je kouzelná věc, všichni by ji měli používat.
Rozdělování probíhalo docela pomalu a když jsem spustil htop, abych zkontroloval využití výkonného (a drahého) EC2 instance, ukázalo se, že využívám pouze jedno jádro a přibližně 200 MB paměti. Abych vyřešil problém a neztratil spoustu peněz, musel jsem vymyslet, jak práci paralelizovat. Naštěstí jsem v naprosto úžasné knize Jerona Janssensa našel kapitolu věnovanou paralelizaci. Z ní jsem se dozvěděl o gnu parallel, velmi flexibilní metodě implementace vícetrhání v Unixu.
Když jsem spustil rozdělování pomocí nového procesu, všechno šlo skvěle, ale zůstalo zde úzké místo — stahování S3 objektů na disk nebylo příliš rychlé a nebylo plně paralelizované. Abych to opravil, udělal jsem toto:
- Zjistil jsem, že mohu přímo v potrubí implementovat fázi S3 stahování, zcela vyloučit mezipaměť na disku. To znamená, že se mohu vyhnout zápisu surových dat na disk a použít ještě menší, a tudíž levnější úložiště na AWS.
- Příkazem
aws configure set default.s3.max_concurrent_requests 50silně zvýšilo počet vláken, které používá AWS CLI (ve výchozím nastavení jich je 10). - Přešel jsem na optimalizovaný na rychlost sítě EC2 instance, s písmenem n v názvu. Zjistil jsem, že ztráta výpočetního výkonu při používání n-instančních s dostatečně kompenzuje zvýšení rychlosti stahování. Pro většinu úloh jsem použil c5n.4xl.
- Změnil jsem
. Verze ICU jsou – bezvýznamné.na , to je gzip nástroj, který umí dělat skvělé věci pro paralelizaci původně neparalelizovaných úloh rozbalení souborů (to pomohlo nejméně).
# Let S3 use as many threads as it wants
aws configure set default.s3.max_concurrent_requests 50

for chunk_file in $(aws s3 ls $DATA_LOC | awk '{print $4}' | grep 'chr'$DESIRED_CHR'.csv') ; do

        aws s3 cp s3://$batch_loc$chunk_file - |
        pigz -dc |
        parallel --block 100M --pipe
        "awk -F 't' '{print $1",..."$30">"chunked/{#}_chr"$15".csv"}'"

       # Combine all the parallel process chunks to single files
        ls chunked/ |
        cut -d '_' -f 2 |
        sort -u |
        parallel 'cat chunked/*_{} | sort -k5 -n -S 80% -t, | aws s3 cp - '$s3_dest'/batch_'$batch_num'_{}'

         # Clean up intermediate data
       rm chunked/*
done
Tyto kroky jsou kombinovány, aby všechno fungovalo velmi rychle. Díky zvýšení rychlosti stahování a opuštění zápisu na disk jsem nyní mohl zpracovat 5TB balíček během několika hodin.
Není nic sladšího než vidět všechny jádra, za která platíte na AWS, skutečně využitá. Díky gnu-parallel mohu dekomprimovat a rozdělit 19gigový csv soubor tak rychle, jak ho mohu stáhnout. Ani jsem nedokázal spustit Spark.
— Nick Strayer (@NicholasStrayer)
V tomto tweetu mělo být zmíněno 'TSV'. Bohužel.
Použití znovu zparsovaných dat
Co jsem se naučil: Spark má rád nekomprimovaná data a nerad kombinuje partice.
Nyní byla data uložena v S3 v nekomprimovaném (čili, děleném) a částečně uspořádaném formátu a já se mohl vrátit k Sparku. Čekalo mě překvapení: znovu se mi nedařilo dosáhnout požadovaného! Bylo velmi těžké přesně říct Spark'ovi, jak jsou data rozdělena. A i když jsem to udělal, ukázalo se, že je příliš mnoho particí (95 tisíc), a když jsem pomocí coalesce snížil jejich počet na rozumné limity, porušilo to mé partiční uspořádání. Jsem si jistý, že to lze opravit, ale během dvou dnů hledání jsem nenašel řešení. Nakonec jsem dokončil všechny úkoly ve Sparku, i když to zabralo nějaký čas, a mé rozdělené Parquet soubory nebyly příliš malé (~200 kB). Nicméně data byla uložena tam, kde měla být.
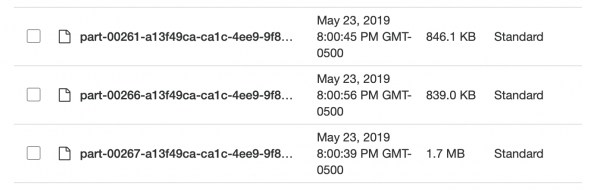
Příliš malé a různé, skvělé!
Testování lokálních Spark dotazů
Co jsem se naučil: ve Sparku je příliš mnoho režijních nákladů při řešení jednoduchých úloh.
Když jsem data nahrál ve promyšleném formátu, mohl jsem otestovat rychlost. Nastavil jsem skript v R pro spuštění lokálního Spark serveru a poté načetl Spark datový rámec z určeného úložiště Parquet skupin (bin). Snažil jsem se načíst všechna data, ale nedokázal jsem donutit Sparklyr rozpoznat rozdělení.
sc <- Spark_connect(master = "local")

desired_snp <- 'rs34771739'

# Spusťte časomíru
start_time <- Sys.time()

# Načtěte požadovaný bin do Sparku
intensity_data %
  Spark_read_Parquet(
    name = 'intensity_data',
    path = get_snp_location(desired_snp),
    memory = FALSE )

# Zúžte bin na snp a poté shromážděte lokálně
test_subset %
  filter(SNP_Name == desired_snp) %>%
  collect()

print(Sys.time() - start_time)
Provádění trvalo 29,415 sekundy. O hodně lepší, ale ne příliš dobré pro hromadné testování čehokoliv. Navíc jsem nemohl zrychlit práci pomocí ukládání do mezipaměti, protože když jsem se pokusil ukládat rámec dat do paměti, Spark vždy spadl, i když jsem přiřadil více než 50 GB paměti pro dataset, který vážil méně než 15.
Návrat k AWK
Co jsem se naučil: asociativní pole v AWK jsou velmi efektivní.
Uvědomil jsem si, že mohu dosáhnout vyšší rychlosti. Vzpomněl jsem si, že v úžasném Četl jsem o skvělé funkci nazvané „“. V podstatě se jedná o páry klíč-hodnota, které byly z nějakého důvodu v AWK pojmenovány jinak, takže jsem na ně moc nemyslel. mi připomněl, že termín „asociativní pole“ je mnohem starší než termín „pár klíč-hodnota“. I když si , tento termín tam neuvidíte, místo toho najdete asociativní pole! Kromě toho se „pár klíč-hodnota“ většinou spojuje s databázemi, proto je logičtější porovnávat s hashmap. Uvědomil jsem si, že můžu použít tato asociativní pole k propojení mých SNP s tabulkou skupin (bin table) a surovými daty bez použití Sparku.
K tomu jsem v AWK skriptu použil blok BEGIN. To je fragment kódu, který se vykoná, než bude první řádek dat předán do hlavního těla skriptu.
join_data.awk
BEGIN {
  FS=",";
  batch_num=substr(chunk,7,1);
  chunk_id=substr(chunk,15,2);
  while(getline  "chunked/chr_"chr"_bin_"bin[$1]"_"batch_num"_"chunk_id".csv"
}
Tým while(getline...) nahrál všechny řádky z CSV skupiny (bin), určil první sloupec (název SNP) jako klíč pro asociativní pole bin a druhou hodnotu (skupina) jako hodnotu. Poté v bloku { }, který se vykonává pro všechny řádky hlavního souboru, je každý řádek odeslán do výstupního souboru, který dostává unikátní jméno v závislosti na jeho skupině (bin): ..._bin_"bin[$1]"_....
Proměnné batch_num a chunk_id odpovídaly datům poskytnutým potrubím, což umožnilo vyhnout se stavu závodu, a každý vykonávací tok spuštěný parallel, zapisoval do svého vlastního unikátního souboru.
Protože jsem všechny surové údaje rozptýlil do složek podle chromozomů, které zbyly po mém předchozím experimentu s AWK, nyní jsem mohl napsat další Bash skript, abych zpracoval jeden chromozom najednou a poslal do S3 hlouběji dělená data.
DESIRED_CHR='13'

# Stáhnout data chromozomu z s3 a rozdělit do bins
aws s3 ls $DATA_LOC |
awk '{print $4}' |
grep 'chr'$DESIRED_CHR'.csv' |
parallel "echo 'reading {}'; aws s3 cp "$DATA_LOC"{} - | awk -v chr=""$DESIRED_CHR"" -v chunk="{}" -f split_on_chr_bin.awk"

# Kombinovat všechny části paralelního procesu do jednotlivých souborů a nahrát do rds pomocí R
ls chunked/ |
cut -d '_' -f 4 |
sort -u |
parallel "echo 'zipping bin {}'; cat chunked/*_bin_{}_*.csv | ./upload_as_rds.R '$S3_DEST'/chr_'$DESIRED_CHR'_bin_{}.rds"
rm chunked/*
Ve skriptu jsou dva oddíly parallel.
V první části se čtou data ze všech souborů obsahujících informace o požadovaném chromozomu, potom se tato data rozdělují do vláken, která umísťují soubory do odpovídajících skupin (bin). Aby nedošlo k závodnímu stavu, kdy několik vláken zapisuje do jednoho souboru, AWK předává názvy souborů pro zápis dat na různá místa, například, chr_10_bin_52_batch_2_aa.csv. V důsledku toho se na disku vytváří mnoho malých souborů (pro to jsem použil terabajtové EBS svazky).
Kompilator ze druhé části parallel prochází skupinami (bin) a spojuje jejich jednotlivé soubory do společného CSV s cat, a poté je posílá na export.
Translaci do R?
Co jsem se naučil: lze přistupovat k stdin a stdout z R skriptu, což znamená, že jej lze použít v kompilátoru.
Ve skriptu Bash jste si možná všimli této řádky: ...cat chunked/*_bin_{}_*.csv | ./upload_as_rds.R.... Přenáší všechny zkonkatenované soubory skupiny (bin) do níže uvedeného R skriptu. {} je speciální metodou parallel, která jakákoliv data odesílaná do určeného streamu vloží přímo do příkazu. Možnost {#} poskytuje unikátní ID vykonávacího streamu, a {%} je číslo slotu úlohy (opakující se, ale nikdy současně). Seznam všech možností najdete v
#!/usr/bin/env Rscript
library(readr)
library(aws.s3)

# Read first command line argument
data_destination <- commandArgs(trailingOnly = TRUE)[1]

data_cols <- list(SNP_Name = 'c', ...)

s3saveRDS(
  read_csv(
        file("stdin"),
        col_names = names(data_cols),
        col_types = data_cols
    ),
  object = data_destination
)
Když je proměnná file("stdin") předána do readr::read_csv, data přenesená do R skriptu se načtou do rámce, který potom ve formě .rds-soubory pomocí aws.s3 se zapisuje přímo do S3.
RDS je něco jako mladší verze Parquet, bez rafinování sloupcového úložiště.
Po dokončení Bash skriptu jsem získal sadu .rds-soubory ležící v S3, což mi umožnilo používat efektivní kompresi a zabudované typy.
Navzdory použití pomalého R to všechno běželo velmi rychle. Není divu, že fragmenty na R, které zajišťují čtení a zápis dat, jsou dobře optimalizovány. Po testování na jednom středně velkém chromozomu dokončil úkol na instanci C5n.4xl přibližně za dvě hodiny.
Omezení S3
Co jsem se naučil: díky chytrému provedení cest může S3 zpracovat mnoho souborů.
Obával jsem se, zda bude S3 schopna zpracovat množství jí předaných souborů. Mohu dát názvům souborů smysl, ale jak bude S3 podle nich vyhledávat?
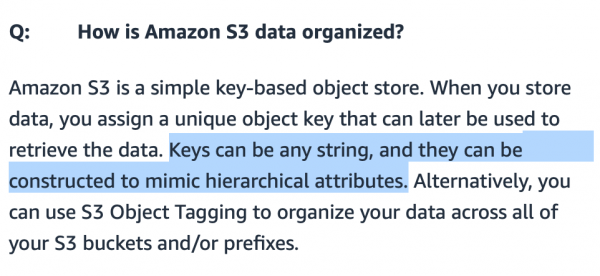
Složky v S3 jsou pouze pro estetiku, ve skutečnosti systém nezajímá symbol /.
Zdá se, že S3 představuje cestu k určitému souboru jako jednoduchý klíč v jakési hash tabulce nebo databázi založené na dokumentech. Bucket lze považovat za tabulku a soubory za záznamy v této tabulce.
Jelikož je rychlost a efektivita důležitá pro ziskovost v Amazonu, není překvapením, že tento systém "klíč-k-cestě-k-souboru" je skvěle optimalizován. Snažil jsem se najít rovnováhu: aby nebylo potřeba provádět mnoho GET dotazů, ale aby dotazy byly rychlé. Ukázalo se, že nejlepší je mít zhruba 20 tisíc binárních souborů. Myslím, že pokud budu pokračovat v optimalizaci, mohu dosáhnout zvýšení rychlosti (například vytvořením speciálního bucketu pouze pro data, čímž se sníží velikost vyhledávací tabulky). Ale na další experimenty už nezbylo čas ani peníze.
Co říkáte na křížovou kompatibilitu?
Čemu jsem se naučil: hlavní příčinou ztráty času je předčasná optimalizace vaší metody ukládání.
V tomto okamžiku je velmi důležité položit si otázku: "Proč používat proprietární formát souborů?" Důvod spočívá v rychlosti načítání (komprimované gzip CSV soubory se načítaly 7krát déle) a kompatibilitě s našimi pracovními postupy. Mohu přehodnotit své rozhodnutí, pokud R snadno načte soubory Parquet (nebo Arrow) bez zátěže ve formě Sparku. V naší laboratoři všichni používají R, a pokud budu potřebovat převést data do jiného formátu, mám stále původní textová data, takže mohu jednoduše znovu spustit pipeline.
Rozdělení práce
Co jsem se naučil: nesnažte se optimalizovat úkoly ručně, ať to udělá počítač.
Opravil jsem pracovní proces na jednom chromozomu, nyní je potřeba zpracovat všechna ostatní data.
Chtěl jsem spustit několik instancí EC2 pro transformaci, ale zároveň jsem se obával, že dostanu extrémně nevyvážené zatížení v různých zpracovatelských úkolech (stejně jako Spark trpěl nevyváženými partiemi). Kromě toho se mi nechtělo zvedat jednu instanci na každý chromozom, protože pro účty AWS je výchozí omezení 10 instancí.
Tak jsem se rozhodl napsat skript na R pro optimalizaci zpracovatelských úloh.
Nejprve jsem požádal S3, aby spočítal, kolik místa ve skladu zabírá každý chromozom.
knihovna(aws.s3)
knihovna(tidyverse)

chr_sizes %
mutate(Size = as.numeric(Size)) %>%
filter(Size != 0) %>%
mutate(
# Extrakce chromozomu z názvu souboru
chr = str_extract(Key, 'chr.{1,4}.csv') %>%
str_remove_all('chr|.csv')
) %>%
group_by(chr) %>%
summarise(total_size = sum(Size)/1e+9) # Děleno pro získání hodnoty v GB


# Tibble: 27 x 2
chr total_size

1 0 163.
2 1 967.
3 10 541.
4 11 611.
5 12 542.
6 13 364.
7 14 375.
8 15 372.
9 16 434.
10 17 443.
# … s 17 dalšími řádky
Pak jsem napsal funkci, která vezme celkovou velikost, promíchá pořadí chromozomů a rozdělí je do skupin num_jobs a sdělí, jak moc se liší velikosti všech zpracovatelských úloh.
num_jobs <- 7
# Jak velká by každá úloha byla, kdyby byla dokonale rozdělena?
job_size <- sum(chr_sizes$total_size)/7

shuffle_job %
sample_frac() %>%
mutate(
cum_size = cumsum(total_size),
job_num = ceiling(cum_size/job_size)
) %>%
group_by(job_num) %>%
summarise(
job_chrs = paste(chr, collapse = ','),
total_job_size = sum(total_size)
) %>%
mutate(sd = sd(total_job_size)) %>%
nest(-sd)
}

shuffle_job(1)


# Tibble: 1 x 2
sd data

1 153.
Pak jsem přes purrr spustil tisíc promíchání a vybral to nejlepší.
1:1000 %>%
map_df(shuffle_job) %>%
filter(sd == min(sd)) %>%
pull(data) %>%
pluck(1)
Tak jsem získal sadu úloh, které byly velmi podobné velikostí. Pak jsem už jen potřeboval zabalit můj předchozí Bash skript do velkého cyklu for. Na napsání této optimalizace mi to zabralo asi 10 minut. A to je mnohem méně, než bych strávil manuálním vytvářením úloh v případě, že by byly nesbalancované. Proto považuji, že s touto předchozí optimalizací jsem neudělal chybu.
for DESIRED_CHR in "16" "9" "7" "21" "MT"
do
# Kód pro zpracování jednoho chromozomu
fi
Na konci přidávám příkaz pro vypnutí:
sudo shutdown -h now … a všechno vyšlo! Pomocí AWS CLI jsem spouštěl instance a přes možnost user_data jsem jim předával Bash skripty jejich zpracovatelských úloh. Ty se vykonávaly a automaticky vypínaly, takže jsem neplatil za nadbytečnou výpočetní sílu.
aws ec2 run-instances ...
--tag-specifications "ResourceType=instance,Tags=[{Key=Name,Value=<>}]"
--user-data file://<>
Balení!
Co jsem se naučil: API by mělo být jednoduché kvůli jednoduchosti a flexibilitě použití.
Nakonec jsem dostal data na správném místě a v správném formátu. Teď bylo potřeba maximálně zjednodušit proces využívání dat, aby to mým kolegům usnadnilo práci. Chtěl jsem vytvořit jednoduché API pro generování dotazů. Pokud se v budoucnu rozhodnu přejít s .rds Pokud se jedná o soubory Parquet, mělo by to být mým problémem, nikoli problémem kolegů. Rozhodl jsem se proto vytvořit interní R balíček.
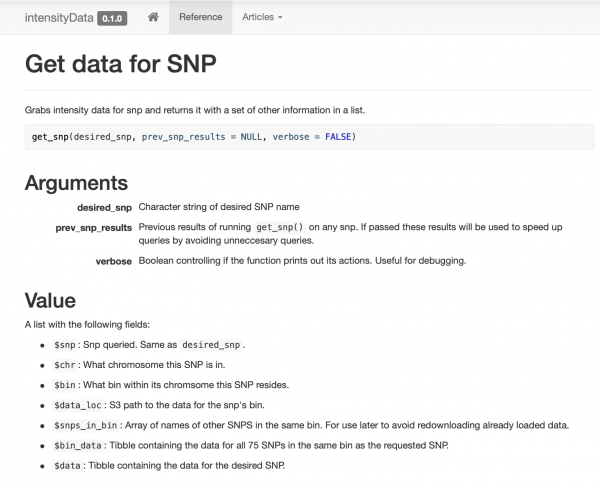
Sestavil jsem a zdokumentoval velmi jednoduchý balíček, který obsahuje pouze několik funkcí pro přístup k datům, vytvořeným kolem funkce get_snp. Také jsem vytvořil pro kolegy web , aby si mohli snadno prohlédnout příklady a dokumentaci.
Inteligentní ukládání do vyrovnávací paměti
Co jsem se naučil: pokud jsou vaše data dobře připravena, ukládání do vyrovnávací paměti bude snadné!
Jelikož jeden z hlavních pracovních toků aplikoval stejný analytický model na balíček SNP, rozhodl jsem se využít seskupení (binning) ve svůj prospěch. Při předávání dat po SNP je k vrácenému objektu připojena veškerá informace ze skupiny (bin). To znamená, že staré požadavky mohou (teoreticky) urychlit zpracování nových požadavků.
# Part of get_snp()
...
  # Test if our current snp data has the desired snp.
  already_have_snp <- desired_snp %in% prev_snp_results$snps_in_bin

  if(!already_have_snp){
    # Grab info on the bin of the desired snp
    snp_results <- get_snp_bin(desired_snp)

    # Download the snp's bin data
    snp_results$bin_data <- aws.s3::s3readRDS(object = snp_results$data_loc)
  } else {
    # The previous snp data contained the right bin so just use it
    snp_results <- prev_snp_results
  }
...
Při sestavování balíčku jsem provedl mnoho benchmarků, abych porovnal rychlost při použití různých metod. Doporučuji na to nezapomínat, protože výsledky mohou být někdy překvapivé. Například dplyr::filter se ukázal být mnohem rychlejší než zachytávání řádků pomocí indexového filtrování, a získání jednoho sloupce z filtrovacího datového rámce bylo mnohem rychlejší než použití indexovacího syntaxe.
Všimněte si, že objekt prev_snp_results obsahuje klíč snps_in_bin. Je to pole všech jedinečných SNP ve skupině (bin), které umožňuje rychle zkontrolovat, zda již existují data z předchozího požadavku. Také usnadňuje procházení všech SNP ve skupině (bin) pomocí tohoto kódu:
# Get bin-mates
snps_in_bin <- my_snp_results$snps_in_bin

for(current_snp in snps_in_bin){
  my_snp_results <- get_snp(current_snp, my_snp_results)
  # Do something with results
}
Výsledky
Nyní můžeme (a začali jsme skutečně) spouštět modely a scénáře, které byly dříve nedostupné. Nejlepší na tom je, že mým kolegům v laboratoři nemusí myslet na žádné složitosti. Mají jednoduše funkci, která funguje.
A i když je balíček zbavuje detailů, snažil jsem se udělat formát dat dostatečně jednoduchý, aby se v něm mohli vyznat, kdybych zítra náhodou zmizel...
Rychlost se výrazně zvýšila. Obvykle skenujeme funkčně významné úseky genomu. Dříve jsme to nemohli dělat (bylo to příliš drahé), ale nyní, díky skupinové (bin) struktuře a ukládání do vyrovnávací paměti, trvá průměrně méně než 0,1 sekundy na žádost o jedno SNP, a využívání dat je tak nízké, že náklady na S3 jsou minimální.
Nedávno jsem měl na starosti zpracování více než 25 TB surových genotypových dat pro svou laboratoř. Když jsem začínal, trvalo to pomocí Spark 8 minut a stálo to 20 dolarů na dotaz SNP. Po použití AWK + to nyní trvá méně než 10 setin sekundy a stojí 0,00001 dolaru. Můj osobní úspěch.
— Nick Strayer (@NicholasStrayer)
Závěr
Tento článek není vůbec průvodcem. Řešení byla individuální a pravděpodobně neoptimální. Spíše je to příběh o cestě. Chci, aby ostatní pochopili, že podobná řešení nevznikají v hlavě plně utvořená, ale jsou výsledkem pokusů a omylů. Navíc, pokud hledáte specialistu na analýzu dat, mějte na paměti, že pro efektivní využití těchto nástrojů je třeba zkušeností, a zkušenosti vyžadují peníze. Jsem rád, že jsem měl prostředky na zaplacení, ale mnozí jiní, kteří by mohli vykonat stejnou práci lépe než já, nikdy takovou příležitost mít nebudou kvůli nedostatku peněz i na pokus.
Nástroje pro velká data jsou univerzální. Pokud máte čas, pravděpodobně dokážete napsat rychlejší řešení, použijete „inteligentní“ čištění dat, úložiště a metody extrakce. Nakonec jde vše o analýzu nákladů a přínosů.
Čeho jsem se naučil:
- neexistuje levný způsob, jak narazit 25 TB najednou;
- buďte opatrní na velikost svých Parquet souborů a jejich organizaci;
- partice ve Sparku by měly být vyvážené;
- nikdy se nesnažte mít 2,5 milionu particí;
- třídění je stále obtížné, stejně jako nastavování Sparku;
- někdy vyžadují speciální data speciální řešení;
- sloučení v Sparku běží rychle, ale particionování stále stojí hodně;
- nespěte, když vás učí základy, určitě už někdo vyřešil váš problém už v 80. letech;
gnu parallel— to je kouzelná věc, všichni by ji měli používat;- Spark má rád nekomprimovaná data a nemá rád sloučení particí;
- ve Sparku je příliš mnoho režijních nákladů při řešení jednoduchých úloh;
- asociativní pole v AWK jsou velmi efektivní;
- můžete na ně odkazovat
stdinastdoutz R skriptu, což znamená, že je můžete použít v pipeline; - díky inteligentní implementaci S3 může zpracovávat mnoho souborů;
- hlavní důvod ztráty času je předčasná optimalizace vaší metody ukládání;
- nesnažte se optimalizovat úkoly ručně, ať to udělá počítač;
- API by mělo být jednoduché pro snadnost a flexibilitu použití;
- pokud jsou vaše data dobře připravena, bude snadné je cachovat!
Zdroj: habr.com
