

Ahoj, Habr!
Připomínáme, že jsme vydali další velmi zajímavý a užitečný o vzorech Kubernetes. Všechno to začalo s "" Brendanem Burnsem, a v podstatě, naše práce v tomto segmentu . Dnes vám nabízíme přečíst si článek z blogu MinIO, který stručně shrnuje tendence a specifika vzorů ukládání dat v Kubernetes.
Kubernetes zásadně změnil tradiční vzory vývoje a nasazení aplikací. Nyní může týmu trvat jen několik dní na vývoj, testování a nasazení aplikace – v různých prostředích, a to vše v rámci clusterů Kubernetes. Taková práce s technologiemi minulých generací obvykle trvala celé týdny, ne-li měsíce.
Toto zrychlení bylo možné díky abstrakci, kterou Kubernetes poskytuje – tedy proto, že Kubernetes samo realizuje interakci s nízkoúrovňovými detaily fyzických nebo virtuálních strojů, umožňující uživatelům deklarovat mimo jiné potřebný procesor, potřebné množství paměti, počet instancí kontejnerů. Vzhledem k tomu, že o podporu Kubernetes se stará obrovské společenství a rozsah používání Kubernetes se neustále rozšiřuje, jednoznačně vede před ostatními platformami pro orchestraci kontejnerů.
Jak se používání Kubernetes rozšiřuje, roste i zmatek ohledně vzorů ukládání dat, které se v něm používají..
Při všeobecné konkurenci o kousek koláče Kubernetes (tedy o ukládání dat), když dojde na řeč o ukládání dat, signál zde tonie ve silném šumu.
Kubernetes představuje současný model vývoje a nasazení aplikací, stejně jako jejich správu. Tento moderní model odděluje ukládání dat od výpočtů. Abychom plně pochopili toto oddělení v kontextu Kubernetes, musíme také porozumět tomu, co jsou aplikace pracující se zachováním stavu a bez zachování stavu, a jak se k tomu vztahuje ukládání dat. Právě zde přístup REST API, který používá S3, má zřetelné výhody oproti přístupu POSIX/CSI, který je charakteristický pro jiná řešení.
V tomto článku se budeme zabývat vzory ukládání dat v Kubernetes a podrobně se dotkneme debaty o aplikacích provozovaných bez stavu a s uložením stavu, abychom dobře pochopili, v čem spočívá rozdíl mezi nimi a proč je důležitý. V textu budou také zvažovány aplikace a vzory ukládání dat používané v souladu s nejlepšími praktikami práce s kontejnery a Kubernetes.
Kontejnery bez ukládání stavu
Kontejnery jsou ze své podstaty lehké a efemérní. Lze je snadno zastavit, odstranit nebo nasadit na jiném uzlu – na to vše stačí jen několik sekund. V rozsáhlém systému orchestrace kontejnerů se tyto operace odehrávají neustále a uživatelé si ani nevšimnou těchto změn. Avšak, přesuny jsou možné pouze tehdy, pokud kontejner nemá žádné závislosti na uzlu, na kterém je umístěn. O takových kontejnerech se říká, že fungují bez ukládání stavu.
Kontejnery s ukládáním stavu
Pokud kontejner ukládá data na lokálně připojená zařízení (nebo na blokové zařízení), pak bude třeba přesunout datové úložiště, na kterém se nachází, na nový uzel společně s kontejnerem – v případě selhání. To je důležité, protože jinak aplikace spuštěná v kontejneru nebude správně fungovat, protože musí mít přístup k datům uloženým na lokálních médiích. O takových kontejnerech se říká, že fungují s ukládáním stavu.
Z čistě technického hlediska je možné také přesouvat kontejnery s ukládáním stavu na jiné uzly. Obvykle je to zajištěno pomocí distribuovaných souborových systémů nebo blokových síťových úložišť dat připojených ke všem uzlům, na kterých kontejnery běží. Tímto způsobem kontejnery získávají přístup k objemům pro trvalé ukládání dat a informace se ukládají na discích rozmístěných po celé síti. Tuto metodu nazývámkontejnerovým přístupem s ukládáním stavua v zbytek článku ji tak budu nazývat pro jednotnost.
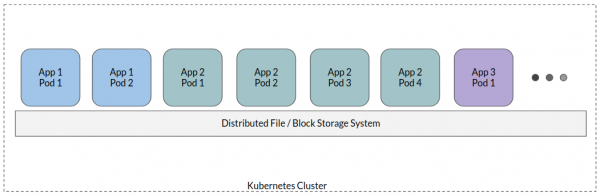
Při typickém kontejnerovém přístupu se zachováním stavu jsou všechny podřízené aplikací připojeny k jedné distribuované souborové soustavě – což vytvoří jakousi sdílenou paměť, kde se nacházejí všechna data aplikací. I když jsou možné určité variace, je to přístup na vysoké úrovni.
Nyní si pojďme vysvětlit, proč je kontejnerový přístup se zachováním stavu v oblečném světě anti-vzorem.
Návrh aplikací zaměřený na cloud
Tradičně aplikace používaly databáze pro strukturované uchovávání informací a místní disky či distribuované souborové systémy, kam se ukládala všechna nestrukturovaná nebo dokonce polo-strukturovaná data. Jak objem nestrukturovaných dat rostl, vývojáři si uvědomili, že POSIX je příliš "mluvný", spojený s významnými náklady a nakonec brání fungování aplikace při přechodu na skutečně velké měřítka.
To vše přispělo k vzniku nového standardu uchovávání dat, tedy cloudově orientovaných úložišť, která fungují převážně na základě REST API a osvobozují aplikaci od náročného spravování místního úložiště dat. V takovém případě aplikace fakticky přechází do režimu bez uchovávání stavu (protože stav se nachází v dálkovém úložišti). Moderní aplikace jsou budovány od základů s přihlédnutím k tomuto faktoru. Obvykle je každá moderní aplikace, která zpracovává data jakéhokoli druhu (logy, metadata, blob atd.) postavena podle cloudově orientované paradigmatiky, kde je stav přesunut do speciálně vyhrazeného softwarového systému pro jeho uchovávání.
Kontejnerový přístup se zachováním stavu nutí celou tuto paradigmu vrátit se zpět k tomu, odkud začala!
Při použití rozhraní POSIX pro ukládání dat aplikace fungují stejně, jako by ukládaly svůj stav, a tím se odklánějí od nejdůležitějších postulátů cloudově orientovaného designu, tedy od možnosti měnit velikosti pracovních toků aplikace podle příchozí zátěže, přesouvat se na nový uzel, jakmile aktuální uzel selže, a tak dále.
Pokud se podíváme na tuto situaci blíže, zjistíme, že při výběru úložiště dat se opět a opět setkáváme s dilematem "POSIX kontra REST API", A TO S DALŠÍM ZESÍLENÍM PROBLÉMŮ POSIX způsobeným distribuovanou povahou prostředí Kubernetes. Zejména,
- POSIX je zbytečně složité: semantika POSIX vyžaduje přiřadit k každé operaci metadata a deskriptory souborů, které pomáhají udržovat stav operace. To vede k významným nákladům, které nemají žádnou skutečnou hodnotu. API pro ukládání objektů, zejména S3 API, se těchto požadavků zbavily, což umožňuje aplikaci provést akci a poté "zapomenout" na volání. Odpověď systému úložiště ukazuje, zda byla akce úspěšně provedena nebo ne. V případě neúspěchu může aplikace provést opakování.
- Síťová omezení: V distribuovaném systému se předpokládá, že může existovat řada aplikací, které se pokoušejí zapisovat data na stejný připojený média. Proto nejen že aplikace budou mezi sebou soutěžit o šířku pásma (aby poslaly data na médium), samotný systém úložiště bude soutěžit o tuto šířku pásma, rozesílající data po fyzických discích. Díky složitosti POSIX se počet síťových volání zvyšuje několikrát. Na druhou stranu, S3 API poskytuje jasné rozlišení síťových volání mezi těmi, která přicházejí z klienta na server, a těmi, která se odehrávají v rámci serveru.
- Bezpečnost: Model zabezpečení POSIX je navržena pro aktivní účast uživatele: administrátoři konfigurují konkrétní úrovně přístupu pro každého uživatele nebo skupinu. Tato paradigma se obtížně přizpůsobuje cloudovému světu. Moderní aplikace závisí na modelech zabezpečení založených na API, kde jsou práva přístupu definována jako soubor politik, přidělovány služební účty, dočasné přihlašovací údaje atd.
- Spravovatelnost: Kontejnery se zachováním stavu nesou určité náklady spojené s řízením. Jde o synchronizaci paralelního přístupu k datům, zajištění konzistence dat, to vše vyžaduje pečlivé zvážení, jaké vzory přístupu k datům použít. Je nutné instalovat, monitorovat a konfigurovat další programy, nemluvě o dalších úsilí vynaloženém na vývoj.
Kontejnerové rozhraní pro ukládání dat
Zatímco rozhraní kontejnerového úložiště dat (CSI) významně pomohlo s rozšířením úrovně svazků Kubernetes a částečně přeneslo tuto funkci na externí dodavatele úložišť, zároveň omylem podporovalo přesvědčení, že kontejnerový přístup se zachováním stavu je doporučeným metodou ukládání dat v Kubernetes.
CSI byl navržen jako standard pro poskytování různých systémů blokového a souborového úložiště pro dědictví aplikace při práci s Kubernetes. Jak bylo ukázáno v tomto článku, jediná situace, kdy je kontejnerový přístup se zachováním stavu (a CSI v jeho současné podobě) rozumný – je, když je samotná aplikace dědičným systémem, ve kterém není možné přidat podporu pro API objektového úložiště.
Je důležité chápat, že při používání CSI v jeho současné podobě, tedy montováním svazků při práci se současnými aplikacemi, se setkáme s přibližně stejnými problémy, které se vyskytovaly v systémech, kde bylo ukládání dat organizováno podle stylu POSIX.
Kvalitnější přístup
V tomto případě je důležité pochopit, že většina aplikací není primárně určena pro práci s ukládáním stavu nebo bez něj. Tento přístup závisí na celkové architektuře systému a konkrétních volbách učiněných při návrhu. Pojďme si trochu popovídat o aplikacích, které uchovávají stav.
V podstatě lze všechna data aplikací rozdělit do několika širokých kategorií:
- Logové údaje
- Údaje o časových značkách
- Transakční údaje
- Metadatové údaje
- Obrázky kontejnerů
- Údaje blobů (velkých binárních objektů)
Všechny tyto typy dat jsou velmi dobře podporovány na moderních platformách pro ukládání dat, a existuje několik cloudově orientovaných platforem, které jsou přizpůsobeny pro dodávku dat v každém z těchto konkrétních formátů. Například transakční údaje a metadata mohou být v moderní cloudově orientované databázi, jako je CockroachDB, YugaByte atd. Obrázky kontejnerů nebo údaje blobů mohou být uloženy v dockerovém registru založeném na MinIO. Údaje časových značek mohou být uloženy v databázi časových řad, například InfluxDB atd. Nepodrobíme se zde každému typu dat a odpovídajícím aplikacím, ale základní myšlenkou je, že se vyhneme trvalému ukládání dat založenému na místním připojení disků.
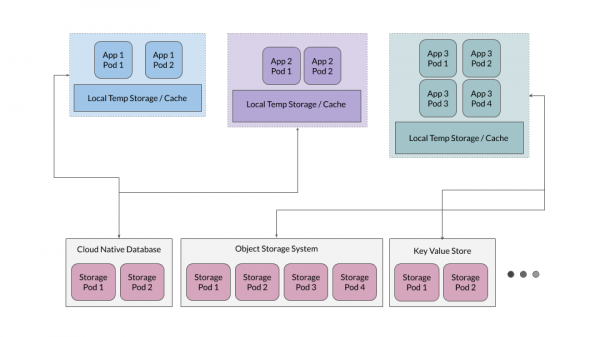
Kromě toho se často ukazuje, že je efektivní poskytnout úroveň dočasného ukládání, která slouží aplikacím jako jakýsi sklad dočasných souborů, ale aplikace by se na tuto úroveň neměly spoléhat jako na zdroj pravdy.
Ukládání pro aplikace s uchováváním stavu
Zatímco v mnoha případech je prospěšné udržovat aplikace bez stavu, ty aplikace, které jsou určeny k ukládání dat – například databáze, objektové úložiště, úložiště klíčů a hodnot – by měly uchovávat stav. Pojďme se podívat, proč tyto aplikace nasazují na Kubernetes. Jako příklad vezmeme MinIO, ale podobné principy se vztahují i na jakékoli jiné velké cloudově orientované systémy pro ukládání dat.
Aplikace orientované na cloud jsou navrženy tak, aby maximálně využívaly pružnost, kterou kontejnery nabízejí. To znamená, že nenavrhují žádné předpoklady ohledně prostředí, ve kterém budou nasazeny. Například v MinIO se používá vnitřní mechanismus zbytečného kódování (erasure coding), který zajišťuje dostatečnou odolnost systému, aby zůstal funkční i při selhání poloviny disků. MinIO také spravuje integritu a bezpečnost dat pomocí vlastního hashování a šifrování na straně serveru.
Pro takové aplikace orientované na cloud jsou místní trvalé svazky (PV) nejvhodnějším řešením pro záložní úložiště. Místní PV poskytují možnost ukládat surová data, zatímco aplikace, které běží nad těmito PV, sama shromažďují informace, které umožňují škálování dat a řízení rostoucích požadavků na data.
Tento přístup je mnohem jednodušší a výrazně lépe se škáluje ve srovnání s PV založenými na CSI, které do systému zavádějí vlastní úrovně správy dat a redundance; problém je v tom, že tyto úrovně obvykle konfliktují s aplikacemi navrženými na principu uchování stavu.
Jistý posun k oddělení dat od výpočtů
V tomto článku jsme hovořili o tom, jak se aplikace zaměřují na práci bez uchovávání stavu, nebo jinými slovy, ukládání dat je odděleno od výpočtů nad nimi. Na závěr se podíváme na několik skutečných příkladů tohoto trendu.
, slavná platforma pro analýzu dat, tradičně byla používána s uchováváním stavu a nasazováním ve файловой системе HDFS. Nicméně, s přechodem Spark do cloudového orientovaného světa, se tato platforma stále aktivněji používá bez uchovávání stavu s využitím `s3a`. Spark používá s3a k přenosu stavu do jiných systémů, zatímco samotné kontejnery Spark fungují zcela bez uchovávání stavu. Jiné velké podniky v oblasti analytiky velkých dat, konkrétně, , , se také přecházejí k práci s oddělením ukládání dat a výpočtů nad nimi.
Podobné vzory se také objevují na dalších velkých analytických platformách, mezi nimiž jsou Presto, Tensorflow to R a Jupyter. Vykládání stavu do vzdálených cloudových úložišť dat usnadňuje správu vaší aplikace a její škálování. Kromě toho to podporuje přenositelnost aplikace v rozmanitých prostředích.
Zdroj: habr.com
