

Na první pohled se zdá, že vývojáři Terraform nabízejí dostatečně pohodlné osvědčené postupy pro práci s infrastrukturou AWS. Existuje však jeden háček. Postupem času se zvyšuje počet prostředí, v každém se objevují specifika. V sousedním regionu se objevuje téměř kopie aplikačního stacku. A kód Terraformu je třeba pečlivě zkopírovat a upravit podle nových požadavků, nebo vytvořit sněhovou vločku.
Má prezentace se zaměřuje na vzory v Terraformu jako způsob, jak se vypořádat s chaosem a ručními rutinními činnostmi ve velkých a dlouhých projektech.
Video:
Je mi 40 let, v IT pracuji 20 let. 12 let pracuji ve společnosti Ixtens. Zabýváme se vývojem zaměřeným na ecommerce. A 5 let praktikuji DevOps postupy.
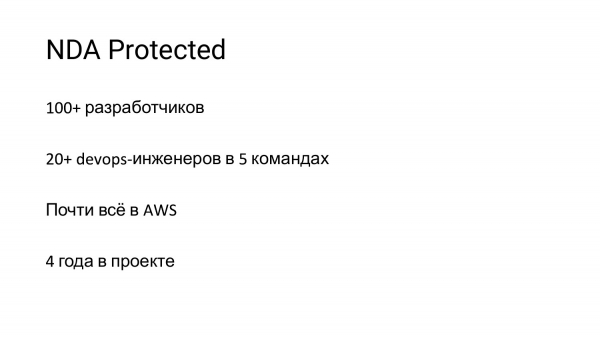
Můj příběh bude o zkušenosti z projektu ve firmě, jejíž název nebudu zveřejňovat z důvodu dohody o mlčenlivosti.
Čísla na snímku jsou uvedena, abychom pochopili rozsah projektu. A vše, co budu dále říkat, souvisí s Amazonem.
Do tohoto projektu jsem se připojil před 4 lety. V té době probíhaly zásadní refaktorizace infrastruktury, protože projekt se rozrostl. A vzory, které byly použity, už nevyhovovaly. Vzhledem k plánovanému růstu projektu bylo potřeba přijít s něčím novým.
Děkuji Matveyovi, který včera mluvil o tom, co se dělo v Dodo Pizza. To, co se dělo u nás před 4 lety.
Přišli vývojáři a začali vytvářet infrastrukturní kód.
Nejzřejmější důvody, proč to bylo potřeba, byly zajištění doby uvedení na trh. Muselo se udělat tak, aby tým DevOps nebyl úzkým hrdlem během nasazení. A kromě toho byly na nejnižší úrovni použity Terraform a Puppet.
Terraform je open source projekt společnosti HashiCorp. A pro ty, kteří nevědí, co to je, následující snímky.
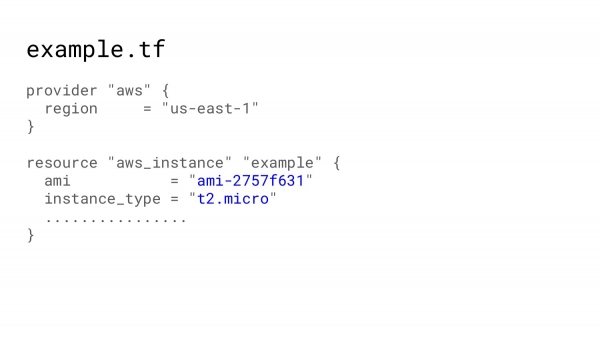
Infrastruktura jako kód znamená, že můžeme popsát naši infrastrukturu a požádat nějaké roboty, aby vytvořili zdroje, které jsme popsali.
Například potřebujeme virtuální stroj. Popsáme to, přidáme několik povinných parametrů.
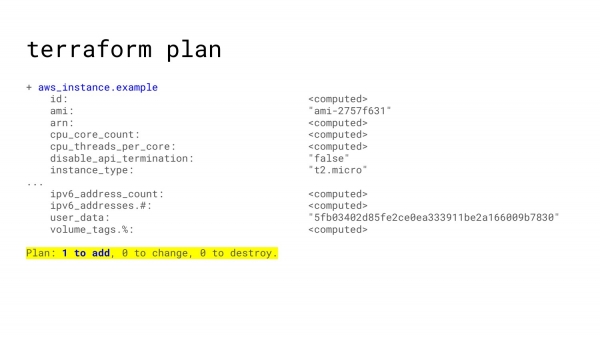
Po tom nastavíme přístup k Amazonu v konzoli. A požádáme Terraform o plán. Terraform plán oznámí: „Dobře, pro váš zdroj můžeme udělat tyto věci“. A minimálně jeden zdroj bude přidán. A žádné změny se neplánují.
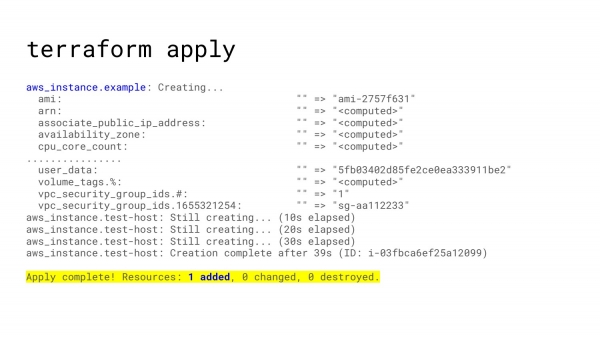
Jakmile jste se vším spokojeni, můžete požádat o Terraform apply a Terraform pro vás vytvoří instanci, a vy obdržíte virtuální stroj ve vašem cloudu.
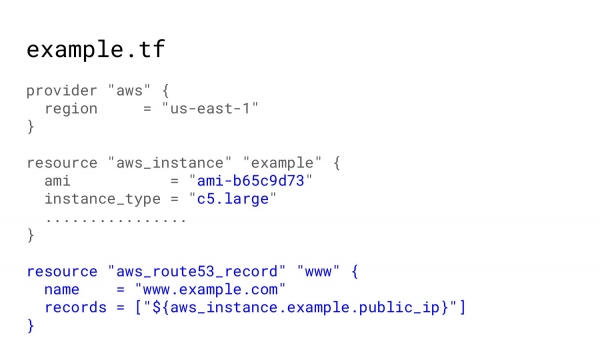
Dále se náš projekt vyvíjí. Přidáváme do něj nějaké změny. Požadujeme více instancí, přidáváme 53. záznam.
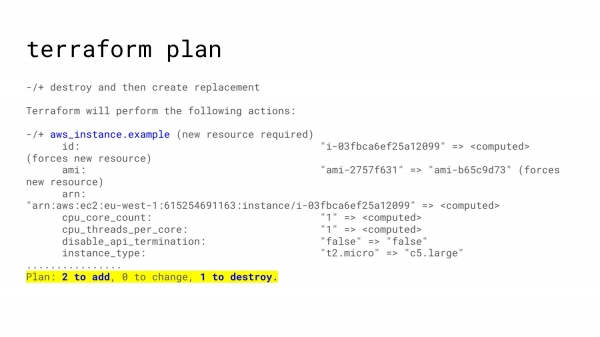
A opakujeme. Požádáme o plán. Vidíme, jaké změny se plánují. Použijeme je. A tak naše infrastruktura roste.
Terraform používá něco jako stavy soubory. Tedy všechny změny, které odcházejí na Amazon, ukládá do souboru, kde pro každý prostředek, který jste popsali, existují odpovídající prostředky, které byly vytvořeny v Amazonu. Tím pádem při změně popisu nějakého prostředku Terraform přesně ví, co je třeba změnit na Amazonu.
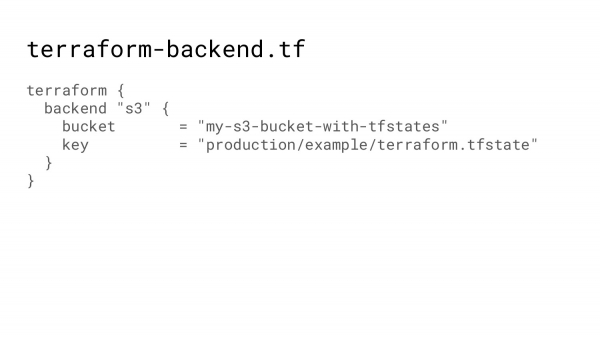
Tyto stavy soubory byly původně prostě soubory. A my je ukládali do Git, což bylo velmi nepohodlné. Stále někdo zapomínal commitovat změny a vznikalo mnoho konfliktů.
Nyní je možné použít backend, tedy Terraformu se určuje, do jakého bucketu a pod jakým klíčem je třeba uložit stavový soubor. A Terraform se postará o to, aby získal tento stavový soubor, provedl veškerou magii a uložil zpět finální výsledek.
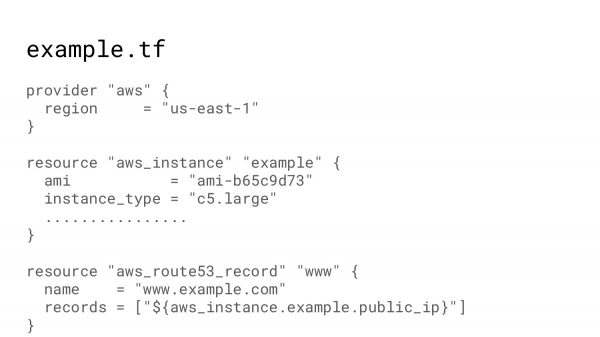
Naše infrastruktura roste. Tady je náš kód. A nyní nechceme jen vytvářet virtuální stroj, chceme mít testovací prostředí.
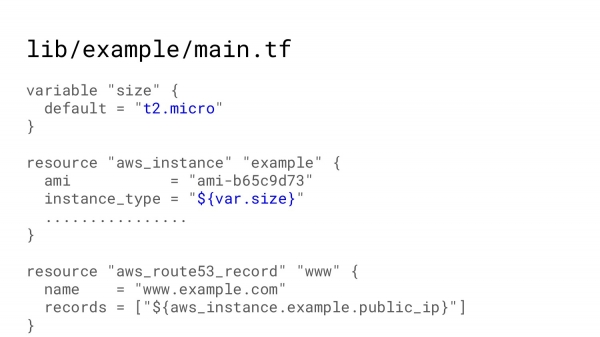
Terraform umožňuje vytvořit něco jako modul, tedy to samé popsat v nějaké složce.
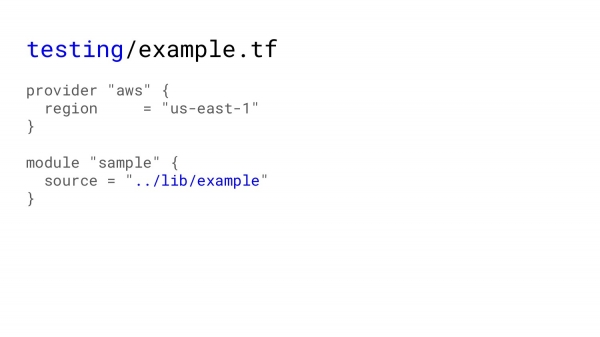
A například v testování zavolat tento modul a získat to samé, jako bychom vykonali Terraform apply v samotném modulu. Pro testování by byl takový kód.
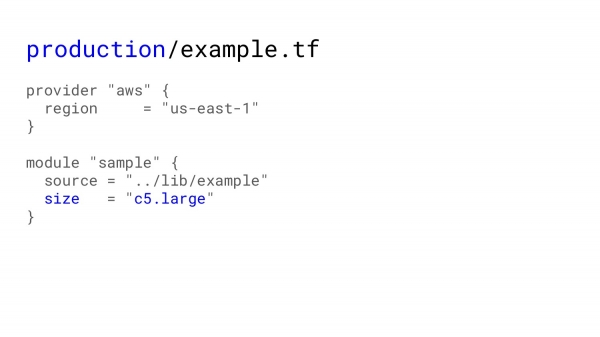
Pro produkci můžeme poslat nějaké změny, protože v testování nepotřebujeme velké instance, v produkci velké instance budou právě potřebné.
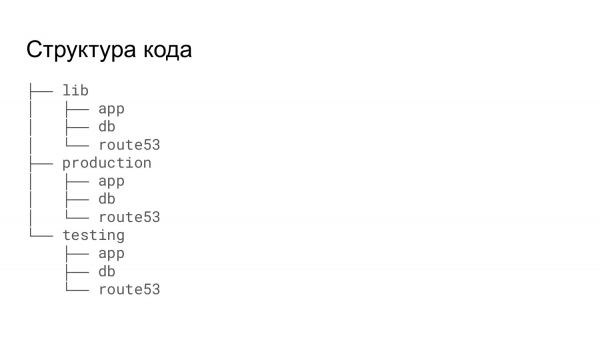
A pak se vrátím zpět do projektu. Byla to složitá úloha, infrastruktura byla plánována jako velmi velká. A bylo potřeba nějak rozložit celý kód, aby to bylo pohodlné pro všechny: jak pro ty, kteří provádí údržbu tohoto kódu, tak pro ty, kteří provádějí změny. A plánovalo se, že jakýkoli vývojář může jít a opravit infrastrukturu tak, jak potřebuje pro svou část platformy.
Tohle je strom adresářů, který doporučuje samotný HashiCorp, pokud máte velký projekt a má smysl rozdělit celou infrastrukturu na nějaké malé kousky, a každé kousky popsat v samostatné složce.
S rozsáhlou knihovnou zdrojů lze ve testování a produkci volat přibližně to samé.
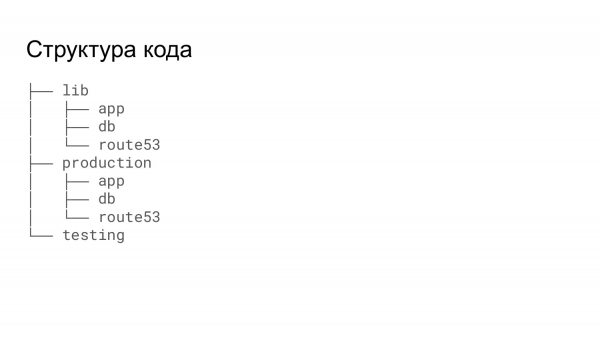
V našem případě to úplně nevyhovovalo, protože testovací stack pro vývojáře nebo pro testování bylo potřeba získávat nějak jednodušeji. A nechtělo se nám procházet složkami, aplikovat to ve správném pořadí a bát se, že se nejprve spustí databáze a poté instance, která tuto databázi používá. Proto se celé testování spouštělo z jedné složky. Tam se volaly stejné moduly, ale vše probíhalo při jednom běhu.
Terraform se stará o všechny závislosti. A vždy vytváří zdroje v takovém pořadí, aby bylo možné získat IP adresu, například od čerstvě vytvořené instance, a mít tuto IP adresu v záznamu route53.
Kromě toho je platforma velmi rozsáhlá. A spuštění testovacího stacku, i když na hodinu, i když na 8 hodin – je to dost nákladná záležitost.
A to jsme automatizovali. Job Jenkins umožňoval spustit stack. Potřebovalo se spustit pull request se změnami, které chtěl vývojář testovat, zadat všechny potřebné možnosti, komponenty a také velikosti. Pokud potřeboval výkonnostní testování, mohl vzít více instancí. Pokud potřeboval jen zkontrolovat, že se nějaký formulář otevírá, mohl začít s minimálním zatížením. A také určit, zda potřebuje cluster nebo ne a tak dále.
A poté Jenkins spustil shell skript, který mírně modifikoval kód ve složce Terraform. Odstraňoval nepotřebné soubory, přidával potřebné soubory. A poté jedním příkazem Terraform apply stack vzrostl.
A poté už následovaly další kroky, do kterých se nechci zatěžovat.
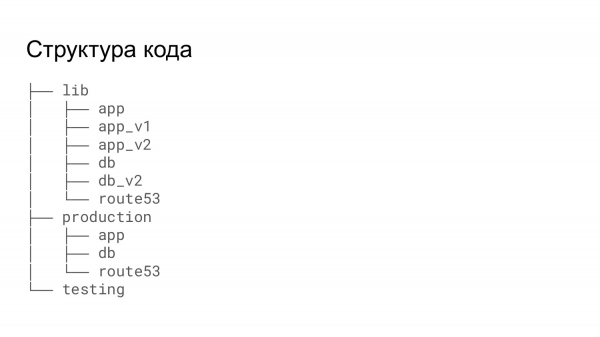
Protože jsme k testování potřebovali o něco více možností než v produkci, museli jsme vytvářet kopie modulů, abychom do těchto kopií mohli přidat ty funkce, které byly potřeba pouze v testování.
A tak se stalo, že v testování bylo jakoby chtěné otestovat ty změny, které nakonec půjdou do produkce. Ale ve skutečnosti se testovalo něco jiného, zatímco v produkci se aplikovalo něco trošku jiného. A byl tam malý rozpor v tom, že všechny změny v produkci aplikovala operační tým. A občas se stalo, že ty změny, které měly přejít z testování do produkce, zůstávaly v jiné verzi.
Kromě toho byl problém v tom, že byl přidán nový servis, který se poněkud lišil od již existujícího. Místo toho, abychom modifikovali stávající modul, museli jsme vytvořit jeho kopii a přidat potřebné změny.
V podstatě Terraform není skutečný jazyk. Je to deklarace. Pokud potřebujeme něco deklarovat, tak to deklarujeme. A všechno to funguje.
V určitém okamžiku, když se diskutoval jeden z mých pull requestů, jeden z kolegů řekl, že není potřeba vytvářet sněhové vločky. Zajímalo mě, co tím myslí. Existuje vědecký fakt, že na světě neexistují dvě totožné sněhové vločky, všechny se trošku liší. A jakmile jsem to slyšel, okamžitě jsem pocítil veškerou tíhu Terraform kódu. Protože když bylo potřeba přejít z jedné verze na druhou, Terraform vyžadoval breaking chain změnu, tj. kód již nebyl kompatibilní s následující verzí. A bylo nutné udělat pull request, který pokrýval téměř polovinu souborů v infrastruktuře, aby se infrastruktura přizpůsobila další verzi Terraform.
A poté, co se objevila taková sněhová vločka, veškerý Terraform kód, který jsme měli, se proměnil ve velkou hromadu sněhu.
Pro externího vývojáře, který není v operacích, to nemá velký význam, protože udělal pull request, jeho zdroj byl spuštěn. A tím to končí, dál se o to nestará. Ale tým DevOps, který dohlíží na to, aby bylo vše v pořádku, musí udělat všechny tyto změny. A cena těchto změn velmi, velmi vzrostla s každou další sněhovou vločkou.
Existuje příběh o tom, jak student na semináři kreslí křídou na tabuli dva dokonalé kruhy. A učitel je překvapen, jak se mu podařilo tak rovně nakreslit bez kružítka. Student odpovídá: „Velmi jednoduše, dva roky jsem v armádě kroutil mlýnek na maso."
A z těch čtyř let, kdy se účastním tohoto projektu, jsem asi dva roky věnoval Terraform. A samozřejmě mám nějaké triky, nějaké tipy, jak zjednodušit Terraform kód, pracovat s ním jako s programovacím jazykem a snížit zátěž na vývojáře, kteří musí tento kód udržovat aktuální.
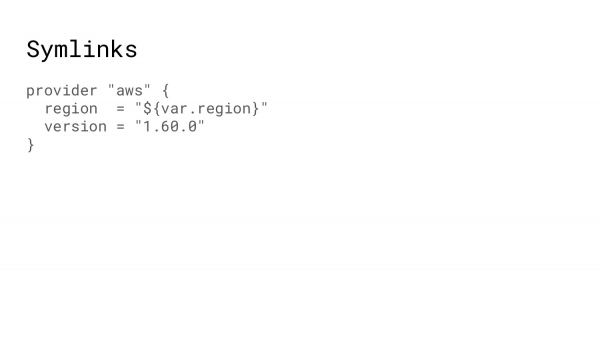
První, co bych chtěl začít, jsou symlinky. Terraform má hodně opakujícího se kódu. Například volání poskytovatele je prakticky na každém místě, kde vytváříme kousek infrastruktury, stejné. A je logické to přesunout do samostatné složky. A všude tam, kde je potřeba poskytovatel, udělat symlinky na tento soubor.
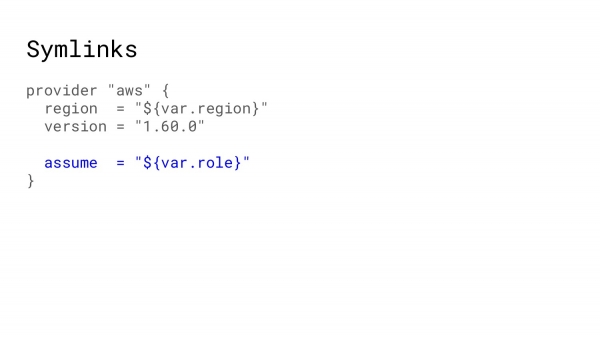
Například, pokud máte v produkci použitý assume role, který vám umožňuje získat přístupová práva k nějakému externímu Amazon účtu. A změnou jednoho souboru budou mít všechny zbylé soubory ve stromě zdrojů potřebná práva, aby Terraform věděl, na který Amazon segment se obrátit.
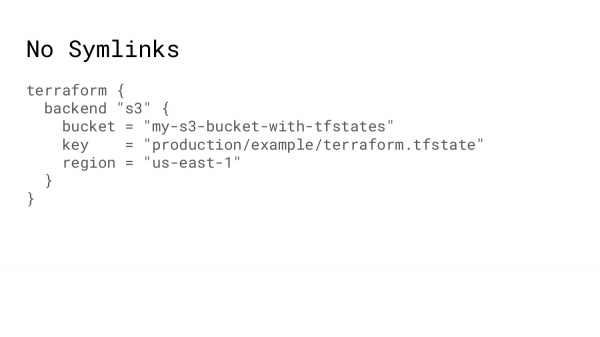
Kde symlinky nefungují? Jak jsem již řekl, v Terraform jsou stavové soubory. A ty jsou velmi, velmi skvělé. Ale problém je v tom, že Terraform inicializuje backend jako první. A nemůže používat jakékoliv proměnné v těchto parametrech, musíte je vždy psát jako text.
A jako výsledek, když někdo dělá nový zdroj, zkopíruje část kódu z jiných složek. A může se mýlit s klíčem nebo s bucketem. Například, vytváří ze sandboxu sandboxovou věc, a pak to dělá v produkci. A tak může nakonec být, že bucket v produkci bude používán ze sandboxu. Samozřejmě, to se rychle najde. Bude možné to nějak opravit, ale i tak to ztráta času a do určité míry zdrojů.
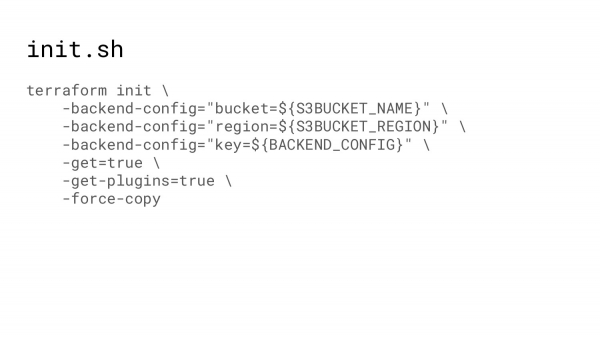
Co můžeme udělat dál? Než začneme pracovat s Terraform, musíme ho inicializovat. V okamžiku inicializace Terraform stáhne všechny pluginy. V určitém okamžiku se z monolitu rozpadly na více mikroservisní architekturu. A vždy je potřeba udělat Terraform init, aby stáhl všechny moduly, všechny pluginy.
Můžeme použít shell skript, který jednak dokáže získat všechny proměnné. Shell skript není ničím omezen. A za druhé, cesty. Pokud vždy používáme tu cestu, která je v repozitáři jako klíč k stavovému souboru, pak chyba zde bude vyloučena.
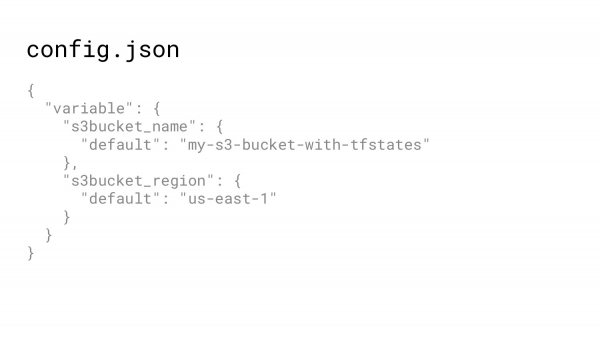
Odkud získat data? JSON soubor. Terraform umožňuje zapisovat infrastrukturu nejen v hcl (HashiCorp Configuration Language), ale také v JSON.
JSON je snadno čitelný ze shell skriptu. Odpovídajícím způsobem lze někde umístit konfigurační soubor s bucketem. A používat tento bucket jak v Terraform kódu, tak v shell skriptu pro inicializaci.
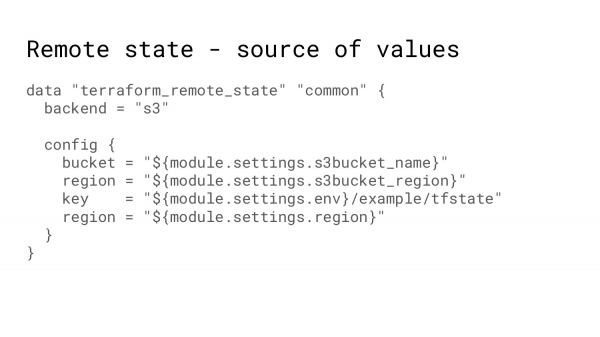
Proč je důležité mít bucket pro Terraform? Protože existuje něco jako vzdálené stavové soubory. To znamená, že když vytvářím nějaký zdroj, musím Amazone říct: „Prosím, zvedněte instance“, a k tomu je potřeba zadat spoustu povinných parametrů.
A tyto identifikátory jsou uloženy v nějakém jiném adresáři. Mohu říct: „Terraform, prosím běž do stavového souboru toho konkrétního zdroje a přines mi ty identifikátory“. Tímto způsobem dochází k určité unifikaci mezi různými regiony nebo prostředími.
Ne vždy je možné použít vzdálený stavový soubor. Například, pokud jste ručně vytvořili VPC. A ten Terraform kód, který vytváří VPC, vytváří natolik odlišný VPC, že budete muset dlouho přizpůsobovat jedno druhému, proto můžete použít následující trik.
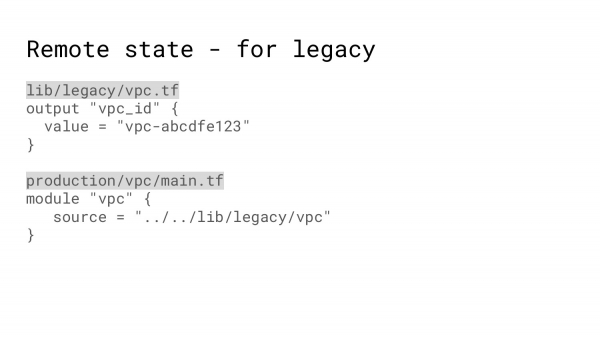
To znamená, vytvořit modul, který jakoby dělá VPC a jakoby vám dodává identifikátory, ale ve skutečnosti existuje soubor se zhardcodovanými hodnotami, který lze použít k vytvoření stejného instance.
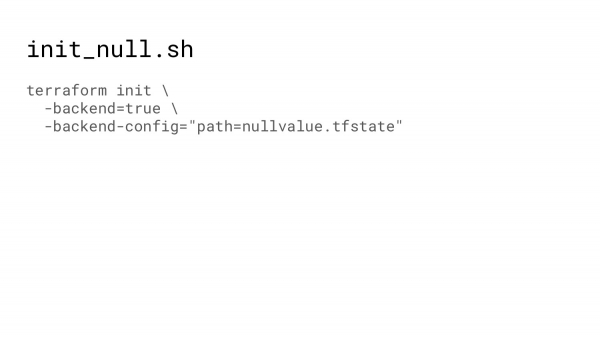
Není vždy potřeba uchovávat stavový soubor v cloudu. Například při testování modulů můžete použít inicializaci backendu, kdy bude soubor uchováván prostě na disku po dobu testování.
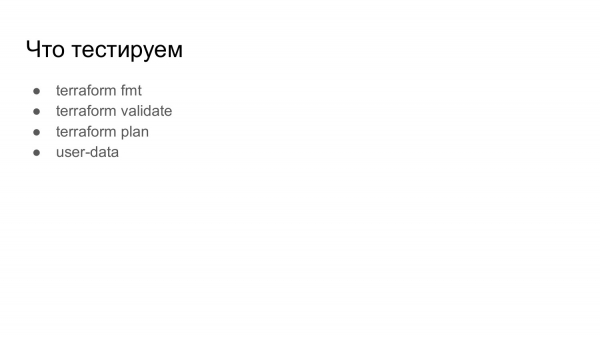
Teď něco málo o testování. Co se v Terraformu dá testovat? Pravděpodobně toho lze testovat hodně, ale budu mluvit o těchto čtyřech věcech.
HashiCorp má představu o tom, jak by měl být formátován Terraform kód. A Terraform fmt vám umožňuje naformátovat kód, který editujete, v souladu s touto vírou. Odpovídající testy by měly nutně zkontrolovat, zda formátování odpovídá tomu, co předal HashiCorp, abyste nemuseli měnit umístění závorek atd.
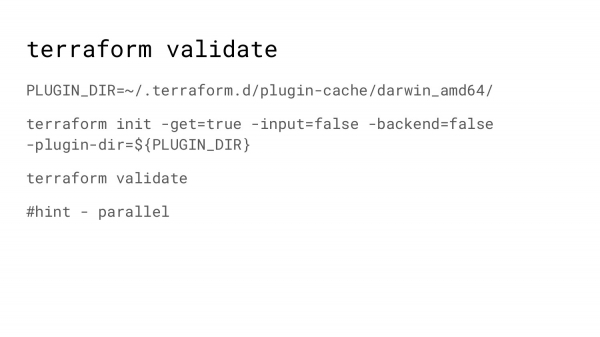
Další je Terraform validate. Dělá trochu více než jen kontrolu syntaxe – jako že jsou všechny závorky párové. Co je zde důležité? Naše infrastruktura je velmi rozsáhlá. Máme v ní spoustu různých adresářů. A v každém je potřeba spustit Terraform validate.
Abychom urychlili testování, spouštíme několik procesů paralelně, pomocí paralelní obsluhy.
Paralela je skvělá věc, využívejte ji.
Ale pokaždé, když se provádí inicializace Terraformu, jde na HashiCorp a ptá se: „Jaké jsou poslední verze pluginů? A ten plugin, který mám v cache – je ten nebo není?“ A to každým krokem způsobuje zpoždění.
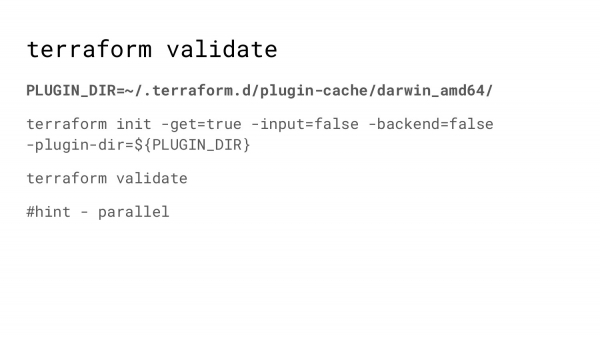
Pokud Terraformu řeknete, kde se pluginy nacházejí, řekne: „Ok, to je pravděpodobně to nejnovější, co máme. Nebudu chodit nikam jinam, rovnou začnu validovat váš Terraform kód.“
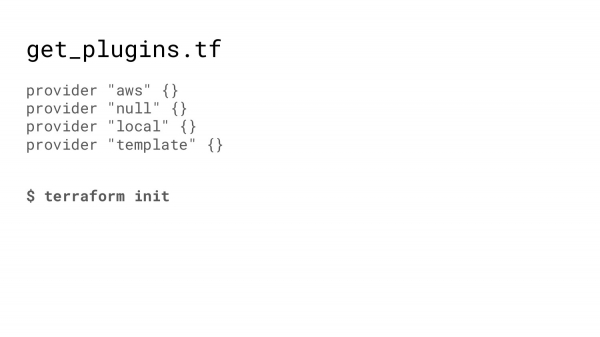
Abychom naplnili složku potřebnými pluginy, máme velmi jednoduchý Terraform kód, který je třeba pouze inicializovat. Samozřejmě zde musíme uvést všechny poskytovatele, kteří se nějakým způsobem podílejí na vašem kódu, jinak Terraform řekne: „Nevím o žádném poskytovateli, protože není v cache.“
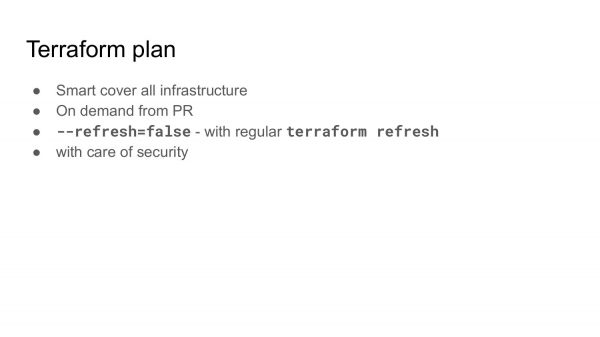
Dalším krokem je Terraform plan. Jak už bylo řečeno, vývoj je cyklický. Děláme kód se změnami a pak je třeba zjistit, jaké změny se plánují pro infrastrukturu.
A když je infrastruktura opravdu velmi velká, můžete změnit jeden modul, opravit nějaké testovací prostředí nebo nějaký konkrétní region a přitom zlomit něco sousedního. Proto by měl být Terraform plan proveden pro celou infrastrukturu a ukázat, jaké změny se plánují.
Dá se to udělat chytře. Například jsme napsali skript v Pythonu, který vyřeší závislosti. A v závislosti na tom, co bylo změněno: Terraform modul nebo jen nějaká konkrétní komponenta, vytváří plány pro všechny závislé složky.
Terraform plan by měl být prováděn na vyžádání. Minimálně to je to, co děláme my.
Testy je samozřejmě dobré provádět na každou změnu, na každý commit, ale plány jsou poměrně nákladná záležitost. A v pull requestu říkáme: „Prosím, dej mi plány.“ Spustí se robot a zašle v komentářích nebo jako přílohu všechny plány, které by měly vyplývat z vašich změn.
Plán je poměrně nákladný. Trvá to čas, protože Terraform jde do Amazonu a ptá se: „Existuje ještě tento instance? Má tento autoscale opravdu takové parametry?“ A aby se to urychlilo, můžete použít parametr jako refresh=false. To znamená, že Terraform stáhne ze S3 stav. A bude věřit, že stav bude přesně odpovídat tomu, co se nachází v Amazonu.
Tento Terraform plán probíhá mnohem rychleji, ale stav musí odpovídat vaší infrastruktuře, tzn. někde, někdy musí být spuštěn Terraform refresh. Terraform refresh dělá přesně to, aby stav odpovídal tomu, co existuje v reálné infrastruktuře.
A je potřeba zmínit bezpečnost. Tímto bych měl začít. Tam, kde spouštíte Terraform, a Terraform pracuje s vaší infrastrukturou, existuje zranitelnost. Tzn. v podstatě vykonáváte kód. A pokud pull request obsahuje nějaký škodlivý kód, může se vykonat na infrastruktuře, která má příliš mnoho přístupu. Proto buďte opatrní, kde spouštíte Terraform plán.
Dále, o čem bych chtěl mluvit, je testování user-data.
Co je to user-data? V Amazonu, když vytváříme instanci, můžeme z instance poslat určité zprávy – metadata. Když se instance spouští, obvykle je cloud init vždy přítomný na těchto instancích. Cloud init přečte tuto zprávu a říká: „Dobře, dnes jsem load balancer“. A v souladu s těmito příkazy provádí určité akce.
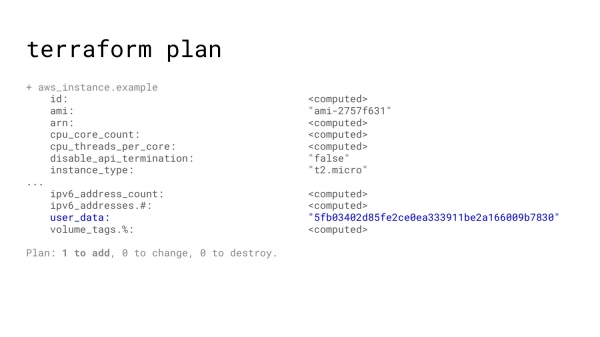
Ale bohužel, když provádíme Terraform plán a Terraform aplikaci, user-data vypadá jako taková kaše z čísel. Tzn. jednoduše vám pošle hash. A všechno, co můžete vidět v plánu, je, zda dojde k nějakým změnám nebo hash zůstane stejný.
A pokud si toho nevšimnete, na Amazonu může na reálnou infrastrukturu odejít nějaký poškozený textový soubor.
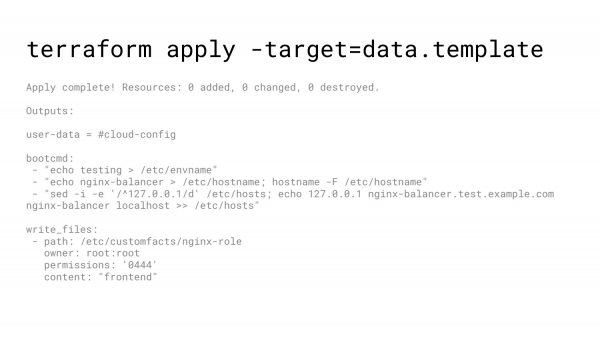
Jako alternativu můžete při provádění uvést nejen celou infrastrukturu, ale pouze šablonu. A v kódu říct: „Prosím, zobraz mi tuto šablonu“. A nakonec můžete získat výtisk, jak budou vypadat vaše data na Amazonu.
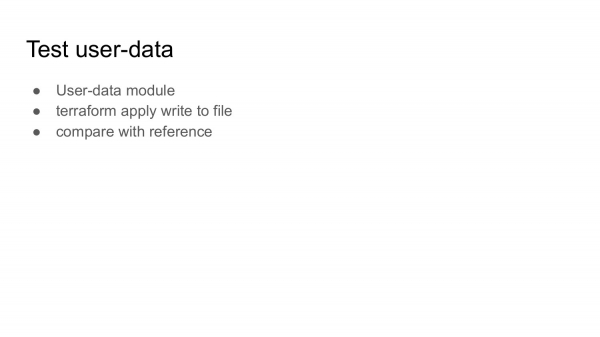
Další možností je použít modul pro generaci user-data. Tento modul aplikujete. Získáte soubor na disku. Porovnáte ho s referenčním. A tak, pokud se nějaký nováček rozhodne mírně upravit user-data, vaše testy řeknou: „Dobře, tady a tady jsou nějaké změny – to je v pořádku.“
Další téma, o kterém bych rád mluvil, je Automatizace Terraform apply.
Samozřejmě je docela děsivé provádět Terraform apply automaticky, protože kdo ví, jaké změny byly předneseny a jak destruktivní mohou být pro živou infrastrukturu.
Pro testovací prostředí je to naprosto v pořádku. Tedy job, který vytváří testovací prostředí, je to, co potřebují všichni vývojáři. A takový výrok jako „všechno mi fungovalo“ není vtipný mem, ale důkaz, že se člověk snažil, nasadil stack, spustil na tomto stacku nějaké testy. A ujistil se, že je vše v pořádku a řekl: „O.k., ten kód, který vydávám, byl otestován.“
Ve výrobním prostředí, sandboxu a dalších prostředích, která jsou pro podnikání důležitější, lze částečně aplikovat některé zdroje dostatečně bezpečně, protože to nevede k tomu, že by někdo zemřel. To jsou: autoscale skupiny, security skupiny, role, route53 a seznam může být dost dlouhý. Ale sledujte, co se děje, čtěte zprávy o automatických aplikacích.
Tam, kde je aplikace nebezpečná nebo se jí obáváte, například pokud se jedná o nějaké zdroje s persistentními databázemi, získávejte zprávy o tom, že v nějaké části infrastruktury jsou neaplikované změny. A inženýr pak už pod dozorem spouští jobs, aby je aplikoval, nebo to dělá ze své konzole.
Na Amazonu existuje něco jako ochrana před ukončením. A ta může v některých případech ochránit před nežádoucími změnami. Tedy Terraform přichází na Amazon a říká: „Potřebuji zabít tento instance, abych mohl vytvořit jiný.“ A Amazon odpovídá: „Omlouvám se, dnes ne. Mám ochranu před ukončením.“
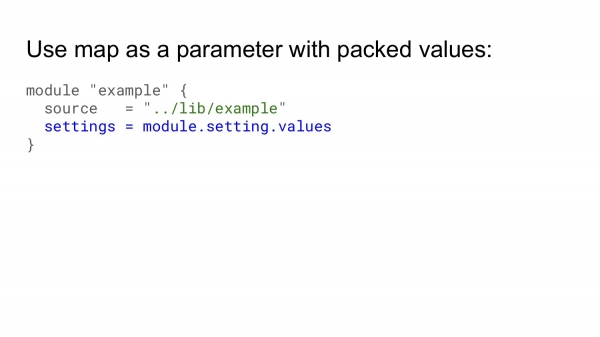
A třešnička na dortu – to je optimalizace kódu. Když pracujeme s Terraform kódem, musíme předat do modulu velmi velké množství parametrů. To jsou ty parametry, které jsou nezbytné pro vytvoření nějakého zdroje. A kód se stává velkými seznamy parametrů, které je třeba předat z modulu do modulu, z modulu do modulu, zejména pokud jsou moduly vnořené.
A to se velmi těžko čte. O to se velmi těžko provádí revize. A velmi často se stává, že nějaké parametry projdou revizí a nejsou zcela tím, co je potřeba. A to stojí čas a peníze, abychom to pak opravili.
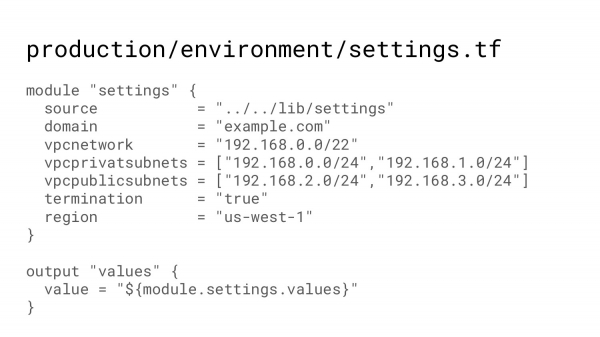
Proto vám navrhuji použít něco jako komplexní parametr, který zahrnuje jakési stromové hodnoty. Tedy potřebujete nějakou složku, kde máte uvedeny všechny hodnoty, které byste chtěli mít na nějakém prostředí.
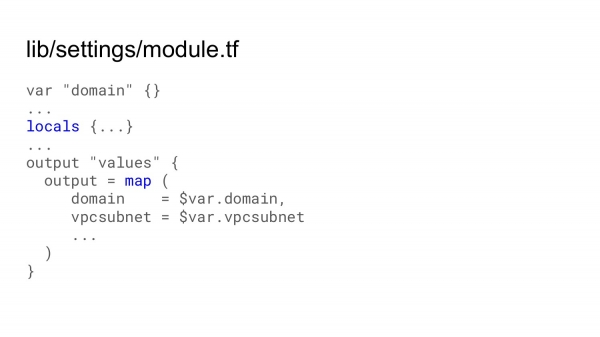
A použitím tohoto modulu lze získat strom, který se generuje v jednom obecném modulu, tj. v obecném modulu, který funguje stejně pro celou infrastrukturu.
V tomto modulu lze provádět určité výpočty s využitím nové funkce v Terraformu, jako jsou locals. A poté jedním outputem poskytnout nějaký složitý parametr, který může zahrnovat hash a pole atd.
Tímto mám na mysli všechny nejlepší nálezy, které mám. A rád bych vyprávěl pohádku o Kolumbovi. Když hledal peníze na svou expedici, aby objevil Indii (jak si tenkrát myslel), nikdo mu nevěřil a považovali to za nemožné. Tehdy řekl: „Udělte tak, aby se vejce nesflattenilo.“ Všichni bankéři, velmi bohatí a pravděpodobně chytří lidé, se snažili vejce nějak postavit, ale pořád padalo. Poté Kolumbus vzal vejce, trochu na něj zatlačil. Šlupka se zmáčkla a vejce zůstalo stát. Řekli: „Oh, to je příliš jednoduché!“. A Kolumbus odpověděl: „Ano, je to příliš jednoduché. A když otevřu Indii, všichni budou používat tuto obchodní cestu.“
A to, co jsem vám teď řekl, jsou pravděpodobně dost jednoduché a triviální věci. A když o nich zjistíte a začnete je používat, je to v pořádku. Takže jich využijte. A pokud jsou to pro vás normální věci, aspoň víte, jak postavit vejce, aby nespadlo.
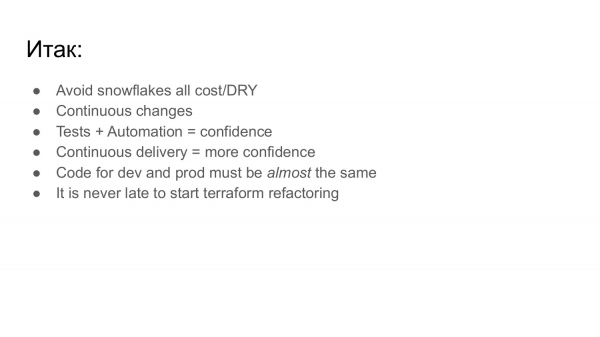
Shrneme to:
- Snažte se vyhnout sněhovým vločkám. A čím méně sněhových vloček, tím méně zdrojů budete potřebovat, abyste provedli nějaké změny ve vaší velké infrastruktuře.
- Stálé změny. Tj. když dojde ke změnám v kódu, je třeba co nejrychleji uvést vaši infrastrukturu do souladu s těmito změnami. Neměla by nastat situace, kdy někdo přijde za dva až tři měsíce, aby se podíval na Elasticsearch, provede Terraform plan a tam je spousta změn, které neočekával. A zabere to spoustu času, aby se vše opět uvedlo do pořádku.
- Testy a automatizace. Čím více máte kód pokrytý testy a funkcemi, tím více máte jistotu, že děláte vše správně. A automatizované dodání zvyšuje vaši důvěru mnohonásobně.
- Kód pro testovací a produkční prostředí by měl být prakticky stejný. Prakticky, protože produkce je přece jen trochu jiná a budou tam určité nuance, které přesahují rámec testovacího prostředí. Nicméně, plus minus je možné to zajistit.
- A pokud máte hodně Terraform kódu a na jeho udržování v aktuálním stavu potřebujete spoustu času, nikdy není pozdě na refactoring a přivést ho do pořádku.
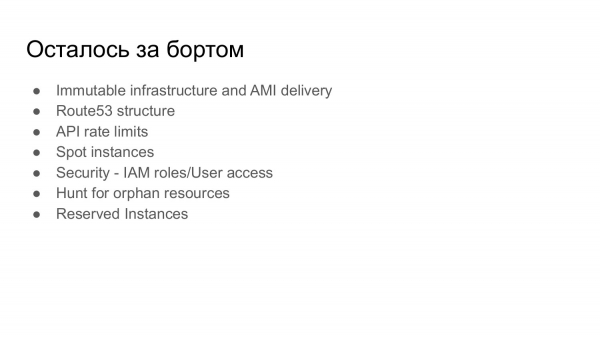
- Immutable infrastructure. Dostava AMI podle plánu.
- Struktura pro route53, když máte hodně záznamů a chcete, aby byly v jednotném pořadí.
- Boj s API rate limits. To je, když Amazon říká: „Všechno, všechno, více nemohu přijímat, prosím, počkejte.“ A polovina firmy čeká, dokud nebude moci spustit svou infrastrukturu.
- Spot instances. Amazon není levná záležitost a spoty umožňují značně ušetřit. O tom by se dalo přednést celé vystoupení.
- Bezpečnost a IAM role.
- Hledání ztracených zdrojů, když máte v Amazonu instance nejasného původu, které spotřebovávají peníze. I když instance stojí 100-150 dolarů měsíčně – za rok je to přes 1 000. Hledání takových zdrojů je výnosné.
- A rezervované instance.
Na tom mám vše. Terraform je opravdu skvělý, používejte ho. Děkuji!
Otázky
Děkuji za prezentaci! Váš state soubor leží v S3, jak řešíte problém, že několik lidí může vzít tento state soubor a pokusit se nasadit?
Za prvé, nespěcháme. Za druhé, máme flagy, ve kterých oznamujeme, že pracujeme na nějaké části kódu. Tedy, i když je infrastruktura velmi velká, neznamená to, že někdo něco neustále aplikuje. Když byla aktivní fáze – to byl problém, naše state soubory byly uloženy v Gitu. Bylo to důležité, jinak by někdo vytvořil state soubor a museli jsme je ručně sbírat do kupy, aby všechno pokračovalo. Teď tento problém není. A vůbec, Terraform tuto úlohu vyřešil. A pokud se něco neustále mění, můžete použít zámky, které brání tomu, co jste zmínili.
Používáte otevřenou verzi nebo enterprise?
Žádné enterprise, tedy vše, co si můžete stáhnout zdarma.
Jmenuji se Stanislav. Chtěl jsem udělat malou poznámku. Hovořili jste o funkci Amazon, která umožňuje, aby byl instance nezničitelný. To je také v samotném Terraformu, v bloku Life Second můžete zapsat zákaz na změnu nebo zákaz na zničení.
Měl jsem časové omezení. Dobrý postřeh.
Chtěl jsem se také zeptat na dvě věci. Zaprvé, zmínili jste se o testování. Používali jste nějaké nástroje pro testování? Slyšel jsem o pluginu Test Kitchen. Možná existuje i něco jiného. A chtěl bych se také zeptat na Local Values. Čím se v zásadě liší od Input Variables? A proč nemohu parametrizovat něco jen přes Local Values? Snažil jsem se s touto tématem pochopit, ale nějak jsem se v tom nevyznal.
O tomto můžeme podrobněji mluvit za tímto sálem. Nástroje pro testování - to máme úplně domácí. Tam není nic, co by nám umožnilo testovat. V zásadě existují možnosti, kdy automatické testy zvedají infrastrukturu někde, kontrolují, že je v pořádku, a pak všechno zničí s reportem, že vaše infrastruktura je stále v dobré kondici. To u nás není, protože testovací steky se spouštějí každý den. A to je dost. A pokud se něco začne rozpadat, začne se to rozpadat, aniž bychom to ještě někde zkontrolovali.
Pokud jde o Local Values, pojďme pokračovat v rozhovoru za sálem.
Ahoj! Děkuji za přednášku! Bylo to velmi informativní. Mluvil jsi o tom, že máte hodně uniformního kódu pro popis infrastruktury. Nezvažovali jste možnost generování tohoto kódu?
Skvělá otázka, děkuji! Věc je taková, že když používáme infrastrukturu jako kód, předpokládáme, že se díváme na kód a rozumíme, jaká infrastruktura za tímto kódem leží. Pokud je kód generován, musíme si představit, jaký kód bude vygenerován, abychom pochopili, jaká infrastruktura tam bude. Buď generujeme kód, commiteme ho a v podstatě se dostáváme k tomu samému. Proto jsme šli cestou, jak jsme to napsali, dostali jsme to. Navíc generátory se objevily o něco později, když jsme začali dělat. A už bylo pozdě na změnu.
Slyšel jsi něco o jsonnet?
Ne.
Podívej, to je velmi skvělá věc. Vidím konkrétní případ, kde bychom to mohli aplikovat a generovat datovou strukturu.
Generátory jsou dobré, když máte, jako v anekdotě o holicím strojku. Tedy prvně je obličej různý, ale pak mají všichni obličej stejný. Generátory jsou velmi příjemné. Ale bohužel, naše obličeje jsou trochu jiné. To je problém.
Jen se podívej. Děkuji!
Jmenuji se Maxim, jsem ze Sberbank. Trochu jste řekli, že jste se snažili přizpůsobit Terraform analogii programovacího jazyka. Nebylo by jednodušší používat Ansible?
To jsou velmi různé věci. Lze pomocí Ansible vytvářet zdroje a Puppet také dokáže vytvářet zdroje v Amazonu. Ale Terraform je přímo na to zaměřen.
Máte jen Amazon?
Nejde o to, že máme jen Amazon. Máme téměř jen Amazon. Ale klíčovou funkcí je, že Terraform si pamatuje. V Ansible, když řeknete: "Zvedni mi 5 instance", tak je zvedne, a pak řeknete: "A teď potřebuji 3". A Terraform řekne: "Dobře, 2 zruším", zatímco Ansible řekne: "Dobře, tady máš 3". Celkem 8.
Dobrý den! Děkuji za vaši přednášku! Bylo velmi zajímavé poslouchat o Terraformu. Hned chci dát malý komentář k tomu, že Terraform přece jen nemá stabilní verzi, takže k Terraformu přistupujte s velkou opatrností.
Dobrá lžíce ke obědu. Tedy pokud potřebujete řešení, někdy odložíte to, co je nestabilní apod., ale funguje to a pomohlo nám.
Mám otázku. Používáte Remote backend, používáte S3. Proč nepoužíváte oficiální backend?
Oficiální?
Terraform Cloud.
Kdy se objevil?
Před 4 měsíci.
Kdyby se objevil před 4 lety, pravděpodobně bych odpověděl na vaši otázku.
Již má vestavěnou funkci a zámky, a můžete uchovávat state-file. Zkuste to. Ale ani já jsem to netestoval.
Jedeme ve velkém vlaku, který jede velkou rychlostí. A nemůžete jen tak vzít a vyhodit několik vagonů.
Mluvili jste o sněhových vločkách, a proč jste nepoužili branch? Proč se to nepodařilo tak udělat?
Máme přístup, že celá infrastruktura je v jednom repozitáři. Terraform, Puppet, všechny skripty, které se nějak týkají tohoto, jsou všechny v jednom repozitáři. Tímto způsobem můžeme zaručit, že inkrementální změny jsou testovány jedna po druhé. Kdyby to byly hromady branchí, byl by takový projekt prakticky neudržovatelný. Uplynou půl roku a rozcházejí se tak, že je to prostě trest. To je to, od čeho jsem chtěl utéct, až do refaktoringu.
Tedy to nefunguje?
To vůbec nefunguje.
V branchi jsem odstranil snímek složky. Tedy pokud bychom vytvořili pro každou testovací větev, například tým A – mají svou složku, tým B má svou složku, pak to také nefunguje. Vytvořili jsme jednotný kód testovacího prostředí, který byl dostatečně flexibilní, aby vyhovoval všem. Tedy jsme spravovali jeden kód.
Ahoj! Jmenuji se Jura! Děkuji za prezentaci! Mám otázku ohledně modulů. Říkáte, že používáte moduly. Jak řešíte situaci, když někdo v jednom modulu provede změny, které nejsou kompatibilní se změnou druhé osoby? Nějak verzujete moduly, nebo se snažíte přizpůsobit vynález, abyste splnili dvě požadavky?
Je to problém velkého sněhuláka. To je, co nás trápí, když nějaká neškodná změna může rozbít nějakou část infrastruktury. A to bude patrné až po nějaké době.
Tedy zatím to není řešeno?
Děláte univerzální moduly. Vyhýbejte se sněhovým vločkám. A všechno bude fungovat. Druhá polovina prezentace je o tom, jak tomu zabránit.
Dobrý den! Děkuji za prezentaci! Chtěl bych upřesnit. Zůstala zde velká hromada, kvůli které jsem přišel. Jakým způsobem jsou integrovány Puppet a rozdělení rolí?
User-data.
Tedy jen vypustíte soubor a podle něj nějak provádíte?
User-data – to je poznámka, tedy když vytváříme klon obrazu, tak se tam spustí Daemon a snaží se pochopit, kým je, a čte poznámku, že je load balancer.
Tedy je to nějaký samostatný proces, který se vrací?
Nebyli jsme ti, kdo to vynalezli. Používáme to.
Dobrý den! Mám otázku ohledně User-data. Říkali jste, že tam jsou problémy, že někdo může něco poslat špatně. Je nějaký způsob, jak uchovávat user-data ve stejném Gitu, aby bylo vždy jasné, na co se odkazuje User-data?
User-data generujeme z template. To znamená, že se tam dostane nějaký počet proměnných. A Terraform generuje finální výsledek. Proto se nedá jen tak podívat na template a říct, co vznikne, protože všechny problémy vznikají z toho, že vývojář si myslí, že do této proměnné předává řetězec, ale ve skutečnosti se dostává pole. A on najednou – bum, a já – ten a ten, následující řetězec, a všechno se rozpadne. Pokud je to nový zdroj a člověk jej spouští, sleduje, že něco nefunguje, tak se to rychle vyřeší. Ale pokud se aktualizovala autoscale skupina, tak v určitém okamžiku se instance v autoscale skupině začnou měnit. A bum, něco nefunguje. To je frustrující.
Znamená to, že jediné řešení je testovat?
Ano, vidíte problém, přidáte tam testovací kroky. To znamená, že lze také testovat output. Možná to není tak pohodlné, ale můžete také nastavit nějaké značky – zkontrolujte, že User-data je tady přibita hřebíky.
Jmenuji se Timur. Je skvělé, že existují přednášky o tom, jak správně organizovat Terraform.
Ještě jsem ani nezačal.
Myslím, že na příští konferenci možná bude. Mám jednoduchou otázku. Proč hardcodíte hodnotu v samostatném modulu, a nepoužíváte tfvars, to znamená, čím je lepší modul se hodnotami než tfvars?
To znamená, že tady (snímek: Production/environment/settings.tf) napíšu: domain = proměnná, domain vpcnetwork, proměnná vpcnetwork a stvars – také získat totéž?
Děláme to přesně takto. Odkazujeme na modul setting source, například.
V podstatě je to takový tfvars. Tfvars je velmi pohodlný v testing prostředí. Mám tfvars pro velké instance, pro malé. A hodím jeden soubor do složky. A dostanu to, co jsem chtěl. Když stavíme infrastrukturu, chceme, aby bylo možné se podívat a okamžitě vše pochopit. A tak se ukazuje, že je potřeba se podívat sem, pak se podívat do tfvars.
Znamená to, aby bylo vše na jednom místě?
Ano, tfvars – to je, když máte jeden kód. A ten je používán na několika různých místech s různými nuancemi. Pak byste tfvars hodili a získali své nuance. A my – to je infrastruktura jako kód v čisté podobě. Podíval jste se a pochopil.
Ahoj! Setkal jste se někdy se situacemi, kdy cloudový poskytovatel zasahuje do toho, co jste udělali pomocí Terraformu? Řekněme, upravujeme metadata. Tam jsou ssh klíče. A Google tam neustále cpuje svá metadata, své klíče. A Terraform neustále píše, že má změny. Po každém běhu, i když se nic nemění, vždy říká, že toto pole bude aktualizovat.
S klíči, ano, část infrastruktury je zasažena tímto problémem, tj. Terraform nemůže nic změnit. My také nemůžeme nic změnit ručně. Zatím s tím žijeme.
Tedy, setkal jste se s tím, ale nic jste nevymysleli, on to dělá znovu a znovu sám?
Bohužel, ano.
Ahoj! Jmenuji se Stanislav Starkov. Mail.ru Group. Jak řešíte problém s generováním tagu na ..., jak ho předáváte dovnitř? Chápu to správně, že přes User-data, abyste uvedli host name, nasměrovali Puppet? A druhá část otázky. Jak řešíte tuto otázku v SG, tj. když generujete SG, stovka podobných instancí, jak je správně pojmenovat?
Ty instance, které jsou pro nás velmi důležité, pojmenováváme hezky. Ty, které nejsou potřeba, mají příponu, že to je autoscale-skupina. A ideálně to lze ukončit a získat nové.
Pokud jde o problém s tagem, tak není takový problém, ale je to takový úkol. A tagy máme velmi, velmi silně používány, protože infrastruktura je velká a drahá. Musíme se dívat, na co jdou peníze, proto tagy umožňují zjistit, co a kam šlo. A tedy hledání toho, na co se utrácí hodně peněz.
O čem byl ještě další dotaz?
Když SG vytváří stovku instancí, je potřeba je nějak odlišit?
Ne, není potřeba. Na každé instanci je agent, který hlásí, že mám problém. Pokud agent hlásí, agent o něm ví a minimálně jeho IP adresa existuje. Už lze utíkat. Dále používáme Consul pro Discovery tam, kde není Kubernetes. A Consul také ukazuje IP adresu instance.
Tedy, orientujete se právě podle IP, a ne podle host name?
Není možné se orientovat podle host name, je jich příliš mnoho. Existují identifikátory instance – AE atd. Ten lze někde najít, můžete ho hodit do vyhledávání.
Ahoj! Pochopil jsem, že Terraform je skvělá věc, určená pro cloudy.
Nejen to.
Toto je otázka, která mě zajímá. Pokud se rozhodnete přecházet, dejme tomu, na Bare Metal ve velkém se všemi svými instancemi? Nebudou žádné problémy? Anebo se bude muset použít jiné produkty, například ten zmíněný Ansible?
Ansible je o něčem jiném. Tedy Ansible funguje až poté, co se instance spustila. Terraform funguje před tím, než se instance spustila. Přechod na Bare Metal – ne.
Teď ne, ale přijdou obchodníci a řeknou: 'Jdeme na to.'
Přechod na jinou cloudovou službu – ano, ale tady je to trošku jiná záležitost. Je potřeba napsat Terraform kód tak, aby bylo možné s menšími obtížemi přejít na jiný cloud.
Původně byla stanovena taková úloha, že naše celá infrastruktura by měla být agnostická, tedy jakýkoli cloud by měl vyhovovat, ale v určitém okamžiku se byznys vzdal a řekl: 'Dobře, v nejbližších N letech nikam neodejdeme, můžeme používat služby od Amazonu.'
Terraform umožňuje vytvářet frontendová zaměstnání, konfigurovat PagerDuty, datové dokumenty atd. Má toho opravdu spoustu. V podstatě může kontrolovat celý svět.
Děkuji za přednášku! Já také už 4 roky pracuji s Terraformem. Během plynulého přechodu k Terraformu, k infrastruktuře, k deklarativnímu popisu, jsme se setkávali se situací, kdy někdo něco dělá ručně, a vy se snažíte udělat plán. A dostanete tam nějakou chybu. Jak řešíte takové problémy? Jak nacházíte ztracené zdroje, které byly uvedeny?
Hlavně rukama a očima, pokud vidíme v reportu něco podivného, tak analyzujeme, co se tam děje, nebo to prostě odstraníme. A vůbec, pull requesty – to je běžná věc.
Pokud se objeví chyba, děláte rollback? Zkoušeli jste to už?
Ne, to je rozhodnutí člověka v tu chvíli, kdy vidí problém.
Zdroj: habr.com
