

V tomto článku vám povím, jak se projekt, na kterém pracuji, proměnil z velkého monolitu na soubor mikroslužeb.
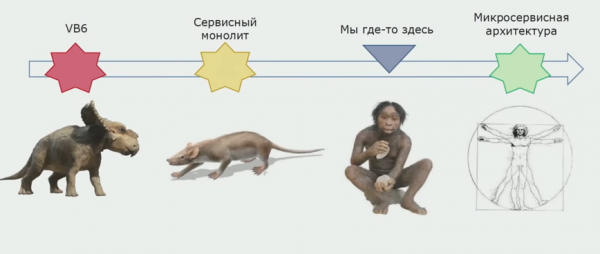
Projekt začal svou historii poměrně dávno, na začátku 2000. První verze byly napsány na Visual Basic 6. S postupem času se ukázalo, že vývoj v tomto jazyce bude v budoucnu obtížně udržovatelný, jelikož IDE i samotný jazyk se vyvíjejí pomalu. Na konci 2000. let bylo rozhodnuto přejít na perspektivnější C#. Nová verze se psala paralelně s vylepšováním staré, postupně byl stále větší objem kódu v .NET. Backend na C# byl původně orientován na službovou architekturu, avšak při vývoji se používaly společné knihovny s logikou, a služby se spouštěly v jednom procesu. Vznikla aplikace, kterou jsme nazvali „servisní monolit“.
Jedním z mála výhod takové kombinace byla možnost, aby se služby vzájemně vyvolávaly prostřednictvím externího API. Byly jasné předpoklady pro přechod na správnější službovou, a v budoucnu i mikroslužbovou architekturu.
Naše práce na dekompozici začala přibližně v roce 2015. I když jsme ještě nedosáhli ideálního stavu — zůstaly části velkého projektu, které už těžko nazvat monolity, ale ani mikroslužbami nepřipomínají. Přesto však pokrok je zásadní.
O tom se zmíním v tomto článku.
Obsah
Architektura a problémy stávajícího řešení
Původně architektura vypadala následovně: UI — samostatná aplikace, monolitická část napsaná na Visual Basic 6, aplikace na .NET představovala soubor vzájemně propojených služeb, pracujících s poměrně velkou databází.
Nevýhody předchozího řešení
Jednotný bod selhání
Měli jsme jediný bod selhání: aplikace na .NET běžela v jednom procesu. Pokud v některém z modulů došlo k chybě, selhalo celé aplikace a muselo se restartovat. Vzhledem k tomu, že automatizujeme velké množství procesů pro různé uživatele, kvůli selhání v jednom z nich nemohli nějakou dobu pracovat všichni. A při programové chybě nepomohlo ani zálohování.
Fronta změn
Tato nevýhoda je spíše organizační. V naší aplikaci je mnoho zákazníků a všichni chtějí změny co nejdříve. Dříve to bylo nemožné provádět paralelně, a všichni zákazníci se museli postavit do fronty. Tento proces vzbuzoval v podnikání negativní emoce, protože museli prokazovat, že jejich úkol má hodnotu. A vývojový tým strávil čas organizováním této fronty. To zabíralo mnoho času a sil, a produkt nakonec nemohl měnit tak rychle, jak by po něm chtěli.
Neoptimální využití zdrojů
Při nasazení služeb v jednotném procesu jsme vždy plně kopírovali konfiguraci ze serveru na server. Chtěli jsme umístit nejvíce zatížené služby zvlášť, abychom neplýtvali zdroji a získali pružnější řízení naší škálování.
Těžké zavádění moderních technologií
Známa problém, který všichni vývojáři znají: existuje touha zavést moderní technologie do projektu, ale není na to možnost. Při velkém monolitickém řešení se každá aktualizace aktuální knihovny, nemluvě o přechodu na novou, stává poměrně nejednoduchým úkolem. Dlouho je potřeba dokazovat týmovému vedoucímu, že to přinese více výhod, než strávených nervů.
Složitost vydávání změn
To byla nejzávažnější problém — vydávali jsme verze každé dva měsíce.
Každé vydání se stalo skutečnou katastrofou pro banku, navzdory testování a úsilí vývojářů. Podnikání chápalo, že na začátku týdne nebude fungovat část funkčnosti. A vývojáři si uvědomovali, co je čeká, vážný týden incidentů.
Všichni měli touhu situaci změnit.
Očekávání od mikroslužeb
Vydávání komponentů podle připravenosti. Vydávání komponentů podle připravenosti díky dekompozici řešení a oddělení různých procesů.
Malé produktové týmy. To je důležité, protože s velkým týmem pracujícím na starém monolitu je těžké řídit. Takový tým byl nucen pracovat podle přísného procesu, zatímco by chtěl více kreativity a nezávislosti. To si mohly dovolit pouze malé týmy.
Izolace služeb v oddělených procesech. Ideálně bychom chtěli izolovat do kontejnerů, ale velké množství služeb napsaných na .NET Framework běží pouze pod Windows. V současnosti se objevují služby na .NET Core, ale těch je zatím málo.
Flexibilita nasazení. Chtěli bychom kombinovat služby tak, jak to potřebujeme, a ne tak, jak to vyžaduje kód.
Využití nových technologií. To zajímá každého programátora.
Problémy s přechodem
Samozřejmě, kdyby bylo snadné rozdělit monolit na mikroslužby, nemuseli bychom o tom mluvit na konferencích a psát články. V tomto procesu je mnoho úskalí, popíšu hlavní, která nám bránila.
První problém je typický pro většinu monolitů: provázanost obchodní logiky. Když píšeme monolit, chceme znovu používat naše třídy, abychom nenapsali zbytečný kód. Ale při přechodu na mikroslužby se to stává problémem: celý kód je dost pevně spojen a je těžké služby rozdělit.
V době zahájení prací bylo v repozitáři více než 500 projektů a více než 700 tisíc řádků kódu. To je dost velké řešení a druhý problém. Jednoduše vzít a rozdělit to na mikroslužby nebylo možné.
Třetí problém je nedostatek potřebné infrastruktury. V podstatě jsme se zabývali ručním kopírováním zdrojového kódu na servery.
Jak přejít od monolitu k mikroslužbám
Vyčlenění mikroslužeb
Za prvé, hned jsme si určili, že rozdělení mikroslužeb je iterativní proces. Od nás se vždy vyžadovalo současně vyvíjet obchodní úlohy. Jak to provedeme technicky — to už je náš problém. Takže jsme se připravovali na iterativní proces. Jinak to nepůjde, pokud máte velkou aplikaci a nebyla původně připravena na to, aby se přepisovala.
Jaké máme způsoby pro vyčlenění mikroslužeb?
První způsob — vyčleňovat stávající moduly jako služby. V této souvislosti jsme měli štěstí: již existovaly služby, které pracovaly na protokolu WCF. Byly rozděleny do samostatných sestavení. Přenášeli jsme je jednotlivě, přidávali k každé sestavení malý spouštěcí modul. Ten byl napsán s pomocí úžasné knihovny Topshelf, která umožňuje spouštět aplikaci jak jako službu, tak jako konzoli. To je praktické pro ladění, protože to nevyžaduje žádné další projekty v řešení.
Služby byly propojeny na základě obchodní logiky, protože používaly společná sestavení a pracovaly se společnou databází. Těžko je bylo nazvat čistými mikroservisy. Nicméně, tyto služby jsme mohli poskytovat odděleně, v různých procesech. Už to umožnilo snížit vzájemný vliv, čímž se vyřešil problém s paralelním vývojem a jediným bodem selhání.
Sestavení s hostitelem je pouze jeden řádek kódu ve třídě Program. Práci s Topshelf jsme skryli ve pomocné třídě.
namespace RBA.Services.Accounts.Host
{
   internal class Program
   {
      private static void Main(string[] args)
      {
        HostRunner.Run("RBA.Services.Accounts.Host");

       }
    }
}
Druhý způsob vyčlenění mikroservisů: vytvářet je pro vyřešení nových úkolů. Pokud monolit přitom neroste, už to je skvělé, znamená to, že se ubíráme správným směrem. Pro řešení nových úkolů jsme se snažili vytvářet samostatné služby. Pokud to bylo možné, vytvářeli jsme více "kanonické" služby, které plně spravují svůj datový model a oddělenou databázi.
My, jako mnoho jiných, jsme začínali se službami autentizace a autorizace. Ty se pro tento účel ideálně hodí. Jsou nezávislé, obvykle mají oddělený datový model. Sami neinteragují s monolitem, pouze se s ním spojí pro vyřešení nějakých úkolů. Na těchto službách lze začít přechod na novou architekturu, otestovat na nich infrastrukturu, vyzkoušet nějaké přístupy související se síťovými knihovnami, atd. V naší organizaci nejsou týmy, které by nedokázaly vytvořit službu autentizace.
Třetí způsob vyčlenění mikroservisů, který používáme, je pro nás trochu specifický. Jedná se o oddělení byznys logiky od uživatelského rozhraní. Naše hlavní uživatelská aplikace je desktopová, stejně jako backend je napsána v C#. Vývojáři se čas od času dopouštěli chyb a přenášeli do UI části logiky, které měly existovat v backendu a být znovu využitelné.
Pokud se podíváme na skutečný příklad z kódu uživatelské části, vidíme, že většina tohoto řešení obsahuje skutečnou byznys logiku, která je užitečná v jiných procesech, nejen pro vytváření uživatelského rozhraní.
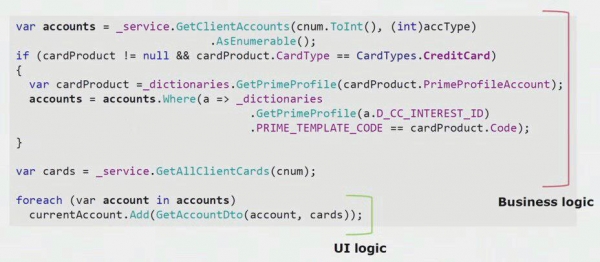
Skutečná logika uživatelského rozhraní je tam jen v posledních dvou řádcích. Přesunuli jsme ji na server, abychom ji mohli znovu využít, čímž jsme zmenšili uživatelské rozhraní a dosáhli správné architektury.
Čtvrtý, nejdůležitější způsob, jak oddělit mikroslužby, který umožňuje snižovat monolit, je přenesení existujících služeb s přepracováním. Když přenášíme existující moduly tak, jak jsou, výsledek se vývojářům ne vždy líbí a byznys proces mohl časem zastarat. Díky refaktoringu můžeme podpořit nový byznys proces, protože požadavky podnikání se neustále mění. Můžeme vylepšit původní kód, odstranit známé defekty a vytvořit kvalitnější datový model. Získáváme mnoho výhod.
Oddělení služeb s přepracováním je nerozlučně spojeno s konceptem omezeného kontextu. Tento koncept pochází z objektově orientovaného návrhu. Označuje část doménového modelu, ve které jsou všechny termíny jednotného jazyka jednoznačně definovány. Uvedeme na příkladu kontextu pojištění a účtů. Máme monolitní aplikaci a je třeba v pojištění pracovat s účtem. Očekáváme, že vývojář najde v jiné sestavě existující třídu „Účet“, odkazuje na ni z třídy „Pojištění“ a my dostaneme fungující kód. Principe DRY bude dodrženo, úkol bude díky využití existujícího kódu splněn rychleji.
Ukazuje se, že kontexty účtů a pojištění jsou propojené. Jakmile se objeví nové požadavky, toto spojení zkomplikuje vývoj a zvýší složitost již tak složité obchodní logiky. Pro řešení tohoto problému je třeba v kódu nalézt hranice mezi kontexty a odstranit jejich porušení. Například kontextu pojištění bude pravděpodobně stačit 20miístné číslo účtu ČNB a datum otevření účtu.
Abychom tyto omezené kontexty oddělili a zahájili proces vyčleňování mikroslužeb z monolitického řešení, použili jsme přístup, jehož základem je vytváření externích API uvnitř aplikace. Pokud jsme věděli, že by se nějaký modul měl stát mikroslužbou a nějak se měnit v rámci procesu, ihned jsme prováděli volání logiky, která patří do jiného omezeného kontextu, prostřednictvím externích výzev. Například pomocí REST nebo WCF.
Rozhodli jsme se, že se nebudeme vyhýbat kódu, který bude vyžadovat provádění distribuovaných transakcí. V našem případě se ukázalo, že dodržovat toto pravidlo je dost snadné. Dosud nenastaly situace, kdy by byly opravdu potřebné tvrdé distribuované transakce — stačí konečná konzistence mezi moduly.
Zvažme konkrétní příklad. Máme pojem orchestrátora — potrubí, které zpracovává entitu „žádosti“. Postupně vytváří klienta, účet a bankovní kartu. Pokud jsou klient a účet úspěšně vytvořeny, ale vytvoření karty selže, žádost nepřejde do stavu „úspěšně“ a zůstane ve stavu „kartě nebyla vytvořena“. V budoucnu tuto žádost zpracuje pozadí a dokončí ji. Systém je nějakou dobu v nesourodém stavu, ale celkově nás to uspokojuje.
Pokud přece jen nastane situace, kdy bude třeba souhlasně uložit část dat, pravděpodobně přistoupíme ke zvětšení služby, abychom to zpracovali v jednom procesu.
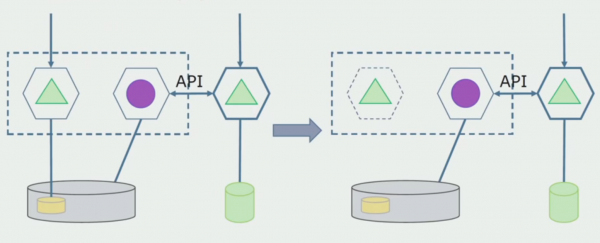
Zvažme příklad vyčlenění mikroslužby. Jakým způsobem lze relativně bezpečně dostat tuto mikroslužbu do produkce? V tomto příkladu máme samostatnou část systému — modul výplaty, z jehož části kódu bychom chtěli vytvořit mikroslužbu.
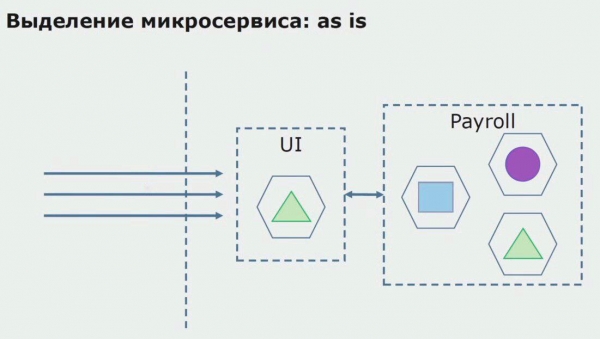
Nejdříve vytvoříme mikroslužbu přepsáním kódu. Zlepšujeme některé aspekty, které nám nevyhovovaly. Implementujeme nové obchodní požadavky od zákazníka. Přidáváme do spojení mezi UI a backendem API Gateway, který zajistí zprostředkování volání.
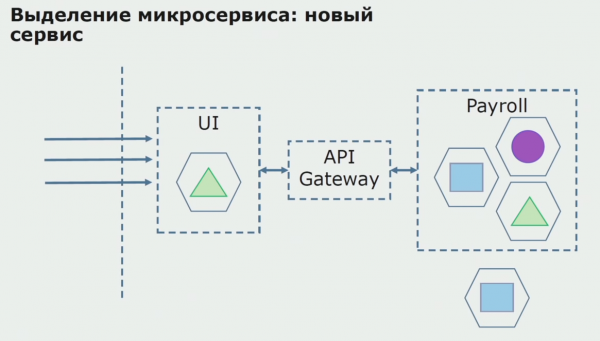
Následně nasazujeme tuto konfiguraci do provozu, ale v pilotním stavu. Většina uživatelů stále pracuje se starými obchodními procesy. Pro nové uživatele vyvíjíme novou verzi monolitické aplikace, která tento proces již neobsahuje. V podstatě máme v pilotním režimu spojení monolitu a mikroslužby.
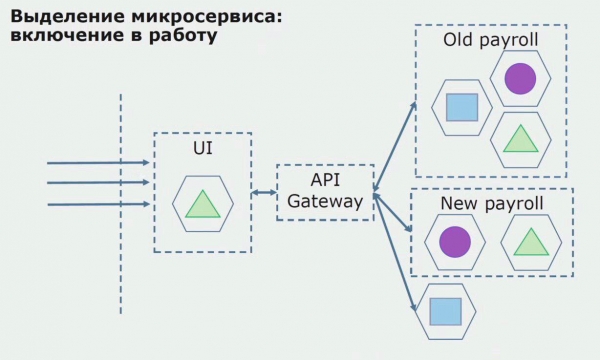
Při úspěšném pilotu chápeme, že nová konfigurace je skutečně funkční, můžeme odstranit starý monolit a ponechat novou konfiguraci na místě starého řešení.
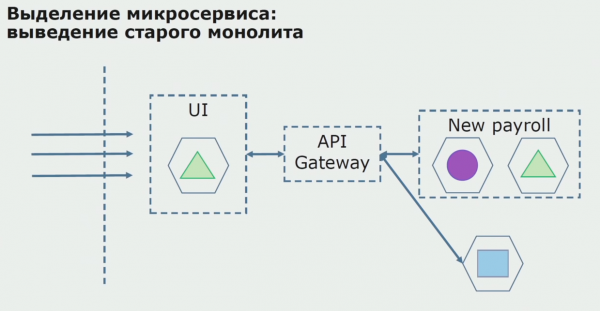
Celkově používáme prakticky všechny existující metody rozdělení zdrojového kódu monolitu. Všechny nám umožňují zmenšovat velikost částí aplikace a převádět je na nové knihovny, čímž zajišťujeme kvalitnější zdrojový kód.
Práce s DB
DB se dělí hůře než zdrojový kód, protože obsahuje nejen aktuální schéma, ale také shromážděné historické údaje.
Naše DB, jako u mnoha dalších, měla ještě jednu důležitou nevýhodu – obrovskou velikost. Tato DB byla navržena podle složité obchodní logiky monolitu, a mezi tabulkami různých omezených kontextů se nahromadily vazby.
V našem případě, aby toho nebylo málo (velká databáze, množství vazeb, někdy nejasné hranice mezi tabulkami), vznikl problém, se kterým se setkáváme v mnoha velkých projektech: použití vzoru sdílené databáze. Data se brala z tabulek prostřednictvím pohledů, prostřednictvím replikace a byla posílána do jiných systémů, kde byla tato replikace potřebná. V důsledku toho jsme nemohli přesunout tabulky do samostatného schématu, protože byly aktivně používány.
V rozdělení nám pomáhá právě ono rozdělení na omezené kontexty v kódu. Obvykle nám dává dostatečně dobré představy o tom, jak rozdělujeme data na úrovni databáze. Chápeme, které tabulky patří do jednoho omezeného kontextu, a které do jiného.
Zavedli jsme dva globální způsoby oddělení databáze: oddělení stávajících tabulek a oddělení s přepracováním.
Oddělení stávajících tabulek je metoda, která se dobře používá, pokud je struktura dat kvalitní, vyhovuje obchodním požadavkům a všem vyhovuje. V takovém případě můžeme stávající tabulky vyčlenit do samostatné schématu.
Oddělení s přepracováním je potřeba, když se obchodní model výrazně změnil a tabulky nás už vůbec nevyhovují.
Oddělení stávajících tabulek. Musíme určit, co budeme oddělovat. Bez této znalosti nic nezískáme a zde nám pomůže oddělení omezených kontextů v kódu. Obvykle, pokud je možné pochopit hranice kontextů ve zdrojovém kódu, stává se jasné, které tabulky by měly být na seznamu k oddělení.
Představme si, že máme řešení, kde dva moduly monolitu komunikují s jednou databází. Musíme zajistit, aby s oddělenými tabulkami komunikoval pouze jeden modul, zatímco druhý začal komunikovat s ním přes API. Zpočátku stačí, aby se přes API provádělo pouze zapisování. To je nezbytný předpoklad, abychom mohli mluvit o nezávislosti mikroslužeb. Čtenářské vazby mohou zůstat, pokud v tom není žádný velký problém.
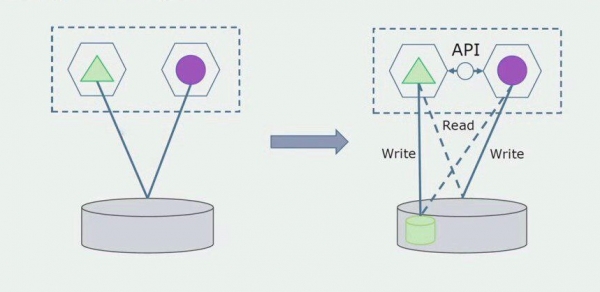
Dalším krokem již můžeme část kódu pracující s oddělenými tabulkami, ať už s přepracováním nebo bez něj, vyčlenit do samostatné mikroslužby a spustit v samostatném procesu, konteineru. To bude samostatná služba s vazbou na databázi monolitu a na ty tabulky, které se jej přímo netýkají. Monolit ještě interaguje na čtení s oddělenou částí.
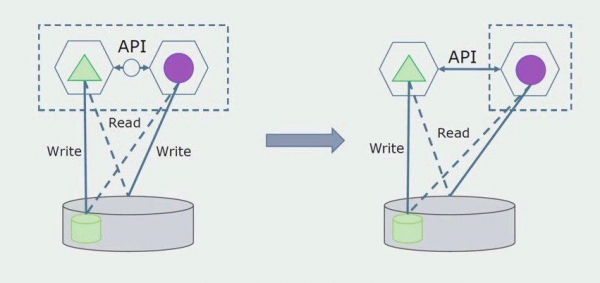
Později tuto vazbu odstraníme, tedy čtení dat monolitické aplikace z oddělených tabulek také převedeme na API.
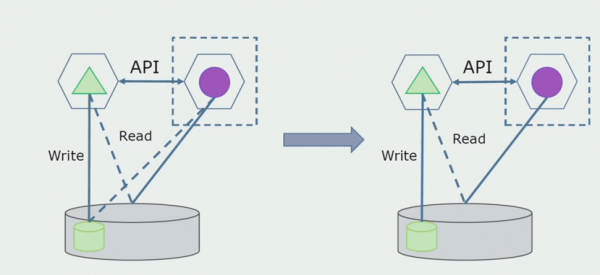
Dále vyčleníme z obecné databáze tabulky, se kterými pracuje pouze nová mikroslužba. Můžeme vyvést tabulky do samostatné schématu nebo dokonce do samostatné fyzické databáze. Zůstala vazba na čtení mezi mikroslužbou a databází monolitu, ale na tom není nic hrozného; v takové konfiguraci může existovat dost dlouho.
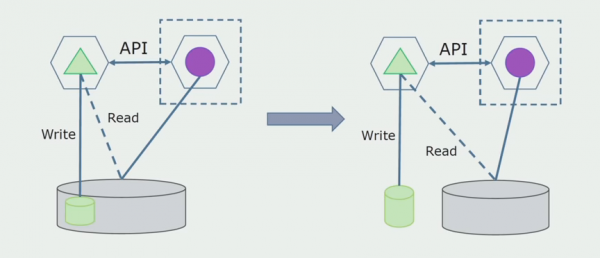
Poslední krok — zcela odstranit všechny vazby. V tomto případě možná budeme potřebovat migraci dat z hlavní databáze. Někdy budeme chtít znovu použít v několika databázích nějaké replikované z externích systémů data nebo referenční informace. S tím se u nás občas setkáváme.
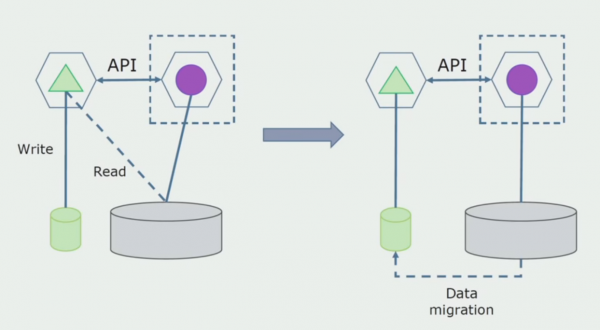
Oddělení s přepracováním. Tato metoda je velmi podobná první, jen probíhá v opačném pořadí. Ihned si vytvoříme novou databázi a nový mikroslužbu, která komunikuje s monolitickým systémem přes API. Avšak zůstává soubor tabulek databáze, které chceme v budoucnu odstranit. Nebude nám již potřebné, v novém modelu jsme je nahradili.
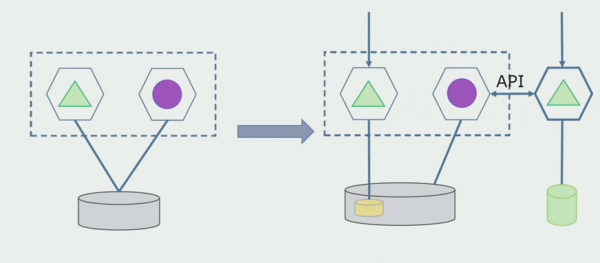
Aby tento schéma fungovalo, pravděpodobně budeme potřebovat přechodné období.
Dále existují dva možné přístupy.
První: duplikujeme všechny údaje v nové a staré databázi. V tomto případě vzniká redundance dat, mohou nastat problémy se synchronizací. Ale můžeme mít dva různé klienty. Jeden bude pracovat s novou verzí, druhý se starou.
Druhý: rozdělíme údaje podle nějakého obchodního znaku. Například v našem systému bylo 5 produktů, které jsou uchovávány ve staré databázi. Šestý v rámci nové obchodní úlohy vkládáme do nové databáze. Ale budeme potřebovat API Gateway, který tyto údaje synchronizuje a ukáže klientovi, odkud a co brát.
Oba přístupy jsou efektivní, vyberte podle situace.
Jakmile se ujistíme, že vše funguje, část monolitu, která pracuje se starými strukturami databáze, lze odpojit.
Posledním krokem bude odstranění starých datových struktur.
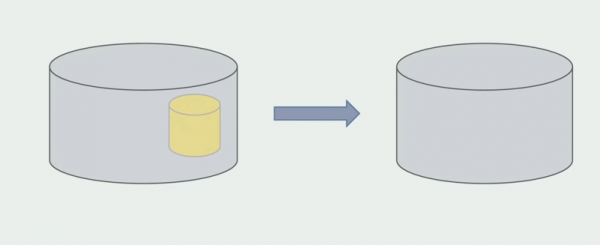
Shrneme-li, můžeme říci, že máme problémy s databázemi: je obtížné s nimi pracovat v porovnání se zdrojovým kódem, je těžší je rozdělit, ale je to možné a nutné. Našli jsme některé způsoby, které umožňují to dělat dostatečně bezpečně, přece jen chyba v datech je snazší než ve zdrojovém kódu.
Práce se zdrojovým kódem
Takto vypadala schéma zdrojového kódu, když jsme začali analyzovat monolitický projekt.
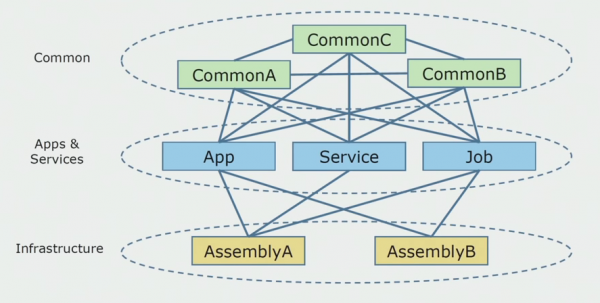
Lze ji podmíněně rozdělit na tři vrstvy. První vrstva zahrnuje spouštěné moduly, pluginy, služby a jednotlivé aktivity. Ve skutečnosti to byly vstupní body uvnitř monolitického řešení. Všechny byly pevně spojeny vrstvou Common. Obsahovala společnou obchodní logiku, kterou využívaly služby, a množství vazeb. Každá služba a plugin používaly až 10 a více společných sestavení, v závislosti na jejich velikosti a svědomí vývojářů.
Měli jsme štěstí, protože jsme měli infrastrukturní knihovny, které bylo možné používat samostatně.
Občas se objevila situace, že některé objekty Common ve skutečnosti nepatřily do této vrstvy, ale byly infrastrukturními knihovnami. To se řešilo přejmenováním.
Největší obavy vyvolávaly omezené kontexty. Někdy se 3-4 kontexty mísily v jednom sestavení Common a vzájemně se využívaly v rámci stejných obchodních funkcí. Bylo nutné pochopit, kde je možné provést oddělení a jaké hranice stanovit, a co dál dělat s mapováním tohoto rozdělení na sestavení zdrojového kódu.
Formulovali jsme několik pravidel pro proces rozdělení kódu.
První: nechtěli jsme již sdílet obchodní logiku mezi službami, aktivitami a pluginy. Chtěli jsme, aby byla obchodní logika nezávislá v rámci mikroslužeb. Na druhé straně, mikroslužby by ideálně měly být vnímány jako služby, které existují zcela nezávisle. Považuji tento přístup za poněkud plýtvavý a je obtížné ho dosáhnout, protože například služby v C# budou v každém případě spojeny se standardní knihovnou. Náš systém je napsán v C#, zatím jsme neměli potřebu používat jiné technologie. Proto jsme se rozhodli, že si můžeme dovolit používat společná technická sestavení. Hlavně aby v nich nebyly žádné fragmenty obchodní logiky. Pokud máte pohodlný obal nad ORM, které používáte, pak jeho kopírování z jedné služby do druhé je velmi nákladné.
Náš tým je fanouškem doménově orientovaného návrhu, takže nám "cibulová architektura" skvěle vyhovuje. Základem našich služeb se stal nikoli datový přístupový vrstva, ale sestavení s doménovou logikou, které obsahuje pouze obchodní logiku a je zbaveno vazeb na infrastrukturu. Přitom můžeme nezávisle rozvíjet doménové sestavení za účelem řešení problémů souvisejících s frameworky.
Na této úrovni jsme čelili první vážné výzvě. Služba měla odkazovat na jednu doménovou sestavu, logiku jsme chtěli udělat nezávislou, a princip DRY nám v tom velmi překážel. Vývojáři chtěli, aby se vyhnuli duplikaci, a tak začali znovu používat třídy ze sousedních sestav, což vedlo k tomu, že se domény opět začaly vzájemně propojovat. Analyzovali jsme výsledky a usoudili, že problém může spočívat také v oblasti struktury úložiště zdrojového kódu. Měli jsme velký repozitář, kde byly uloženy všechny zdrojové kódy. Řešení pro celý projekt se velmi obtížně shromažďovalo na lokálním stroji. Proto byly pro části projektu vytvářeny samostatné malé řešení, a nikdo nezakazoval přidat do nich nějakou společnou nebo doménovou sestavu a opětovně je používat. Jediným nástrojem, který nám to nedovoloval, byla revize kódu. Ale někdy i ten selhal.
Tehdy jsme začali přecházet na model se samostatnými repozitáři. Obchodní logika přestala unikat ze služby do služby, domény se skutečně staly nezávislými. Omezené kontexty jsou podporovány jasněji. Jak jsme přitom znovu používali infrastrukturní knihovny? Vyčlenili jsme je do samostatného repozitáře, poté jsme je umístili do Nuget balíčků, které jsme uložili do Artifactory. Při jakékoli změně se sestavení a publikování provádí automaticky.
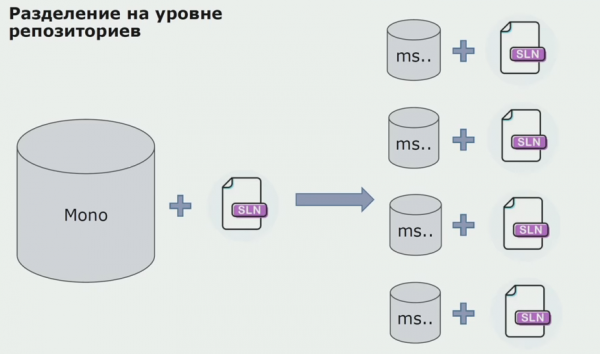
Naše služby začaly odkazovat na interní infrastrukturní balíčky přesně tak, jak na externí. Externí knihovny stahujeme z Nugetu. Pro práci s Artifactory, kde jsme tyto balíčky umístili, jsme použili dva správce balíčků. V malých repozitářích jsme také používali Nuget. V repozitářích se více službami jsme použili Paket, který zajišťuje větší konzistenci verzí mezi moduly.
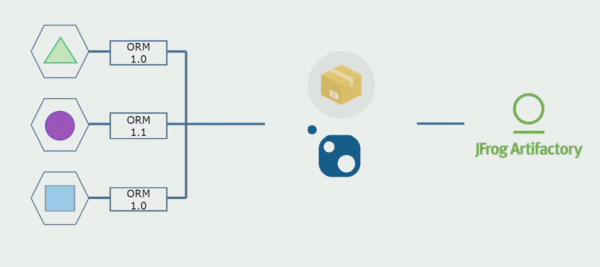
Prací na zdrojovém kódu, mírně měníme architekturu a oddělujeme repozitáře, činíme naše služby nezávislejšími.
Problémy infrastruktury
Většina problémů při přechodu na mikroslužby souvisí s infrastrukturou. Budete potřebovat automatizované nasazení a nové knihovny na práci s infrastrukturou.
Ručně instalovat do prostředí
Původně jsme řešení na prostředí instalovali ručně. Abychom automatizovali tento proces, vytvořili jsme CI/CD pipeline. Zvolili jsme proces continuous delivery, protože continuous deployment se pro nás zatím jeví jako nepřijatelný z hlediska obchodních procesů. Nasazení se proto provádí na tlačítko, zatímco testování probíhá automaticky.
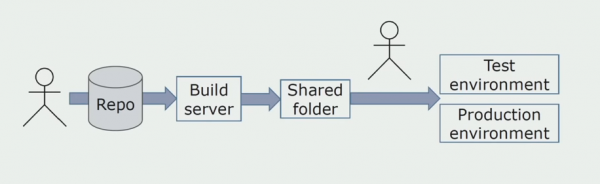
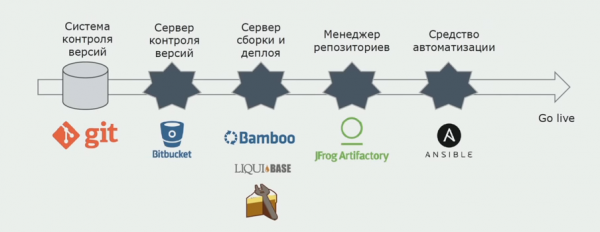
Používáme Atlassian, Bitbucket pro ukládání zdrojových kódů a Bamboo pro sestavení. Rádi píšeme sestavovací skripty v Cake, protože to je stejný jazyk jako C#. V Artifactory přicházejí hotové balíčky a Ansible je automaticky nasazuje na testovací servery, které lze ihned otestovat.
Oddělené logování
V době vzniku byla jednou z myšlenek monolitu zajišťování společného logování. Také jsme potřebovali pochopit, co dělat s individuálními logy, které jsou na discích. Logy zapisujeme do textových souborů. Rozhodli jsme se použít standardní ELK stack. Nepíšeme přímo do ELK přes providery, ale rozhodli jsme se, že upravíme textové logy tak, aby obsahovaly ID trasování ve formě identifikátoru, přičemž přidáme jméno služby, aby se tyto logy daly později analyzovat.
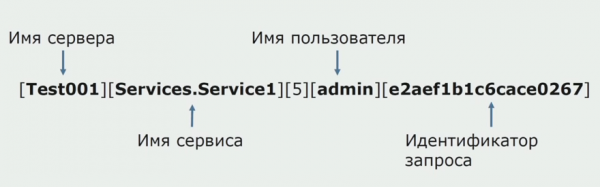
S pomocí Filebeat získáváme možnost shromažďovat naše logy z servery, pak je transformovat, pomocí Kibany sestavovat dotazy v uživatelském rozhraní a sledovat, jak probíhaly volání mezi službami. To výrazně pomáhá ID trasování.
Testování a ladění souvisejících služeb
Zpočátku jsme si úplně nebyli jisti, jak ladit vyvíjené služby. S monolitem to bylo jednoduché, spustili jsme ho na místním počítači. Zpočátku jsme se o to pokoušeli i s mikroslužbami, ale někdy pro plné spuštění jedné mikroslužby je třeba spustit i několik dalších, což je nepohodlné. Pochopili jsme, že je nutné přejít k modelu, kde na místním počítači necháme pouze službu nebo služby, které chceme ladit. Ostatní služby jsou používány ze serverů, které se konfigurací shodují s produkčním prostředím. Po ladění se při testování na testovací server nasazují pouze změněné služby. Tímto způsobem se testuje řešení v podobě, ve které se v budoucnu ocitne na produkci.
Existují servery, na kterých jsou pouze produkční verze služeb. Tyto servery jsou potřeba pro případ incidentů, pro kontrolu dodávky před nasazením a pro interní školení.
Přidali jsme proces automatického testování pomocí populární knihovny Specflow. Testy se spouštějí automaticky pomocí NUnit ihned po nasazení z Ansible. Pokud je pokrytí úkolu plně automatické, není potřeba manuální testování. Ačkoli někdy je vyžadováno další manuální testování. Pro určení, které testy spustit pro konkrétní úkol, používáme tagy v Jira.
Dále vzrostla potřeba zátěžového testování, které se dříve provádělo pouze ve vzácných případech. Pro spuštění testů používáme JMeter, pro jejich uložení InfluxDB a pro vytváření grafů procesu Grafana.
Co jsme dosáhli?
Za prvé, zbavili jsme se pojmu „release“. Zmizely dvouměsíční monstrózní releasy, kdy se tato mašina nasazovala do produkčního prostředí, což dočasně narušovalo podnikové procesy. Nyní nasazujeme služby v průměru každých 1,5 dne, agregujeme je, protože do provozu vycházejí po schválení.
V našem systému nejsou fatální selhání. Pokud jsme vydali mikroslužbu s chybou, tak související funkčnost bude poškozena, ale veškerá ostatní funkčnost nebude ovlivněna. To významně zlepšuje uživatelskou zkušenost.
Můžeme spravovat schéma nasazení. Můžeme vyčlenit skupiny služeb odděleně od ostatních řešení, pokud je to potřeba.
Kromě toho jsme výrazně snížili problém s velkým frontem úprav. Máme nyní samostatné produktové týmy, které pracují na části služeb nezávisle. Tady už se dobře uplatňuje proces Scrum. Každý konkrétní tým může mít svého samostatného vlastníka produktu, který mu zadává úkoly.
Shrnutí
- Mikroslužby jsou dobře přizpůsobeny dekompozici složitých systémů. V průběhu toho začínáme rozumět tomu, co v našem systému existuje, jaké jsou omezené kontexty a kde jsou jejich hranice. To nám umožňuje správně rozdělovat úpravy podle modulů a zabránit zmatení kódu.
- Mikroslužby nabízejí organizační výhody. O nich se často hovoří pouze jako o architektuře, ale jakákoli architektura je potřebná pro řešení potřeb podnikání, nikoli sama o sobě. Proto můžeme říci, že mikroslužby jsou dobře přizpůsobeny pro řešení úkolů malými týmy, zvlášť nyní, když je Scrum velmi populární.
- Dělení je iterativní proces. Nelze vzít aplikaci a jen ji rozdělit na mikroslužby. Výsledný produkt pravděpodobně nebude funkční. Při vyčleňování mikroslužeb je výhodné přepisovat existující legacy, tedy přetvářet ho na kód, který se nám líbí a lépe uspokojuje potřeby podnikání z hlediska funkčnosti a rychlosti.
Malé varování: náklady na přechod k mikroslužbám jsou poměrně značné. Pouze na řešení problémů s infrastrukturou bylo zapotřebí hodně času. Proto, pokud máte malou aplikaci, která nevyžaduje specifické škálování, pokud není velké množství zákazníků, kteří soutěží o pozornost a čas vašeho týmu, pak mikroslužby možná nejsou to, co dnes potřebujete. Je to dost drahé. Pokud začnete proces mikroslužbami, náklady budou na začátku vyšší než když stejný projekt začnete vývojem monolitu.
P.S. Emotivnější příběh (jako by byl určen přímo vám) – podle .
Zde je plná verze přednášky.
Zdroj: habr.com
