

Výkon v .NET Core
Ahoj všichni! Tento článek je sbírkou osvědčených postupů, které já a moji kolegové používáme již dlouhou dobu při práci na různých projektech.
Informace o stroji, na kterém byly prováděny výpočty:BenchmarkDotNet=v0.11.5, OS=Windows 10.0.18362
Intel Core i5-8250U CPU 1.60GHz (Kaby Lake R), 1 CPU, 8 logických a 4 fyzické jádra
.NET Core SDK=3.0.100
[Host]: .NET Core 2.2.7 (CoreCLR 4.6.28008.02, CoreFX 4.6.28008.03), 64bit RyuJIT
Jádro: .NET Core 2.2.7 (CoreCLR 4.6.28008.02, CoreFX 4.6.28008.03), 64bit RyuJIT
[Host]: .NET Core 3.0.0 (CoreCLR 4.700.19.46205, CoreFX 4.700.19.46214), 64bit RyuJIT
Jádro: .NET Core 3.0.0 (CoreCLR 4.700.19.46205, CoreFX 4.700.19.46214), 64bit RyuJIT
Úloha=Core Runtime=Core
ToList vs ToArray a cykly
Toto informace jsem plánoval připravit s vydáním .NET Core 3.0, ale mě předešli, nechci krást cizí slávu a kopírovat cizí informace, proto jednoduše uvedu .
Od sebe chci jen představit své měření a výsledky, přidal jsem do nich zpětné cykly pro milovníky „C++ stylu“ psaní cyklů.
Kód:
public class Bench
    {
        private List _list;
        private int[] _array;

        [Params(100000, 10000000)] public int N;

        [GlobalSetup]
        public void Setup()
        {
            const int MIN = 1;
            const int MAX = 10;
            Random random = new Random();
            _list = Enumerable.Repeat(0, N).Select(i => random.Next(MIN, MAX)).ToList();
            _array = _list.ToArray();
        }

        [Benchmark]
        public int ForList()
        {
            int total = 0;
            for (int i = 0; i  0; i--)
            {
                total += _list[i];
            }

            return total;
        }

        [Benchmark]
        public int ForeachList()
        {
            int total = 0;
            foreach (int i in _list)
            {
                total += i;
            }

            return total;
        }

        [Benchmark]
        public int ForeachArray()
        {
            int total = 0;
            foreach (int i in _array)
            {
                total += i;
            }

            return total;
        }

        [Benchmark]
        public int ForArray()
        {
            int total = 0;
            for (int i = 0; i  0; i--)
            {
                total += _array[i];
            }

            return total;
        }
    }
Rychlost práce v .NET Core 2.2 a 3.0 je téměř identická. Tady jsou výsledky, které jsem získal v .NET Core 3.0:
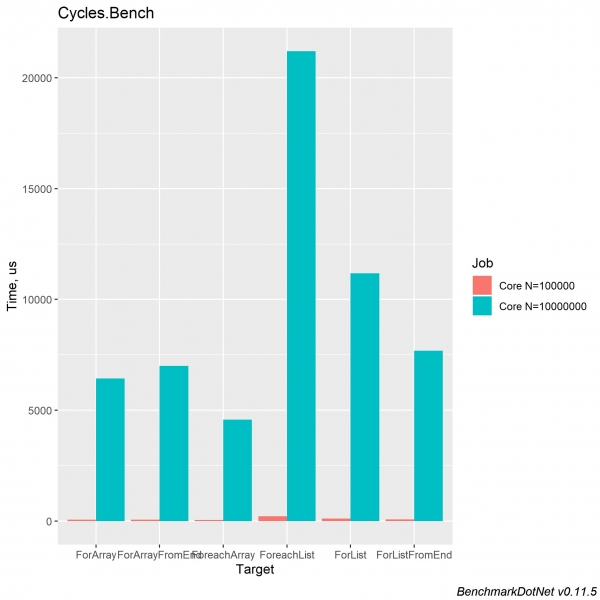
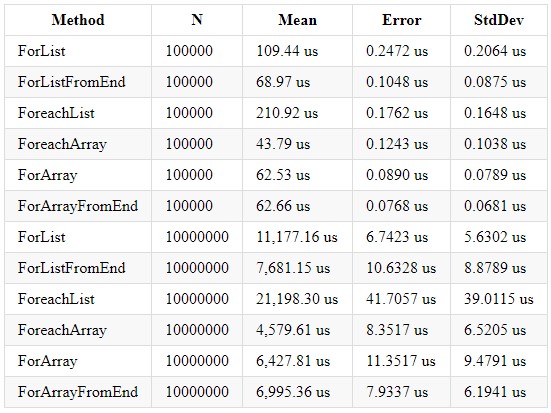
Můžeme dojít k závěru, že cyklické zpracování kolekce typu Array je rychlejší díky svým vnitřním optimalizacím a jasnému určení velikosti kolekce. Také je dobré mít na paměti, že kolekce typu List má své výhody a měli byste používat správnou kolekci podle potřebných výpočtů. I když píšete logiku práce s cykly, neměli byste zapomínat, že se jedná o běžný loop, který je také náchylný k možným optimalizacím cyklů. Na Habr už dlouho vyšel článek: . Ten je stále aktuální a doporučuje se k přečtení.
Throw
Před rokem jsem pracoval ve společnosti na legacy projektu, ve kterém bylo v rámci normy zpracovávat validaci polí pomocí konstrukce try-catch-throw. Už tehdy jsem chápal, že to není zdravá obchodní logika fungování projektu, a proto jsem se snažil tuto konstrukci co nejvíce nevyužívat. Ale pojďme si rozebrat, jaké nevýhody má přístup zpracovávat chyby touto konstrukcí. Napsal jsem malý kód, abych porovnal dva přístupy a provedl „benchmark“ pro každou variantu.
Kód:
        public bool ContainsHash()
        {
            bool result = false;
            foreach (var file in _files)
            {
                var extension = Path.GetExtension(file);
                if (_hash.Contains(extension))
                    result = true;
            }

            return result;
        }

        public bool ContainsHashTryCatch()
        {
            bool result = false;
            try
            {
                foreach (var file in _files)
                {
                    var extension = Path.GetExtension(file);
                    if (_hash.Contains(extension))
                        result = true;
                }

                if(!result)
                    throw new Exception("false");
            }
            catch (Exception e)
            {
                result = false;
            }

            return result;
        }
Výsledky v .NET Core 3.0 a Core 2.2 mají podobné výsledky (.NET Core 3.0):
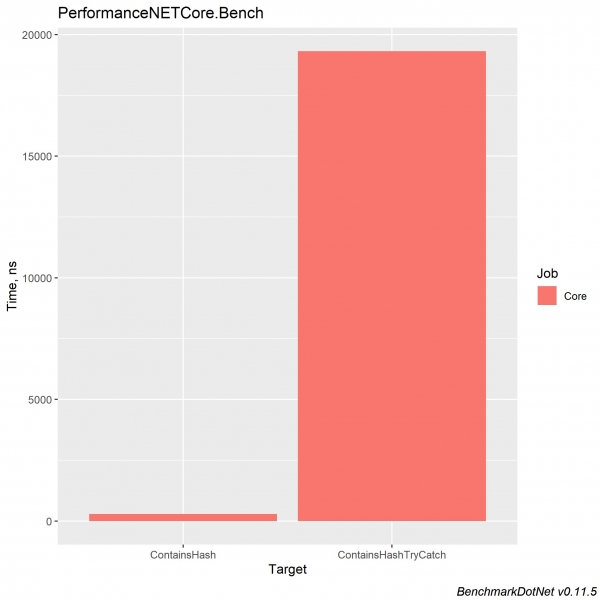
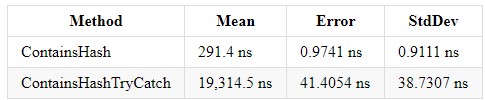
Try catch ztěžuje pochopení kódu a zvyšuje dobu vykonávání vašeho programu. Ale pokud tuto konstrukci potřebujete, neměli byste vkládat ty řádky kódu, od kterých se neočekává zpracování chyb — to usnadní pochopení kódu. Ve skutečnosti systém nezatěžuje tolik zpracování výjimek, jako spíše vyhazování samotných chyb přes konstrukci throw new Exception.
Vyhazování výjimek pracuje pomaleji než nějaká třída, která shromáždí chybu ve správném formátu. Pokud zpracováváte formulář nebo nějaká data a přesně víte, jaká chyba by měla nastat, tak proč je nezpracovat?
Není třeba psát konstrukci throw new Exception(), pokud situace není výjimečná. Zpracování a vyhazování výjimek je velmi nákladné!!!
ToLower, ToLowerInvariant, ToUpper, ToUpperInvariant
Ve svých 5 letech zkušeností s platformou .NET jsem se setkal s mnoha projekty, které používaly porovnávání řetězců. Také jsem viděl následující situaci: existovala jedna Enterprise řešení se spoustou projektů, z nichž každý prováděl porovnání řetězců různě. Co by mělo být použito a jak to unifikovat? V knize CLR via C# od Rychtera jsem našel informaci, že metoda ToUpperInvariant() funguje rychleji než ToLowerInvariant().
Úryvek z knihy:
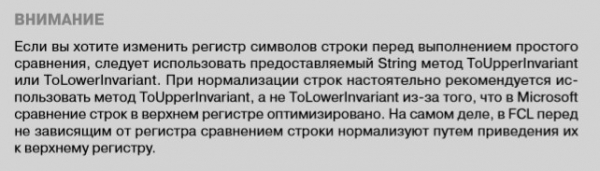
Samozřejmě jsem tomu nevěřil a rozhodl jsem se provést nějaké testy ještě na .NET Framework, a výsledek mě šokoval - více než 15% nárůst výkonu. Následující ráno jsem ukázal měření svému nadřízenému a poskytl mu přístup ke zdrojovým kódům. Poté byly 2 ze 14 projektů změněny podle nových měření, a vzhledem k tomu, že tyto dva projekty sloužily k zpracování obrovských excelových tabulek, byl výsledkem více než významný přínos pro produkt.
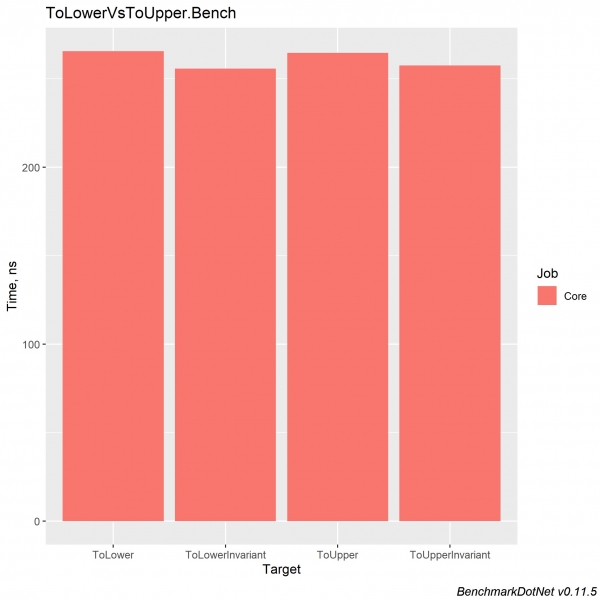
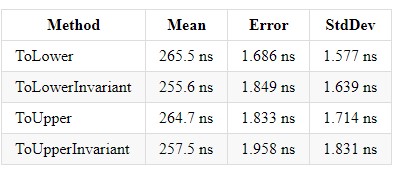
Také vám předkládám měření pro různé verze .NET Core, abyste si každý z vás mohl vybrat optimální řešení. A chci dodat, že v firmě, kde pracuji, používáme ToUpper() pro porovnávání řetězců.
Kód:
public const string defaultString =  "VXTDuob5YhummuDq1PPXOHE4PbrRjYfBjcHdFs8UcKSAHOCGievbUItWhU3ovCmRALgdZUG1CB0sQ4iMj8Z1ZfkML2owvfkOKxBCoFUAN4VLd4I8ietmlsS5PtdQEn6zEgy1uCVZXiXuubd0xM5ONVZBqDu6nOVq1GQloEjeRN8jXrj0MVUexB9aIECs7caKGddpuut3";

        [Benchmark]
        public bool ToLower()
        {
            return defaultString.ToLower() == defaultString.ToLower();
        }

        [Benchmark]
        public bool ToLowerInvariant()
        {
            return defaultString.ToLowerInvariant() == defaultString.ToLowerInvariant();
        }

        [Benchmark]
        public bool ToUpper()
        {
            return defaultString.ToUpper() == defaultString.ToUpper();
        }

        [Benchmark]
        public bool ToUpperInvariant()
        {
            return defaultString.ToUpperInvariant() == defaultString.ToUpperInvariant();
        }
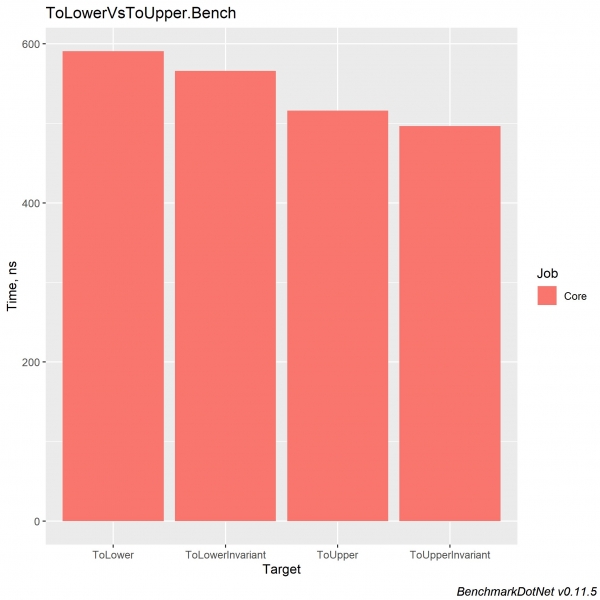
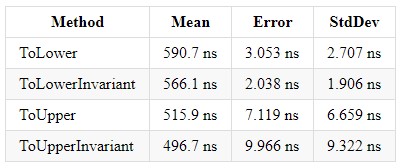
V .NET Core 3.0 je nárůst výkonu pro každou z těchto metod přibližně ×2 a vyvažuje implementace mezi sebou.
Tier Compilation
Ve svém předchozím článku jsem tento funkční prvek popsal stručně, nyní bych chtěl své slova opravit a doplnit. Víceúrovňová kompilace zrychluje čas spuštění vašeho řešení, ale obětujete tím to, že části vašeho kódu budou kompilovány do optimalizovanější verze na pozadí, což může vést k drobným režijním nákladům. S příchodem .NET Core 3.0 došlo ke zkrácení doby sestavení projektů s aktivovanou tier kompilací a byly opraveny chyby související s touto technologií. Dříve tato technologie vedla k chybám prvních dotazů v ASP.NET Core a k zamrznutí při prvním sestavení v režimu víceúrovňové kompilace. V současnosti je v .NET Core 3.0 nastavená jako výchozí, ale můžete ji na přání vypnout. Pokud jste v pozici team-lead, senior, middle nebo vedoucím oddělení, měli byste chápat, že rychlá vývoj projektu zvyšuje hodnotu týmu a tato technologie vám umožní šetřit čas jak vývojářů, tak i celkový čas práce na projektu.
.NET úroveň nahoru
Zvyšte verzi vašeho .NET Framework / .NET Core. Často každá nová verze přináší dodatečný přírůstek výkonu a přidává nové funkce.
Ale jaké konkrétní výhody? Pojďme se podívat na některé z nich:
- V .NET Core 3.0 se objevily R2R obrazy, které umožní snížit dobu spuštění .NET Core aplikací.
- Od verze 2.2 existuje Tier Compilation, díky které budou programátoři trávit méně času spouštěním projektu.
- Podpora nových standardů .NET Standard.
- Podpora nové verze programovacího jazyka.
- Optimalizace, s každou novou verzí se zlepšuje optimalizace základními knihovnami Collection/Struct/Stream/String/Regex a mnoha dalšími. Pokud přecházíte z .NET Framework na .NET Core, získáte vysoký přírůstek výkonu z krabice. Jako příklad přikládám odkaz na část optimalizací, které byly přidány do .NET Core 3.0:
Závěr
Při psaní kódu je důležité věnovat pozornost různým aspektům vašeho projektu a využívat funkce vašeho programovacího jazyka a platformy k dosažení nejlepších výsledků. Budu rád, pokud se podělíte o své znalosti související s optimalizací v .NET.
Zdroj: habr.com
