

Ahoj všichni! Jsem backendový vývojář, píšu mikroslužby v Javě + Spring. Pracuji v jednom z týmů vyvíjejících interní produkty ve společnosti Tinkoff.
V našem týmu se často objevuje otázka optimalizace dotazů v databázovém systému. Vždy bychom chtěli, aby to bylo ještě o něco rychlejší, ale ne vždy lze obejít dobře promyšlenými indexy — musíme hledat nějaké alternativní způsoby. Během jednoho z takových hledání na internetu za účelem rozumných optimalizací pro práci s databází jsem našel , autora knihy SQL Performance Explained. To je ten vzácný typ blogu, kde se dají číst všechny články jeden za druhým.
Chci pro vás přeložit malý článek Marka. Lze ho určitým způsobem nazvat manifestem, který má za cíl upozornit na starý, ale stále aktuální problém výkonu operace offset podle standardu SQL.
Na některých místech budu doplňovat autora vysvětlivkami a poznámkami. Všechna taková místa budu označovat jako „poznámka“ pro větší jasnost.
Malé úvodní slovo
Myslím, že mnozí vědí, jak problematická a pomalá může být práce s stránkovými seleky přes offset. A víte, že ji lze poměrně snadno nahradit výkonnější konstrukcí?
Takže klíčové slovo offset říká databázi, aby přeskočila prvních n záznamů v dotazu. Nicméně databáze stále musí přečíst těchto prvních n záznamů z disku, navíc v daném pořadí (pozn.: aplikovat třídění, pokud bylo specifikováno), a teprve poté bude možné vrátit záznamy počínaje n+1 a dál. Nejzajímavější na tom je, že problém není v konkrétní implementaci v databázovém systému, ale v původním definování podle standardu:
…the rows are first sorted according to the and then limited by dropping the number of rows specified in the from the beginning…
-SQL:2016, Part 2, 4.15.3 Derived tables (pozn.: nyní nejpoužívanější standard)
Klíčový bod zde je, že offset přijímá jediný parametr — počet záznamů, které je třeba přeskočit, a to je vše. Podle takového definování může databázový systém pouze načíst všechny záznamy a poté vyřadit ty nepotřebné. Je zřejmé, že takové definice offsetu nutí systematicky provádět zbytečnou práci. A nezáleží ani na tom, jestli je to SQL nebo NoSQL.
Ještě trochu bolesti
Problémy s offsetem tímto nekončí a tady je proč. Pokud mezi čtením dvou stránek dat z disku vloží jiná operace nový záznam, co se v tomto případě stane?
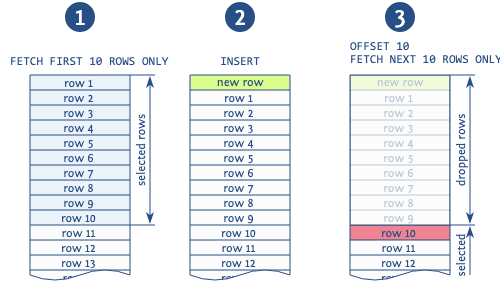
Když se používá offset k přeskočení záznamů z předchozích stránek, v situaci přidání nového záznamu mezi operacemi čtení různých stránek pravděpodobně získáte duplicity (pozn.: to je možné, když čteme stránkově pomocí konstrukce order by, pak se do našeho výstupu může dostat nový záznam).
Obrázek názorně zobrazuje tuto situaci. Databáze čte první 10 záznamů, po tom se vloží nový záznam, který posune všechny přečtené záznamy o 1. Poté databáze vezme novou stránku z 10 následujících záznamů a nezačne s 11., jak by měla, ale s 10., což způsobí duplicitu tohoto záznamu. Existují i další anomálie spojené s použitím tohoto výrazu, ale tato je nejběžnější.
Jak jsme již zjistili, nejde o problémy konkrétního DBMS nebo jejich implementací. Problém je v definici stránkování podle standardu SQL. Říkáme DBMS, kterou stránku má načíst nebo kolik záznamů má přeskočit. Databáze prostě není schopna optimalizovat takový dotaz, protože má příliš málo informací.
Je také důležité upřesnit, že se nejedná o problém konkrétního klíčového slova, ale spíše o semantiku dotazu. Existuje také několik identických problémových syntaxí:
- Klíčové slovo offset, jak bylo řečeno dříve.
- Konstrukce ze dvou klíčových slov limit [offset] (i když sám limit není zas tak špatný).
- Filtrace podle dolních mezí založená na číslování řádků (například row_number(), rownum atd.).
Všechny tyto výrazy jednoduše říkají, kolik řádků je třeba přeskočit, žádné další informace nebo kontext.
Dále v tomto článku se klíčové slovo offset používá jako obecné označení pro všechny tyto varianty.
Život bez OFFSET
A nyní si představme, jaký by byl náš svět bez všech těchto problémů. Ukazuje se, že život bez offsetu není tak složitý: SELECTem můžeme vybírat pouze ty řádky, které jsme ještě neviděli (pozn.: tedy ty, které nebyly na minulém stránce), pomocí podmínky v WHERE.
V tomto případě vycházíme z toho, že selekty se provádějí nad uspořádanou množinou (starý dobrý order by). Jelikož máme uspořádanou množinu, můžeme použít poměrně jednoduchý filtr, abychom získali pouze ta data, která se nacházejí za posledním záznamem předchozí stránky:
    SELECT ...
    FROM ...
    WHERE ...
    AND id < ?last_seen_id
    ORDER BY id DESC
    FETCH FIRST 10 ROWS ONLY
To je celý princip takového přístupu. Samozřejmě, při třídění podle mnoha sloupců je to zábavnější, ale myšlenka zůstává stejná. Je důležité poznamenat, že tato konstrukce je použitelná na mnoha -řešeních.
Tento přístup se nazývá seek method nebo keyset pagination. Řeší problém s plovoucím výsledkem (pozn.: situace se záznamem mezi čteními stránek, jak bylo popsáno dříve) a samozřejmě, co máme všichni rádi, funguje rychleji a stabilněji než klasický offset. Stabilita spočívá v tom, že čas zpracování dotazu se nezvyšuje úměrně číslu požadované tabulky (pozn.: pokud chcete podrobněji pochopit práci různých přístupů k paginaci, můžete . Tam také můžete najít srovnávací benchmarky různých metod).
Jedna z slidů , že paginace podle klíčů samozřejmě není all-powerful — má svá omezení. Nejvýznamnější je, že nemá možnost číst náhodné stránky (pozn.: nesledovaně). Nicméně v době nekonečného scrollování (pozn.: na frontendě) to není takový problém. Uvedení čísla stránky k prokliku — v každém případě špatné řešení při vývoji UI (pozn.: názor autora článku).
A co nástroje?
Paginace na klíčích často nevyhovuje kvůli nedostatku nástrojové podpory této metody. Většina vývojových nástrojů, včetně různých frameworků, nenabízí volbu, jakým způsobem bude paginace provedena.
Situaci zhoršuje to, že popsaná metoda vyžaduje průběžnou podporu ve používaných technologiích — začínaje od DBMS a konče prováděním AJAX dotazu v prohlížeči při nekonečném scrollování. Místo toho, abychom uváděli pouze číslo stránky, nyní budeme muset uvést soubor klíčů pro všechny stránky najednou.
Nicméně počet frameworků, které podporují stránkování na základě klíčů, postupně roste. Zde je aktuální přehled:
- pro Java;
- pro Ruby;
- a pro Django;
- pro Python;
- — criteria API pro implementace JPA;
- pro Perl;
- , мапер для Node.js .
(Pozn.: některé odkazy byly odstraněny, protože v době překladu některé knihovny nebyly aktualizovány od roku 2017–2018. Pokud máte zájem, můžete se podívat na původní zdroj.)
Právě v tomto bodě potřebujeme vaši pomoc. Pokud vyvíjíte nebo udržujete framework, který nějakým způsobem používá stránkování, prosím, vyzývám vás, abyste udělali nativní podporu pro stránkování na základě klíčů. Pokud máte otázky nebo potřebujete pomoc, rád vám pomohu (, , ) (pozn.: z mé zkušenosti s Markusem mohu říci, že se k šíření tohoto tématu opravdu staví s nadšením).
Pokud však používáte hotová řešení, o kterých si myslíte, že by měla mít podporu stránkování na základě klíčů, — vytvořte žádost nebo dokonce navrhněte hotové řešení, pokud je to možné. Můžete také uvést tento článek v odkazu.
Závěr
Důvod, proč je tak jednoduchý a užitečný přístup, jako je stránkování na základě klíčů, málo rozšířený, není v tom, že by bylo technicky složité ho realizovat nebo by vyžadovalo nějaké velké úsilí. Hlavní příčinou je to, že si mnozí zvykli vidět a pracovat s offsetem — takový přístup je diktován samotným standardem.
V důsledku toho se málokdo zamýšlí nad změnou přístupu ke stránkování, a proto se nástrojová podpora ze strany frameworků a knihoven rozvíjí slabě. Proto, pokud je vám blízká myšlenka a cíle bezoffsetového stránkování, — pomozte ji rozšířit!
Zdroj:
Autor: Markus Winand
Zdroj: habr.com
