

Jaká verze firmwaru je ta "nejlepší" a "funkční"? Pokud úložiště zaručuje dostupnost 99,9999 %, znamená to, že bude fungovat bez přerušení i bez aktualizace softwaru? Nebo naopak, pro dosažení maximální dostupnosti je nutné vždy instalovat nejnovější firmware? Pokusíme se odpovědět na tyto otázky na základě našich zkušeností.
Malé úvodní slovo
Všichni chápeme, že v každé verzi softwaru, ať už se jedná o operační systém nebo ovladač pro nějaké zařízení, často existují nedostatky/baggy a další "osobitosti", které se mohou buďto "neprojevit" až do konce životnosti zařízení, nebo se "ukážou" pouze za určitých podmínek. Počet a význam těchto nuancí závisí na složitosti (funkcionalitě) softwaru a na kvalitě testování při jeho vývoji.
Uživatelé se často drží "z výroby dodaného firmwaru" (známé – "když to funguje, raději do toho nezasahuj") nebo vždy instalují nejnovější verzi (v jejich chápání, poslední znamená nejlepší). My však používáme jiný přístup – sledujeme vydávací poznámky pro veškerý používaný hardware. a pečlivě vybíráme vhodný firmware pro každou jednotku zařízení.
K tomuto závěru jsme dospěli, jak se říká, s praxí. Na svém příkladu provozu vám povíme, proč slibované 99,9999 % spolehlivosti úložiště nic neznamená, pokud nebudete včas sledovat aktualizaci a popis softwaru. Náš případ se hodí pro uživatele úložišť jakékoli značky, protože taková situace se může vyskytnout s hardwarem jakéhokoli výrobce.
Výběr nového systému pro ukládání dat
Na konci loňského roku do naší infrastruktury přibyl zajímavý systém pro ukládání dat: nižší model z řady IBM FlashSystem 5000, který byl při koupi znám jako Storwize V5010e. Nyní se prodává pod názvem FlashSystem 5010, ale ve skutečnosti je to stejná hardwarová báze se stejným Spectrum Virtualize uvnitř.
Jednotný systém správy je vlastně hlavním rozdílem IBM FlashSystem. Modely nižší třídy se od modelů s vyšším výkonem téměř neliší. Výběr určitého modelu pouze poskytuje odpovídající hardwarovou základnu, jejíž vlastnosti umožňují využívat určitou funkčnost nebo zajistit vyšší úroveň škálovatelnosti. Software přitom identifikuje hardwarovou část a poskytuje potřebnou a dostatečnou funkčnost pro tuto platformu.
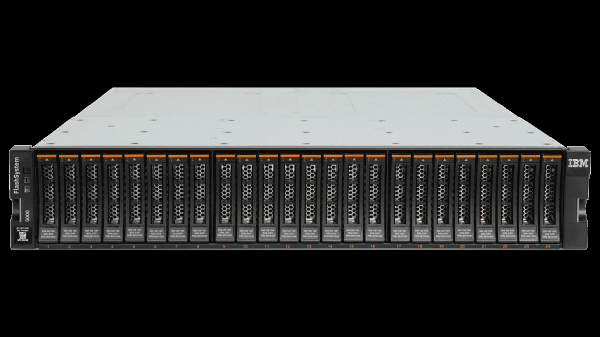 IBM FlashSystem 5010
Stručně o našem modelu 5010. Je to dvouřadičový blokový systém pro ukládání dat na úrovni vstupu a výstupu. Umí umisťovat disky NLSAS, SAS, SSD. Umístění NVMe v něm není dostupné, protože tento model je určen pro řešení úloh, které nevyžadují výkon NVMe disků.
Systém byl zakoupen pro uchovávání archivních informací nebo dat, ke kterým nedochází k častému přístupu. Proto nám stačil standardní soubor jeho funkčností: tiering (Easy Tier), Thin Provision. Výkon na NLSAS discích na úrovni 1000-2000 IOPS nás také plně uspokojoval.
Naše zkušenost — jak jsme neaktualizovali firmware včas
Nyní přímo k aktualizaci softwaru. V době zakoupení měl systém již mírně zastaralou verzi softwaru Spectrum Virtualize, a to konkrétně, 8.2.1.3.
Prozkoumali jsme popis firmware a naplánovali aktualizaci na 8.2.1.9. Kdybychom byli trochu obratnější, tento článek by nevznikl — na novější verzi by k problému nedošlo. Nicméně, z určitých důvodů byla aktualizace tohoto systému odložena.
V důsledku malé prodlevy v aktualizaci došlo k velmi nepříjemné situaci, jak je popsáno v odkazu: .
Ano, ve firmwaru té verze byl aktuální takzvaný APAR (Authorized Program Analysis Report) HU02104. Projevuje se následujícím způsobem. Pod zátěží za určitých okolností začne přetékat cache, poté systém přejde do ochranného režimu, ve kterém zakáže vstup a výstup pro pool. V našem případě to vypadalo jako odpojení 3 disků pro RAID skupinu v režimu RAID 6. Odpojení trvá 6 minut. Poté se přístup k objemům v poolu obnoví.
Pokud někdo není obeznámen se strukturou a pojmenováním logických entit v kontextu IBM Spectrum Virtualize, nyní stručně vysvětlím.
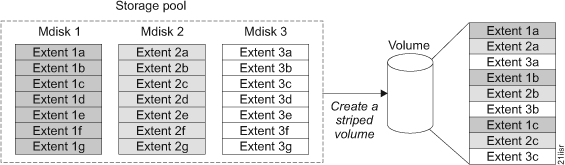 Struktura logických prvků úložiště
Disky jsou sestavovány do skupin, které se nazývají MDisk (Managed Disk). MDisk může představovat klasický RAID (0,1,10,5,6) nebo virtualizovaný – DRAID (Distributed RAID). Použití DRAID zvyšuje výkon pole, protože se využijí všechny disky skupiny, a snižuje čas obnovy, protože je potřeba obnovit pouze určité bloky, nikoli všechna data z nefunkčního disku.
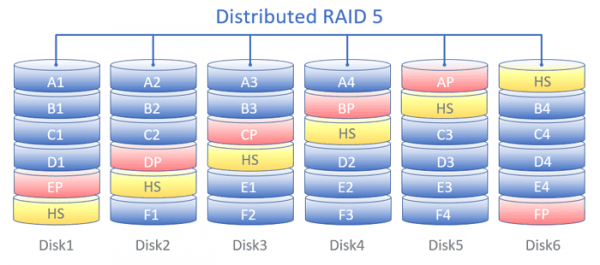 Distribuce datových bloků na discích při použití Distributed RAID (DRAID) v režimu RAID-5.
Tento diagram ukazuje logiku obnovy DRAID v případě selhání jednoho disku:
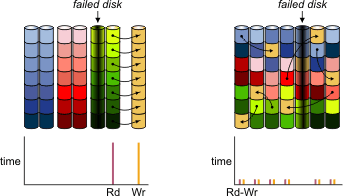 Logika obnovy DRAID při selhání jednoho disku
Dále jeden nebo více MDisk vytváří takzvaný Pool. V rámci jednoho poolu se nedoporučuje používat MDisk s různými úrovněmi RAID/DRAID na discích jednoho typu. Nehodláme se do toho příliš zasahovat, protože plánujeme to podrobněji přiblížit v jednom z následujících článků. No a vlastně, Pool se dělí na Toma (Volumes), které jsou prezentovány prostřednictvím jednoho nebo druhého protokolu blokového přístupu k hostům.
Tak tedy, v důsledku vzniku situace popsané v APAR HU02104, z důvodu logického selhání tří disků, přestal být funkční MDisk, který na oplátku způsobil selhání Poolu a příslušných Tomů.
Jelikož jsou tyto systémy poměrně "inteligentní", lze je připojit k cloudovému monitorovacímu systému IBM Storage Insights, který automaticky při vzniku závady odešle žádost o servis do zákaznického servisu IBM. Vytváří se žádost a odborníci IBM provádějí diagnostiku na dálku a kontaktují uživatele systému.
Díky tomu byl problém vyřešen poměrně rychle a od zákaznického servisu jsme obdrželi aktuální doporučení na aktualizaci našeho systému na již dříve vybraný firmware 8.2.1.9, ve kterém byl tento problém již řešen. To potvrzuje .
Závěry a naše doporučení
Jak se říká: „dobré je to, co dobře končí“. Chyba v firmwaru se neproměnila v závažné problémy — provoz serverů byl obnoven v nejkratším možném čase a bez ztráty dat. U některých klientů bylo nutné restartovat virtuální stroje, ale celkově jsme byli připraveni na horší důsledky, protože každý den děláme zálohy všech prvků infrastruktury a klientských strojů.
Obdrželi jsme potvrzení, že i spolehlivé systémy s 99,9999% slíbenou dostupností vyžadují pozornost a včasnou údržbu. Na základě situace jsme si udělali několik závěrů a sdílíme naše doporučení:
Je nutné sledovat vydávání aktualizací, studovat poznámky k vydání kvůli opravě potenciálně kritických aspektů a včas provádět plánované aktualizace.
To je organizační a vlastně docela zřejmý moment, na který by se, zdá se, nemělo poukazovat. Nicméně, na tomto „pokojném místě“ se dá relativně snadno zakopnout. Vlastně právě tento moment přidal výše popsané nepříjemnosti. Přistupujte k sestavení předpisu aktualizací velmi pečlivě a stejně pečlivě sledujte jeho dodržování. Tento bod více souvisí s pojmem „disciplína“.
Vždy je lepší mít systém s aktuální verzí softwaru. Přičemž aktuální není ta, která má vyšší číselné označení, ale ta, která má opravdu pozdější datum vydání.
Například IBM pro své systémy ukládání dat udržuje aktuální alespoň dvě verze softwaru. K okamžiku napsání tohoto článku jsou to 8.2 a 8.3. Aktualizace pro 8.2 vychází dříve. Následně s malým zpožděním obvykle vychází obdobná aktualizace pro 8.3.
Verze 8.3 má řadu funkčních výhod, například možnost rozšíření MDisk (v režimu DRAID) přidáním jednoho nebo více nových disků (tato funkce se objevila od verze 8.3.1). Je to docela základní funkčnost, ale ve verzi 8.2, bohužel, tato možnost není.
Pokud není možné provést aktualizaci z jakéhokoliv důvodu, pro verze softwaru Spectrum Virtualize, které předcházejí verzím 8.2.1.9 a 8.3.1.0 (kde je tato chyba relevantní), doporučuje technická podpora IBM omezit výkon systému na úrovni poolu, jak je znázorněno na obrázku níže (snímek byl pořízen v lokalizované verzi GUI). Hodnota 10000 IOPS je uvedena jako příklad a je volena podle charakteristik vaší soustavy.
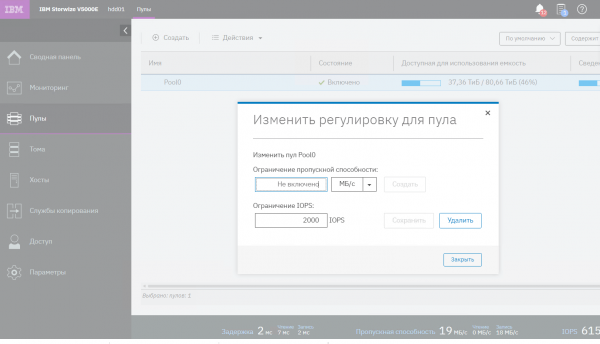 Omezení výkonu úložných systémů IBM
Je třeba správně vypočítat zátěž na systémy úložišť a nezatěžovat je. K tomu můžete využít buď IBM size tool (pokud máte k němu přístup), pomoc partnerů, nebo externí zdroje. Při tom je důležité rozumět profilu zátěže na úložiště, protože výkon v MB/s a IOPS se výrazně liší v závislosti alespoň na následujících parametrech:
typ operace: čtení nebo zápis,
velikost bloku operace,
procentuální podíl operací čtení a zápisu v celkovém vstupně-výstupním toku.
Dále, na rychlost vykonávání operací má vliv, jak jsou bloky dat čteny: sériově nebo náhodně. Při vykonávání několika operací přístupu k datům na straně aplikace existuje pojem závislých operací. To je také žádoucí zohlednit. Vše to může pomoct vidět souhrn dat ze čítačů výkonu OS, systémů úložišť, serverů/hypervizorů, stejně jako pochopení specifik práce aplikací, DBMS a dalších „spotřebitelů“ diskových zdrojů.
A nakonec je nezbytné mít záložní kopie v aktuálním a funkčním stavu. Plán zálohování by měl být nastavován s ohledem na přijatelné hodnoty RPO pro podnikání a pravidelně je nutné kontrolovat integritu záložních kopií (mnoho výrobců zálohovacího softwaru implementovalo do svých produktů automatizovanou kontrolu) pro zajištění přijatelných hodnot RTO.
Děkujeme, že jste dočetli až do konce.
Jsme připraveni odpovědět na vaše otázky a připomínky v komentářích. Také, ve kterém pravidelně pořádáme akce (slevy na IaaS a losování o promo kódy až do 100% na VPS), píšeme zajímavé novinky a oznamujeme nové články na blogu Habra.
Zdroj: habr.com
