

Ahoj, Habr! Představuji vám překlad článku autorů Burak Yavuz, Brenner Heintz a Denny Lee, který byl připraven na zahájení kurzu od OTUS.
Data, stejně jako naše zkušenosti, se neustále shromažďují a vyvíjejí. Abychom nezůstali pozadu, naše mentální modely světa se musí přizpůsobit novým datům, z nichž některá obsahují nové dimenze — nové způsoby, jak pozorovat věci, o kterých jsme dříve neměli ponětí. Tyto mentální modely se od sebe málo liší od schémat tabulek, které určují, jak klasifikujeme a zpracováváme nové informace.
To nás přivádí k otázce správy schémat. Jak se obchodní úkoly a požadavky v průběhu času mění, mění se také struktura vašich dat. Delta Lake umožňuje snadno implementovat nové dimenze při změně dat. Uživatelé mají přístup k jednoduché sémantice pro správu schémat svých tabulek. Tyto nástroje zahrnují vynucení schématu (Schema Enforcement), které chrání uživatele před neúmyslným znečištěním jejich tabulek chybami nebo nežádoucími daty, a také evoluci schématu (Schema Evolution), která umožňuje automaticky přidávat nové sloupce s cennými daty na odpovídající místa. V tomto článku se podíváme hlouběji na použití těchto nástrojů.
Porozumění schématům tabulek
Každý DataFrame v Apache Spark obsahuje schéma, které definuje formu dat, jako jsou datové typy, sloupce a metadata. Pomocí Delta Lake se schéma tabulky zachovává ve formátu JSON uvnitř transakčního protokolu.
Co je to vynucení schématu?
Vynucení schématu (Schema Enforcement), také známé jako ověřování schématu (Schema Validation), je ochranný mechanismus v Delta Lake, který zaručuje kvalitu dat tím, že odmítá záznamy, které neodpovídají schématu tabulky. Podobně jako hosteska na recepci v oblíbené restauraci, která přijímá pouze s předchozí rezervací, kontroluje, zda každý sloupec dat, který je vkládán do tabulky, patří do příslušného seznamu očekávaných sloupců (jinými slovy, zda pro každý z nich existuje „rezervace“) a odmítá jakékoli záznamy se sloupci, které nejsou na seznamu.
Jak funguje vynucení schématu?
Delta Lake používá kontrolu schématu při zápisu, což znamená, že všechny nové záznamy do tabulky jsou během zápisu kontrolovány na shodu se schématem cílové tabulky. Pokud není schéma kompatibilní, Delta Lake transakci zcela zruší (data nejsou zapsána) a vyvolá výjimku, aby uživatele informoval o nesouladu.
Pro určení kompatibility záznamu s tabulkou Delta Lake používá následující pravidla. Zapisovaný DataFrame:
- nesmí obsahovat další sloupce, které nejsou ve schématu cílové tabulky. Naopak, pokud vstupní data neobsahují naprosto všechny sloupce z tabulky, je to v pořádku — těmto sloupcům budou jednoduše přiřazeny nulové hodnoty.
- nesmí mít datové typy sloupců, které se liší od typů dat sloupců v cílové tabulce. Pokud sloupec cílové tabulky obsahuje data typu StringType, ale odpovídající sloupec v DataFrame obsahuje data typu IntegerType, vynucení schématu vyvolá výjimku a zabrání provedení operace zápisu.
- nesmí obsahovat názvy sloupců, které se liší pouze velikostí písmen. To znamená, že nemůžete mít sloupce s názvy ‘Foo’ a ‘foo’ definované v jedné tabulce. Ačkoli Spark může být použit v režimu citlivém nebo necitlivém na velikost písmen (standardně necitlivém), Delta Lake zachovává velikost písmen, ale není citlivý při uchovávání schématu. Parquet je citlivý na velikost písmen při ukládání a vracení informací o sloupcích. Abychom se vyhnuli možným chybám, poškození dat nebo jejich ztrátě (s čímž jsme se osobně setkali v Databricks), rozhodli jsme se přidat toto omezení.
Abychom to ilustrovali, pojďme se podívat na to, co se děje v níže uvedeném kódu, když se pokusíme přidat některé nedávno vygenerované sloupce do tabulky Delta Lake, která ještě není nastavena na jejich přijetí.
# Сгенерируем DataFrame ссуд, который мы добавим в нашу таблицу Delta Lake
loans = sql("""
            SELECT addr_state, CAST(rand(10)*count as bigint) AS count,
            CAST(rand(10) * 10000 * count AS double) AS amount
            FROM loan_by_state_delta
            """)

# Вывести исходную схему DataFrame
original_loans.printSchema()

root
  |-- addr_state: string (nullable = true)
  |-- count: integer (nullable = true)

# Вывести новую схему DataFrame
loans.printSchema()

root
  |-- addr_state: string (nullable = true)
  |-- count: integer (nullable = true)
  |-- amount: double (nullable = true) # new column

# Попытка добавить новый DataFrame (с новым столбцом) в существующую таблицу
loans.write.format("delta")
           .mode("append")
           .save(DELTALAKE_PATH)

Returns:

A schema mismatch detected when writing to the Delta table.

To enable schema migration, please set:
'.option("mergeSchema", "true")'

Table schema:
root
-- addr_state: string (nullable = true)
-- count: long (nullable = true)

Data schema:
root
-- addr_state: string (nullable = true)
-- count: long (nullable = true)
-- amount: double (nullable = true)

If Table ACLs are enabled, these options will be ignored. Please use the ALTER TABLE command for changing the schema.
Místo automatického přidávání nových sloupců Delta Lake prosazuje schéma a zastavuje zápis. Abychom pomohli určit, který sloupec (nebo jich více) je příčinou nesouladu, Spark vypíše obě schémata z trasování zásobníku pro porovnání.
Jaký je přínos vynucení schématu?
Protože vynucené použití schématu představuje poměrně přísnou kontrolu, je skvělým nástrojem pro zajištění čistého, plně transformovaného souboru dat, který je připraven pro výrobu nebo spotřebu. Obvykle se aplikuje na tabulky, které přímo poskytují data:
- Algoritmy strojového učení
- BI dashboardy
- Analytiku dat a vizualizační nástroje
- Jakýkoli výrobní systém vyžadující přísně strukturované, přísně typizované sémantické schémata.
Aby připravili svá data na tuto závěrečnou překážku, mnoho uživatelů používá jednoduchou architekturu „multi-hop“, která postupně vkládá strukturu do jejich tabulek. Chcete-li se o tom dozvědět více, můžete si přečíst článek
Samozřejmě, že vynucené použití schématu lze použít kdekoli ve vašem pipeline, ale mějte na paměti, že streamování zápisu do tabulky může být frustrující, pokud jste například zapomněli, že jste přidali další sloupec do příchozích dat.
Prevence zředění dat
V tuto chvíli se můžete ptát, proč je kolem toho takový rozruch? Nakonec, občas může nepředvídatelná chyba „neshodnosti schématu“ podrazit nohy vaší pracovnímu procesu, zejména pokud jste nováčkem v Delta Lake. Proč prostě nedovolit schématu změnit se, jak potřebuje, abych mohl svou datovou sadu zapsat, bez ohledu na okolnosti?
Jak říká staré přísloví, „unce prevence za kilogram léčby“. V určitém okamžiku, pokud se nestaráte o aplikaci svého schématu, se mohou na povrch dostat problémy s kompatibilitou typů dat — na první pohled homogenní zdroje surových dat mohou obsahovat okrajové případy, poškozené sloupce, nesprávně utvořené mapování nebo jiné hrůzy, které se vám sní o nočních můrách. Nejlepší přístup je zastavit tyto nepřátele u bran — pomocí vynuceného použití schématu — a vyřešit je na světle, namísto později, když začnou prohlížet ve tmě vašeho pracovního kódu.
Povinné prosazení schématu zajišťuje, že schéma vaší tabulky se nezmění, pokud sami nepotvrdíte variantu změny. Zabraňuje „zředění“ (dilution) dat, které může nastat, když jsou nové sloupce přidávány tak často, že dříve hodnotné, komprimované tabulky ztrácejí svou hodnotu a užitečnost v důsledku zaplavení daty. Tím, že vás povzbudí k tomu, abyste byli záměrní, nastavili vysoké standardy a očekávali vysokou kvalitu, povinné prosazení schématu dělá přesně to, k čemu bylo určeno – pomáhá vám zůstat svědomití a vašim tabulkám zůstávat čisté.
Pokud při dalším zvažování zjistíte, že vlastně je třeba chcete přidat nový sloupec – žádný problém, níže je jednorázové řešení. Řešení – evoluce schématu!
Co je evoluce schématu?
Evoluce schématu je funkce, která uživatelům umožňuje snadno měnit aktuální schéma tabulky podle dat, která se v průběhu času mění. Nejčastěji se používá při provádění operace přidání nebo přepsání, aby automaticky přizpůsobila schéma tak, aby zahrnovalo jeden nebo více nových sloupců.
Jak funguje evoluce schématu?
Následujícím příkladem z předchozího oddílu mohou vývojáři snadno použít evoluci schématu k přidání nových sloupců, které byly dříve zamítnuty kvůli nesouladu se schématem. Evoluce schématu se aktivuje přidáním .option('mergeSchema', 'true') k vašemu Spark příkazu .write nebo .writeStream.
# Добавьте параметр mergeSchema
loans.write.format("delta")
           .option("mergeSchema", "true")
           .mode("append")
           .save(DELTALAKE_SILVER_PATH)
Chcete-li zobrazit graf, proveďte následující Spark SQL dotaz
# Создайте график с новым столбцом, чтобы подтвердить, что запись прошла успешно
%sql
SELECT addr_state, sum(`amount`) AS amount
FROM loan_by_state_delta
GROUP BY addr_state
ORDER BY sum(`amount`)
DESC LIMIT 10 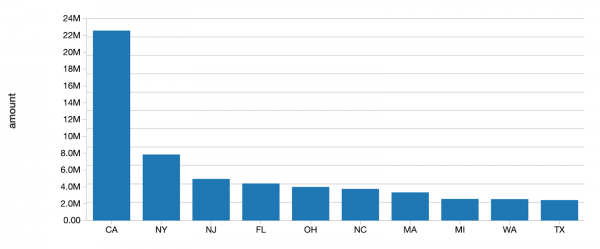
Alternativně můžete tento parametr nastavit pro celou Spark relaci přidáním spark.databricks.delta.schema.autoMerge = True do konfigurace Spark. Ale buďte opatrní, protože povinné prosazení schématu vás již nebude varovat před neúmyslnými nesoulady se schématem.
Přidáním parametru mergeSchema, všechny sloupce, které jsou přítomny v DataFrame, ale chybí v cílové tabulce, se automaticky přidávají na konec schématu v rámci transakce zápisu. Také mohou být přidána vnořená pole, a také budou přidána na konec odpovídajících sloupců struktury.
Inženýři a vědci mohou tuto možnost využít k přidání nových sloupců (např. nedávno sledované metriky nebo sloupec pro prodeje za tento měsíc) do svých stávajících výrobních tabulek strojového učení, aniž by došlo k narušení stávajících modelů založených na starých sloupcích.
Následující typy změn schématu jsou povoleny v rámci evoluce schématu při přidávání nebo přepisování tabulky:
- Přidání nových sloupců (to je nejběžnější scénář)
- Změna datových typů z NullType -> jakýkoli jiný typ nebo zvýšení z ByteType -> ShortType -> IntegerType
Další změny, které nejsou povoleny v rámci evoluce schématu, vyžadují, aby bylo schéma a data přepsána přidáním .option("overwriteSchema", "true"). Například pokud byl sloupec "Foo" původně integer, a nové schéma by bylo typu String, pak by všechny soubory Parquet (data) musely být přepsány. Mezi tyto změny patří:
- odstranění sloupce
- změna datového typu existujícího sloupce (na místě)
- přejmenování sloupců, které se liší pouze velikostí písmen (např. "Foo" a "foo")
Nakonec, s následující verzí Spark 3.0 bude plně podporována explicitní DDL (s využitím ALTER TABLE), což umožní uživatelům provádět následující akce nad schématy tabulek:
- přidání sloupců
- změna komentářů k sloupcům
- nastavení vlastností tabulky, které určují chování tabulky, například nastavení doby uchovávání transakčního protokolu.
Jaké jsou výhody evoluce schématu?
Evoluci schématu můžete využít vždy, když plánujete změnit schéma své tabulky (na rozdíl od případů, kdy jste omylem přidali do svého DataFrame sloupce, které by tam neměly být). To je nejjednodušší způsob, jak migrovat vaše schéma, protože automaticky přidává správné názvy sloupců a datové typy bez nutnosti jejich explicitního vyhlašování.
Závěr
Povinné použití schématu odmítá jakékoli nové sloupce nebo jiné změny schématu, které nejsou kompatibilní s vaší tabulkou. Stanovením a dodržováním těchto vysokých standardů se analytici a inženýři mohou spolehnout na to, že jejich data mají nejvyšší úroveň integrity, přičemž jasně formulují své myšlenky, což jim umožňuje přijímat efektivnější obchodní rozhodnutí.
Na druhé straně evoluce schématu doplňuje povinné použití, zjednodušující předpokládané automatické změny schématu. Nakonec by to nemělo být komplikované – přidat sloupec.
Povinné použití schématu je jang, zatímco evoluce schématu je jin. Společně tyto funkce usnadňují potlačení šumu a ladění signálu jako nikdy předtím.
Rádi bychom také poděkovali Mukulovi Murti a Pranavovi Anandovi za jejich příspěvek k tomuto článku.
Další články v této sérii:
Články na téma
Zdroj: habr.com
