

TL;DR: Před čtyřmi lety jsem opustil Google s myšlenkou na nový nástroj pro monitorování serverů. Myšlenka spočívala v tom, že spojíme do jedné služby obvykle izolované funkce, a analýzy logů, sběru metrik, a řídicích panelů. Jedním z principů je, že služba by měla být skutečně rychlá, což usnadňuje devops týmům lehkou, interaktivní a příjemnou práci. To vyžaduje zpracování datových sad o několika gigabajtech během zlomků sekundy, aniž bychom překročili rozpočet. Stávající nástroje na práci s logy jsou často pomalé a neohrabané, a tak jsme čelili zajímavému úkolu: správně navrhnout nástroj, který poskytne uživatelům nové zkušenosti z práce.
V tomto článku popisujeme, jak jsme ve Scalyr vyřešili tento problém, použitím metod staré školy, hrubého přístupu, zbavit se zbytečných vrstev a vyhnout se složitým datovým strukturám. Tyto lekce můžete aplikovat na vlastní inženýrské úkoly.
Síla staré školy
Analýza logů obvykle začíná vyhledáváním: najít všechna zprávy, které odpovídají určitému vzoru. V Scalyr to zahrnuje desítky nebo stovky gigabajtů logů z mnoha serverů. Moderní přístupy obvykle zahrnují vytváření složité datové struktury, optimalizované pro vyhledávání. Samozřejmě jsem toto viděl v Google, kde jsou v těchto věcech docela pádní. Ale my jsme se zastavili u mnohem hrubšího přístupu: lineárního prohledávání logů. A to fungovalo — nabízíme rozhraní s vyhledáváním, které je o řád rychlejší než u konkurence (podívejte se na animaci na konci).
Klíčovým poznatkem bylo, že moderní procesory jsou opravdu velmi rychlé v jednoduchých, přímých operacích. To je snadné opomenout ve složitých, mnohovrstevných systémech, které závisí na rychlosti I/O a síťových operacích a takové systémy jsou dnes velmi rozšířené. Vyvinuli jsme tedy design, který minimalizuje počet vrstev a zbytečného balastu. S několika procesory a servery paralelně dosahujeme rychlosti vyhledávání až 1 TB za sekundu.
Klíčové poznatky z tohoto článku:
- Hrubé prohledávání je zcela životaschopný přístup k řešení skutečných, rozsáhlých problémů.
- Hrubá síla je technika návrhu, nikoli zbavení se práce. Stejně jako každá technika se lépe hodí k některým problémům než k jiným a může být realizována špatně nebo dobře.
- Hrubá síla je obzvlášť dobrá pro dosažení stabilním výkonu.
- Efektivní využití hrubé síly vyžaduje optimalizaci kódu a včasné nasazení dostatečného množství zdrojů. Je vhodná, pokud jsou vaše servery pod velkou zátěží, která nesouvisí s uživateli, přičemž uživatelské operace zůstávají prioritou.
- Výkon závisí na designu celého systému, nikoli pouze na algoritmu interní smyčky.
(Tento článek se zabývá vyhledáváním dat v paměti. Většinou, když uživatel provádí vyhledávání v logách, servery Scalyr je již ukládaly do cache. V dalším článku prodiskutujeme vyhledávání v nekamizovaných logách. Používají se ty samé principy: efektivní kód, metoda hrubé síly s velkými výpočetními zdroji).
Metoda hrubé síly
Tradicionalně se vyhledávání ve velkém souboru dat provádí podle indexu klíčových slov. V případě serverových logů to znamená hledání každého unikátního slova v záznamu. Pro každé slovo je třeba sestavit seznam všech výskytů. To umožňuje snadno najít všechny zprávy s tímto slovem, jako například 'error', 'firefox' nebo 'transaction_16851951' — jednoduše se podíváme do indexu.
Takový přístup jsem používal ve společnosti Google a fungoval dobře. Ale ve Scalyr hledáme v logech byte po bytu.
Proč? Z abstraktní algoritmické perspektivy jsou indexy klíčových slov mnohem efektivnější než hrubé vyhledávání. Avšak neprodáváme algoritmy, prodáváme výkon. A výkon není jen o algoritmech, ale také o systémovém inženýrství. Musíme brát v úvahu vše: objem dat, typ vyhledávání, dostupný hardware a programový kontext. Rozhodli jsme se, že pro náš konkrétní problém je varianta jako 'grep' lepší než index.
Indexy jsou skvělé, ale mají svá omezení. Jedno slovo najít snadno. Ale vyhledávat zprávy se dvěma slovy, jako jsou 'googlebot' a '404', už je mnohem složitější. Hledání fráze jako 'uncaught exception' vyžaduje objemnější index, který zaznamenává nejen všechny zprávy s tímto slovem, ale i konkrétní umístění slova.
Skutečná obtíž nastává, když nehledáte slova. Představte si, že chcete zjistit, kolik provozu pochází od botů. První myšlenka je hledat v logách podle slova ‘bot’. Tak najdete některé boty: Googlebot, Bingbot a mnohé další. Ale zde je ‘bot’ část slova, nikoli celé slovo. Když hledáte ‘bot’ v indexu, nenajdete zprávy obsahující slovo ‘Googlebot’. Pokud kontrolujete každé slovo v indexu a poté skenujete index podle nalezených klíčových slov, hledání se výrazně zpomalí. V důsledku toho některé programy pro práci s logy neumožňují hledání podle částí slova nebo (v lepším případě) umožňují používat speciální syntaxi s nižší výkonem. Chceme se tomuto vyhnout.
Dalším problémem je interpunkce. Chcete najít všechny dotazy od 50.168.29.7? Что насчёт отладки логов, содержащих [error]? Индексы обычно пропускают пунктуацию.
Nakonec inženýři milují výkonné nástroje a někdy lze problém vyřešit pouze pomocí regulárních výrazů. Klíčový index není pro to příliš vhodný.
Kromě toho jsou indexy složitější. Každou zprávu je třeba přidat do několika seznamů klíčových slov. Tyto seznamy by měly být vždy udržovány v snadno vyhledávatelném formátu. Dotazy obsahující fráze, fragmenty slov nebo regulární výrazy je třeba převést na operace s několika seznamy a výsledky skenovat a spojovat pro získání výsledné sady. V kontextu rozsáhlé vícerozměrné služby taková složitost vytváří problémy s výkonem, které nejsou při analýze algoritmů patrné.
Indexy klíčových slov také zabírají hodně místa a úložiště je hlavní položkou výdajů v systému správy logů.
Na druhou stranu, na každý vyhledávání lze vynaložit hodně výpočetní síly. Naši uživatelé oceňují vysokorychlostní vyhledávání na unikátní dotazy, ale takové dotazy jsou poměrně vzácné. Pro typické vyhledávací dotazy, například pro panel monitorování, používáme speciální techniky (ty popíšeme v příštím článku). Jiné dotazy jsou dost vzácné, takže se často zpracovává jen jeden najednou. Ale to neznamená, že naše servery nejsou vytíženy: jsou zatíženy prací přijímaní, analýzou a kompresí nových zpráv, hodnocením upozornění, kompresí starých dat a podobně. Takže máme poměrně značnou rezervu procesorů, které lze využít k provádění dotazů.
Hrubá síla funguje, pokud máte hrubý problém (a hodně síly)
Hrubá síla nejlépe funguje na jednoduchých úlohách s malými vnitřními smyčkami. Často můžete optimalizovat vnitřní smyčku pro fungování při velmi vysokých rychlostech. Pokud je kód složitý, je mnohem těžší ho optimalizovat.
Původně měl náš kód pro vyhledávání poměrně velkou vnitřní smyčku. Uchováváme zprávy na stránkách po 4K; každá stránka obsahuje některé zprávy (v UTF-8) a metadata pro každou zprávu. Metadata jsou struktura, ve které jsou zakódovány délka hodnoty, vnitřní ID zprávy a další pole. Smyčka vyhledávání vypadala takto:
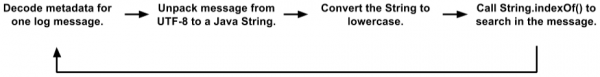
Toto je zjednodušená verze ve srovnání s skutečným kódem. Ale i zde je vidět několik přiřazení objektu, kopií dat a volání funkcí. JVM docela dobře optimalizuje volání funkcí a přiděluje efemérní objekty, takže tento kód fungoval lépe, než jsme si zasloužili. Během testování s ním klienti docela úspěšně pracovaly. Ale nakonec jsme přešli na novou úroveň.
(Můžete se ptát, proč ukládáme zprávy tímto způsobem na stránkách o velikosti 4K, textem a metadata, a nepracujeme přímo s logy. Existuje mnoho důvodů, které spočívají v tom, že vnitřní engine Scalyr se více podobá distribuované databázi než souborovému systému. Textové vyhledávání se často kombinuje s filtry ve stylu DBMS na polích po analýze logů. Můžeme hledat v tisících logů současně a jednoduché textové soubory pro naše transakční, replikované, distribuované řízení dat nevyhovují.)
Původně se zdálo, že tento kód není příliš vhodný pro optimalizaci pomocí metody hrubé síly. "Skutečná práce" v String.indexOf() ani nepřevládala v profilu CPU. To znamená, že optimalizace pouze této metody by nepřinesla výrazný efekt.
Jak se ukázalo, ukládáme metadata na začátku každé stránky, zatímco text všech zpráv je ve formátu UTF-8 zabalen na jiném konci. Využili jsme toho a přepsali smyčku pro vyhledávání najednou na celé stránce:
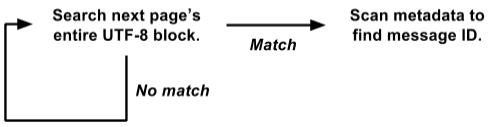
Tato verze funguje přímo na zobrazení raw byte[] a provádí vyhledávání všech zpráv najednou na celé stránce 4K.
Je to mnohem snazší optimalizovat pro metodu hrubé síly. Vnitřní vyhledávací smyčka je volána současně pro celou stránku 4K, nikoli jednotlivě pro každou zprávu. Není tu žádné kopírování dat ani alokace objektů. A složitější operace s metadaty jsou vyvolány pouze při pozitivním výsledku, nikoli pro každou zprávu. Tímto způsobem jsme vyloučili spoustu režijních nákladů a zbytek zátěže je soustředěn v malé vnitřní vyhledávací smyčce, která je vhodná pro další optimalizaci.
Náš skutečný vyhledávací algoritmus je založen na . Je podobný Boyer-Mooreovu algoritmu s přeskočením přibližně délky vyhledávacího řetězce při každém kroku. Hlavní rozdíl spočívá v tom, že kontroluje dva bajty najednou, aby minimalizoval falešné shody.
Naše implementace vyžaduje vytvoření vyhledávací tabulky 64K pro každý dotaz, ale to je směšné ve srovnání s gigabajty dat, ve kterých hledáme. Vnitřní cyklus zpracovává několik gigabajtů za sekundu na jednom jádře. V praxi stabilní výkon činí přibližně 1,25 GB za sekundu na každém jádře a existuje potenciál pro zlepšení. Některé overheady mimo vnitřní cyklus lze odstranit, a plánujeme experimentovat s vnitřním cyklem v C místo v Javě.
Aplikujeme sílu
Diskutovali jsme, že hledání v logách může být realizováno „hrubě“, ale kolik „síly“ máme? Ne až tak málo.
1 jádro: při správném využití je jedno jádro moderního procesoru samo o sobě poměrně výkonné.
8 jader: v současnosti pracujeme na serverech Amazon hi1.4xlarge a i2.4xlarge SSD, z nichž každý má 8 jader (16 vláken). Jak bylo zmíněno výše, obvykle jsou tato jádra zaměstnána na pozadí. Když uživatel provádí vyhledávání, pozadí se pozastaví, aby uvolnilo všech 8 jader pro vyhledávání. Vyhledávání obvykle trvá zlomky sekundy, po kterém se pozadí znovu spustí (regulační program zajišťuje, že nával vyhledávacích dotazů nenaruší důležité pozadí).
16 jader: pro spolehlivost organizujeme servery do skupin master/slave. Každý master má pod sebou jeden SSD server a jeden EBS. Pokud hlavní server selže, SSD server okamžitě zaujme jeho místo. Většinu času pracují master i slave normálně, takže každý blok dat je dostupný pro vyhledávání na dvou různých serverech (podřízený server EBS má slabší procesor, takže ho nezvažujeme). Rozdělujeme úkol mezi ně, takže celkově máme k dispozici 16 jader.
Mnoho jader: v blízké budoucnosti rozdělíme data mezi servery tak, aby všechny se podílely na zpracování každého netriviálního dotazu. Každé jádro bude pracovat. [Poznámka: realizovali jsme plán a zvýšili rychlost vyhledávání na 1 TB/s, viz poznámku na konci článku].
Jednoduchost zajišťuje spolehlivost
Další výhodou metody hrubé síly je poměrně stabilní výkon. Obecně platí, že vyhledávání není příliš citlivé na detaily úkolu a datového souboru (myslím, že proto se mu říká „hrubé“).
Index klíčových slov někdy poskytuje neuvěřitelně rychlý výsledek, zatímco jindy ne. Předpokládejme, že máte 50 GB logů, kde se termín 'customer_5987235982' objevuje přesně třikrát. Vyhledávání podle tohoto termínu počítá přímo z indexu tři umístění a skončí okamžitě. Ale složité vyhledávání s divokými znaky může skenovat tisíce klíčových slov a trvat dlouho.
Na druhou stranu, hledání metodou hrubé síly probíhá s více či méně stejnou rychlostí pro jakýkoli dotaz. Hledání dlouhých slov je lepší, ale i vyhledání jednoho znaku probíhá dostatečně rychle.
Jednoduchost metody hrubé síly znamená, že její výkon je blízký teoretickému maximu. Tady je méně možností pro nečekané přetížení disků, konflikty při zámcích, hone pointer a tisíce dalších důvodů pro selhání. Právě jsem se podíval na dotazy od uživatelů Scalyr minulý týden na našem nejvytíženějším serveru. Bylo 14 000 dotazů. Přesně osm z nich trvalo více než jednu sekundu; 99% bylo provedeno v rámci 111 milisekund (pokud jste nepoužívali nástroje pro analýzu logů, věřte mi: to je rychlé.).
Stabilní, spolehlivý výkon je důležitý pro uživatelskou přívětivost služby. Pokud občas zpomaluje, uživatelé ji budou považovat za nespolehlivou a neochotně ji používat.
Vyhledávání v logách v akci
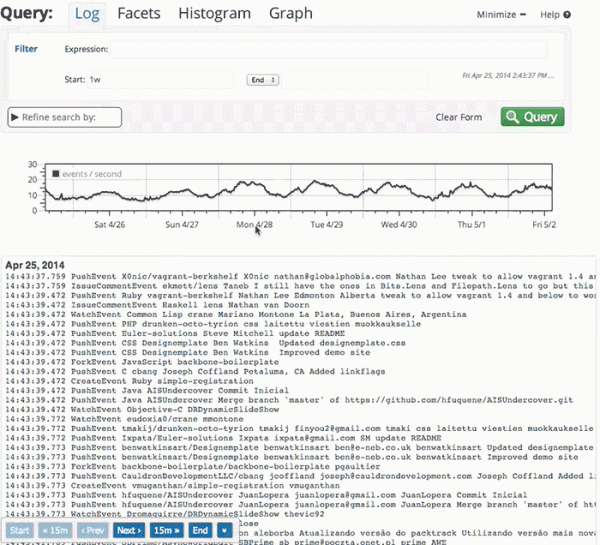
Tady je malá animace, která ukazuje vyhledávání Scalyr v akci. Máme demo účet, kde importujeme každou událost z každého veřejného repozitáře Github. V této ukázce zkoumám data za týden: přibližně 600 MB neprozkoumaných logů.
Video bylo nahráno naživo, bez zvláštní přípravy, na mém desktopu (asi 5000 kilometrů od serveru). Výkon, který uvidíte, je z velké části dán , a také rychlým a spolehlivým backendem. Kdykoli dojde k pauze bez indikátoru 'loading', dělám pauzu, abyste si stihli přečíst, co budu chtít stisknout.
Na závěr
Při zpracování velkých objemů dat je důležité vybrat dobrý algoritmus, ale „dobrý“ neznamená „složitý“. Zamyslete se nad tím, jak váš kód bude fungovat v praxi. V teoretické analýze algoritmů se opomíjejí některé faktory, které mohou mít velký význam v reálném světě. Jednodušší algoritmy jsou snáze optimalizovatelné a stabilnější v krizových situacích.
Také zvažte kontext, v němž se kód bude vykonávat. V našem případě potřebujeme dostatečně výkonné servery pro správu pozadí. Uživatelé relativně zřídka iniciují vyhledávání, takže si můžeme půjčit celou skupinu serverů na krátké období nezbytné pro provedení každého vyhledávání.
Metodou hrubé síly jsme implementovali rychlé, spolehlivé a flexibilní vyhledávání v sadě logů. Doufáme, že tyto myšlenky budou užitečné pro vaše projekty.
Úprava: název a text se změnily z „Vyhledávání rychlostí 20 GB za sekundu“ na „Vyhledávání rychlostí 1 TB za sekundu“, aby odrážely zvýšení výkonu za posledních několik let. Tento nárůst rychlosti je především spojen s přechodem na nový typ a množství serverů EC2, které dnes nasazujeme pro obsluhu rostoucího počtu zákazníků. V nejbližší době očekáváme změny, které zajistí další výrazné zvýšení efektivity, a těšíme se, až o tom budeme moci říct více.
Zdroj: habr.com
