

Před šesti měsíci — veřejný na PostgreSQL.
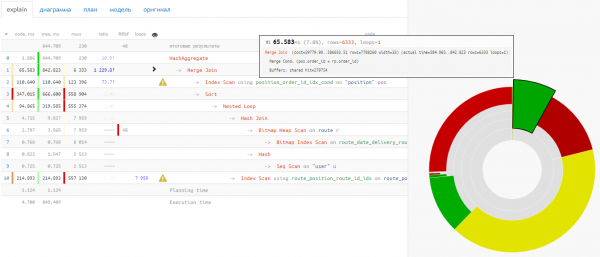
Během uplynulých měsíců jsme o něm , připravili shrnující na základě doporučení, která poskytuje... ale co je nejdůležitější — shromáždili jsme vaše názory a sledovali skutečné případy použití.
A nyní jsme připraveni informovat o nových funkcích, které můžete využívat.
Podpora různých formátů plánů
Plán z logu, společně s dotazem
Vybereme celý blok přímo z konzole, počínaje řádkem s Text dotazu, se všemi vedoucími mezerami:
        Text dotazu: INSERT INTO dicquery_20200604 VALUES ($1.*) ON CONFLICT (query)
                           DO NOTHING;
        Insert on dicquery_20200604 (cost=0.00..0.05 rows=1 width=52) (actual time=40.376..40.376 rows=0 loops=1)
          Conflict Resolution: NOTHING
          Conflict Arbiter Indexes: dicquery_20200604_pkey
          Tuples Inserted: 1
          Conflicting Tuples: 0
          Buffers: shared hit=9 read=1 dirtied=1
          -> Result (cost=0.00..0.05 rows=1 width=52) (actual time=0.001..0.001 rows=1 loops=1)
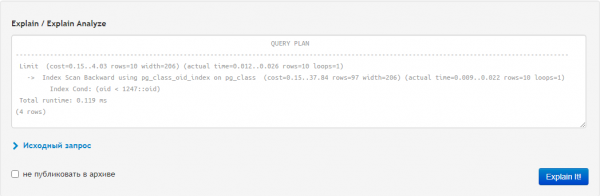
… a vložíme vše zkopírované přímo do pole pro plán, nic neoddělujeme:
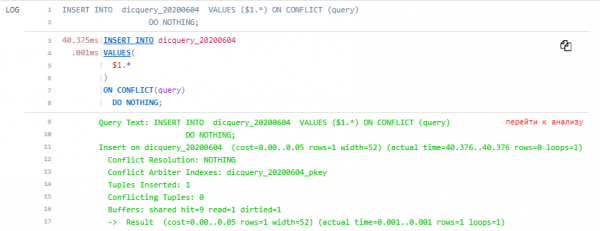
Na výstupu získáme jako bonus k rozebranému plánu také záložku „kontext“, kde je náš dotaz prezentován v celé své kráse:
JSON a YAML
EXPLAIN (ANALYZE, BUFFERS, FORMAT JSON)
SELECT * FROM pg_class;
"[
{
"Plan": {
"Node Type": "Seq Scan",
"Parallel Aware": false,
"Relation Name": "pg_class",
"Alias": "pg_class",
"Startup Cost": 0.00,
"Total Cost": 1336.20,
"Plan Rows": 13804,
"Plan Width": 539,
"Actual Startup Time": 0.006,
"Actual Total Time": 1.838,
"Actual Rows": 10266,
"Actual Loops": 1,
"Shared Hit Blocks": 646,
"Shared Read Blocks": 0,
"Shared Dirtied Blocks": 0,
"Shared Written Blocks": 0,
"Local Hit Blocks": 0,
"Local Read Blocks": 0,
"Local Dirtied Blocks": 0,
"Local Written Blocks": 0,
"Temp Read Blocks": 0,
"Temp Written Blocks": 0
},
"Planning Time": 5.135,
"Triggers": [
],
"Execution Time": 2.389
}
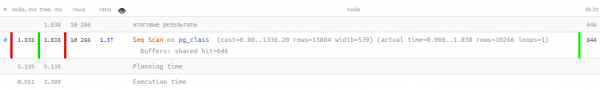
]"Ať už s vnějšími uvozovkami, jak je kopíruje pgAdmin, nebo bez — hodíme to do stejného pole, a výsledkem je krása:
Pokročilá vizualizace
Čas plánování / Čas provádění
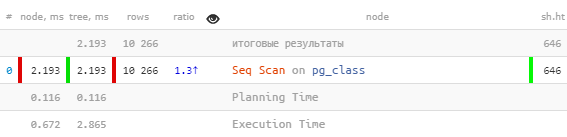
Nyní je lépe vidět, kam se dostalo další čas při provádění dotazu:
I/O Timing
Někdy se člověk setkává se situací, kdy v plánu se nezdá, že by se četlo nebo psalo příliš mnoho zdrojů, ale přesto je doba provádění nějak nesmírně dlouhá.
Musíme říct: "Omlouvám se, možná byl v tu chvíli disk na serveru příliš přetížen, proto se četlo tak dlouho!" Ale to není příliš přesné…
Ale můžete to určit naprosto spolehlivě. Jde o to, že mezi možnostmi konfigurace PG serveru je :
Zapojuje měření času vstupních/výstupních operací. Tento parametr je ve výchozím nastavení vypnutý, protože pro jeho fungování je nutné neustále dotazovat operační systém na aktuální čas, což může na některých platformách výrazně zpomalit výkon. Pro zhodnocení nákladů na měření času na vaší platformě můžete využít nástroj pg_test_timing. Statistiky vstupů/výstupů lze získat pomocí pohledu pg_stat_database, v výstupu EXPLAIN (když je použit parametr BUFFERS) a prostřednictvím pohledu pg_stat_statements.
Tento parametr lze také povolit v rámci místní relace:
SET track_io_timing = TRUE;A teď to nejlepší – naučili jsme se tyto údaje chápat a zobrazovat je s ohledem na všechny transformace vykonávacího stromu:
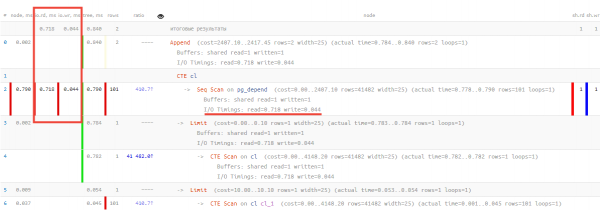
Tady lze vidět, že ze 0.790 ms celkového času vykonání zabralo 0.718 ms načtení jedné stránky dat, 0.044 ms – její zápis, a na veškerou ostatní užitečnou činnost bylo využito pouhých 0.028 ms!
Budoucnost s PostgreSQL 13
Celý přehled novinek si můžete prohlédnout , a my se konkrétně zaměříme na změny v plánech.
Planning buffers
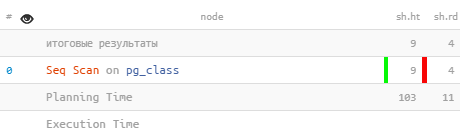
Zohlednění zdrojů vyhrazených plánovači se odrazilo také v jednom dalším patchi, který se netýká pg_stat_statements. EXPLAIN s volbou BUFFERS bude uvádět počet bufferů použitých během plánování:
 Seq Scan on pg_class (actual rows=386 loops=1)
   Buffers: shared hit=9 read=4
 Planning Time: 0.782 ms
   Buffers: shared hit=103 read=11
 Execution Time: 0.219 ms
Inkrementální třídění
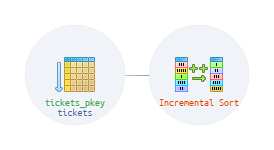
V případech, kdy je zapotřebí třídění podle mnoha klíčů (k1, k2, k3…), nyní může plánovač využít znalosti o tom, že data jsou již seřazena podle několika z prvních klíčů (např. k1 a k2). V tomto případě není nutné znovu přetřídit všechna data, ale lze je rozdělit do sekvenčních skupin se stejnými hodnotami k1 a k2 a „dopracovat“ podle klíče k3.
Takto se celé třídění rozpadá na několik sekvenčních třídění menší velikosti. To snižuje objem potřebné paměti a také umožňuje vydat první data dříve, než bude celé třídění dokončeno.
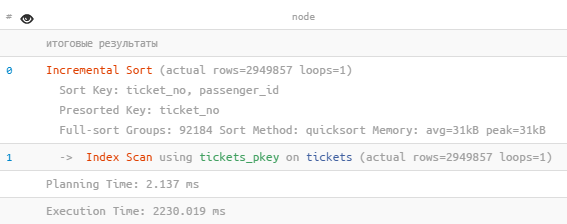
 Inkremální třídění (skutečné řádky=2949857 smyčky=1)
   Klíč třídění: ticket_no, passenger_id
   Předtříděný klíč: ticket_no
   Skupiny pro úplné třídění: 92184 Metoda třídění: quicksort Paměť: průměr=31kB vrchol=31kB
   ->  Indexové skenování pomocí tickets_pkey na tickets (skutečné řádky=2949857 smyčky=1)
 Čas plánování: 2.137 ms
 Čas provádění: 2230.019 ms
Vylepšení UI/UX
Snímek obrazovky, ten je všude!
Nyní na každé kartě přibyla možnost rychle vzít snímek obrazovky karty do schránky na celou šířku a hloubku karty — „zaměřovač“ vpravo nahoře:
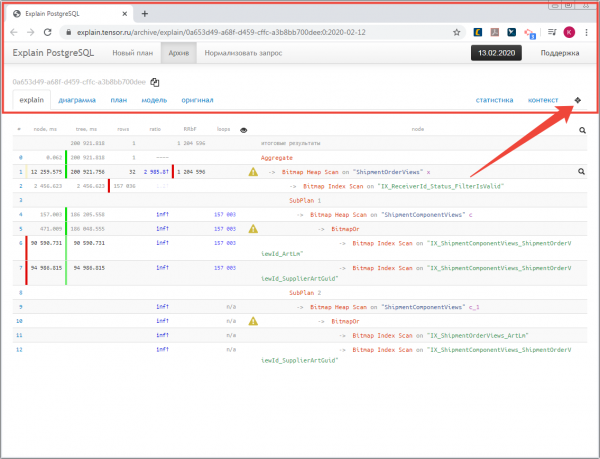
Vlastně, většina obrázků pro tuto publikaci byla získána právě takto.
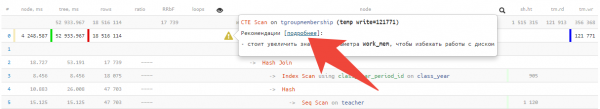
Doporučení na uzlech
Nejenže jich přibylo, ale o každém lze , přejdete-li na odkaz:
Odstranění z archivu
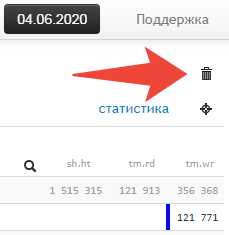
Někteří velmi žádali o přidání možnosti odstranit "úplně" i nepublikované plány v archivu — prosím, stačí stisknout odpovídající ikonu:
No, nezapomínáme, že máme , kam můžete psát své poznámky a návrhy.
Zdroj: habr.com
