

Efekt zvětšování tabulek a indexů (bloat) je široce známý a přítomný nejen v Postgresu. Existují způsoby, jak s ním bojovat „out of the box“ jako VACUUM FULL nebo CLUSTER, ale tyto operace blokují tabulky během práce a proto nemusí být vždy použity.
Článek bude obsahovat trochu teorie o tom, jak vzniká bloat, jak s ním lze bojovat, o odložených omezeních a o problémech, které přinášejí při použití rozšíření pg_repack.
Tento článek je napsán na základě na PgConf.Russia 2020.
Proč vzniká bloat
Základem Postgresu je vícerozměrný model (). Jeho podstatou je, že každý řádek v tabulce může mít několik verzí, přičemž transakce vidí maximálně jednu z těchto verzí, ale nemusí to být nutně stejná. To umožňuje, aby několik transakcí pracovalo současně a prakticky na sebe nevzájemně působilo.
Je zřejmé, že všechny tyto verze je třeba uchovávat. Postgres pracuje s pamětí po stránkách a stránka je minimální objem dat, který lze přečíst z disku nebo na něj zapsat. Podívejme se na malý příklad, abychom pochopili, jak to probíhá.
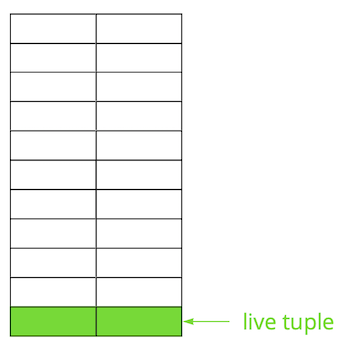
Představme si, že máme tabulku, do které jsme přidali několik záznamů. Na první stránce souboru, kde je tabulka uložena, se objevila nová data. To jsou živé verze řádků, které jsou dostupné jiným transakcím po potvrzení (pro zjednodušení budeme předpokládat, že úroveň izolace je Read Committed).
Poté jsme aktualizovali jeden ze záznamů a tím označili starou verzi jako neaktuální.
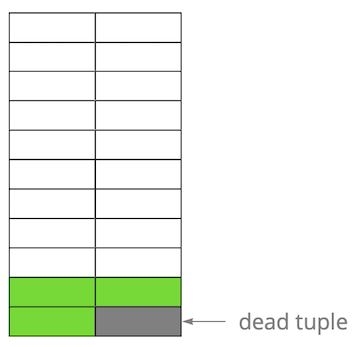
Krok za krokem, aktualizováním a odstraňováním verzí řádků, jsme dostali stránku, ve které je přibližně polovina dat „odpad“. Tato data nejsou viditelná žádné transakci.
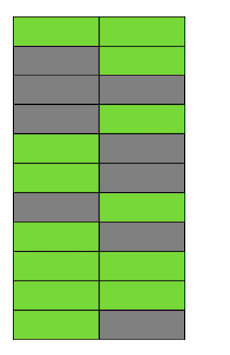
V Postgresu existuje mechanismus , který odstraňuje neaktuální verze a uvolňuje místo pro nová data. Ale pokud není nastaven příliš agresivně nebo je zaměstnán prací v jiných tabulkách, zůstávají nám „odpadní data“ a musíme používat další stránky pro nová data.
Tak v našem příkladu bude v určitém okamžiku tabulka skládat ze čtyř stránek, ale živých dat v ní bude pouze polovina. V důsledku toho, při přístupu k tabulce budeme číst mnohem více dat, než je potřeba.
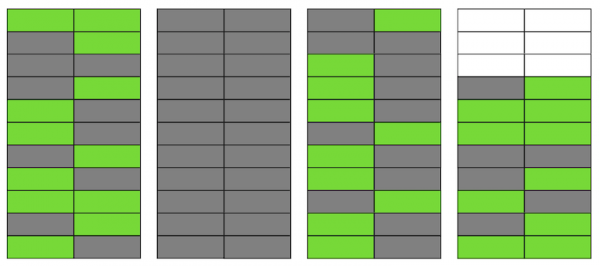
I když VACUUM nyní odstraní všechny neaktuální verze řádků, situace se zásadně nezlepší. Získáme volné místo na stránkách nebo dokonce celé stránky pro nové řádky, ale stejně budeme číst více dat, než je potřeba.
Mimochodem, pokud by se úplně prázdná stránka (druhá v našem příkladu) ocitla na konci souboru, VACUUM by ji mohl oříznout. Ale nyní je uprostřed, takže s ní nelze nic udělat.
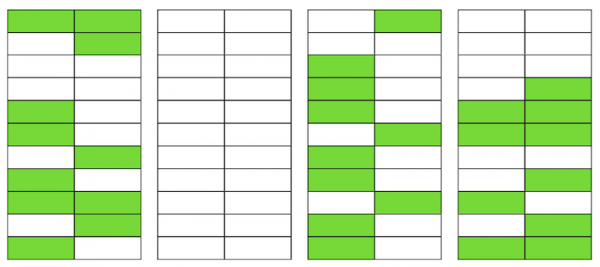
Když počet takových prázdných nebo silně vyprázdněných stránek vzroste, čemuž se říká bloat, začne to mít vliv na výkon.
Všechny výše popsané trendy ilustrují vznik bloat v tabulkách. V indexech se to děje zhruba stejně.
Mám nějaký bloat?
Existuje několik způsobů, jak určit, zda máte bloat. První myšlenka je využít interní statistiky Postgres, které obsahují přibližné informace o počtu řádků v tabulkách, počtu 'živých' řádků a podobně. Na internetu lze najít mnoho variací již hotových skriptů. Jako základ jsme vzali od PostgreSQL Experts, který dokáže ohodnotit bloat tabulek spolu s toast a bloat btree-indexy. Podle našich zkušeností je jeho chyba 10-20%.
Další způsob – použít rozšíření , které vám umožní nahlédnout do stránek a získat jak odhadované, tak přesné hodnoty bloat. Avšak v druhém případě bude potřeba proskenovat celou tabulku.
Malá hodnota bloat, do 20%, se považuje za přijatelnou. Může být považována za analog fillfactor pro a . Při 50% a více mohou nastat problémy s výkonem.
Způsoby, jak bojovat proti bloat
V Postgres existuje několik způsobů, jak bojovat proti bloat 'out of the box', avšak ne vždy a ne všem mohou vyhovovat.
Nastavit AUTOVACUUM, aby se bloat neobjevoval.. A pokud přesněji, aby se udržel na úrovni přijatelném pro vás. Zdá se, že je to „kapitánská“ rada, ale ve skutečnosti to není vždy snadné dosáhnout. Například pokud probíhá aktivní vývoj s pravidelnými změnami datových struktur nebo se provádí nějaká migrace dat. V důsledku toho se váš profil zatížení může často měnit a obvykle se liší pro různé tabulky. To znamená, že musíte neustále pracovat trochu dopředu a přizpůsobovat AUTOVACUUM měnícímu se profilu každé tabulky. Ale je jasné, že to není jednoduché.
Další běžnou příčinou, proč AUTOVACUUM nestíhá zpracovávat tabulky, jsou dlouhé transakce, které mu neumožňují vyčistit data, protože jsou dostupná těmto transakcím. Doporučení zde je také jasné - zbavit se „zavěšených“ transakcí a minimalizovat čas aktivních transakcí. Ale pokud je zátěž vašeho aplikace kombinací OLAP a OLTP, pak můžete mít současně jak spoustu častých aktualizací a krátkých dotazů, tak dlouhé operace - například sestavování nějakého reportu. V takovém případě stojí za úvahu rozdělení zátěže na různé databáze, což umožní lepší ladění každé z nich.
Další příklad - i když je profil homogenní, ale DB je pod velmi vysokou zátěží, pak i maximálně agresivní AUTOVACUUM nemusí stačit a bloat se bude objevovat. Škálování (vertikální nebo horizontální) je jediné řešení.
Jak tedy postupovat v situaci, kdy jste AUTOVACUUM nastavili, ale bloat pokračuje v růstu.
Tým VACUUM FULL přestavuje obsah tabulek a indexů a ponechává v nich pouze aktuální data. Pro odstranění bloatu funguje neomylně, ale během jejího provádění je získána exkluzivní blokace na tabulku (AccessExclusiveLock), která neumožňuje vykonávat dotazy na tuto tabulku, ani selecty. Pokud si můžete dovolit na nějakou dobu (od desítek minut do několika hodin v závislosti na velikosti DB a vašem hardwaru) zastavit váš servis nebo jeho část, je to nejlepší varianta. My, bohužel, nezvládáme provést VACUUM FULL během naplánované údržby, takže tento způsob pro nás není vhodný.
Tým CLUSTER také přestavuje obsah tabulek, stejně jako VACUUM FULL, přičemž umožňuje specifikovat index, podle kterého budou data fyzicky uspořádána na disku (ale pro nové řádky v budoucnu není pořadí zaručeno). V určitých situacích je to dobrá optimalizace pro řadu dotazů - při čtení několika záznamů podle indexu. Nevýhoda příkazu je stejná jako u VACUUM FULL – během jeho provádění blokuje tabulku.
Tým REINDEX je podobný dvěma předchozím, ale provádí přestavbu konkrétního indexu nebo všech indexů tabulky. Blokace jsou o něco slabší: ShareLock na tabulku (brání modifikacím, ale umožňuje provádět select) a AccessExclusiveLock na přestavovaný index (blokuje dotazy využívající tento index). V 12. verzi Postgres však byl přidán parametr , který umožňuje přestavbu indexu, aniž by blokoval paralelní přidávání, změny nebo odstraňování záznamů.
Ve starších verzích Postgres lze dosáhnout výsledku, který je podobný REINDEX CONCURRENTLY, pomocí . Tento příkaz umožňuje vytvořit index bez přísné blokace (ShareUpdateExclusiveLock, která nebrání paralelním dotazům), poté nahradí starý index novým a odstraní starý index. To umožňuje eliminovat bloat indexů, aniž by to narušilo činnost vaší aplikace. Je důležité vzít v úvahu, že při přestavbě indexů dojde k dodatečné zátěži diskového subsystému.
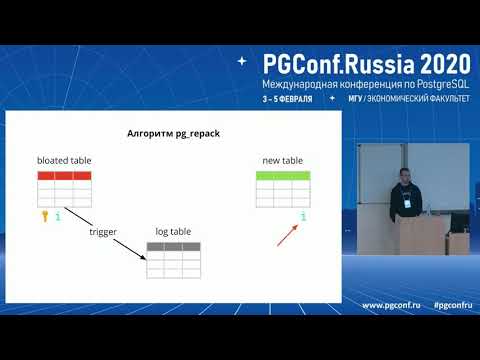
Takže pokud existují způsoby, jak eliminovat bloat pro indexy „za běhu“, pro tabulky tomu tak není. V tomto případě nastupují různé externí rozšíření: (dříve pg_reorg), , a další. V rámci tohoto článku je porovnávat nebudu a povím pouze o pg_repack, které po určitém vylepšení používáme u nás.
Jak funguje pg_repack
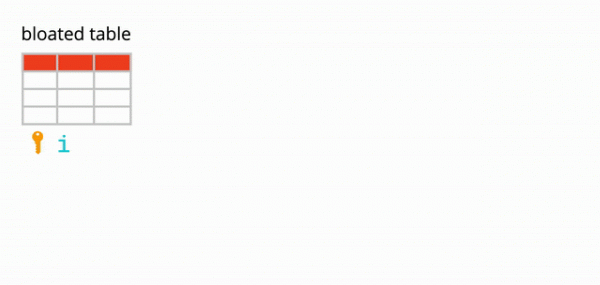
Představme si, že máme zcela obvyklou tabulku - s indexy, omezeními a, bohužel, s bloat. Prvním krokem pg_repack vytvoří log-tabuli, aby uchovávala data o všech změnách během práce. Spouštěč bude replikovat tyto změny při každém insertu, updatu a delete. Poté se vytvoří tabulka, která je strukturou podobná původní, ale bez indexů a omezení, aby se nezpomalil proces vkládání dat.
Dále pg_repack přesune do nové tabulky data ze staré, automaticky filtruje všechny neaktuální řádky a poté vytvoří indexy pro novou tabulku. Během provádění všech těchto operací se ve záznamové tabulce hromadí změny.
Dalším krokem je přesunout změny do nové tabulky. Přenos probíhá ve více iteracích a když v záznamové tabulce zůstane méně než 20 záznamů, pg_repack zablokuje tabulku, přesune poslední data a nahradí starou tabulku novou v systémových tabulkách Postgres. To je jediný a velmi krátký okamžik, kdy nebudete moci s tabulkou pracovat. Po tom je stará tabulka a tabulka se záznamy smazána a vefilesystemu se uvolní místo. Proces je dokončen.
Teoreticky všechno vypadá skvěle, co však v praxi? Otestovali jsme pg_repack bez zátěže a pod zátěží, zkontrolovali jsme jeho fungování v případě předčasného zastavení (jednoduše řečeno, stisknutím Ctrl+C). Všechny testy byly pozitivní.
Vyrazili jsme do produkce – a zde se všechno začalo odvíjet jinak, než jsme očekávali.
První test v produkci
Na prvním clusteru jsme obdrželi chybu porušení unikátního omezení:
$ ./pg_repack -t tablename -o id
INFO: repacking table "tablename"
ERROR: query failed:
    ERROR: duplicate key value violates unique constraint "index_16508"
DETAIL:  Key (id, index)=(100500, 42) already exists.
Toto omezení mělo automaticky generované jméno index_16508 – vytvořil ho pg_repack. Podle atributů, které obsahoval, jsme určili „naše“ omezení, které mu odpovídá. Problém byl v tom, že to není zcela běžné omezení, ale odložené (), t.j. jeho kontrola se provádí později než sql-příkaz, což vede k nečekaným následkům.
Odložené omezení: proč je potřebujeme a jak fungují
Trochu teorie o odložených omezeních.
Představme si jednoduchý příklad: máme tabulku referencí automobilů se dvěma atributy – názvem a pořadím automobilu v referenci.
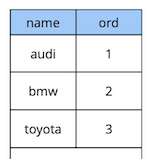
create table cars
(
  name text constraint pk_cars primary key,
  ord integer not null constraint uk_cars unique
);
Předpokládejme, že budeme potřebovat vyměnit první a druhý automobil. Řešení „přímo“ – aktualizovat první hodnotu na druhou a druhou na první:
begin;
  update cars set ord = 2 where name = 'audi';
  update cars set ord = 1 where name = 'bmw';
commit;
Avšak při provádění tohoto kódu očekávaně obdržíme porušení omezení, protože pořadí hodnot v tabulce je jedinečné:
[23305] CHYBA: duplicitní klíč porušuje unikátní omezení "uk_cars"
Detail: Klíč (ord)=(2) již existuje.
Jak to udělat jinak? První možnost: přidat dodatečnou náhradu hodnoty pořadí, která v tabulce zaručeně neexistuje, například "-1". V programování se tomu říká "výměna dvou proměnných přes třetí". Jedinou nevýhodou této metody je dodatečný update.
Druhá možnost: přeprojektovat tabulku tak, aby pro hodnotu pořadí byl použit typ dat s plovoucí desetinnou čárkou místo celých čísel. Při aktualizaci hodnoty například z 1 na 2.5 se první záznam automaticky "postaví" mezi druhý a třetí. Toto řešení je funkční, ale má dvě omezení. Za prvé, nebude vyhovovat, pokud se hodnota používá někde v rozhraní. Za druhé, v závislosti na přesnosti typu dat budete mít omezený počet možných vložení před provedením přepočtu hodnot všech záznamů.
Třetí možnost: udělat omezení odloženým, aby bylo kontrolováno pouze v okamžiku potvrzení:
create table cars
(
  name text constraint pk_cars primary key,
  ord integer not null constraint uk_cars unique deferrable initially deferred
);
Jelikož logika našeho původního dotazu zaručuje, že v okamžiku potvrzení jsou všechny hodnoty unikátní, bude úspěšně proveden.
Výše uvedený příklad je samozřejmě velmi syntetický, ale myšlenku vyjadřuje. V naší aplikaci používáme odložená omezení k realizaci logiky, která se zabývá řešením konfliktů při současné práci uživatelů se sdílenými předměty-widgety na tabuli. Použití takových omezení nám umožňuje udělat aplikační kód o něco jednodušším.
Obecně, v závislosti na typu omezení v Postgres, existují tři úrovně granularitní kontroly: úroveň řádku, transakce a výrazu.
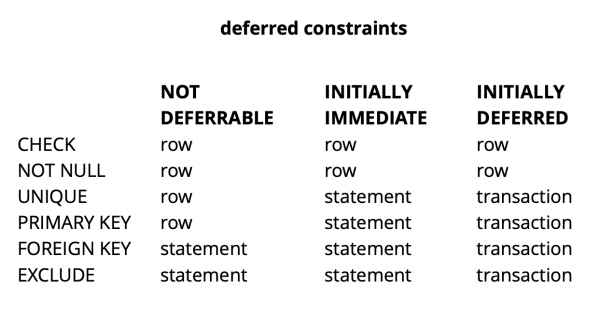
Zdroj:
CHECK a NOT NULL jsou vždy kontrolovány na úrovni řádku, pro ostatní omezení, jak je vidět z tabulky, existují různé možnosti. Více informací lze přečíst .
Pokud shrneme, odložená omezení v některých situacích vedou k přehlednějšímu kódu a menšímu množství příkazů. Nicméně to s sebou nese složitost procesu ladění, protože okamžik vzniku chyby a okamžik, kdy se o ní dozvíte, jsou časově oddělené. Další možný problém spočívá v tom, že plánovač nemusí vždy být schopen vytvořit optimální plán, pokud je v dotazu zahrnuto odložené omezení.
Dopracování pg_repack
Pochopili jsme, co jsou to odložená omezení, ale jak souvisejí s naším problémem? Připomeňme si chybu, kterou jsme dříve obdrželi:
$ ./pg_repack -t tablename -o id
INFO: repacking table "tablename"
ERROR: query failed:
    ERROR: duplicate key value violates unique constraint "index_16508"
DETAIL:  Key (id, index)=(100500, 42) already exists.
Ta nastává při kopírování dat z logovací tabulky do nové tabulky. Vypadá to divně, protože data v logovací tabulce se potvrzují spolu s daty z původní tabulky. Pokud vyhovují omezením původní tabulky, jak mohou porušovat stejná omezení v nové?
Jak se ukázalo, kořen problému leží v předchozím kroku práce pg_repack, při kterém se vytvářejí pouze indexy, nikoli omezení: ve staré tabulce bylo unikátní omezení, a v nové místo něj byl vytvořen unikátní index.
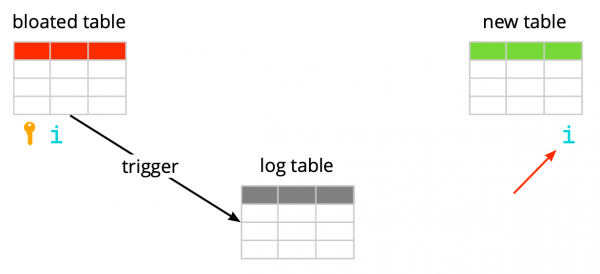
Je důležité poznamenat, že pokud je omezení běžné, a ne odložené, pak vytvořený unikátní index odpovídá tomuto omezení, protože unikátní omezení v PostgreSQL se realizují pomocí vytváření unikátního indexu. Ale v případě odloženého omezení se chování neshoduje, protože index nemůže být odložený a vždy se kontroluje v okamžiku provádění sql-příkazu.
Takže podstatou problému je "odloženost" kontroly: v původní tabulce se provádí v okamžiku potvrzení, a v nové - v okamžiku provádění sql-příkazu. To znamená, že musíme zajistit, aby se kontroly prováděly stejně v obou případech: buď vždy odloženě, nebo vždy okamžitě.
Takže, jaké nápady jsme měli.
Vytvořit index, který je ekvivalentní deferred
První myšlenka je provádět obě kontroly v režimu immediate. To může způsobit několik false positive oznámení o omezení, ale pokud jich bude málo, nemělo by to mít vliv na práci uživatelů, protože pro ně jsou takové konflikty normální situací. K nim dochází například, když dva uživatelé současně začnou upravovat stejný widget a klient druhého uživatele nestihne získat informace o tom, že widget již byl zablokován k úpravám prvním uživatelem. V takové situaci server odpovídá druhému uživateli odmítnutím, a jeho klient vrátí změny a zablokuje widget. O něco později, když první uživatel dokončí úpravu, druhý obdrží informaci, že widget již není zablokován, a může své akce zopakovat.
Aby byly kontroly vždy v naléhavém režimu, vytvořili jsme nový index, který je analogický původnímu odloženému omezení:
CREATE UNIQUE INDEX CONCURRENTLY uk_tablename__immediate ON tablename (id, index);
-- spusťte pg_repack
DROP INDEX CONCURRENTLY uk_tablename__immediate;
Na testovacím prostředí jsme získali pouze několik očekávaných chyb. Úspěch! Znovu jsme spustili pg_repack na produkci a získali 5 chyb v prvním clusteru za hodinu provozu. To je akceptovatelný výsledek. Nicméně už v druhém clusteru se počet chyb zvýšil několikanásobně a museli jsme pg_repack zastavit.
Proč k tomu došlo? Pravděpodobnost vzniku chyby závisí na tom, kolik uživatelů současně pracuje se stejnými widgety. Zřejmě v tu chvíli bylo s daty uloženými v prvním clusteru mnohem méně konkurenčních změn než v ostatních, t.j. prostě jsme měli "štěstí".
Myšlenka nevyšla. V té době jsme viděli dvě další varianty řešení: přepsat náš aplikační kód tak, abychom se vzdali odložených omezení, nebo "naučit" pg_repack s nimi pracovat. Vybrali jsme druhou možnost.
Nahraďte indexy v nové tabulce odloženými omezeními z původní tabulky.
Cíl vylepšení byl jasný – pokud má původní tabulka odložené omezení, pak je třeba pro novou vytvořit takové omezení, a ne index.
Abychom ověřili naše změny, napsali jsme jednoduchý test:
- tabulka s odloženým omezením a jedním záznamem;
- vkládáme do cyklu data, která kolidují s existujícím záznamem;
- provádíme update – data už se nekonfliktují;
- commitujeme změny.
create table test_table
(
  id serial,
  val int,
  constraint uk_test_table__val unique (val) deferrable initially deferred
);
INSERT INTO test_table (val) VALUES (0);
FOR i IN 1..10000 LOOP
  BEGIN
    INSERT INTO test_table VALUES (0) RETURNING id INTO v_id;
    UPDATE test_table set val = i where id = v_id;
    COMMIT;
  END;
END LOOP;
Původní verze pg_repack vždy spadla při prvním insertu, upravená verze fungovala bez chyb. Skvěle.
Jdeme do produkce a znovu dostáváme chybu ve stejné fázi kopírování dat z logové tabulky do nové:
$ ./pg_repack -t tablename -o id
INFO: repacking table "tablename"
ERROR: query failed:
    ERROR: duplicate key value violates unique constraint "index_16508"
DETAIL:  Key (id, index)=(100500, 42) already exists.
Klasická situace: ve testovacích prostředích vše funguje, ale v produkci – ne?!
APPLY_COUNT a spojení dvou batchů
Začali jsme analyzovat kód doslova po řádcích a objevili jsme důležitý moment: přelévání dat z logové tabulky do nové se děje ve batchích, konstanta APPLY_COUNT udávala velikost batchu:
for (;;)
{
num = apply_log(connection, table, APPLY_COUNT);

if (num > MIN_TUPLES_BEFORE_SWITCH)
     continue;
/* možná jsou stále nějaké tuple, opakovat. */
...
}
Problém je v tom, že data původní transakce, ve které několik operací může potenciálně porušit omezení, při přesunu mohou skončit na spojení dvou batchů – půlka příkazů bude zcommittována v prvním batchi, a druhá půlka – ve druhém. A tady je to jak se to povede: pokud příkazy v prvním batchi nic neporušují, je vše v pořádku, a pokud porušují – dojde k chybě.
APPLY_COUNT je 1000 záznamů, což vysvětluje, proč naše testy procházely úspěšně – nepokrývaly případ "spojení batchů". Použili jsme dva příkazy – insert a update, takže přesně 500 transakcí po dvou příkazech se vždy vešlo do batchu a my jsme neměli žádné problémy. Po přidání druhého update naše úprava přestala fungovat:
FOR i IN 1..10000 LOOP
  BEGIN
    INSERT INTO test_table VALUES (1) RETURNING id INTO v_id;
    UPDATE test_table set val = i where id = v_id;
    UPDATE test_table set val = i where id = v_id; -- jeden další update
    COMMIT;
  END;
END LOOP;
Takže dalším úkolem je udělat tak, aby data z původní tabulky, která se měnila v jedné transakci, skončila v nové tabulce také v rámci jedné transakce.
Odřeknutí batching
A my jsme znovu měli dvě řešení. První: úplně se vzdejme rozdělení na dávky a provedeme přenos dat jednou transakcí. Pro toto řešení hovoří jeho jednoduchost – požadované změny v kódu jsou minimální (mimochodem, ve starších verzích tehdy ještě pg_reorg fungoval přesně takto). Ale je tu problém — vytváříme dlouhou transakci, a to, jak bylo již zmíněno, představuje hrozbu pro vznik nového bloat.
Druhé řešení — složitější, ale pravděpodobně správnější: vytvořit v logové tabulce sloupec s identifikátorem té transakce, která přidala data do tabulky. Pak při kopírování dat budeme moci sdružovat je podle tohoto atributu a zaručit, že související změny budou přenášeny společně. Dávka bude tvořena z několika transakcí (nebo jedné velké) a její velikost se bude měnit v závislosti na množství dat, která byla v těchto transakcích změněna. Je důležité poznamenat, že protože data různých transakcí přicházejí do logové tabulky náhodně, již nebude možné ji číst sekvenčně, jako tomu bylo dříve. seqscan při každém dotazu s filtrováním podle tx_id – to je příliš drahé, potřebujeme index, ale ten také zpomalí práci metody kvůli režijním nákladům na jeho aktualizaci. Obecně, jako vždy, je třeba něčeho se vzdát.
Takže jsme se rozhodli začít s prvním řešením, jako s jednodušším. Nejdříve bylo třeba pochopit, zda bude dlouhá transakce skutečným problémem. Jelikož hlavní přenos dat ze staré tabulky do nové probíhá také v jedné dlouhé transakci, otázka se transformovala na "jak moc tuto transakci zvýšíme?" Délka první transakce závisí převážně na velikosti tabulky. Délka nové závisí na tom, kolik změn se v tabulce nahromadí během přelévání dat, tedy na intenzitě zatížení. Provoz pg_repack probíhal během minimální zátěže na službu a objem změn byl zanedbatelný v porovnání s původním objemem tabulky. Rozhodli jsme se, že můžeme ignorovat délku nové transakce (průměrně to je 1 hodina a 2-3 minuty).
Experimenty byly pozitivní. Spuštění na produ byly také úspěšné. Pro přehlednost – obrázek s velikostí jedné z databází po provedení:
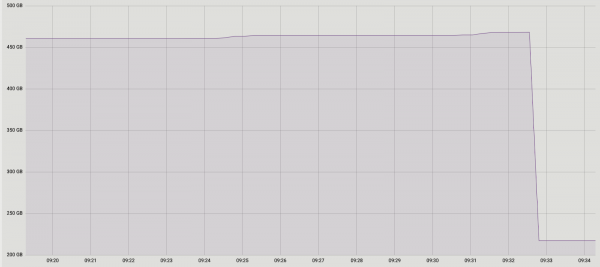
Protože jsme byli s tímto řešením plně spokojeni, nerozhodli jsme se vyzkoušet druhé, ale zvažujeme možnost jeho probrání s vývojáři rozšíření. Naše aktuální vylepšení bohužel zatím není připraveno k publikaci, protože jsme vyřešili problém pouze s unikátními odloženými omezeními, a pro plnohodnotný patch je třeba zajistit podporu i pro další typy. Doufáme, že se nám to podaří uskutečnit v budoucnu.
Možná máte otázku, proč jsme se vůbec pustili do této historie s vylepšením pg_repack, a nevyužili například jeho analogy? V nějakém okamžiku jsme o tom také přemýšleli, ale pozitivní zkušenost s jeho využitím dříve, na tabulkách bez odložených omezení, nás motivovala pokusit se pochopit podstatu problému a opravit jej. Kromě toho pro využití jiných řešení je také potřeba čas na provedení testů, proto jsme se rozhodli, že nejprve zkusíme vyřešit problém v něm, a pokud pochopíme, že to za rozumný čas nedokážeme, začneme zvažovat analogy.
Závěry
Co můžeme doporučit na základě našich vlastních zkušeností:
- Sledujte svůj bloat. Na základě monitorovacích dat budete schopni zjistit, jak dobře je nastaven autovacuum.
- Nastavte AUTOVACUUM, abyste udrželi bloat na přijatelných úrovních.
- Pokud bloat přesto roste a nemůžete ho zvládnout standardními prostředky, nebojte se využít externí rozšíření. Hlavně – vše dobře testujte.
- Nebojte se přizpůsobit externí řešení svým potřebám – někdy to může být efektivnější a dokonce jednodušší, než měnit váš vlastní kód.
Zdroj: habr.com
