

— velmi silný a pohodlný mechanismus, pokud se nad souvisejícími daty provádějí stejné operace "do hloubky". Ale nekontrolovaná rekurze je zlo, které může vést buď k nekonečnému provádění procesu, nebo (což se stává častěji) k „vyžrání“ veškeré dostupné paměti.
Systémy řízení databází v tomto ohledu fungují na stejných principech — "řekli jste kopat, já k tomu kopu". Váš dotaz může nejen zpomalit sousední procesy, neustále zabírat zdroje procesoru, ale také „shodit“ celou databázi, „snědouc“ veškerou dostupnou paměť. Proto ochrana před nekonečnou rekurzí — je povinností samotného vývojáře.
V PostgreSQL je možnost používat rekurzivní dotazy prostřednictvím dostupná už od památné verze 8.4, ale dodnes se mohou pravidelně setkat potenciálně zranitelné „bezbranné“ dotazy. Jak se zbavit problémů tohoto druhu?
Nepište rekurzivní dotazy
Ale pište nerekurzivní. S úctou, váš K.O.
Ve skutečnosti PostgreSQL poskytuje dostatek funkcionality, kterou lze využít k tomu, aby ne aplikovali rekurzi.
Použít principiálně jiný přístup k úkolu
Někdy stačí na úkol podívat "z jiného úhlu“. Příklad takové situace jsem uváděl v článku — násobení množiny čísel bez použití uživatelských agregačních funkcí:
WITH RECURSIVE src AS (
  SELECT '{2,3,5,7,11,13,17,19}'::integer[] arr
)
, T(i, val) AS (
  SELECT
    1::bigint
  , 1
UNION ALL
  SELECT
    i + 1
  , val * arr[i]
  FROM
    T
  , src
  WHERE
    i <= array_length(arr, 1)
)
SELECT
  val
FROM
  T
ORDER BY -- výběr finálního výsledku
  i DESC
LIMIT 1;
Takový dotaz lze nahradit variantou od matematiků:
WITH src AS (
  SELECT unnest('{2,3,5,7,11,13,17,19}'::integer[]) prime
)
SELECT
  exp(sum(ln(prime)))::integer val
FROM
  src;
Používat generate_series místo cyklů
Představme si, že máme úkol vygenerovat všechny možné prefixy pro řetězec 'abcdefgh':
WITH RECURSIVE T AS (
  SELECT 'abcdefgh' str
UNION ALL
  SELECT
    substr(str, 1, length(str) - 1)
  FROM
    T
  WHERE
    length(str) > 1
)
TABLE T;
Je opravdu potřeba rekurze?.. Pokud použijeme LATERAL a generate_series, tak ani CTE nebude potřeba:
SELECT
  substr(str, 1, ln) str
FROM
  (VALUES('abcdefgh')) T(str)
, LATERAL(
    SELECT generate_series(length(str), 1, -1) ln
  ) X;
Změnit strukturu databáze
Například máte tabulku fórumových zpráv s vazbami kdo komu odpověděl nebo vlákna v :
VYTVOŘIT TABULKU message(
  message_id
    uuid
      PRIMÁRNÍ KLÍČ
, reply_to
    uuid
      ODKAZY message
, body
    text
);
VYTVOŘIT INDEX NA message(reply_to); 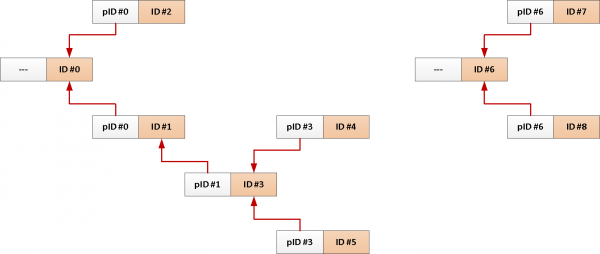
Příklad dotazu pro načtení všech zpráv podle jednoho tématu vypadá přibližně takto:
S REKURZÍ T AS (
  VYBERTE
    *
  Z
    message
  KDE
    message_id = $1
UNION ALL
  VYBERTE
    m.*
  Z
    T
  PŘIPOJTE
    message m
      ON m.reply_to = T.message_id
)
TABULKA T;
Ale pokud vždy potřebujeme celé téma od kořenové zprávy, proč bychom neměli přidávat jeho identifikátor do každého záznamu automaticky?
-- přidáme pole se společným identifikátorem tématu a index na něj
ALTER TABLE message
  PŘIDAT SLUŽBU theme_id uuid;
VYTVOŘIT INDEX NA message(theme_id);

-- inicializujeme identifikátor tématu v triggeru při vložení
VYTVOŘIT NEBO ZMĚNIT FUNKCI ins() VRÁTIT TRIGGER AS $$
ZAČÁTEK
  NEW.theme_id = PŘÍPAD
    KDYŽ NEW.reply_to JE NULL POTOM NEW.message_id -- bereme ze startovací události
    JINAK ( -- nebo ze zprávy, na kterou odpovídáme
      VYBERTE
        theme_id
      Z
        message
      KDE
        message_id = NEW.reply_to
    )
  KONEC;
  VRÁTIT NEW;
KONEC;
$$ JAZYK plpgsql;

VYTVOŘIT TRIGGER ins PŘED VLOŽENÍM
  NA message
    PRO KAŽDÝ ŘÁDEK
PROVEďTE PROCEDURU ins(); 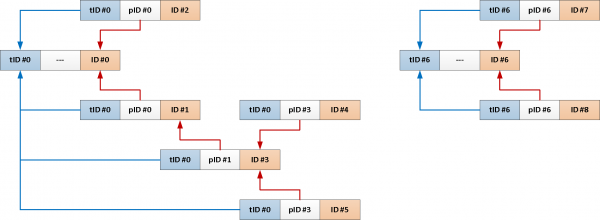
Nyní může být náš veškerý rekurzivní dotaz redukován jen na toto:
VYBERTE
  *
Z
  message
KDE
  theme_id = $1;
Používat aplikační "omezení"
Pokud z nějakých důvodů nemůžeme změnit strukturu databáze, podívejme se, na co se můžeme opřít, aby i přítomnost chyby v datech nevedla k nekonečnému provádění rekurze.
Počítadlo "hloubky" rekurze
Jednoduše zvyšujeme počítadlo o jednu na každém kroku rekurze až do momentu dosažení limitu, který považujeme za zjevně neadekvátní:
S REKURZÍ T AS (
  VYBERTE
    0 i
  ...
UNION ALL
  VYBERTE
    i + 1
  ...
  KDE
    T.i < 64 -- limit
)
Pro: Při pokusu o cykličnost stejně neuděláme více než uvedený limit iterací "do hloubky".
Proti: Není zaručeno, že zpracujeme stejný záznam více než jednou — například na hloubce 15 a 25, a dál to bude každých +10. A také nikdo nic neslíbí o "do šířky".
Formálně taková rekurze nebude nekonečná, ale pokud se na každém kroku počet záznamů exponenciálně zvyšuje, všichni víme, jak to končí...
Strážce "cesty"
Postupně zapisujeme všechny identifikátory objektů, které potkáme na cestě rekurze, do pole, které je unikátní "cestou" k němu:
S REKURZÍ T AS (
  VYBERTE
    ARRAY[id] cesta
  ...
UNION ALL
  VYBERTE
    cesta || id
  ...
  KDE
    id  ALL(T.cesta) -- neodpovídá žádnému z
)
Pro: Pokud data obsahují cyklus, rozhodně nebudeme zpracovávat stejný záznam znovu v rámci jedné cesty.
Proti: Ale můžeme projít, doslova, všechny záznamy, aniž bychom se opakovali.
Omezení délky cesty
Abychom se vyhnuli situaci "bloudění" rekurze do nejasné hloubky, můžeme zkombinovat dvě předchozí metody. Nebo, pokud nechceme udržovat zbytečná pole, doplníme podmínku pokračování rekurze hodnocením délky cesty:
WITH RECURSIVE T AS (
  SELECT
    ARRAY[id] path
  ...
UNION ALL
  SELECT
    path || id
  ...
  WHERE
    id  ALL(T.path) AND
    array_length(T.path, 1) < 10
)
Vyberte si metodu podle svého gusta!
Zdroj: habr.com
