

V rámci své činnosti se občas setkávám se situacemi, kdy vývojář píše dotaz a myslí si: „databáze je chytrá, sama si poradí!“«
V některých případech (částečně kvůli neznalosti možností DB, částečně kvůli předčasným optimalizacím) takový přístup vede k vzniku „frankensteinů“.
Nejprve uvedu příklad takového dotazu:
-- pro každou klíčovou dvojici hledáme asociované hodnoty polí
WITH RECURSIVE cte_bind AS (
  SELECT DISTINCT ON (key_a, key_b)
    key_a a
  , key_b b
  , fld1 bind_fld1
  , fld2 bind_fld2
  FROM
    tbl
)
-- hledáme min/max hodnoty pro každý první klíč
, cte_max AS (
  SELECT
    a
  , max(bind_fld1) bind_fld1
  , min(bind_fld2) bind_fld2
  FROM
    cte_bind
  GROUP BY
    a
)
-- spojujeme podle prvního klíče klíčové dvojice a min/max hodnoty
, cte_a_bind AS (
  SELECT
    cte_bind.a
  , cte_bind.b
  , cte_max.bind_fld1
  , cte_max.bind_fld2
  FROM
    cte_bind
  INNER JOIN
    cte_max
      ON cte_max.a = cte_bind.a
)
SELECT * FROM cte_a_bind;
Abychom mohli objektivně zhodnotit kvalitu dotazu, vytvořme si nějaký náhodný soubor dat:
CREATE TABLE tbl AS
SELECT
  (random() * 1000)::integer key_a
, (random() * 1000)::integer key_b
, (random() * 10000)::integer fld1
, (random() * 10000)::integer fld2
FROM
  generate_series(1, 10000);
CREATE INDEX ON tbl(key_a, key_b);
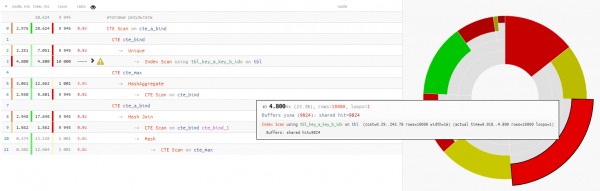
Ukazuje se, že čtení dat zabralo méně než čtvrtinu celkového času provádění dotazu:
Rozebíráme podrobně
Pozorně se podíváme na dotaz a začneme se zamýšlet:
- Proč je zde WITH RECURSIVE, když žádné rekurzivní CTE nejsou?
- Proč shromažďovat min/max hodnoty v samostatném CTE, když se později stejně vážou na původní výběr?
+25% času - Proč na konci používat opětovné načtení z předchozího CTE prostřednictvím bezpodmínečného ‘SELECT * FROM’?
+14% času
V tomto případě jsme ještě měli štěstí, že pro spojení byl zvolen Hash Join, a ne Nested Loop, protože jinak bychom dostali ne jeden průchod CTE Scan, ale 10K!
trochu o CTE ScanZde je potřeba vzpomenout, že CTE Scan je ekvivalent Seq Scan — to znamená žádná indexace, pouze úplné procházení, které by vyžadovalo 10K x 0.3ms = 3000ms při cyklech přes cte_max nebo 1K x 1.5ms = 1500ms při cyklech přes cte_bind!
Co vlastně chtěli v důsledku získat? Aha, obvykle právě taková otázka napadne někde na páté minutě rozboru „třípatrových“ dotazů.
Chtěli jsme pro každou jedinečnou klíčovou dvojici vypsat min/max ze skupiny podle key_a.
Dopřejme si tedy pro to :
SELECT DISTINCT ON(key_a, key_b)
	key_a a
,	key_b b
,	max(fld1) OVER(w) bind_fld1
,	min(fld2) OVER(w) bind_fld2
FROM
	tbl
WINDOW
w AS (PARTITION BY key_a); 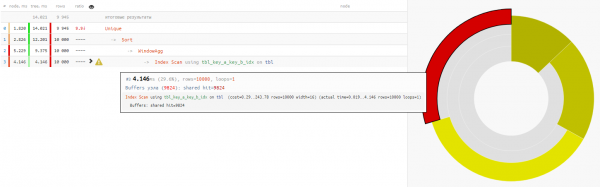
Jelikož čtení dat v obou případech trvá přibližně 4-5 ms, máme tak celý náš časový zisk -32% — čistě ve svém projevu zátěž, která byla odstraněna z CPU databáze, pokud je takový dotaz prováděn dostatečně často.
Obecně byste neměli nutit databázi ‚nosit kulaté – točit čtveraté‘.
Zdroj: habr.com
