

V SQL popisujete „co“ chcete získat, nikoli „jak“ to má být vykonáno. Proto problém návrhu SQL dotazů ve stylu „jak slyším, tak píšu“ zaujímá své místo vedle .
Dnes se na naprosto jednoduchých příkladech podíváme, k čemu to může vést v kontextu použití GROUP/DISTINCT a LIMIT spolu s nimi.
Pokud jste například v dotazu napsali „nejprve spojte tyto tabulky a potom vyhoďte všechny duplicity, měla by zůstat jen jedna instance podle každého klíče,“ — přesně tak to bude fungovat, i když spojení vůbec nebylo potřeba.
A někdy se to stane a „prostě to funguje“, jindy to nepříjemně ovlivňuje výkon a někdy to dává z pohledu vývojáře naprosto nečekané efekty.
No, možná ne tak působivé, ale…
„Sladká dvojice“: JOIN + DISTINCT
SELECT DISTINCT
  X.*
FROM
  X
JOIN
  Y
    ON Y.fk = X.pk
WHERE
  Y.bool_condition;
Jakoby bylo jasné, co chtěli vybrat takové záznamy X, pro které v Y existují související záznamy splňující podmínku. Napsali dotaz přes JOIN — získali nějaké hodnoty pk několikrát (přesně tolik, kolik odpovídajících záznamů v Y bylo). Jak to odstranit? Samozřejmě DISTINCT!
Obzvlášť „těší“, když se pro každou záznam X najde několik set souvisejících záznamů Y a pak se hrdinsky odstraňují duplicity…
Jak to opravit? Nejprve si uvědomit, že úlohu lze modifikovat na „vybrat takové záznamy X, pro které v Y existuje ALESPOŇ JEDEN související záznam splňující podmínku“ — neboť záznam Y nám nic neposkytuje.
Vnořený EXISTS
SELECT
  *
FROM
  X
WHERE
  EXISTS(
    SELECT
      NULL
    FROM
      Y
    WHERE
      fk = X.pk AND
      bool_condition
    LIMIT 1
  );
Některé verze PostgreSQL chápu, že v EXISTS stačí najít první nalezený záznam, starší verze nikoli. Proto dávám přednost vždy uvádět LIMIT 1 uvnitř EXISTS.
LATERAL JOIN
SELECT
  X.*
FROM
  X
, LATERAL (
    SELECT
      Y.*
    FROM
      Y
    WHERE
      fk = X.pk AND
      bool_condition
    LIMIT 1
  ) Y
WHERE
  Y IS DISTINCT FROM NULL;
Tento stejný variant umožňuje najednou vrátit i nějaká data z nalezeného souvisejícího záznamu Y. Podobnou variantu jsem probíral v článku .
„Proč platit více“: DISTINCT [ON] + LIMIT 1
Dalším přínosem takového transformování dotazu je možnost snadno omezit procházení záznamů, pokud potřebujeme pouze jeden / několik z nich, jako v následujícím případě:
SELECT DISTINCT ON(X.pk)
  *
FROM
  X
JOIN
  Y
    ON Y.fk = X.pk
LIMIT 1;
Nyní čteme dotaz a snažíme se pochopit, co se navrhuje udělat DBMS:
- spojíme tabulky
- unikalizujeme podle X.pk
- z zbývajících záznamů vybereme nějaký jeden
Co jsme tedy dostali? „Nějaký jeden záznam“ z unikálních — a pokud by byla tato jedna z neunikálních, změnil by se výsledek nějak?.. „A pokud žádný rozdíl, proč platit více?“
SELECT
  *
FROM
  (
    SELECT
      *
    FROM
      X
    -- tady můžeme přidat vhodné podmínky
    LIMIT 1 -- +1 Limit
  ) X
JOIN
  Y
    ON Y.fk = X.pk
LIMIT 1;
A stejné téma s GROUP BY + LIMIT 1.
„Mám jenom zeptat“: implicitní GROUP + LIMIT
Podobné věci se vyskytují při různých prověrkách neprázdnosti tabulky nebo CTE během provádění dotazu:
...
CASE
  WHEN (
    SELECT
      count(*)
    FROM
      X
    LIMIT 1
  ) = 0 THEN ...
Agregatní funkce (count/min/max/sum/...) úspěšně běží na celém souboru, dokonce i bez explicitního určení GROUP BY. Jenže s LIMIT nejsou tak úplně kompatibilní.
Vývojář si může myslet „pokud tam jsou záznamy, potřebuji maximálně LIMIT“. Ale tak to nedělejte! Protože pro databázi to znamená:
- spočítej, co chtějí všechny záznamy
- vrať tolik řádků, kolik se žádá
V závislosti na cílových podmínkách je zde vhodné provést jedno z následujících nahrazení:
(count + LIMIT 1) = 0naNOT EXISTS(LIMIT 1)(count + LIMIT 1) > 0naEXISTS(LIMIT 1)count >= Nna(SELECT count(*) FROM (... LIMIT N))
„Kolik vážit v gramech“: DISTINCT + LIMIT
SELECT DISTINCT
  pk
FROM
  X
LIMIT $1
Naivní vývojář si může upřímně myslet, že provádění dotazu se zastaví, jakmile najdeme $1 prvních vhodných různých hodnot.
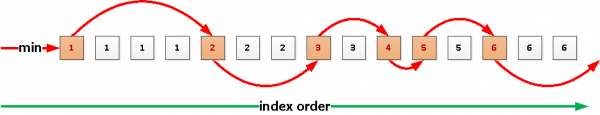
Někdy v budoucnu by to tak mohlo fungovat díky novému uzlu Index Skip Scan, jehož implementace se nyní vyvíjí, ale zatím — ne.
Zatím nejprve budou extrahovány všechny záznamy, unikální, a teprve poté se vrátí tolik, kolik je požadováno. Obzvlášť smutné to bývá, pokud jsme chtěli něco jako $1 = 4, a záznamů v tabulce — stovky tisíc…
Abychom se nezarmucovali zbytečně, využijeme rekurzivní dotaz :
Zdroj: habr.com
