

Dnes nebudou žádné složité případy ani komplikované SQL algoritmy. Všechno bude velmi jednoduché, na úrovni kapitána očividnosti – děláme to. prohlížení registru událostí se tříděním podle času.
To znamená, že v databázi leží tabulka events, a má pole ts – přesně to časové razítko, podle kterého chceme tyto záznamy uspořádaně zobrazit:
CREATE TABLE events(
  id
    serial
      PRIMARY KEY
, ts
    timestamp
, data
    json
);

CREATE INDEX ON events(ts DESC);
Je jasné, že záznamů tam bude víc než deset, takže budeme potřebovat nějakou formu stránkování.
#0. «Я у мамы погроммист»
cur.execute("SELECT * FROM events;")
rows = cur.fetchall();
rows.sort(key=lambda row: row.ts, reverse=True);
limit = 26
print(rows[offset:offset+limit]);
To není ani trochu žert – občas se to v přírodě vyskytuje. Někdy je po práci s ORM těžké přepnout na "přímou" práci s SQL.
Ale přejděme k běžnějším a méně zjevným problémům.
#1. OFFSET
SELECT
  ...
FROM
  events
ORDER BY
  ts DESC
LIMIT 26 OFFSET $1; -- 26 - záznamů na stránce, $1 - začátek stránky
Odkud se tu vzalo číslo 26? To je přibližný počet záznamů k zaplnění jedné obrazovky. Přesněji řečeno, 25 zobrazených záznamů plus 1, signalizující, že dál v výběru je něco dalšího, co má smysl procházet.
Samozřejmě, tuto hodnotu není nutné "zakotvit" v těle dotazu, ale předávat ji jako parametr. V tomto případě však plánovač PostgreSQL nemůže počítat s tím, že záznamů bude relativně málo, a snadno zvolí neefektivní plán.
A dokud je prohlížení registru v rozhraní aplikace realizováno jako přepínání mezi vizuálními "stránkami", nikdo dlouho nic podezřelého nepozoruje. Až do chvíle, kdy se v boji za pohodlí UI/UX rozhodnou přepracovat rozhraní na "nekonečné rolování" – to znamená, že všechny záznamy registru jsou vykresleny jako jeden seznam, který si uživatel může posouvat nahoru a dolů.
A tady, při dalším testování vás nachytají na duplicitních záznamech v registru. Proč, vždyť na tabulce je normální index (ts), na který se váš dotaz opírá?
Právě proto, že jste nezohlednili, že ts není unikátním klíčem v této tabulce. Vlastně hodnoty nejsou unikátní, jako u každého „času“ za reálných podmínek – proto stejný záznam ve dvou sousedních dotazech snadno „přeskočí“ z jedné stránky na druhou díky jinému konečnému pořadí v rámci třídění stejné hodnoty klíče.
Ve skutečnosti se zde skrývá také druhý problém, který je mnohem těžší si všimnout – některé záznamy se vůbec nebudou zobrazovat! Vždyť „zdvojené“ záznamy obsadily něčí místo. Podrobné vysvětlení s pěknými obrázky lze .
Rozšiřujeme index
Chytrý vývojář chápe – je třeba udělat klíč indexu jedinečným, a nejjednodušší způsob – rozšířit ho o zjevně jedinečné pole, kterým skvěle poslouží PK:
VYTVORIT UNIKÁTNÍ INDEX NA události(ts DESC, id DESC);A dotaz se mění:
VYBERTE
  ...
OBJEDNAT PODLE
  ts DESC, id DESC
LIMIT 26 OFFSET $1;
#2. Переход на «курсоры»
Nějaký čas poté k vám přijde DBA a „potěší“ vás, že vaše dotazy , a vůbec by bylo dobré přejít na navigaci od poslední zobrazené hodnoty. Váš dotaz se opět mění:
VYBERTE
  ...
KDE
  (ts, id) < ($1, $2) -- poslední získané hodnoty z předchozího kroku
OBJEDNAT PODLE
  ts DESC, id DESC
LIMIT 26;
S úlevou jste si vydechli, dokud nenastalo...
#3. Чистка индексов
Protože jednou váš DBA četl a pochopil, že „neposlední“ časová značka – to není dobré. A znovu přišel k vám – nyní s myšlenkou, že ten index by se měl přece jen vrátit zpět na (ts DESC).
Ale co dělat s původním problémem „skákaní“ záznamů mezi stránkami?.. A to je jednoduché – je třeba vybírat bloky s nefixovaným počtem záznamů!
Vlastně, kdo nám zakazuje číst ne „přesně 26“, ale „nejméně 26“? Například tak, aby v dalším bloku byly záznamy se zjevně jinými hodnotami – ts pak totiž nebude žádný problém se „přeskočením“ záznamů mezi bloky!
Takto toho dosáhnout:
VYBERTE
  ...
KDE
  ts = coalesce((
    VYBERTE
      ts
    Z
      události
    KDE
      ts < $1
    OBJEDNAT PODLE
      ts DESC
    LIMIT 1 OFFSET 25
  ), '-neomezeno')
OBJEDNAT PODLE
  ts DESC;
Co se zde vlastně děje?
- Sestupujeme o 25 záznamů „dole“ a získáváme „hraniční“ hodnotu.
ts. - Pokud už tam nic není, nahradíme NULL-hodnotu
na -neomezeno.. - Vydělujeme celý segment hodnot mezi získanou hodnotou
tsa předaným z rozhraní parametrem $1 (předchozí „poslední“ vykreslenou hodnotou). - Pokud se blok vrátil s méně než 26 záznamy, je to poslední.
Nebo totéž jako obrázek:
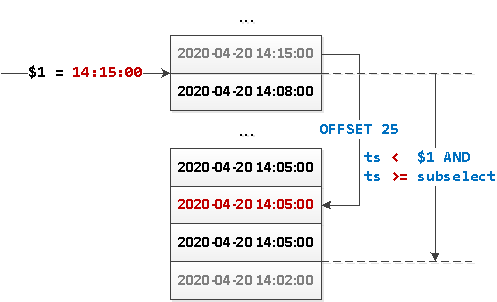
Jelikož teď máme výběr nemá nějaký konkrétní "začátek", nic nám tedy nebrání "otočit" tento dotaz opačným směrem a realizovat dynamické nahrávání bloků dat od "výchozího bodu" oběma směry — jak dolů, tak nahoru.
Poznámka
- Ano, v takovém případě se dotazujeme na index dvakrát, ale vše "čistě podle indexu". Proto vnořený dotaz povede pouze k jednomu dalšímu Index Only Scan.
- Je dost zřejmé, že touto metodou lze používat pouze když máte hodnoty
tskteré se mohou náhodně překrývat, a je jich málo. Pokud je váš typický případ "milion záznamů v 00:00:00.000", tak to dělat není doporučeno. To znamená, že byste se takovému případu měli vyhnout. Ale pokud se to stalo, použijte variantu s rozšířeným indexem.
Zdroj: habr.com
