

Občas se u vývojáře objeví potřeba předat do dotazu sadu parametrů nebo dokonce celou sadu na vstupu. Někdy narazíme na velmi zvláštní řešení tohoto úkolu.
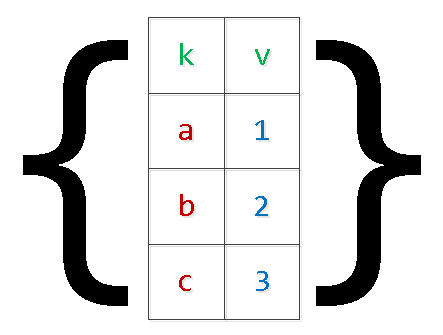
Pojďme se podívat „od konce“ a zjistit, jak to dělat není správně, proč a jak to lze udělat lépe.
Přímá „vložení“ hodnot do těla dotazu
Obvykle vypadá přibližně takto:
query = "SELECT * FROM tbl WHERE id = " + value… nebo takto:
query = "SELECT * FROM tbl WHERE id = :param".format(param=value)O tomto způsobu je řečeno, napsáno a dostatečně:
Téměř vždy to je — přímá cesta k SQL injekcím a zbytečné zátěži na obchodní logiku, která je nucena „lepit“ řetězec vašeho dotazu.
Částečně je tento přístup oprávněný pouze v případě potřeby použití partitioningu ve verzích PostgreSQL 10 a nižších pro efektivnější plánování. V těchto verzích je seznam skenovaných sekcí určen ještě bez ohledu na předávané parametry, pouze na základě těla dotazu.
$n-argumenty
Použití parametry — to je dobré, umožňuje to použití , snižující zatížení jak obchodní logiky (řetězec dotazu je sestavován a předáván pouze jednou), tak na serveru DB (není potřebné opakované zpracování a plánování pro každý případ dotazu).
Proměnlivé množství argumentů
Problémy nás budou čekat, když budeme chtít předat předem neznámé množství argumentů:
... id IN ($1, $2, $3, ...) -- $1 : 2, $2 : 3, $3 : 5, ...Pokud necháme dotaz v takovém stavu, ochrání nás sice před potenciálními injekcemi, ale stejně to povede k potřebě lepení/rozboru dotazu pro každou variantu počtu argumentů.. Už je to lepší než to dělat pokaždé, ale můžeme se bez toho obejít.
Stačí předat pouze jeden parametr, který obsahuje serializované zobrazení pole:
... id = ANY($1::integer[]) -- $1 : '{2,3,5,8,13}'Jediný rozdíl — nutnost výslovně převést argument na požadovaný typ pole. Ale to nepředstavuje problémy, protože stejně předem víme, kam cílíme.
Předání výběru (matrice)
Obvykle to jsou různé možnosti předání sad dat k vložení do databáze „na jeden požadavek“:
INSERT INTO tbl(k, v) VALUES($1,$2),($3,$4),...Kromě zmíněných problémů s „lepícími“ dotazy, nás to může dovést ještě k out of memory a pádu serveru. Důvod je jednoduchý – pod argumenty PG rezervuje dodatečnou paměť, zatímco počet záznamů v sadě je omezován pouze aplikačními požadavky obchodní logiky. V extrémních případech jsme mohli vidět «číselné» argumenty větší než $9000 — nemusíte tak.
Přeformulujeme dotaz, přičemž již použijeme «dvouúrovňovou» serializaci:
INSERT INTO tbl
SELECT
  unnest[1]::text k
, unnest[2]::integer v
FROM (
  SELECT
    unnest($1::text[])::text[] -- $1 : '{"{a,1}","{b,2}","{c,3}","{d,4}"}'
) T;
Ano, v případě «složitých» hodnot uvnitř pole je třeba je obalovat uvozovkami.
Je jasné, že tímto způsobem je možné «rozvinout» výběr s libovolným počtem polí.
unnest, unnest, …
Občas se setkáte s variantami předání místo «pole polí» několika «polí sloupců», o kterých jsem již mluvil. :
SELECT
  unnest($1::text[]) k
, unnest($2::integer[]) v;
Při tomto způsobu, pokud se při generování seznamů hodnot pro jednotlivé sloupce dopustíte chyby, je velmi snadné získat zcela nečekané výsledky, závislé také na verzi serveru:
-- $1 : '{a,b,c}', $2 : '{1,2}'
-- PostgreSQL 9.4
k | v
-----
a | 1
b | 2
c | 1
a | 2
b | 1
c | 2
-- PostgreSQL 11
k | v
-----
a | 1
b | 2
c |
JSON
Od verze 9.3 v PostgreSQL byly zavedeny plnohodnotné funkce pro práci s typem json. Proto, pokud definici vstupních parametrů provádíte v prohlížeči, můžete tam přímo vytvářet json-objekt pro SQL dotaz:
SELECT
  key k
, value v
FROM
  json_each($1::json); -- '{"a":1,"b":2,"c":3,"d":4}'
Pro předchozí verze lze stejný způsob použít pro each(hstore), ale správné «sbalení» s escapováním složitých objektů v hstore může způsobit problémy.
json_populate_recordset
Pokud předem víte, že data z «vstupního» json-pole půjdou k naplnění nějaké tabulky, můžete výrazně ušetřit na «dereferenování» polí a převodu na potřebné typy využitím funkce json_populate_recordset:
SELECT
  *
FROM
  json_populate_recordset(
    NULL::pg_class
  , $1::json -- $1 : '[{"relname":"pg_class","oid":1262},{"relname":"pg_namespace","oid":2615}]'
  );
json_to_recordset
A tato funkce prostě «rozvine» předaný pole objektů do výběru, bez ohledu na formát tabulky:
SELECT
  *
FROM
  json_to_recordset($1::json) T(k text, v integer);
-- $1 : '[{"k":"a","v":1},{"k":"b","v":2}]'
k | v
-----
a | 1
b | 2
TEMPORARY TABLE
Ale pokud je objem dat v předávaném výběru velmi velký, tak dát ho do jednoho serializovaného parametru je náročné a někdy až nemožné, protože to vyžaduje jednorázové alokování velkého objemu paměti. Například, pokud potřebujete dlouho shromažďovat velký balík dat událostí z externího systému a poté jej jednorázově zpracovat na straně DB.
V tomto případě bude nejlepším řešením využití :
CREATE TEMPORARY TABLE tbl(k text, v integer);
...
INSERT INTO tbl(k, v) VALUES($1, $2); -- opakovat mnohokrát
...
-- zde děláme něco užitečného se všemi těmito tabulkami jako celkem
Tato metoda je dobrá právě pro vzácný přenos velkých objemů dat.
Z hlediska popisu struktury vašich dat se dočasná tabulka liší od 'běžné' pouze jedním znakem v systémové tabulce pg_class, a v pg_type, pg_depend, pg_attribute, pg_attrdef, … — vůbec ničím.
Proto v webových systémech s velkým množstvím krátkodobých připojení bude každé z nich vytvářet nové systémové záznamy pokaždé, které se odstraní se zavřením spojení s DB. Nakonec, neřízené používání TEMP TABLE vede k ‚deformaci‘ tabulek v pg_catalog a zpomalení mnoha operací, které je používají.
Samozřejmě, s tím se dá bojovat pomocí pravidelného průchodu VACUUM FULL po tabulkách systémového katalogu.
Proměnné session
Předpokládejme, že zpracování dat z předchozího případu je dostatečně složité pro jeden SQL dotaz, ale chceme to dělat docela často. To znamená, že chceme použít procedurální zpracování v , ale použití přenosu dat přes dočasné tabulky by bylo příliš nákladné.
Použít $n-parametry pro přenos do anonymního bloku také nemůžeme. Řešením nám pomohou proměnné session a funkce current_setting.
Do verze 9.2 bylo nutné předem konfigurovat custom_variable_classes pro ‚své‘ proměnné session. V současných verzích lze psát přibližně takto:
SET my.val = '{1,2,3}';
DO $$
DECLARE
  id integer;
BEGIN
  FOR id IN (SELECT unnest(current_setting('my.val')::integer[])) LOOP
    RAISE NOTICE 'id : %', id;
  END LOOP;
END;
$$ LANGUAGE plpgsql;
-- NOTICE:  id : 1
-- NOTICE:  id : 2
-- NOTICE:  id : 3
V jiných podporovaných procedurálních jazycích lze najít i další řešení.
Znáte další způsoby? Podělte se v komentářích!
Zdroj: habr.com
