

Funkce interních mechanismů PostgreSQL mu umožňují být velmi rychlým v některých situacích a "ne tak rychlým" v jiných. Dnes se podíváme na klasický příklad konfliktu mezi tím, jak funguje DBMS, a tím, co s ní dělá vývojář — UPDATE vs principy MVCC.
Stručný výtah z :
Když je řádek změněn příkazem UPDATE, ve skutečnosti se provádějí dvě operace: DELETE a INSERT. V aktuální verzi řádku se nastavuje xmax, který odpovídá číslo transakce, která provedla UPDATE. Poté se vytvoří nová verze stejného řádku; hodnota xmin se shoduje s hodnotou xmax předchozí verze.
Nějakou dobu po dokončení této transakce budou stará nebo nová verze, v závislosti na COMMIT/ROOLBACK, uznány "mrtvými" (dead tuples) při procházení VACUUM tabulkou a odstraněny.
Ale k tomu nedojde hned, přičemž problém s "mrtvými" se může rychle objevit — při vícenásobných nebo v rozsáhlé tabulce, a o chvíli později můžete narazit na situaci, že ani .
#1: I Like To Move It
Představme si, že váš metoda na obchodní logice funguje a náhle si uvědomí, že je třeba aktualizovat pole X v nějakém záznamu:
UPDATE tbl SET X = <newX> WHERE pk = $1;Pak se cestou ukáže, že je také potřeba aktualizovat pole Y:
UPDATE tbl SET Y = <newY> WHERE pk = $1;… a pak ještě i Z — proč se omezovat?
UPDATE tbl SET Z = <newZ> WHERE pk = $1;Kolik verzí tohoto záznamu teď máme v databázi? Aha, 4 kusy! Z toho jedna aktuální a 3 bude muset uklidit za vámi [auto]VACUUM.
Nedělejte to! Použijte aktualizaci všech polí jedním dotazem — téměř vždy lze logiku pracovního postupu takto změnit:
UPDATE tbl SET X = <newX>, Y = <newY>, Z = <newZ> WHERE pk = $1;#2: Use IS DISTINCT FROM, Luke!
Takže, přece jen jste chtěli (například v průběhu aplikace skriptu nebo konvertoru). A do skriptu pytá něco takového:
UPDATE tbl SET X = <newX> WHERE pk BETWEEN $1 AND $2;Přibližně v takovém tvaru se dotaz objevuje poměrně často a téměř vždy ne pro vyplnění prázdného nového pole, ale pro opravu nějakých chyb v datech. Přitom sama správnost již existujících dat vůbec není zohledněna — a to je škoda! To znamená, že záznam se přepisuje, i když tam leželo přesně to, co bylo chtěno — a proč? Oprávněme:
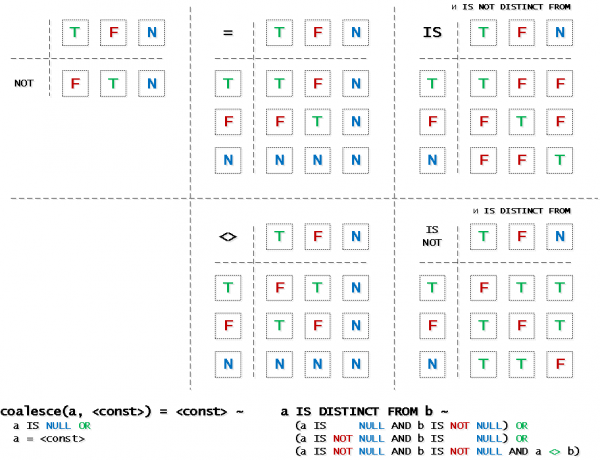
UPDATE tbl SET X = <newX> WHERE pk BETWEEN $1 AND $2 AND X IS DISTINCT FROM <newX>; Mnozí neví o existenci tak skvělého operátoru, proto zde je rychlá příručka k IS DISTINCT FROM a dalším logickým operátorům na pomoc:
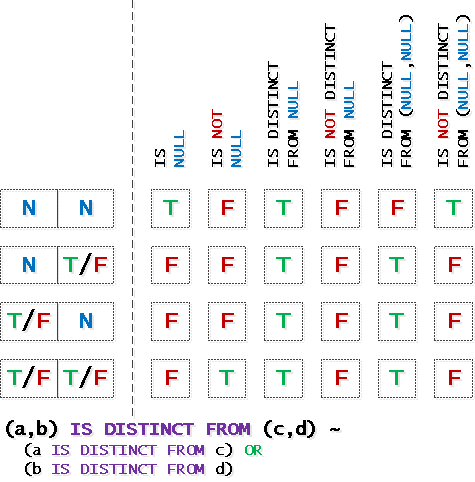
… a trochu o operacích se složenými ROW()-výrazy:
#3: А я милого узнаю по… блокировке
Spouštějí se dva stejné paralelní procesy, z nichž každý se pokouší označit záznam, že je "v procesu":
UPDATE tbl SET processing = TRUE WHERE pk = $1;I když tyto procesy dělají nezávislé věci, v rámci jednoho ID se na tomto dotazu druhý klient "zablokuje", dokud neskončí první transakce.
Řešení č. 1: úloha se redukuje na předchozí
Jednoduše znovu přidáme IS DISTINCT FROM:
UPDATE tbl SET processing = TRUE WHERE pk = $1 AND processing IS DISTINCT FROM TRUE;V této podobě druhý dotaz prostě nezmění nic v databázi, tam už je "všechno jak má být" — proto se blokování nevynoří. Dále fakt "nenalezení" záznamu už zpracováváme v aplikačním algoritmu.
Řešení č. 2: poradenské zámky
Velké téma na samostatný článek, kde si můžete přečíst o .
Řešení č. 3: bez[ú]myslné volání
Ale určitě byste měli mít současnou práci s jedním a tím samým záznamem? Или вы все-таки накосячили с алгоритмами вызовов бизнес-логики со стороны клиента, например? А если подумать?..
Zdroj: habr.com
