

Bojte se operací, které přinášejí buffers...
Na příkladu malé dotazu si ukážeme některé univerzální přístupy k optimalizaci dotazů na PostgreSQL. Používat je nebo ne - to je na vás, ale vědět o nich stojí za to.
V nějakých následujících verzích PG se situace může změnit s "inteligentnějším" plánovačem, ale pro verze 9.4/9.6 to vypadá přibližně stejně, jako ukazují příklady zde.
Vezmu si zcela reálný dotaz:
SELECT
  TRUE
FROM
  "Dokument" d
INNER JOIN
  "DokumentRozšíření" doc_ex
    USING("@Dokument")
INNER JOIN
  "TypDokumentu" t_doc ON
    t_doc."@TypDokumentu" = d."TypDokumentu"
WHERE
  (d."Osoba3" = 19091 or d."Zaměstnanec" = 19091) AND
  d."$Návrh" IS NULL AND
  d."Smazán" IS NOT TRUE AND
  doc_ex."Stav"[1] IS TRUE AND
  t_doc."TypDokumentu" = 'PlánPrací'
LIMIT 1;
o názvech tabulek a políK "ruským" názvům polí a tabulek lze přistupovat různě, ale to už je otázka vkusu. Protože není žádný vývojář-cizinec, a PostgreSQL nám umožňuje dávat názvy i hieroglyfy, pokud jsou uzavřeny v uvozovkách, tak dáváme přednost jednoznačným názvům objektů, abychom předešli nejasnostem.
Podíváme se na vzniklý plán:
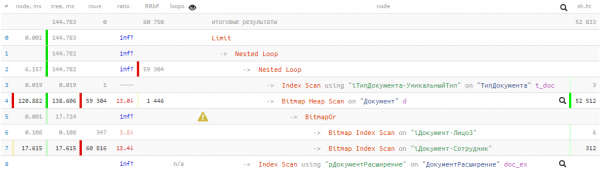
144ms a téměř 53K buffers — tedy více než 400MB dat! A budeme mít štěstí, pokud se všechna ocitnou v cache v okamžiku našeho dotazu, jinak se stane mnohem delším při čtení z disku.
Algoritmus je to nejdůležitější!
Abychom nějak optimalizovali jakýkoli dotaz, musíme nejprve pochopit, co vlastně má dělat.
Zatím vynecháme vývoj samotné struktury DB a dohodneme se, že můžeme relativně "levně" přepsat dotaz a/nebo nasadit na databázi nějaké potřebné nám indexy.
Takže dotaz:
— kontroluje existenci alespoň nějakého dokumentu
— ve potřebném stavu a určitého typu
— kde autorem nebo realizátorem je nám potřebný zaměstnanec
JOIN + LIMIT 1
Často je pro vývojáře jednodušší napsat dotaz, kde se nejprve provede spojení velkého množství tabulek a poté se z toho všeho zůstane jen jeden záznam. Ale jednodušší pro vývojáře neznamená efektivnější pro DB.
V našem případě bylo tabulek pouze 3 — a jaký efekt...
Nejprve se zbavme spojení s tabulkou "TypDokumentu", a zároveň naznačíme databázi, že u záznamu typu máme unikátní (my to víme, ale plánovač zatím ne):
WITH T AS (
  SELECT
    "@TypDokumentu"
  FROM
    "TypDokumentu"
  WHERE
    "TypDokumentu" = 'PlánPrací'
  LIMIT 1
)
...
WHERE
  d."TypDokumentu" = (TABLE T)
...
Ano, pokud tabulka/CTE obsahuje jediné pole jediné záznamu, lze v PG psát i takto, místo
d."TypDokumentu" = (SELECT "@TypDokumentu" FROM T LIMIT 1)"Líné" výpočty v dotazech PostgreSQL
BitmapOr vs UNION
V některých případech bude Bitmap Heap Scan pro nás velmi nákladný – například v naší situaci, kdy spousta záznamů splňuje požadovanou podmínku. Získali jsme ho díky OR-podmínce, která se proměnila v BitmapOr-operaci v plánu.
Vraťme se k původnímu úkolu – musíme najít záznam, který odpovídá jakékoli z podmínek – to znamená, že není třeba procházet všech 59K záznamů podle obou podmínek. Existuje způsob, jak zpracovat jednu podmínku a k druhé přejít až tehdy, když na první nic nenajdeme.Pomůže nám taková konstrukce:
(
  SELECT
    ...
  LIMIT 1
)
UNION ALL
(
  SELECT
    ...
  LIMIT 1
)
LIMIT 1
„Externí“ LIMIT 1 zaručuje, že hledání skončí při nalezení prvního záznamu. A pokud se najde už v prvním bloku, provádění druhého nebude (never executed v plánu).
„Skryté za CASE“ složité podmínky
V původním dotazu je extrémně nepohodlný moment – kontrola stavu podle propojené tabulky „DokumentRozšíření“. Nezáleží na pravdivosti ostatních podmínek ve výrazu (například, d."Odstraněno" IS NOT TRUE), tento join se provádí vždy a „stojí zdroje“. Více nebo méně jich bude utraceno – závisí na objemu této tabulky.
Ale můžeme dotaz modifikovat tak, aby hledání propojeného záznamu probíhalo pouze tehdy, když je to skutečně nutné:
SELECT
  ...
FROM
  "Dokument" d
WHERE
  ... /*index cond*/ AND
  CASE
    WHEN "$Černověk" IS NULL AND "Odstraněno" IS NOT TRUE THEN (
      SELECT
        "Stav"[1] IS TRUE
      FROM
        "DokumentRozšíření"
      WHERE
        "@Dokument" = d."@Dokument"
    )
  END
Pokud z propojené tabulky nám nejsou pro výsledek potřeba žádná pole, máme možnost převést JOIN na podmínku podle poddotazu.
Zanecháme indexovatelné pole „mimo závorky“ CASE, jednoduché podmínky od záznamu vkládáme do bloku WHEN – a nyní je „těžký“ dotaz prováděn pouze při přechodu na THEN.
Moje příjmení „Celkově“
Sestavujeme výsledný dotaz se všemi výše popsanými mechanismy:
S T AS (
  SELECT
    "@TypDokumentu"
  FROM
    "TypDokumentu"
  WHERE
    "TypDokumentu" = 'PlánPrací'
)
  (
    SELECT
      TRUE
    FROM
      "Dokument" d
    WHERE
      ("Osoba3", "TypDokumentu") = (19091, (TABLE T)) AND
      CASE
        WHEN "$Návrh" IS NULL AND "Odstraněn" IS NOT TRUE THEN (
          SELECT
            "Stav"[1] IS TRUE
          FROM
            "DokumentRozšíření"
          WHERE
            "@Dokument" = d."@Dokument"
        )
      END
    LIMIT 1
  )
UNION ALL
  (
    SELECT
      TRUE
    FROM
      "Dokument" d
    WHERE
      ("TypDokumentu", "Zaměstnanec") = ((TABLE T), 19091) AND
      CASE
        WHEN "$Návrh" IS NULL AND "Odstraněn" IS NOT TRUE THEN (
          SELECT
            "Stav"[1] IS TRUE
          FROM
            "DokumentRozšíření"
          WHERE
            "@Dokument" = d."@Dokument"
        )
      END
    LIMIT 1
  )
LIMIT 1;
Přizpůsobujeme [pod] indexy
Zkušené oko si všimlo, že indexované podmínky v podblocích UNION se mírně liší — to proto, že už máme vhodné indexy na tabulce. A kdyby nebyly — pak by stálo za to je vytvořit: Dokument(OSoba3, TypDokumentu) a Dokument(TypDokumentu, Zaměstnanec).
o pořadí polí v ROW-podmínkáchZ pohledu plánovače to samozřejmě lze napsat i (A, B) = (constA, constB), a (B, A) = (constB, constA). Ale při zápisu v pořadí polí v indexu, takový dotaz se pak snadněji ladí.
Co je v plánu?
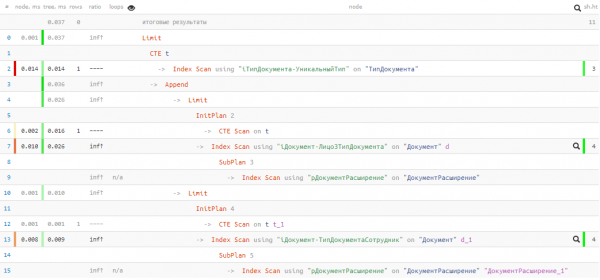
Bohužel jsme neměli štěstí a v prvním UNION bloku nic nenalezli, proto druhý přesto přešel k vykonání. Ale i tak — celkem 0.037ms a 11 bufferů!
Zrychlili jsme dotaz a snížili "přenos" dat v paměti několikrát tisíckrát, využitím poměrně jednoduchých metodik — slušný výsledek při malém kopírování. 🙂
Zdroj: habr.com
